
Von Klexi, aus Ao Feisi
QbitAI | Offizieller Kanal QbitAI
Mit 2,3 Milliarden Yuan hat der KI-native Infrastrukturdienstleister Wuwen Xinqiong seine Serie-C-Finanzierungsrunde abgeschlossen. Zusammen mit den vorherigen Runden hat Wuwen Xinqiong kumuliert 4,3 Milliarden Yuan eingesammelt – sowohl die einzelne Runde als auch die Gesamtsumme stellen neue Rekorde im chinesischen AI-Infrastruktursektor auf.
Seit seiner Gründung vereint die Investorenliste von Wuwen Xinqiong zahlreiche bekannte Institutionen und umfasst staatliche Investoren, branchenbezogene Investoren, Finanzinvestoren und weitere Kategorien. Zu den staatlichen Institutionen zählen unter anderem Hangzhou Gaoxin Jintou, die Sozialversicherung-Zhongguancun-Fonds (JL Capital Management), Zhuhai Technology Industry Group, Xiamen Guoxing Investment, Xuhui Capital, Futeng Capital, China Insurance Investment und CDB Innovation; zu den branchenbezogenen Investoren zählen Dabanc Holding, Lenovo, Ubiquant Ventures, Tongge Ventures, Tencent, Baidu und weitere; zu den Finanzinvestoren zählen bekannte Institutionen wie Sequoia China, Hongtai Fund, Huiyuan Capital, Qiming Venture Partners, Fortune Capital, Shunwei Capital und Lis Ventures. Wuwen Xinqiong ist zu einem der begehrtesten Einhörner im AI-Infra-Sektor geworden.
Das Unternehmen trainiert keine Modelle und entwickelt keine Anwendungen – es arbeitet an der Schicht zwischen Modellen und Chips. Konkret verbindet es Modelle mit Chips, um extreme Effizienz- und Kostenoptimierung zwischen verschiedenen Modellalgorithmen und verschiedenen Chip-Hardwarearten zu erreichen.
Das Ziel dabei ist, heterogene, fragmentierte und domainübergreifende Rechenressourcen effizient zu bündeln und zu koordinieren, aus jeder Kilowattstunde Strom und jeder Sekunde Chip-Laufzeit kostengünstige, hochwertige, produktionsreife Tokens herauszuholen und diese Tokens in echte Geschäftsszenarien zu bringen.
Im Ausland hat der Markt diesem Geschäft bereits einen Preis gegeben. Drei Unternehmen, die dasselbe Geschäft betreiben, haben ihre Bewertung im vergangenen Jahr allesamt in die Höhe schnellen lassen.
Fireworks AI stieg von 4 Milliarden US-Dollar auf 17,5 Milliarden US-Dollar, ein Anstieg von 337 %; Baseten stieg um 160 %; Together AI stieg um 151 %.
Hinter diesen dreien steht zudem ein und derselbe Investor, den wir nur zu gut kennen.
Nvidia.
Nvidia, das sich mit dem Verkauf von Schaufeln am obersten Ende der GPU-Wertschöpfungskette goldene Nasen verdient, steigt nun selbst ins untergeordnete AI-Infra-Geschäft ein – aus Angst, das Ticket im Zeitalter der großen Explosion der AI-Infra-Nachfrage zu verpassen.
Wenn sogar die Schaufelverkäufer es eilig haben, zeigt das, dass das Potenzial dieses Marktes so groß ist, dass die Upstream-Player nicht mehr ruhig sitzen können.
Worauf Nvidia setzt, wollen offensichtlich auch die Investoren von Wuwen Xinqiong mitwetten. Die 2,3 Milliarden, die nun in dieser Runde investiert wurden, sind eine Wette genau auf diesen Markt.
Die Rechenleistungslücke ist ein bodenloses Fass
Um den Hintergrund dieser Finanzierung zu verstehen, muss man zunächst einen Fakt betrachten.
Man könnte denken, dass stärkere Chips und höhere Produktionskapazitäten die KI-Rechenleistungslücke schließen würden – tatsächlich gibt es aber nie einen Tag, an dem die Rechenleistung ausreicht, denn egal wie stark die Chip-Produktion expandiert, sie kann mit dem Nachfragewachstum nicht mithalten.
Daher urteilt Dylan Patel, Gründer der unabhängigen Forschungs- und Analyseagentur SemiAnalysis, dass der Mangel an Rechenleistung andauern wird.
Und der Boom der Agenten hat diese Lücke noch um eine Größenordnung vergrößert.
Wenn ein Agent eine Aufgabe ausführt, stehen dahinter Dutzende von Inferenzanfragen in kettenartigen Aufrufen – der Tokenverbrauch ist mit früheren Einzeldialogen überhaupt nicht mehr vergleichbar.
Das Kapital hat einen sehr feinen Riecher und stürzte sich schnell mit Geldmitteln in diesen Bereich.
Die Entwicklung der drei eingangs erwähnten ausländischen KI-Infrastrukturunternehmen spricht bereits Bände – der gesamte AI-Infra-Sektor wird gerade neu bewertet.
Harry Stebbings, Gründer von 20VC, sprach über seine Investition in Fireworks AI und sagte: „In 15 Minuten war der Deal besiegelt – eine der einfachsten Entscheidungen meiner zehnjährigen Investmentkarriere.“
15 Minuten – ein Mann, der seit zehn Jahren einen Fonds führt, investierte in weniger Zeit als ein Essen dauert in ein AI-Infra-Unternehmen.
Durch die katalytische Beschleunigung durch Agenten wird die Rechenleistungslücke nicht nur nicht geschlossen, sondern nur noch weiter aufgerissen – und dieses Geschäft hat deshalb keine sichtbare Decke.
Auf derselben Spur sind im Ausland bereits Unternehmen mit Bewertungen im Bereich von zehn Milliarden US-Dollar entstanden, und in China wurde gerade ein neuer Rekord bei der Finanzierungssumme dieses Sektors aufgestellt.
Und Wuwen Xinqiong hat sich dafür entschieden, keine eigenen Rechenzentren zu bauen – das Unternehmen schlägt einen anderen Weg ein.
Ohne eigene Rechenzentren lässt sich AI Infra trotzdem betreiben
Beim AI-Infra-Geschäft gibt es im Grunde nur zwei Wege.
Der traditionellere Ansatz ist der Bau eigener Rechenzentren, bei dem man mit schweren Vermögenswerten Größenvorteile erkauft – das bedeutet jedoch sehr wahrscheinlich, sich für die Expansion zu verschulden.
Ein anderer Ansatz geht ins andere Extrem: Das Rechenzentrum wird gar nicht angefasst, sondern die überall verstreute Rechenleistung wird eingesammelt und durch Software-Orchestrierung zu einem Netz verwoben.
Wuwen Xinqiong hat sich für Letzteres entschieden. Das Unternehmen besitzt selbst keine physischen Rechenzentren, die Rechenleistung ist auf Compute-Zentren an verschiedenen Orten verteilt, und die Chiphersteller sind regelrecht ein «Mischmasch aus aller Welt».
Das Technologie-System von Wuwen Xinqiong lässt sich mit drei Schlagwörtern beschreiben: multi-heterogen, Hardware-Software-Koordination und autonomes KI.
Zuerst zur Multi-Heterogenität: Die Plattform von Wuwen Xinqiong ist bereits mit 16 Chiparten kompatibel, darunter NVIDIA, AMD, Huawei Ascend, Biren, Hygon, Moore Threads, Muxi, Enflame und T-Head, und bedient 37000P Rechenleistung.
Selbst wenn ein neuer Chip dazukommt, braucht das Team nur 2 Arbeitstage, um die Kompatibilität herzustellen; die Anpassungskosten für inländische Chips wurden um mehr als 70% gesenkt.
In einer Zeit, in der die Chip-Lieferkette immer komplexer wird, ist die Fähigkeit, sich frei zwischen verschiedenen Chips umschalten zu können, sodass Kunden nicht an einen einzigen Chip gebunden sind, äußerst wertvoll. Wuwen Xinqiong bleibt dabei nicht nur bindungsfrei, sondern auch neutral: Als unabhängige Plattform, die Modelle, Chips und Kundenbedürfnisse verbindet, organisiert es die verteilten Modellfähigkeiten und die heterogene Rechenleistung und optimiert kontinuierlich die Transformationseffizienz von den unteren Ressourcen zur KI-Produktivität.
Wuwen Xinqiong hat als Erster ein heterogenes Mixed-Training von Chips im Maßstab von tausend Karten erreicht, mit einer Rechenleistungsauslastung von 97,6%. Genauer gesagt nutzte Wuwen Xinqiong vier inländische Chips – Huawei Ascend, Tianshu Zhixin, Muxi und Moore Threads – sowie zwei importierte Chips von AMD und NVIDIA und absolvierte das heterogene Chip-Mixed-Training eines Großmodells mit 70 Milliarden Parametern. Das ist das erste Mal in der Branche.
Domain-übergreifendes Training ist ebenfalls ein härter Prüfstein.
Wuwen Xinqiong hat gemeinsam mit China Telecom den ersten Fall im Inland eines domainsübergreifenden Mixed-Trainings eines Großmodells über mehr als 4000 km abgeschlossen, indem die Rechenleistung von Hami in Xinjiang und Shenzhen in Guangdong zusammengeführt wurde und ein gemeinsames Training auf einem Modell mit 30 Milliarden Parametern durchgeführt wurde, wodurch die Leistung um 165% gesteigert wurde.
Darüber hinaus gelang dem Team die Multi-Rechenzentrum-Verbundtraining über 4 GPU-Cluster unterschiedlicher Generationen und Modelle sowie ein Hybrid-Cloud-Training zwischen lokalen privaten Clustern und Public-Cloud-Rechenleistung, mit Leistungssteigerungen von jeweils 41% und 68%.
Natürlich ist die Kompatibilität nur ein Schritt; im tatsächlichen Betrieb ist auch die Geschwindigkeit ein wichtiger Indikator.
Schließlich hat ein Agent keine Zeit zu warten, bis das Modell ein Wort nach dem anderen heraustippt.
Genau das ist das Problem, das die Hardware-Software-Koordination lösen soll.
Wuwen Xinqiong hat am Software-Stack eine ganze Reihe von Optimierungen vorgenommen: von automatisierter paralleler Orchestrierung und Suche, Optimierung von Operatoren und Rechengrafen bis hin zur Überlappung von Berechnung und Kommunikation sowie dynamischer Orchestrierung und Scheduling — so werden Rechenressourcen effizient in hochwertige Modellleistung und Token-Servicefähigkeit umgewandelt.
Das Ergebnis: Auf der von Wuwen Xinqiong optimierten Infrastruktur liegt der Trainingsdurchsatz von MoE-Modellen mit Billionen von Parametern 41% bis 75% über dem gängiger Open-Source-Frameworks.
Beim Inference hat Wuwen Xinqiong durch eine Reihe technischer Innovationen die Inferenzkosten innerhalb eines Jahres auf ein Zehntel des ursprünglichen Werts gesenkt.
Auf der WAIC 2026 präsentierte das Unternehmen mit der branchenweit ersten PD-Trennungsarchitektur über Cluster hinweg — PDD (Prefill-RelayDecode-MainDecode) — eine Reduzierung der First-Token-Latenz um 51.5% und der Kosten pro Token um 37.5%.
Mit der großflächigen Anwendung von PDD besteht künftig noch Spielraum für eine zehnfache Senkung der Inferenzkosten.
Doch im Agent-Zeitalter gibt es noch ein weiteres Problem: Die Fähigkeiten der Modelle unterscheiden sich, sodass es zur Aufgabe wird, für eine konkrete Aufgabe das richtige Modell und die passende Rechenleistung auszuwählen.
Wuwen Xinqiong hat diese Entscheidung dem System überlassen — dem sogenannten «autonomen KI».
Konkret wird ein adaptiver Kooperationsmechanismus zwischen großen und kleinen Modellen eingeführt: Das System überträgt komplexe Aufgaben zur Planung und Inferenz an große Modelle, während leichtgewichtige Echtzeitantworten an kleine Modelle gehen; das System wechselt dynamisch je nach Aufgabenkomplexität, Latenzanforderungen und Token-Kosten.
Aufbauend auf diesem Mechanismus hat Wuwen Xinqiong außerdem einen Schwarm intelligenter Agenten deployt, der derzeit drei Teilmengen umfasst: ein benutzerorientiertes Plattform-Manager-Agentensystem, ein clusterorientiertes Betriebs-Agentensystem sowie ein chiporientiertes Operator-Generierungs-Agentensystem. Durch Agent-Fähigkeiten wird die gesamte AI-Infra in einen closed loop autonomer Iteration und Selbstoptimierung versetzt, sodass die Infrastruktur mit der Nutzung immer leistungsfähiger wird.
Betrachtet man all diese Fähigkeiten zusammen, wird verständlich, was Wuwen Xinqiong tut.
Es verankert sich in der Infrastruktur, bündelt nach unten Energie und Chips und stützt nach oben Modelle und Anwendungen; es steigert nicht nur extrem Maßstab und Effizienz der Umwandlung von unteren Ressourcen in KI-Produktivität, sondern verfügt auch über die im Zeitalter des Agentic AI deutlichste KI-nativ-Fähigkeit — mit einem Infrastruktur-Agentenschwarm die Ressourcenskalierung zu ermöglichen, die Token-Produktion effizienter zu machen und die kontinuierliche Evolution des Agentic AI zu unterstützen — und ist damit geschäftlich zukunftsorientiert aufgestellt.
Rechenleistung, Modelle, Branchen: drei Geschäftsebenen gleichzeitig
Die Rechnung auf der technischen Seite ist abgeschlossen; nun zur Kommerzialisierung.
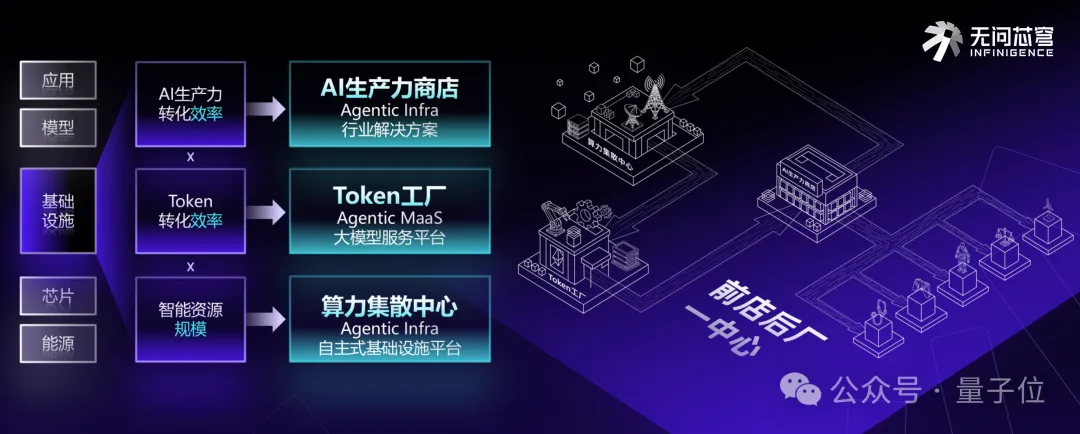
Wuwen Xinqiong hat die strategische Aufstellung «Vorderes Geschäft, hinteres Werk, ein Zentrum» vorgeschlagen, konkret das Geschäft in drei Ebenen aufgeteilt.
Die unterste Ebene ist das Rechenleistungs-Sammel- und -Verteilzentrum (Agentic Infra, autonome Infrastrukturplattform). Seine Aufgabe ist es, verstreute und heterogene Rechenressourcen einheitlich zu bündeln, elastisch zu schedulen und bedarfsgerecht zu verteilen, um für die Modell- und Anwendungsebene ein ausreichendes, stabiles und skalierbares Rechenfundament zu schaffen — Kunden müssen sich nicht um Hardware-Unterschiede kümmern, sie schließen an und können loslegen.
Die mittlere Ebene ist die Token-Fabrik (Agentic MaaS, Plattform für große Modell-Services), die die großskalige, qualitativ hochwertige Token-Produktion mit äußerster Effizienz bedient. Die Plattform hat bereits enge Kooperationen mit führenden großen Modell-Unternehmen wie Zhipu und Moonshot (Yuezhianmian) geschlossen und über hundert große Modelle online gestellt; Kunden müssen nicht selbst deployen — Modell auswählen und direkt nutzen.
Die oberste Ebene ist der AI-Produktivitäts-Store (Branchenlösungen), der Unternehmen Agentic-Infra-Branchenlösungen anbietet. Für ein und dieselbe Branche können unterschiedliche Modellgrößen und Hardware-Konfigurationen völlig unterschiedliche Token-Kosten verursachen. Wuwen Xinqiong nutzt die adaptive Agenten-Szenario-Technologie als zentralen technologischen Pfad zur Steigerung der Umwandlungseffizienz von KI-Produktivität und hat bereits Agentic-Infra-Branchenlösungen für Bereiche wie Unterhaltung und Spiele, Gesundheitswesen, Rechtsdienstleistungen sowie Energie und Strom vorgelegt, um Token weiter in ausführbare, lieferbare Branchenproduktivität umzuwandeln.
Nach dem Ausbruch der Agent-Anwendungen stieg das tägliche Token-Volumen der großen Modell-Serviceplattform von Wuwen Xinqiong innerhalb eines halben Jahres um mehr als das 40-Fache; über 95% der Inferenzaufgaben stammen von Agenten.
Innerhalb der drei Geschäftsebenen von Wuwen Xinqiong schafft das Rechenleistungs-Sammel- und -Verteilzentrum ein ausreichendes, stabiles und skalierbares Rechenfundament für die Modell- und Anwendungsebene; die Token-Fabrik steigert durch eine Reihe origineller technischer Innovationen die Inferenzeffizienz großer Modelle erheblich und senkt die Inferenzkosten; der AI-Produktivitäts-Store verwandelt Token effizient in branchenweit anerkannte, hochwertige KI-Produktivität.
Schon 2025 hat Wuwen Xinqiong als erstes in der Branche den Paradigmenwechsel des Agentic Infra proklamiert. Heute wird der industrielle Wert von Agentic Infra, das den großskaligen Betrieb und die kontinuierliche Evolution von Agenten ermöglicht, fortlaufend bestätigt. Als der Wind wirklich kommt, steht es bereits im Brennpunkt des Aufwinds.
2,3 Milliarden Yuan werden investiert – worauf wird gewettet?
Die Technik funktioniert, die Nachfrage ist validiert, als Nächstes steht also die Frage der Größenordnung an.
Infinigence hat in dieser C-Runde 2,3 Milliarden Yuan eingesammelt; zusammen mit den vorherigen Runden belaufen sich die kumulierten Finanzierungen auf insgesamt 4,3 Milliarden Yuan – sowohl der Betrag der Einzelrunde als auch der kumulierte Betrag stellen neue Rekorde im chinesischen Segment für AI-Infrastruktur auf.
Dieses Kapital ist genau die entscheidende Energie, mit der Infinigence in die skalierende Expansion geht.
Außerdem hat Infinigence laut einem Bericht der Bloomberg News unter Berufung auf mit der Sache vertraute Personen in den letzten Monaten vertraulich einen IPO-Antrag bei der Hong Kong Stock Exchange eingereicht.
Nach der Einsammlung von insgesamt 4,3 Milliarden Yuan hat dieser Anbieter von AI-nativer Infrastruktur nun das IPO-Signal gegeben.
Dass Investoren zu diesem Zeitpunkt diesen Preis akzeptieren, hängt von drei Dingen ab: das Team, die Position und das Timing.
Betrachten wir zunächst das Team. Infinigence ist ein typisches Tsinghua-Unternehmen: Der Initiator Wang Yu ist Inhabprofessor am Fachbereich Elektronik der Tsinghua-Universität, damaliger Fachbereichsleiter und IEEE Fellow; CEO Xia Lixue, Chefwissenschaftler Dai Guohao und CTO Li Boxun haben alle am Fachbereich Elektronik der Tsinghua-Universität studiert.
Von Zhipu bis Moonshot hat der Tsinghua-Kreis bereits eine Reihe von Leitunternehmen im KI-Bereich hervorgebracht – auch die DNA von Infinigence liegt auf dieser Linie.
Dieses Team beschäftigt sich seit der Doktorandenzeit mit Hardware-Beschleunigung für Deep Learning und Optimierung heterogener Systeme und verfügt in Verbindung mit tiefgreifender Branchenerfahrung über Spitzenkompetenzen in Software- und Hardware-Forschung sowie Engineering.
Nun zur Position.
Infinigence besetzt das Scharnier der Wertschöpfungskette: nach unten verbunden mit Energie und Chips, nach oben tragend die Modelle und Anwendungen, konfrontiert mit realen Workloads aus tausenden Branchen – mit jedem zusätzlichen Kunden steigt die Komplexität der Koordinierung und der Szenario-Anpassung weiter an.
Schließlich das Timing: In den vergangenen zwei Jahren wurde verglichen, wessen Modell stärker ist, doch der Abstand zwischen den Modellen verringert sich zunehmend.
Wenn alle annähernd gleich gute Modelle trainieren können, verlagert sich der Wettbewerb auf die nächsttiefere Ebene – wer annähernd gleiche Modelle schnell, günstig und stabil betreiben kann, ist derjenige, der wirklich Geld verdient.
Und wer zuerst läuft, hat Daten und Erfahrung angehäuft; Nachzügler, die es nur mit Geld versuchen, haben es schwer.
In dieser Hinsicht hat Infinigence in realen Geschäftsszenarien kontinuierlich gefeilt und umfangreiche Optimierungserfahrung gesammelt und bereits Agentic-Infra-Branchenlösungen für Bereiche wie Unterhaltung und Gaming, Gesundheitswesen, Rechtsdienstleistungen sowie Energie und Strom vorgestellt. Die riesige Geschäftserfahrung wiederum kann die schnelle technologische Iteration speisen und synchronisierte Sprünge bei Leistung und Zuverlässigkeit der Plattform vorantreiben – ein positiver Kreislauf der Kommerzialisierung.
Auf dem Track für AI-Infrastruktur ist Infinigence vor drei Jahren gegründet worden und hat sich mit der Erkundung von Rechenressourcen, Token-Produktion und branchenspezifischen Agent-Anwendungen beschäftigt. Es ist von realen industriellen Bedürfnissen ausgegangen und hat durch eigenständige technologische Innovationen Probleme wie Rechenkapazitätsauslastung, Servicekosten und Anwendungsüberführung gelöst – und so bis heute durchgehalten, wobei sowohl der Finanzierungsbetrag der Einzelrunde als auch der kumulierte Betrag die Rekorde des Segments erneuert haben.
Der Größenordungskampf der AI-Infrastruktur hat gerade erst begonnen – und Infinigence steht bereits an der Spitze.