
Kernpunkte
- Der Bau langlebiger Agents erfordert ständiges Kontextmanagement, und diese Entscheidungen mit einem Frontier-LLM zu treffen, ist langsam und teuer. ScaleDowns Modelle für eingeschränktes Decoding (Constrained Decoding Models, CDMs) machen dies schneller und günstiger.
langchain-scaledownmacht es einfach, ScaleDown-Modelle in Ihrem Agent zu verwenden, und wird mit Middleware für Zusammenfassung, Komprimierung von Tool-Ergebnissen und Extraktion ausgeliefert.- ScaleDown wird jetzt im LangSmith LLM Gateway unterstützt, sodass seine Aufrufe nachverfolgt werden und auf Ihren Verbrauch und Ihre Rate Limits angerechnet werden.
Der Bau langlebiger Agents ist letztlich die Kunst des Kontextmanagements: zu entscheiden, welche Informationen in das Kontextfenster aufgenommen werden und wann. Das bedeutet, alte Historie zusammenzufassen, große Tool-Ergebnisse zu komprimieren und die richtigen Daten aus langen Eingaben zu extrahieren. Jeder dieser Schritte ist eine Entscheidung. Traditionell haben wir diese mit LLMs getroffen, was in dem Volumen, das ein langlebiger Agent benötigt, langsam und teuer ist.
Um diese Entscheidungen schneller und günstiger zu machen, haben wir jetzt eine langchain-scaledown -Integration und Unterstützung im LangSmith LLM Gateway für ScaleDown-Modelle für eingeschränktes Decoding (CDMs). Während ein allgemeines LLM beliebige Zeichenketten Token für Token schreibt, ist ein CDM für eine einzige Aufgabe trainiert und liefert nur Antworten, die diese Aufgabe zulässt, etwa ein Label aus Ihrer Liste oder Ausschnitte der Eingabe. Dadurch kann er viel kleiner, schneller und günstiger sein: ScaleDown berichtet, dass seine Modelle bei diesen engen Aufgaben 200x schneller und 467x günstiger sind als Frontier-Modelle.
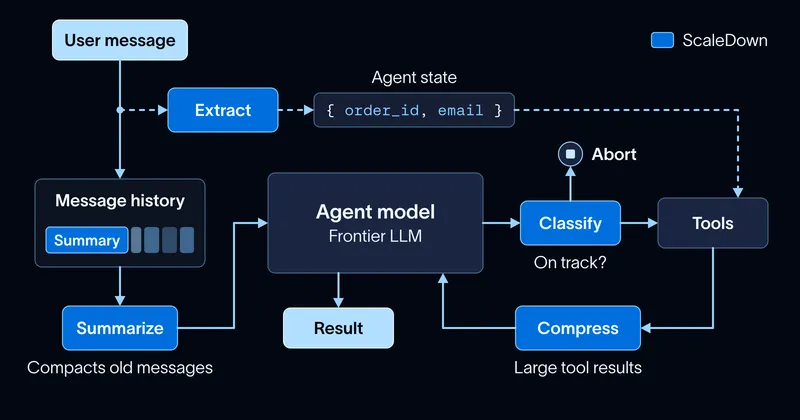
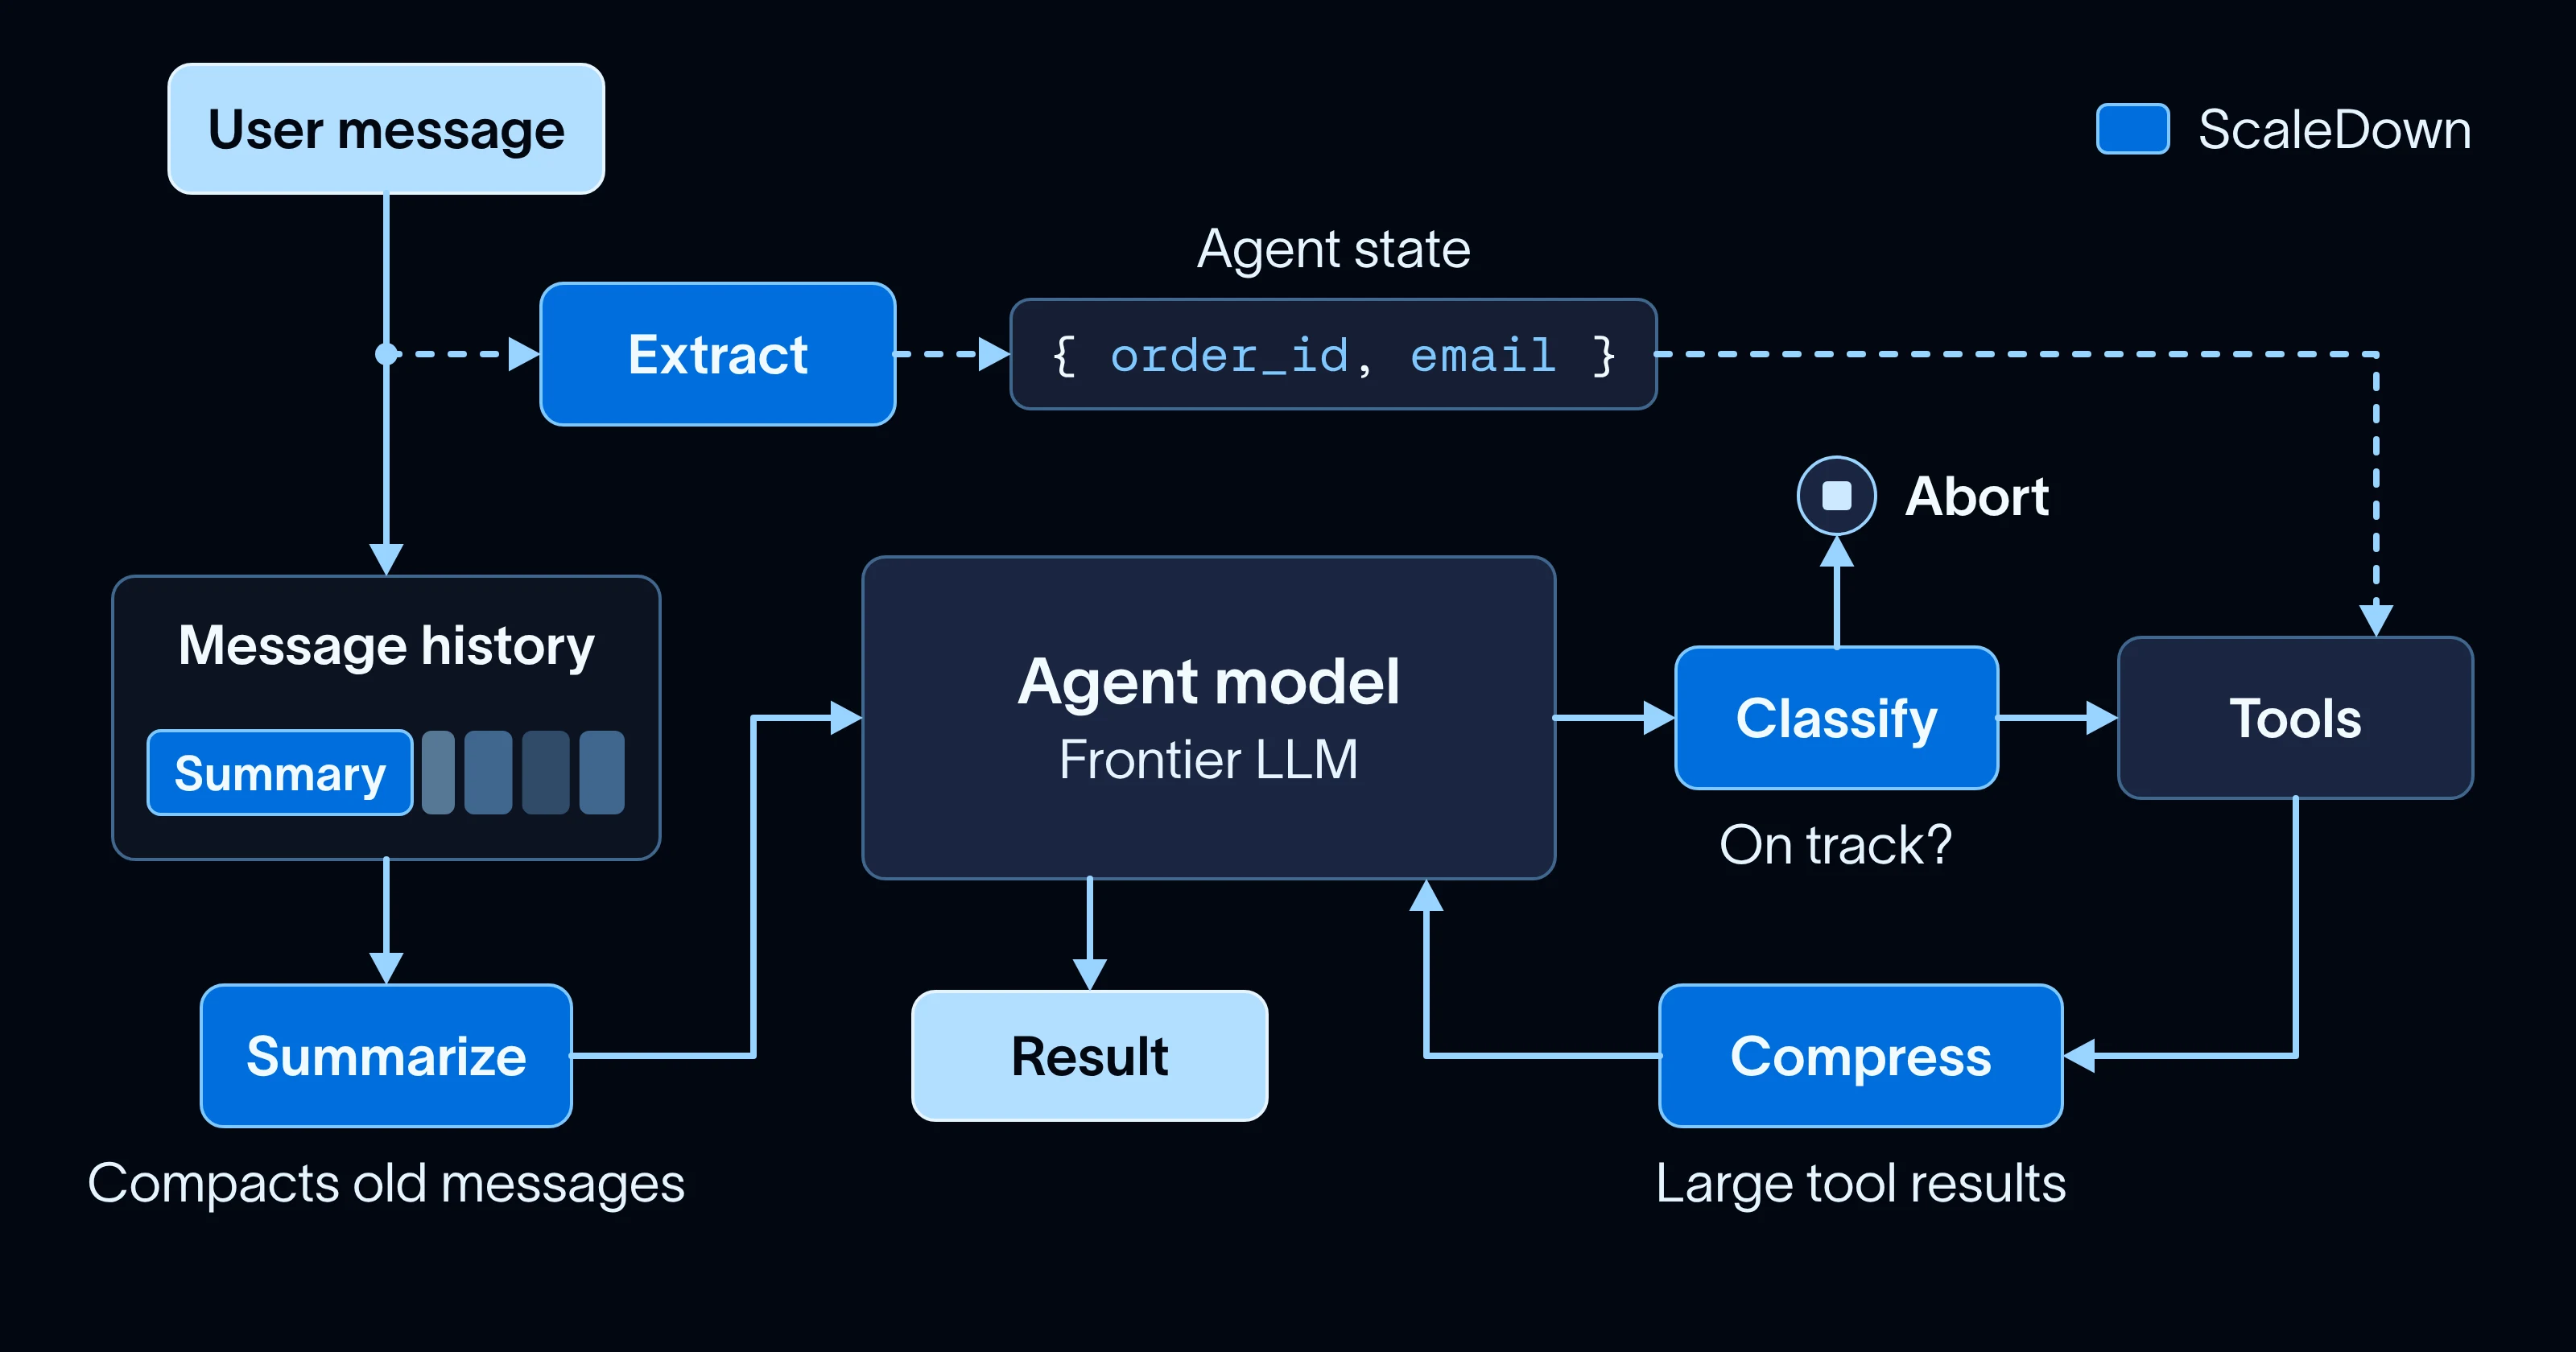
Die Integration wird mit drei Middlewares für LangChain und Deep Agentsausgeliefert: eine fasst alte Historie zusammen, eine komprimiert große Tool-Ergebnisse, und eine extrahiert strukturierte Daten aus der Konversation. In diesem Beitrag erläutern wir, was ScaleDowns Modelle sind und wie Sie damit den Kontext Ihres Agents herunterskalieren können.
Welche Modelle bietet ScaleDown an?
ScaleDown hat vier Modelle, die jeweils für eine einzelne Aufgabe trainiert sind, sodass jedes einzelne deutlich effizienter sein kann als ein allgemeines LLM:
- Summarize schreibt eine kurze Zusammenfassung eines langen Textes.
- Compress kürzt einen Kontextblock auf die Teile, die für eine Frage relevant sind.
- Extract zieht die von Ihnen beschriebenen Felder aus einem Text heraus, jeweils mit einem Confidence-Score und dessen Position in der Quelle.
- Classify bewertet Text anhand von von Ihnen definierten Labels und gibt für jedes eine Wahrscheinlichkeit zurück. Sie können entscheiden, ob ein Grund in natürlicher Sprache dafür zurückgegeben werden soll, warum die Klassifizierung so erfolgte.
Jedes Modell fasst bis zu 1M Token an Eingabe, sodass ein vollständiger Vertrag, eine lange Richtlinienseite oder eine Stunde Agentenverlauf in einen einzigen Aufruf ohne Chunking passt. Sie sind außerdem multimodal: Extract, Summarize und Classify nehmen neben unstrukturiertem Text direkt auch Bilder und gescannte PDFs entgegen, sodass ein Screenshot oder eine gescannte Rechnung als Eingabe funktioniert.
Laut ScaleDowns eigenen Benchmarks, gemessen am Durchschnitt von GPT-5.5, GPT-5.4 Mini und GPT-5.4 Nano auf öffentlichen Datensätzen, ist Summarize 41x günstiger und 2.7x schneller, und Compress ist 138x günstiger und 1.8x schneller – bei jeweils höherer Punktzahl bei der Genauigkeit.
Wenn Sie bereits ein Entscheidungsmodell wie Jevverwendet haben, wird Ihnen ScaleDown Classify vertraut vorkommen: Beide geben eine typisierte Antwort mit einer Wahrscheinlichkeit zurück. Jev nimmt nur Text, bis zu 32K Token an Zustand pro Frage. Classify nimmt bis zu 1M Token an, Bilder inbegriffen, und fügt jedem Entscheidung einen Ein-Satz-Grund hinzu . Wenn ein Agent ein Ticket weiterleitet oder einen Lauf anhand eines Labels stoppt, sagt Ihnen der Grund, warum – das macht den Agenten leichter zu debuggen.
Zusammenfassen des Nachrichtenverlaufs
Langlebige Agenten benötigen Zusammenfassungen, weil ihr Verlauf irgendwann das Kontextfenster sprengt. Ein Coding-Agent, der eine Stunde lang gearbeitet hat, hat Dutzende von Datei-Lesevorgängen und Tool-Ausgaben in seinem Verlauf, die meisten davon werden nicht mehr wörtlich benötigt. Diese mit einem weiteren Frontier-Modellaufruf zusammenzufassen, verursacht jedes Mal Kosten und Latenz, wenn der Verlauf voll wird.
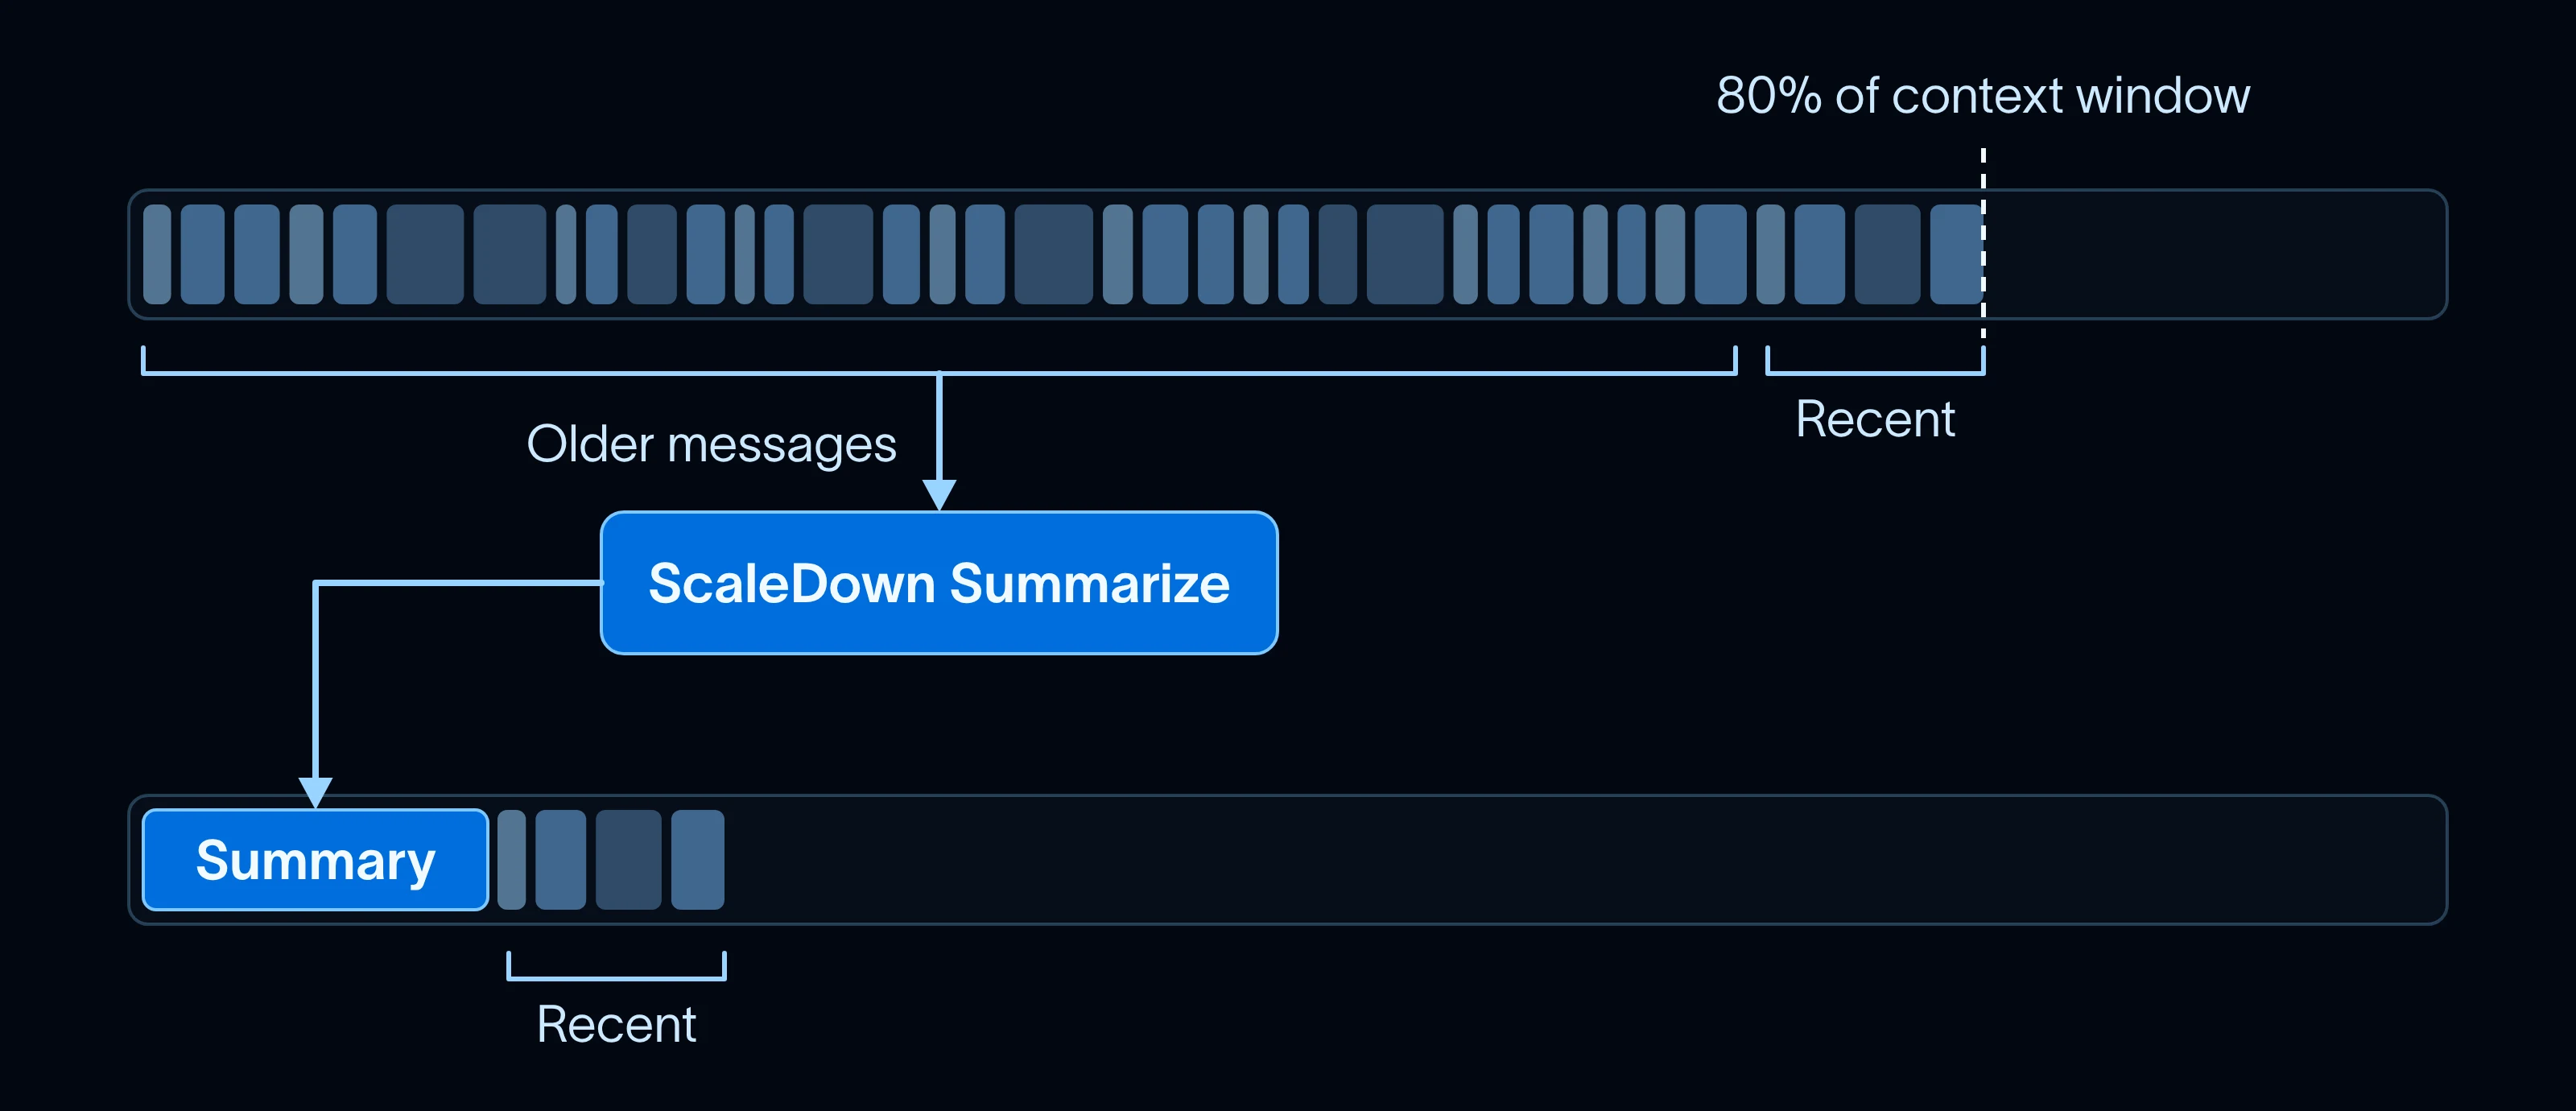
ScaledownSummarizationMiddleware ersetzt Deep Agents’ integrierte Summarization-Middleware. Sie akzeptiert dieselben trigger und keep Optionen, um zu entscheiden, wann zusammengefasst wird und welche aktuellen Nachrichten behalten werden, und ScaleDown erstellt die Zusammenfassung:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
Der Agent behält sein eigenes Modell für Planung und das Schreiben von Code. Nur die Zusammenfassung geht an ScaleDown, das standardmäßig dieselben Abschnitte wie LangChain’s Summary-Prompt zurückgibt (intent, summary, artifacts und next steps). Wenn ein ScaleDown-Aufruf fehlschlägt, lässt die Middleware den Verlauf unverändert und der Agent läuft weiter. Dieselbe Middleware funktioniert mit LangChain’s create_agent.
Komprimierung von Tool-Ergebnissen
Langlebige Agenten rufen viele Tools auf, und jedes große Ergebnis bleibt für den Rest des Laufs im Kontext. Eine abgerufene Webseite kann Zehntausende von Zeichen lang sein, obwohl der Agent nur einen Absatz davon braucht. Jeder spätere Schritt zahlt erneut für diese Tokens, und der Agent wird schlechter darin, bei der Aufgabe zu bleiben, wenn sich sein Kontext füllt.
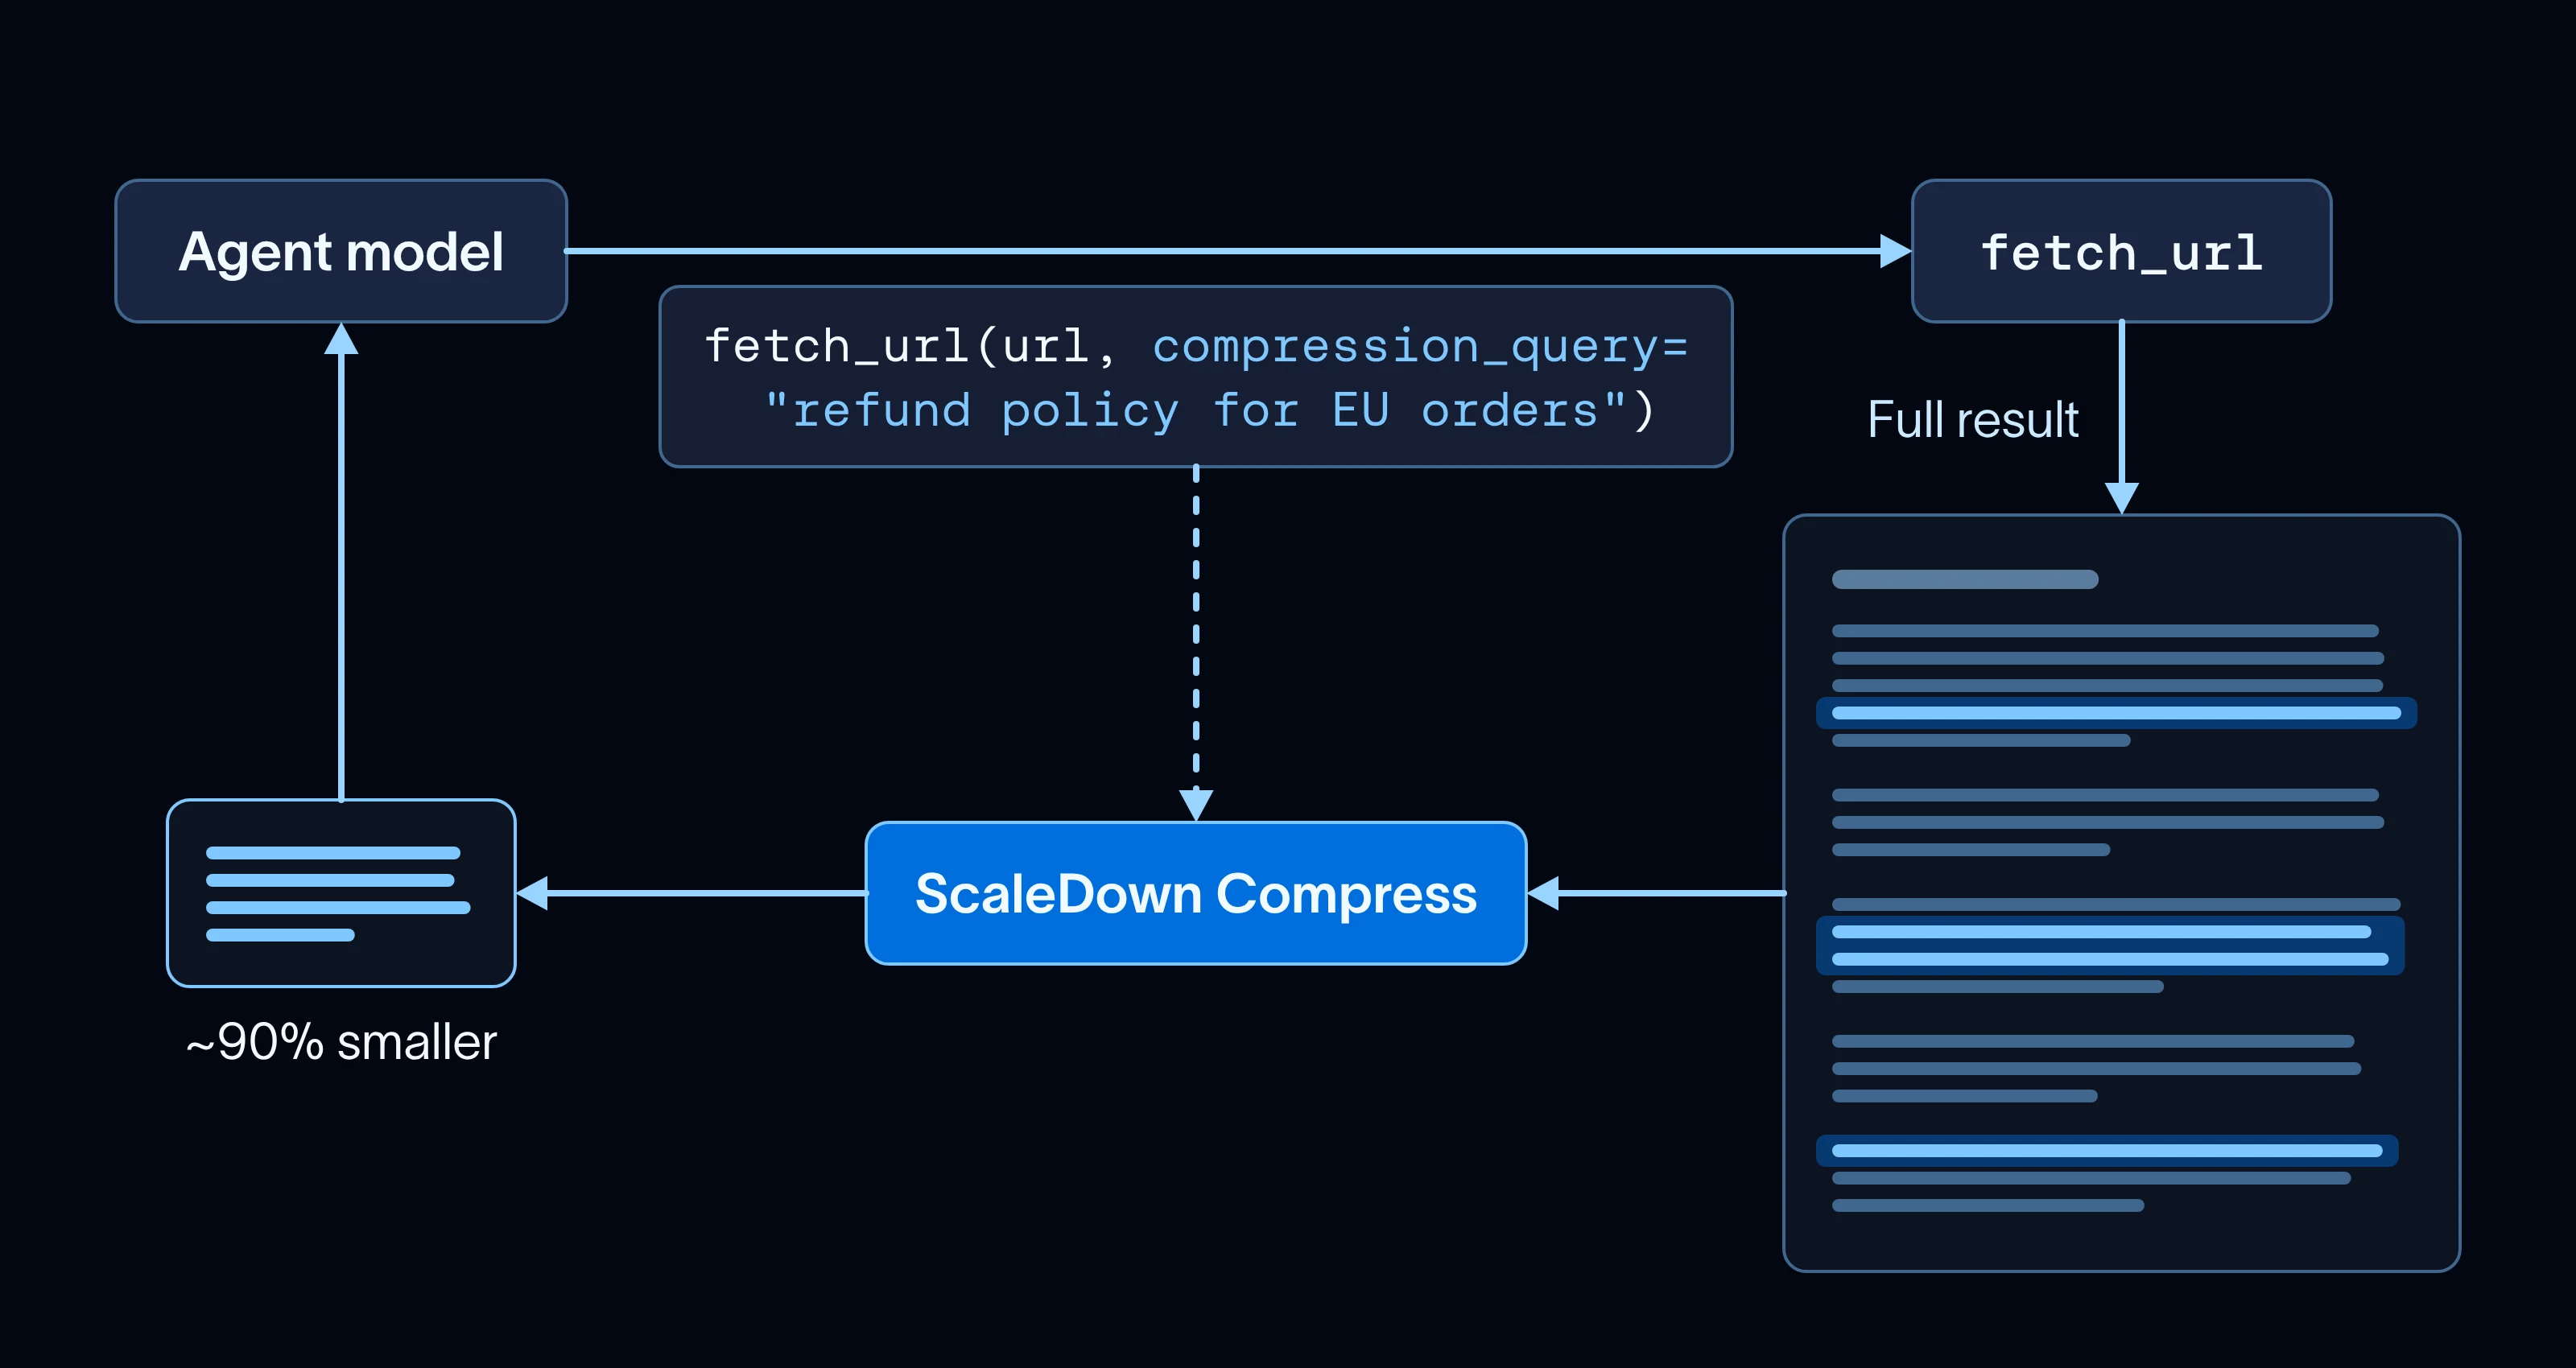
ScaledownToolCompressionMiddleware fügt Ihren Tools einen optionalen compression_query Parameter hinzu. Wenn das Modell nur einen Teil eines Ergebnisses braucht, füllt es compression_query beim Tool-Aufruf aus, zum Beispiel "refund policy for EU orders". Die Middleware entfernt es, bevor das Tool ausgeführt wird, und ScaleDown komprimiert dann die Ausgabe auf die relevanten Teile, bevor das Modell sie sieht:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
Ihre Tools ändern sich nicht, daher funktioniert dies mit jedem Tool, einschließlich MCP-Tools. In diesem Tracekürzte ScaleDown eine lange Dokumentationsseite um fast 90%, bevor das Modell sie sah. Das komprimierte Ergebnis beginnt mit einem Hinweis wie diesem, damit das Modell das Tool erneut ohne compression_query aufrufen kann, wenn es die vollständige Seite benötigt:
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
Extraktion von strukturierten Daten
Agenten ziehen ständig bestimmte Werte aus dem, was sie lesen, heraus, etwa eine ID, ein Datum oder ein Feld, das der nächste Tool-Aufruf benötigt. Diese Extraktion liegt innerhalb der Agent-Schleife, daher muss sie schnell genug sein, um keine Latenz bei jedem Durchgang zu verursachen, und genau genug, damit ein Tool den Wert unverändert verwenden kann.
Beispielsweise braucht ein Support-Agent vor dem Anlegen eines Tickets die Bestellnummer, die Fehlermeldung und die E-Mail-Adresse des Kunden. Das Hauptmodell könnte diese als Tool-Argumente eintragen, aber es könnte stattdessen einen Fehlercode umformulieren oder eine E-Mail-Adresse falsch eintippen, anstatt sie exakt zu kopieren.
ScaledownExtractionMiddleware übergibt diesen Schritt an ScaleDown. Sie beschreiben jedes Feld in einfacher Sprache, und Extract kopiert den Wert aus dem Text. Ein Feld kann auch eine Menge von Labels sein, die ScaleDown mit Classify beantwortet, damit das Ticket nach Problemtyp weitergeleitet werden kann. Vor dem ersten Modellaufruf eines Laufs sendet die Middleware die Nachrichten des Nutzers an Extract und speichert die Felder im Agent-Zustand unter scaledown_extraction, wo Ihre Tools sie lesen können:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
Extract liest nur die Nachrichten des Nutzers, niemals die Antworten des Agenten, sodass jeder Wert etwas ist, das der Kunde tatsächlich gesagt hat. Mit einem checkpointer, läuft die Extraktion in jeder Runde neu, sodass der Datensatz sich füllt, während der Kunde Details ergänzt. Für "Bestellung A-1042 ist mit ERR_PAYMENT_DECLINED fehlgeschlagen. Ich habe bereits eine andere Karte ausprobiert."kommen die Felder zurück als:
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
Klassifizierung von Abweichung (Drift)
Ein Agent entscheidet seinen nächsten Schritt auf Grundlage seines aktuellen Zustands, etwa ob die Aufgabe erledigt ist oder ob der letzte Tool-Aufruf funktioniert hat. Diese Zustandsklassifizierung findet in jeder Runde statt, daher muss sie günstig und schnell sein.
Ein Zustand, den man bei langlebigen Agents erkennen sollte, ist Drift: das Schleifen bei demselben fehlgeschlagenen Tool-Aufruf oder das Feststecken in einem unproduktiven Zyklus. Dafür gibt es keine fertige Middleware, aber Sie können jedes ScaleDown-Modell aus Ihrer eigenen benutzerdefinierten Middlewareaufrufen. Hier ist ein Circuit Breaker, der nach jedem Modellaufruf läuft, den Verlauf an ScaleDown Classify sendet und den Lauf stoppt, wenn er vom Kurs abkommt:
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
Classify gibt für jedes Label eine Wahrscheinlichkeit zurück, sodass Sie wählen können, wie sicher es sein muss, bevor der Breaker auslöst. Der Einzeiler-Grund erscheint in der endgültigen Nachricht, sodass Sie sehen können, warum der Lauf gestoppt wurde. Eine sanftere Variante beendet den Lauf nicht beim ersten Auslösen: Sie fügt den Grund als Anstoß zur Kursänderung in die Konversation ein und stoppt erst, wenn der Agent erneut abdriftet.
Diese vier Abschnitte zeigen einige Stellen, an denen ScaleDowns Modelle passen, und die Liste ist nicht erschöpfend. Sie können sie frei kombinieren, etwa extract / summarize bei langen Tool-Ergebnissen oder Klassifizierung für Modell-Routing zur Laufzeit. Schauen Sie sich die ScaleDown Cookbooks an, um andere Wege zu sehen, CDMs-Modelle über verschiedene Datentypen hinweg einzusetzen.
ScaleDown im LangSmith LLM Gateway
Der LangSmith LLM Gateway ermöglicht es Ihnen, Modelle verschiedener Anbieter mit einem einzigen LangSmith-API-Schlüssel aufzurufen, zeichnet jeden Aufruf nach und setzt Ihre Ausgabenlimits und Ratenlimitsdurch. ScaleDown ist jetzt einer seiner direkten Modellanbieter, unter dem /scaledown Pfad.
Ein Administrator fügt Ihren ScaleDown-Schlüssel zu den Anbieter-Secrets des Workspace als SCALEDOWN_API_KEY einmal hinzu. Dann richten Sie langchain-scaledown auf das Gateway aus und authentifizieren sich mit Ihrem LangSmith-Schlüssel:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
Jeder ScaleDown-Aufruf erscheint dann als LangSmith Trace und zählt zu denselben Limits wie Ihre anderen Modellausführungen.
Wann man ScaleDown nicht verwenden sollte
Behalten Sie ein allgemeines LLM für offene Generierung bei, etwa zum Schreiben von Code, Verfassen von Antworten und Planung. Dies folgt dem „standardmäßig günstig, im Ausnahmefall Frontier“-Ansatz aus unseren Jev-Beiträgen: Verwenden Sie ein großes Allzweck-LLM für die schwierigen Teile und spezialisierte Modelle für die volumenstarken Schritte darum herum.
ScaleDown ist schnell und günstig genug, um bei jedem Durchlauf ausgeführt zu werden, sodass Ihr Agent die strukturierten Entscheidungen treffen kann, von denen das Kontextmanagement abhängt, ohne die Hauptschleife zu verlangsamen oder Frontier-Preise dafür zu zahlen. Bei einem langlebigen Agenten treten diese Entscheidungen bei fast jedem Durchlauf auf, sodass sich die Einsparungen schnell summieren.
Erste Schritte
Installieren Sie die Integration und legen Sie Ihren ScaleDown-API-Schlüssel fest:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
Neue ScaleDown -Konten erhalten 50M kostenlose Tokens. Die ScaleDown-Integrationsdokumentation decken die Konfigurationsoptionen für jede Middleware ab. Probieren Sie es langchain-scaledown aus und lassen Sie uns wissen, was Sie davon halten, im LangChain-Forum, Xoder auf GitHub.