
Wichtigste Erkenntnisse
- Die AI-Suche ermöglicht es den Benutzern, Gespräche aufgrund einer semantischen Verständnis der Spuren zu finden, wie zum Beispiel „War der Benutzer frustriert?“ oder „Wurde PII leaken?“
- Beschreiben Sie das Verhalten in einfacher Sprache, und ein schnelles Entscheidungsmodell liest die Spuren und gibt nur diejenigen zurück, bei denen es stattgefunden hat.
- LangSmith verwendet Trajektionen, um die Trace zu normalisieren, den Kontext zu reduzieren und die Abfragen schnell anzuzeigen.
Agent traces sind groß, multimodal und informativ dicht. Sie erfassen wichtige Details wie Benutzerinput, die Reaktionen des Agenten und Logikfehler. Dadurch sind traces besonders wertvoll für das Verständnis des Benutzerverhaltens und die Verbesserung der Agentleistung, aber traditionelle Datenplattformen waren nicht dafür konzipiert, solche großen, unstrukturierten Datenpakete zu verarbeiten.
Um die Trace-Daten nützlich zu machen, benötigen Teams eine Infrastruktur, die das gesamte Lebenszyklusprozess unterstützen kann: das Eingeben und Speichern großer Volumina, flexibles Abfragen der Trace sowie die Umwandlung dieser Daten in Ansichten für Fehlersuche, Produktanalyse und operative Workflows wie Anmerkungen. Deshalb haben wir SmithDB entwickelt, eine Datenbank, die speziell für Trace-Daten in LangSmith konzipiert ist, und kürzlich auch Custom Apps, die den Teams ermöglichen, personalisierte Ansichten auf ihren Trace zu erstellen.
Heute fügen wir AI Search hinzu – eine neue Methode, um Trace mit natürlicher Sprache abfragen zu können.
Warum wir das AI-Suchsystem entwickelt haben
Jeder Trace enthält Benutzerinput, Agent-Reasoning, Tool-Aufrufe und Antworten – alle Informationen, die notwendig sind, um zu verstehen, wo die Agenten gut funktionieren und wo sie versagen. Teams, die LangSmith verwenden, nutzen oft ihre Agent-Traces, um Beispiele für eine Datenquelle oder Gespräche für einen Überprüfer in einer Annotierkette zu finden.
Allerdings kann die Entdeckung der richtigen Spuren mühsam sein. Fragen wie „Ist PII durchgesickert?“ oder „War der Benutzer verärgert?“ lassen sich nicht sauber auf ein einzelnes Spurattribut wie Tags oder Metadaten übertragen, und können auch nicht mit einer vollständigen Textsuche beantwortet werden. Sie erfordern eine Kenntnis des Inhalts der Spuren. Bis jetzt bedeutete das, dass man einen Bewertungsmechanismus im Voraus einrichten oder die Spuren manuell durchgehen musste.
Deshalb haben wir AI Search entwickelt. Sie beschreiben das Verhalten, nach dem Sie suchen, und LangSmith liefert die Spuren, an denen es stattgefunden hat. Dadurch können Sie die Spuren finden und problematische Muster nach Bedarf durchsuchen.
Was Sie suchen können
Sie können nach allem suchen, was im Inhalt einer Trace erscheint. Sie könnten nach einem Agenten suchen, der behauptete, eine Aufgabe abgeschlossen zu haben, aber das nicht getan hat, nach einem Benutzer, der frustriert wirkte oder auf eine Antwort widersprach, nach einer Anfrage an ein Modell, die PII freisetzt, oder nach jemandem, der versuchte, seine Abonnementverträge zu kündigen. Produktteams können nach „Anfragen für Integrationen, die wir nicht unterstützen“, „genannten Konkurrenten“ oder „benutzerisch verwirrte Onboarding-Prozesse“ suchen und so erkennen, wo das Produkt nicht ausreicht – in den eigenen Worten der Benutzer.
Die AI-Suche funktioniert auch neben den Filteren, die Sie bereits verwenden, sodass eine Suche nur auf Fehler erlittene Trace oder nur mit einem bestimmten Tag durchgeführt werden kann.
Wie wir es gebaut haben
Warum ein Modell jeden Trace liest
Die Vektor-Suche ist die übliche Methode zur Suche nach Bedeutung anstatt nach exakten Wörtern. Sie verwandelt Ihren Suchbegriff und jeden Textabschnitt in eine Embedding, eine kurze Liste von Zahlen, die zeigt, worum es im Text geht. Anschließend werden die Texte zurückgegeben, deren Embeddings am nächsten zu Ihrem Suchbegriff stehen. Das funktioniert gut für Themenuche, wie zum Beispiel das Finden von Gesprächen über Rechnungen. Doch eine Embedding enthält einen ganzen Textabschnitt in einem kleinen Vektor – und diese Komprimierung ist verlustbehaftet. Wichtige Details im Zusammenhang mit Ihrem Suchbegriff können verloren gehen. Ein Spur, auf der der Agent die Arbeit erfolgreich ausführte, und eine andere, in der er nur sagte, dass er es getan hat, führen beide zu fast derselben Einbettung. Um sie voneinander zu unterscheiden, benötigt man ein Modell, das die tatsächlichen Wörter der Spur sowie deine Frage liest, damit es darüber nachdenken kann, was geschehen ist.
Bis vor Kurzem war es zu langsam und zu kostspielig, das bei der Suche durchzuführen. Schnelle Entscheidungsmodelle haben das geändert. Sie beantworten eine einfache Frage zum Eingabewert schnell und günstig genug, um auf großer Skala ausgeführt werden zu können. AI Search kombiniert die Inferenz des Entscheidungsmodells mit SmithDB, unserem Datenlayer für die Beobachtbarkeit von Agenten. Wenn die Traces eintreffen, wandelt SmithDB sie in Trajektorien um. Wenn Sie eine Suche durchführen, verengen Ihre Filter die Kandidaten, und das Entscheidungsmodell prüft jede verbleibende Trajektorie gegenüber Ihrer Beschreibung.
Die Spuren sind groß und kommen in vielen Formaten vor
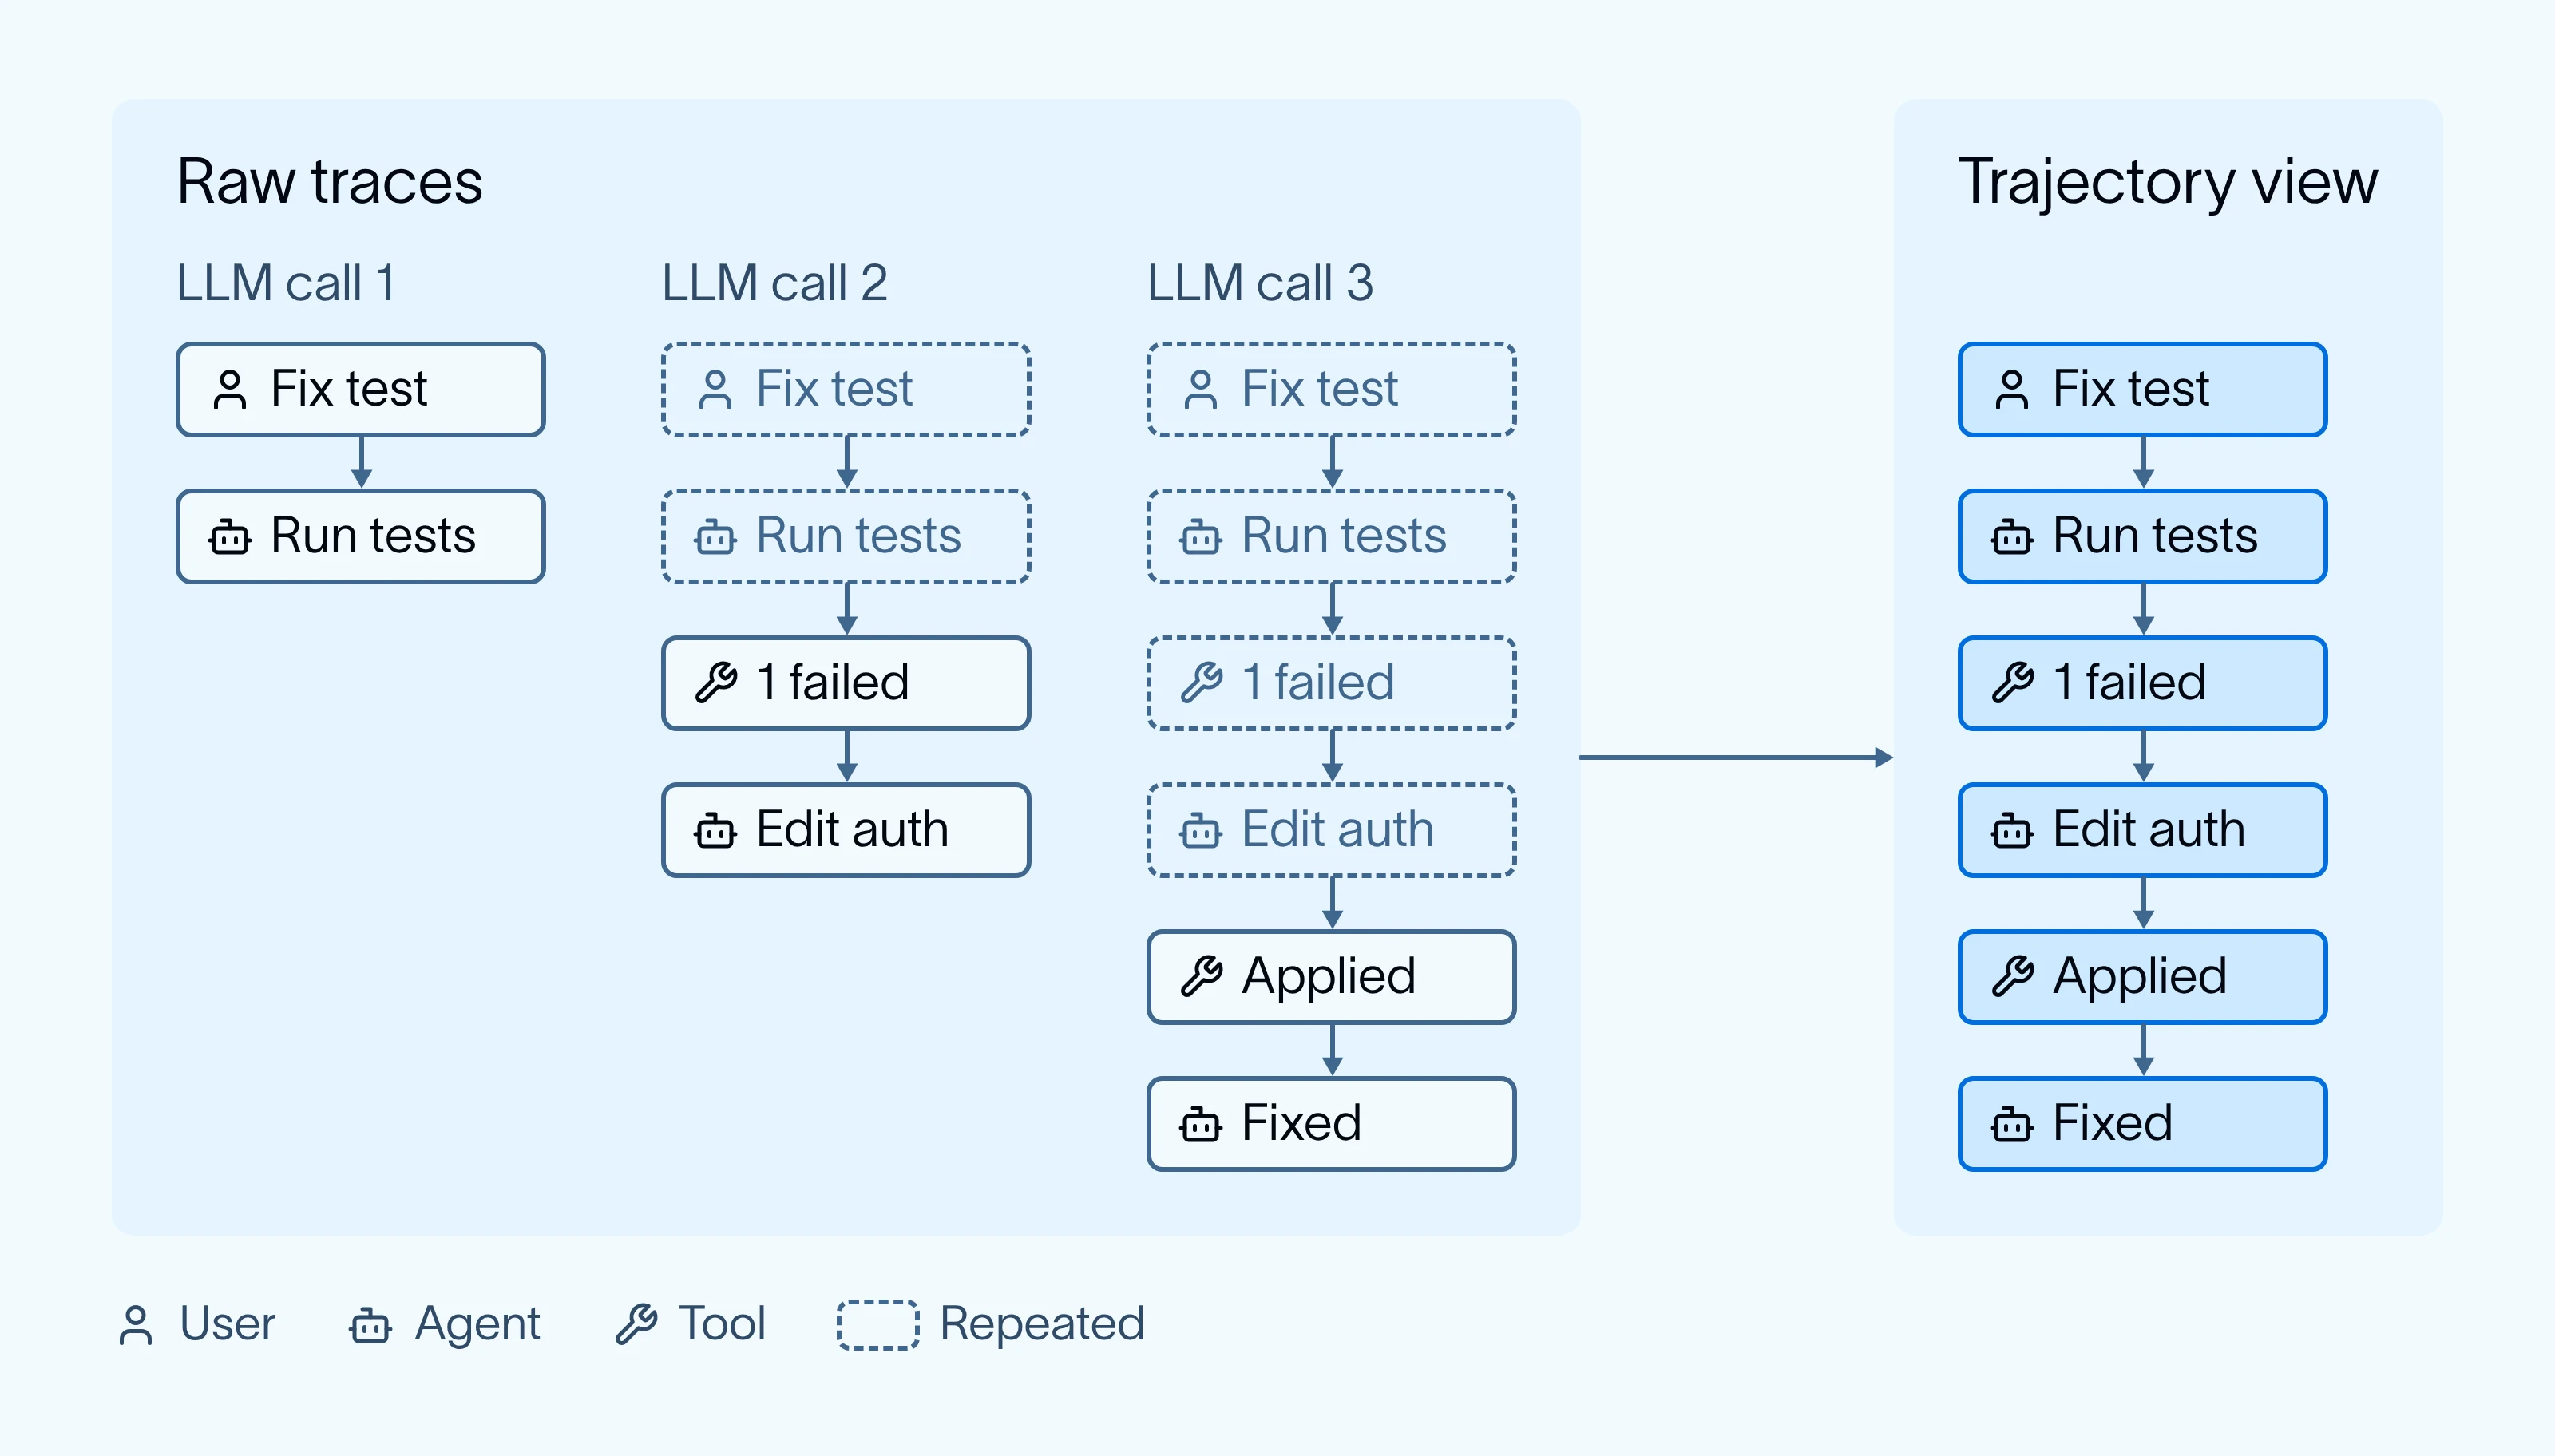
Anzeichen stammen von vielen Quellen: den OpenAI- und Anthropic-SDKs, LangChain, LangGraph, dem Vercel AI SDK, OpenTelemetry und weiteren. Jedes System speichert Nachrichten etwas unterschiedlich. Die Anzeichen wiederholen sich ebenfalls. Die Agenten senden oft die Gesprächshistorie bei jedem LLM-Befehl erneut aus, sodass die erste Nachricht bei jedem weiteren Aufruf erscheint.
SmithDB wandelt diese Spuren in eine Trajektorie für jede Sitzung um. Eine Trajektorie ist eine zusammengefasste Darstellung der Arbeit des Agenten: jeder Nachricht, jeder Toolanruf und jeder Toolergebnis wird einmal aufgeführt. SmithDB erstellt sie, sobald die Spuren eintreffen, und bringt alle unterstützten Formate in dieselbe Form.
Die AI-Suche analysiert Trajektionen anstatt Rohspuren. Da jeder Format die gleiche Trajektionenform aufweist, funktioniert eine Suche über Agenten, die auf verschiedenen SDKs basieren. Das Entfernen der wiederholten Nachrichten reduziert den Kontextverdichtungen, sodass die Suchen schneller ablaufen. Eine Trajektion umfasst außerdem die gesamte Sitzung; wenn man also nach „der Benutzer versuchte abzubrechen“ sucht, erkennt das Modell, was der Benutzer gefragt hat, was der Agent getan hat und wie die Konversation endete.
Die Flugbahnen sind immer noch lang
Die Entfernung von Duplikaten hilft zwar, aber die Trajektorien der Agenten sind immer noch lang. Um ein Gefühl dafür zu bekommen, wie lange das ist, nahmen wir 150 zufällige Gespräche aus Open SWE – dem open source Coding-Agenten, den die LangChain-Team täglich verwendet. Jede Aufgabe läuft in einer eigenen Sandbox mit Shell-Zugriff ab und kann an Subagenten übertragen werden, weshalb die Gespräche groß werden.
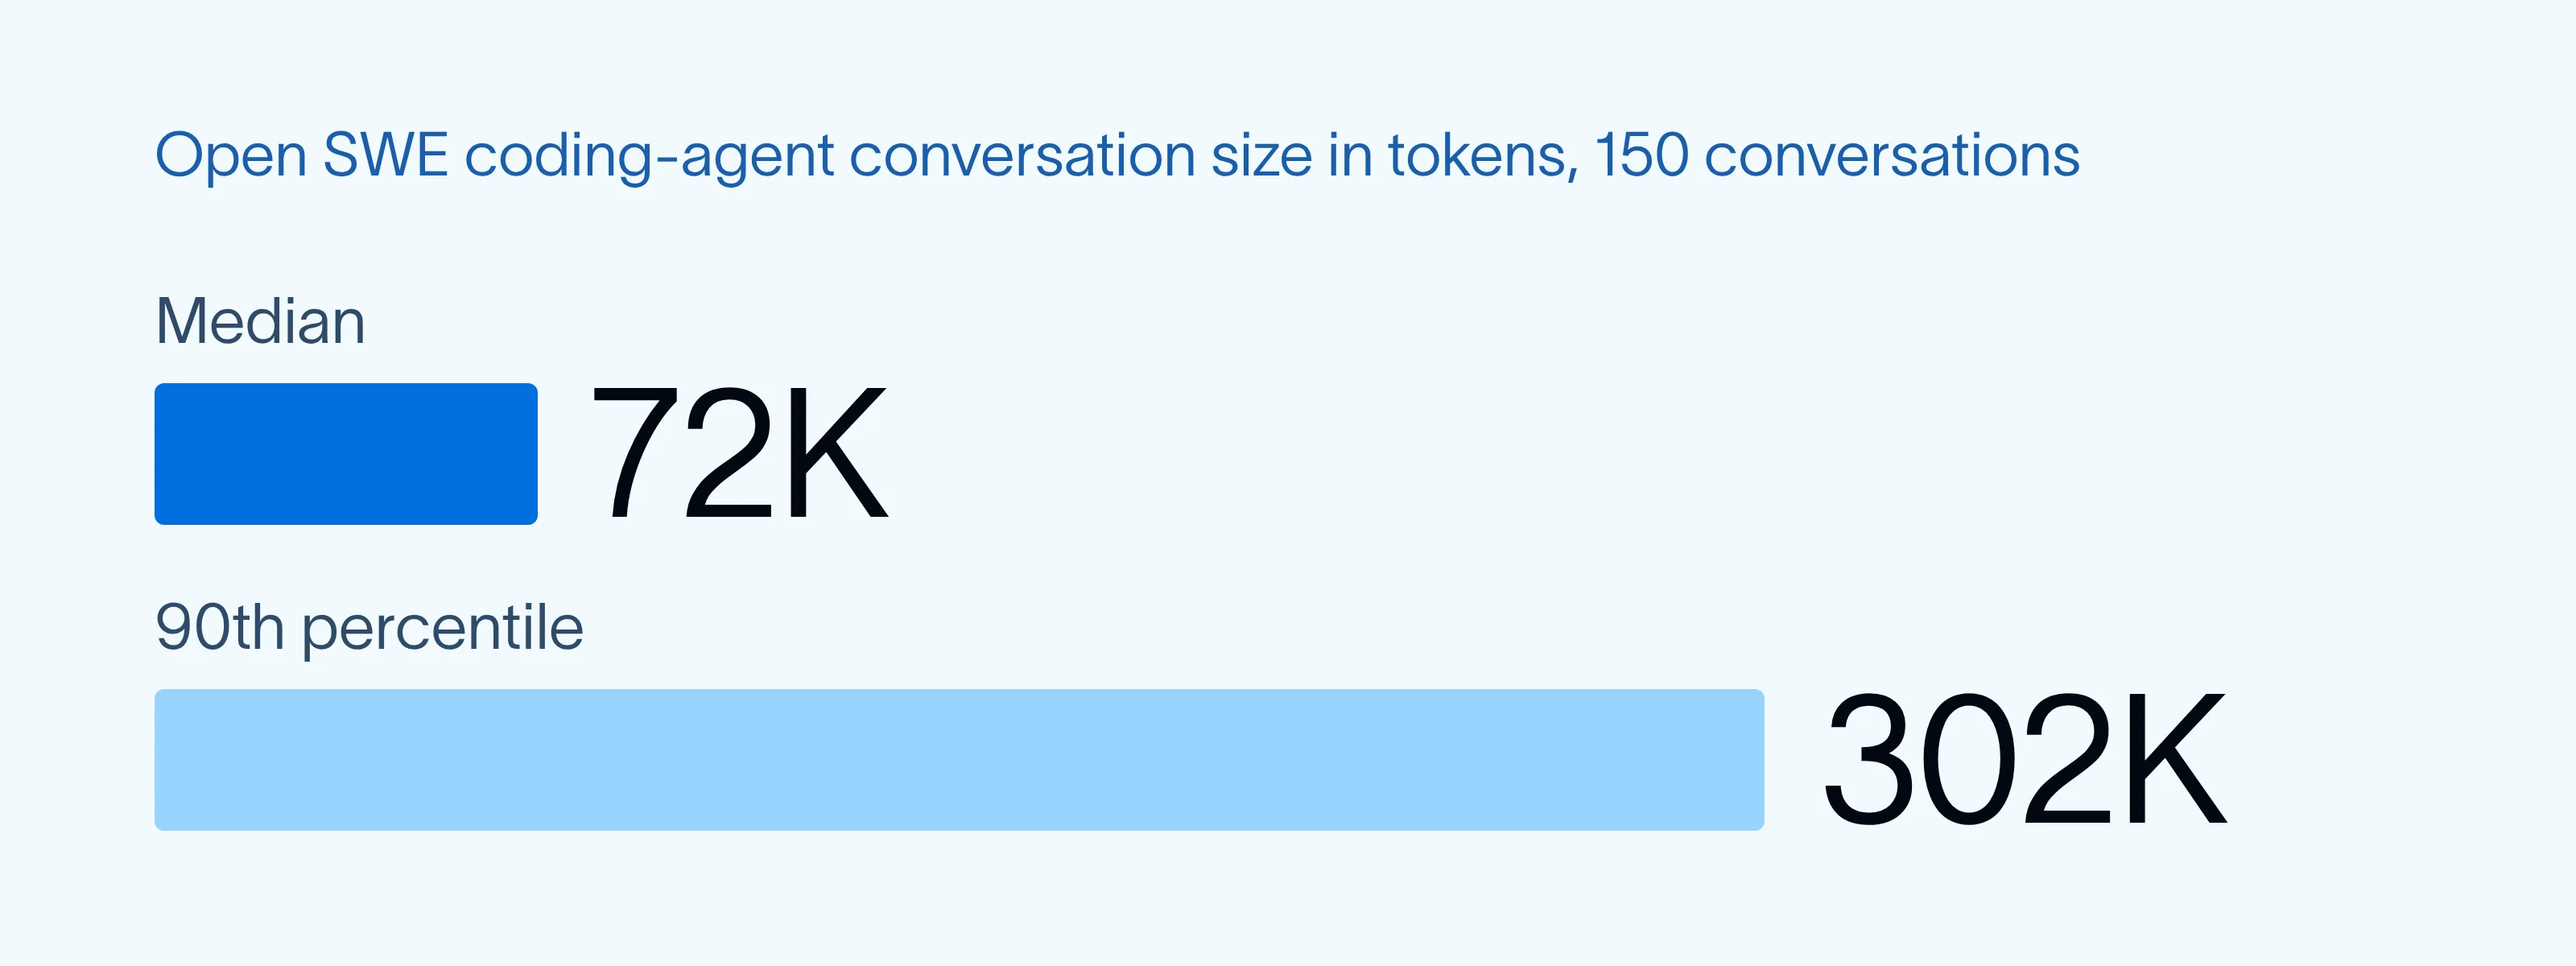
Einige von ihnen verarbeiteten mehr als eine Million Tokens – selbst in einem so kleinen Beispiel. Die Suche nach einem seltenen Verhalten bedeutet, viele Gespräche durchzulesen; daher stößt die AI-Suche regelmäßig auf solche Größen und kann nicht jeden Token lesen.
Die meisten Fragen benötigen jedoch nicht alle diese Tokens. Viele Fragen beziehen sich auf das, was der Benutzer fragt, und wie der Agent antwortet. In der medianen Konversation stammten etwa 2K von den 72K Tokens aus den Nachrichten des Benutzers und den Antworten des Agents. Etwa 85% waren Ausgaben von Tools, hauptsächlich Datei-Readings und Shell-Befehle.
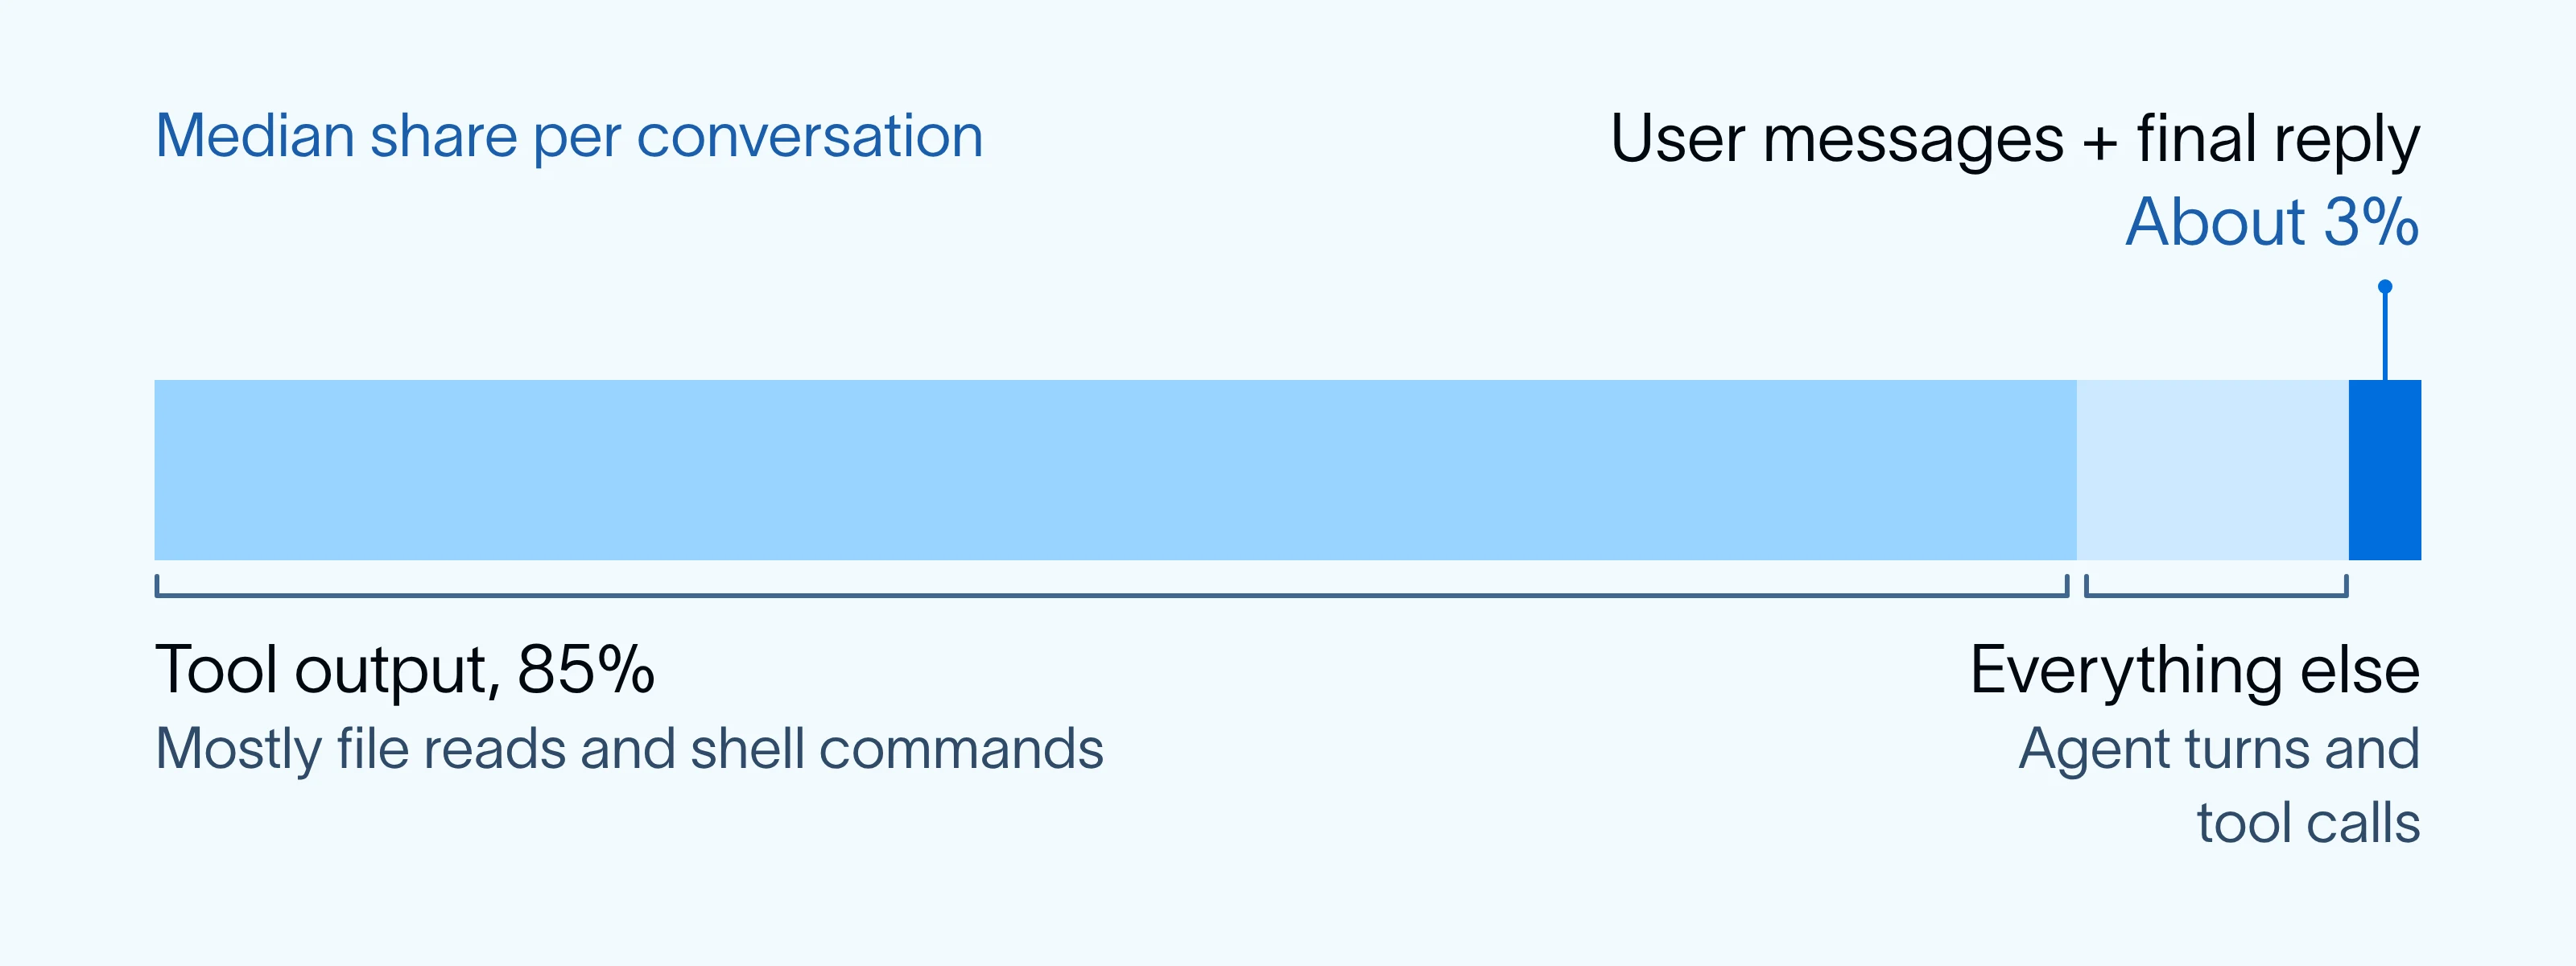
Jede Trajektorie erhält einen festen Token-Budget, der in Prioritätsordnung ausgegeben wird. Benutzernachrichten und die Antworten des Agents an den Benutzer kommen zuerst. Der Rest des Budgets fließt für alles andere: Zwischenmedien der KI (das Denken des Agenten und Tool-Anfragen), Toolergebnisse und Systemnachrichten. Wenn die nächste Nachricht nur teilweise passt, wird sie gekürzt, um das Budget zu erreichen, und alles danach wird entfernt.
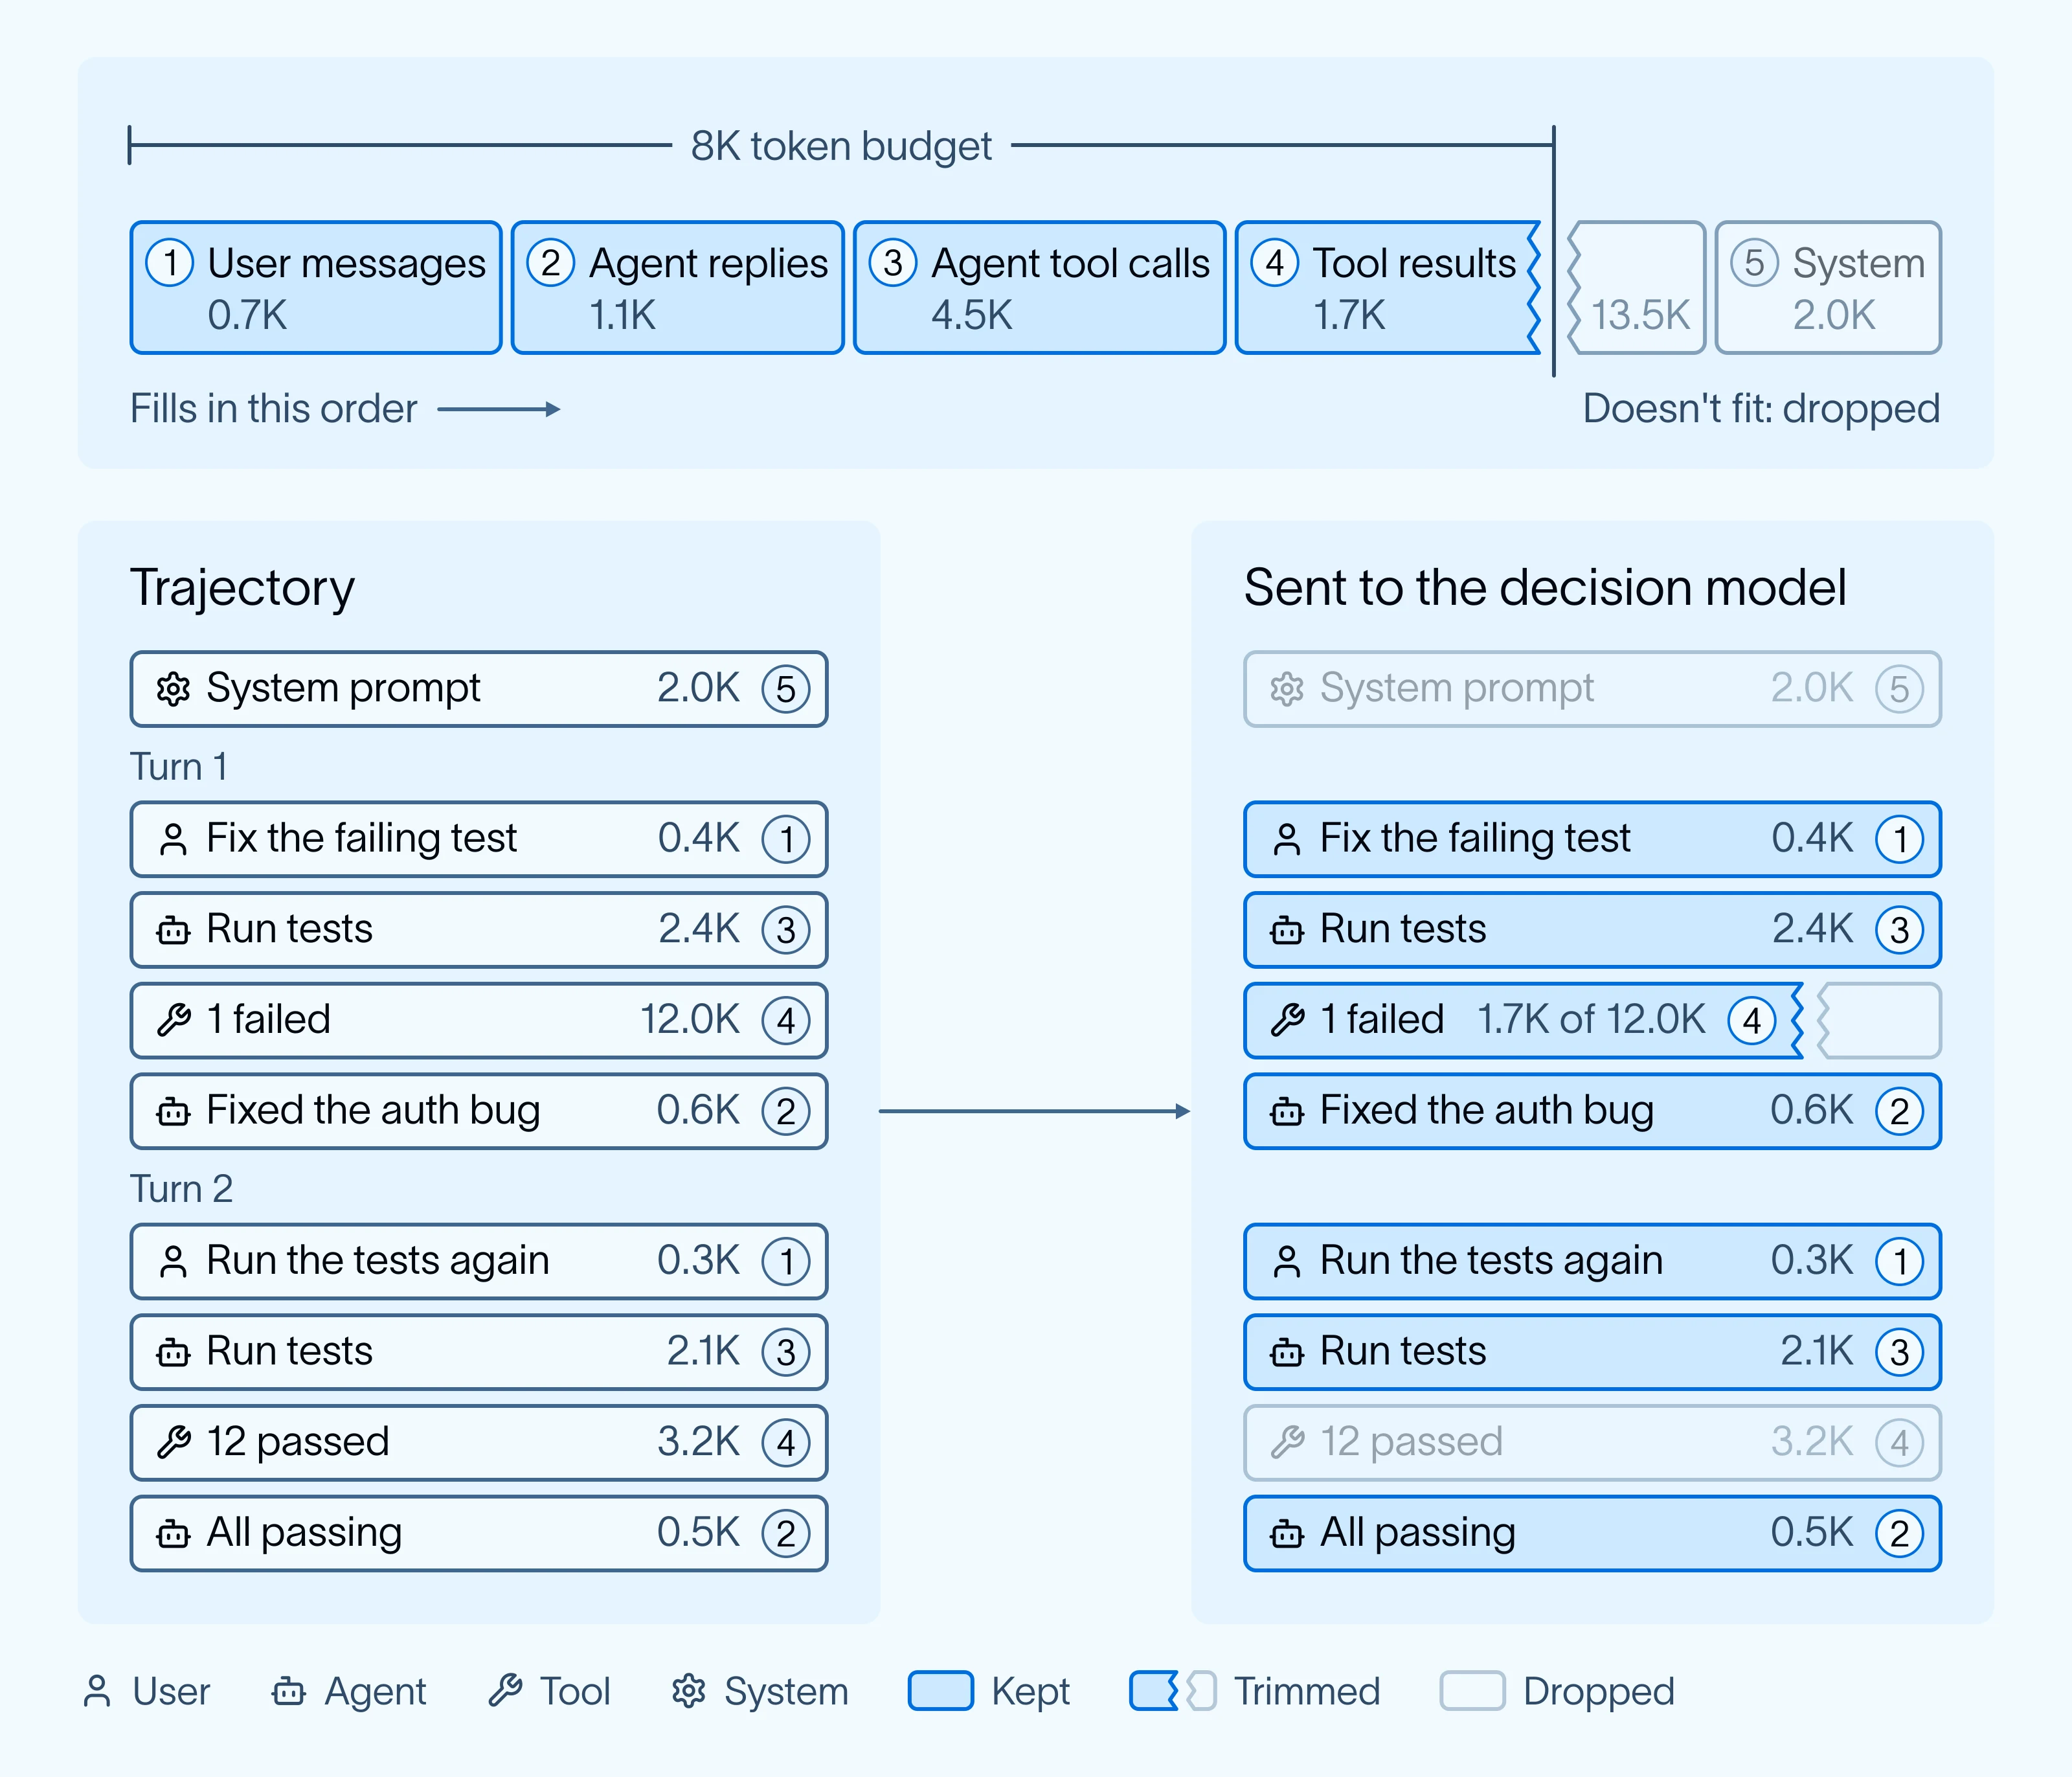
Die Suchoperationen müssen bei größerer Größe schnell bleiben
SmithDB ist entwickelt, um große Mengen an Agent-Trace-Daten zu verarbeiten und zu scannen. Wenn Sie eine Suche durchführen, verengen Ihre strukturierten Filter zunächst die Kandidaten. Das Entscheidungsmodell überprüft dann jede verbleibende Trajektorie parallel mit Ihrer Beschreibung. Während das Modell eine Gruppe von Trajektorien überprüft, erhält SmithDB bereits die nächste Gruppe und bereitet sie vor. Die Übereinstimmungen werden sofort zurückgespielt, sodass Sie nicht auf den vollständigen Scan warten müssen.
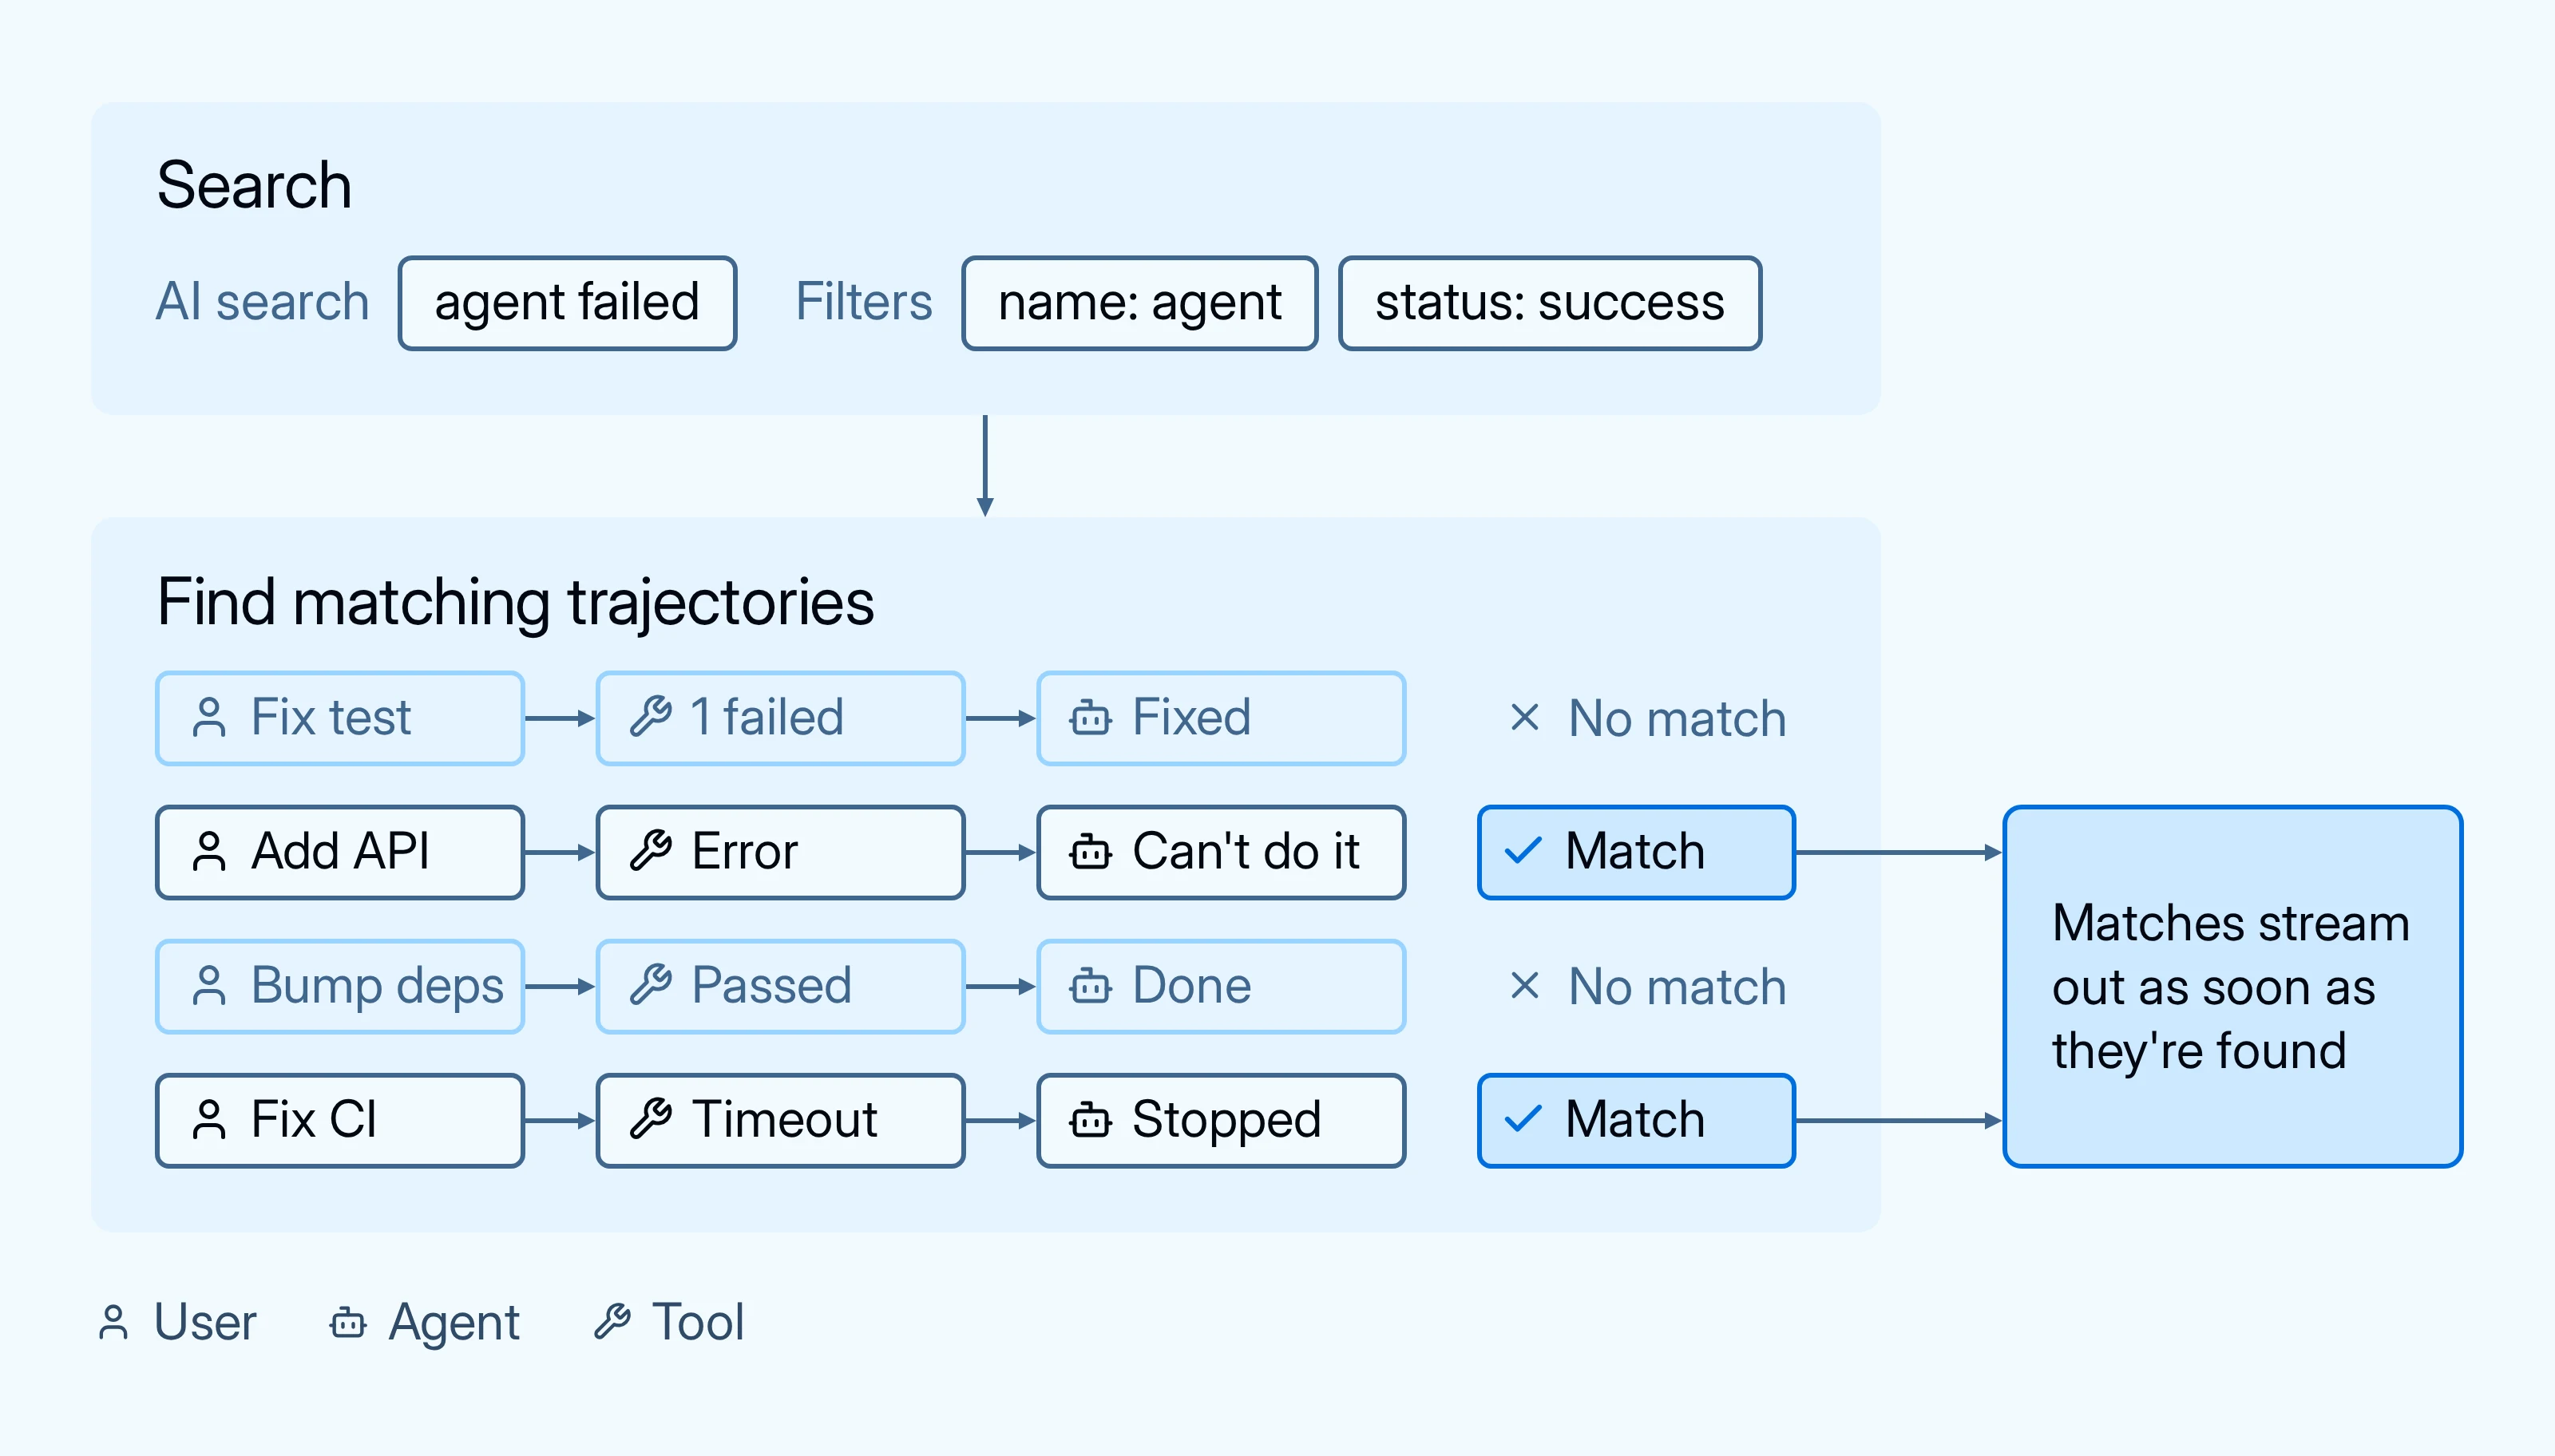
Was kommt als Nächstes
Wir lernen noch immer, welche Fragen die Menschen am häufigsten stellen. Die schwierigsten Konversationen zur Klassifizierung sind jene mit subtilen Unterschieden. Das Aussprechen von „Der Benutzer hat aufgegeben“ im Vergleich zu „Der Benutzer hat bekommen, was er brauchte, und ist gegangen“, kann auf ein paar Sätze in einer langen Entwicklung beruhen. Wir wollen sehen, ob ein Modell, das auf diesen Beobachtungen getuned wurde, diese Unterschiede zuverlässiger unterscheiden kann.
Der Token-Budget-Mechanismus funktioniert gut, wenn die Antwort in dem enthalten ist, was der Benutzer und der Agent gesagt haben. Andere Fragen benötigen andere Beweise. Ein Agent, der einen Tool-Fehler ignoriert, erscheint nur in den Ergebnissen des Tools. Wir untersuchen Möglichkeiten, den Kontext basierend auf der Frage auszuwählen, sowie Signale, die zeigen, wenn das Modell unsicher ist, sodass es eine zweite Durchsatz mit mehr Kontext durchführen kann.
Wir würden auch gerne anstelle einer einfachen Liste der Spiele über ähnliche Ergebnisse gruppieren oder zusammenfassen, was sie gemeinsam haben.
Starten
Die AI-Suche ist in der öffentlichen Beta-Phase auf LangSmith Cloud in den GCP-Regionen US, EU und APAC kostenlos verfügbar. Organisationseigner können sie in den Einstellungen aktivieren, und sie erscheint dann auf der Tracing-Seite. Die AI-Suche-Dokumentation enthält die Details. Teilen Sie uns mit, was Sie suchen.