
Mixture-of-Experts (MoE) ist eine spärlich aktivierte Architektur, die die Kapazität großer Sprachmodelle (LLMs) skaliert und dabei den Rechenaufwand pro Token niedrig hält. Da ihre Operationen einen großen Anteil der gesamten Rechenzeit ausmachen, führen Ineffizienzen dort direkt zu höherer Anfragelatenz und höheren Kosten. Daher bietet die Optimierung von MoE-Operationen durch Kernel-Engineering die größte Chance auf Leistungsgewinne.
Fused MoE ist eine zentrale Optimierungstechnik für die MoE-Architektur. Ein fused-MoE-System vereint Token-Routing, Datenumsortierung und spezialisierte Netzwerkberechnungen in einer einzigen stapelweisen Operation auf der GPU. Dies ersetzt die Ausführung dieser Routing- und Expertenberechnungen als separate, sequenzielle Schleifenoperationen. Während dies Latenzvorteile bietet, bringt es auch Komplexität bei Kernel-Implementierungen und Debugging-Möglichkeiten mit sich. Hohe GPU-Auslastung für diese Architektur erfordert hardwarespezifische Optimierungen.
In diesem Beitrag beschreiben wir die verschiedenen Kernel-Optimierungen, die wir für fused-MoE-Modelle implementiert haben, und zeigen Ihnen, wie Sie von dieser Arbeit profitieren können. Wir haben ein repräsentatives MoE-Modell als unser Hauptbeispiel verwendet.
Swap-AB zur WGMMA-Auslastung
Um den Verarbeitungsdurchsatz der Tensoren zu maximieren, setzt die NVIDIA-Hopper-Architektur auf das Warp Group Matrix Multiply Accumulate (WGMMA)-Instruktionsprotokoll, das kollektiv über eine kooperative Warpgroup von 128 Threads ausgeführt wird. Diese Operandenasymmetrie ist im Wesentlichen eine Eigenschaft auf Ebene der Instruction Set Architecture (ISA). In der zugrunde liegenden wgmma.mma_async Assembly-Definition fixiert die Hardware die Zeilendimension der Matrix (M) auf einer konstanten Skalierung von 64, um ihre parallele Thread-Mapping-Topologie zu definieren. Die Spaltendimension (N) bleibt hochgradig variabel. Operand A wird strikt über diese feste M-Dimension gemappt (unter Verwendung von Registern oder Shared Memory), und Operand B wird über die variable N-Dimension gemappt (durch einen Shared-Memory-Deskriptor). Diese Operanden-Slots sind daher strukturell nicht austauschbar. Folglich wird die Spitzenauslastung der Hardware-Tiles von diesen starren Formkodierungen bestimmt, wobei die M-Dimension mindestens 64 betragen muss, damit die Rechenausführungslanes nicht untätig bleiben.
Diese strukturelle Präferenz ergibt sich daraus, wie Hopper Tensor Cores Speicherblöcke partitionieren. Die Hardware erzwingt ein festes Mindestlayout für die führende Dimension des ersten Operanden und fixiert die Blockhöhe exakt auf 64 (M=64). Wenn eine mathematische Matrix eine große, kontinuierliche führende Dimension in diesem primären Slot besitzt, können die internen Hardware-Scheduler von Hopper die Daten sauber über das physische Rechengitter mappen und verteilen.
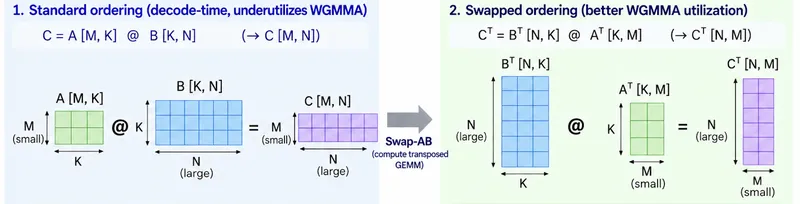
Diese strukturelle Asymmetrie wird in der Dekodierphase von MoE-Netzwerken zu einem schwerwiegenden Leistungsengpass. In einer Standard-MoE-Schicht wird die lineare Algebra, die die Expertenberechnung bestimmt, in traditioneller Matrixnotation formuliert:
A[M,K] x B[K,N] —> C[M,N]
Dabei repräsentiert (M) die Token-Zeilenzahl (oder Batch-Größe), (K) die verborgene Merkmalsdimension und (N) die umfangreiche Experten-Ausgabedimension.
Während der Dekodierphase verarbeitet das System jeweils nur ein Token pro Benutzersequenz. Folglich ist der Batch-Raum bzw. die Token-Zeilengröße äußerst dünn, sinkt regelmäßig auf ein Profil mit (M < 64) und häufig auf eine einzelne Zeile (M = 1). Unter diesem standardmäßigen strukturellen Layout:
verwandelt sich Matrix (A) in einen dünnen, fragmentierten horizontalen Vektor (zum Beispiel 1 x 4096).
Matrix (B) (die eigentlichen Expertengewichte) bleibt ein großer, dichter vertikaler Block (zum Beispiel 4096 x 8192).
Da die Zeilenzahl (M) winzig ist, ist Matrix (A) physisch nicht in der Lage, den festen (64)-Zeilen-Layout-Bucket der Hardware für Operand A zu füllen. Wenn die WGMMA-Instruktion über dieses Layout ausgeführt wird, lässt sie einen gewaltigen Teil der physischen Tensor-Core-Kapazität völlig ungenutzt. Der Chip verbringt Taktzyklen mit der Verarbeitung leerer räumlicher Slots, was zu schlechter Hardware-Auslastung führt.
In einer Standard-Dense-LLM-Schicht sind Gewichtsmatrizen statisch, einheitlich und perfekt zusammenhängend. In einer MoE-Schicht hingegen ist die Arbeitslast über eine Flotte unabhängiger Subnetzwerke (Experten) zersplittert. Dies schafft einzigartige Speicher- und Layout-Engpässe, die das System höchst empfindlich gegenüber den WGMMA-Beschränkungen der Hopper-GPU machen. In einer Standard-Dense-Schicht multipliziert die Matrixmultiplikation einen Token-Vektor mit einer einzelnen Schicht-Gewichtsmatrix. Die Ausgabedimension (N) ist die versteckte Größe des Modells (zum Beispiel 4096).
In einem Fused-MoE-Kernel multipliziert die GPU nicht nur gegen einen Experten. Sie gruppiert und berechnet die Mathematik für alle aktiven Experten gleichzeitig, um zu vermeiden, dass für jeden Experten einzelne Kernel gestartet werden müssen. Für eine Standard-Dense-Schicht ist N die versteckte Größe (4,096). Für eine fusionierte MoE-Schicht ist N die Anzahl der gewählten Experten multipliziert mit der Experten-Zwischengröße. Bei einem Modell, das eine topk=8 Routine ausführt, explodiert die effektive N-Dimension innerhalb des fusionierten Kernels in Zehn- oder Hunderttausende von Parametern. Da die N-Dimension im Vergleich zur winzigen Dekodier-Token-Größe (M=1) so unverhältnismäßig groß ist, wird die Layout-Asymmetrie extrem. Das Transponieren der Matrizen verschiebt diese große, kombinierte MoE-Dimension in den primären Slot und erschließt Hardware-Prefetching in einem Maßstab, den Standard-Dense-Schichten nicht erreichen können.
Um diese Hardware-Fehlausrichtung zu beheben, ohne die zugrunde liegende mathematische Integrität des Modells zu verändern, nutzen wir die algebraische Eigenschaft der Matrixtransposition:
BT[N,K] x AT[K,M] —> CT[N,M]
Abbildung 1: Swap-AB zur WGMMA-Auslastung
Durch programmgesteuertes Umdrehen der Matrixmultiplikation, bevor sie die PTX-Assemblierungsschicht erreicht, brachten wir die Software in Übereinstimmung mit der exakten Topografie des Hopper-Siliziums. Diese Transposition löst zwei unmittelbare architektonische Vorteile auf der GPU aus. Zuerst sättigt sie das physische Layout. Die ausgedehnte Experten-Dimension (N = 8192) wird auf die erste Operandenposition (BT) befördert, und weil (N) groß ist, überschwemmt sie problemlos die obligatorische Hardware-Schwelle von (64) Zeilen. Die Tensor Cores arbeiten dann mit maximaler lokaler Dichte ohne verschwendete Ausführungszyklen. Zweitens aktiviert sie asynchrones Prefetching. Hoppers dedizierte Hardware-Kopier-Einheiten können Speicheradressen asynchron aus dem Shared Memory direkt in Register vorladen, bevor der Mathe-Ausführungsblock auslöst. Wenn die kontinuierlichen, großen Gewichtsblöcke (BT) im führenden Slot platziert werden, können diese Einheiten dem Datenlayout reibungslos folgen und die Compute-Pipeline ohne CPU-Eingriff gesättigt halten. Dies führte zu einer 2–4 prozentigen Verbesserung des End-to-End-Ausgabedurchsatzes bei großskaligen MoE-Modellen auf dem H200. Wir haben diese Optimierung zu vLLM hochgeladen, und sie ist in Version 0.24.0 oder später verfügbar.
Backend-Routing für FP8-Tensor-Quantisierung
Über die Kernel-Interna hinaus hat die Wahl, welches Backend die MoE-Berechnung ausführt, eine große Auswirkung auf die Leistung. Der vLLM-MoE-Oracle routet verschiedene Quantisierungsschemata zu Triton, FlashInfer+CUTLASS oder anderen Backends. Profiling zeigte, dass das Triton-Backend bei FP8-tensorquantisierten Modellen auf Hopper das Standard- FLASHINFER_CUTLASS verhalten durchgängig übertrifft.
Das Triton-Backend übertrifft CUTLASS bei MoE-Workloads mit geringer Parallelität hauptsächlich, weil es starre, Framework-level-Matrix-Mathe-Konfigurationen durch benutzerdefinierte, Operator-level-Register-Fusion ersetzt. CUTLASS stützt sich auf standardmäßige C++-Template-Strukturen, die FP8-Tensor-Skalierung, Matrixmultiplikation und Expertenaggregation als diskrete mathematische Operationen behandeln. Das Triton-Backend fasst stattdessen diese gesamte Pipeline in einem einzigen Hardware-Durchlauf zusammen. Daten werden genau einmal aus dem globalen Hochbandbreitenspeicher (HBM) gezogen und vollständig innerhalb der ultraschnellen lokalen SRAM-Register und Compute-Execution-Files der GPU verarbeitet. Anschließend werden sie zurück zum endgültigen Matrix-Ziel gestreamt. Dies entfernt die langsamen globalen VRAM-Lese-/Schreib-Roundtrips, die CUTLASS beeinträchtigen, wenn es gezwungen ist, ständig durch Zwischenschritte der Tensor-Skalierung zu iterieren.
Darüber hinaus ist diese Register-level-Fusion speziell mit dynamischen Scheduling-Layouts gepaart, die um variables Token-Bucketing herum entworfen wurden, und löst damit einen schwerwiegenden strukturellen Fehler traditioneller Kompilierungs-Templates. CUTLASS ist nativ für dichte, große und vorhersagbare Matrixdimensionen optimiert. Wenn es auf die flüssigen, ultradünnen Batch-Profile (M < 64 oder M = 1) trifft, wie sie in der Live-Decode-Generierungsphase typisch sind, werden seine standardmäßigen Block-Tiling- und Thread-Mapping-Strukturen profund ineffizient. Das Ergebnis ist starke Warp-Unterauslastung oder teurer Memory-Padding-Overhead. Umgekehrt ist das Triton-MoE-Backend hervorragend darin, diese kleinen, fragmentierten Token-Arrays dynamisch über die physischen Grenzen der aktiven Expertengewichte hinweg zu mappen. Dies hält die internen Prefetch-Streams der Hardware und die Tensor-Core-Pipelines vollständig gesättigt, selbst bei der Verarbeitung hochinstabiler Workloads mit sehr kleinen Batch-Größen.
Die Aktualisierung der Routing-Richtlinie ist eine reine Konfigurationsänderung, bei der kein Kernel-Code modifiziert wurde. Dennoch brachte sie eine 10 prozentige End-to-End-Durchsatzverbesserung für FP8-quantisierter Fused-MoE-Modelle auf dem H200. Diese Verbesserung ist im AWS Large Model Inference (LMI) v28 Container verfügbar.
Vermeidung der Triton-JIT-Neukompilierung
Eine der wirkungsvollsten Leistungspathologien im GPU-Inferenzieren ist zugleich eine der unauffälligsten: unnötige Kernel-Neukompilierung. Triton, das Compiler-Framework, auf dem viele der benutzerdefinierten vLLM-Kernel basieren, spezialisiert ganzzahlige Argumente standardmäßig. Jedes Mal, wenn ein Kernel mit einem zuvor ungesehenen Wert für einen spezialisierten Parameter aufgerufen wird, löst Triton eine frische Just-in-Time-(JIT)-Kompilierung aus. In Serving-Workloads, in denen Sequenzlängen und Batch-Größen kontinuierlich variieren, entsteht daraus ein stetiger Strom von Kompilierungs-Overhead, der die Latenz aufbläht, insbesondere die Time to First Token (TTFT).
Im MoE-Modell-Serving wurde der _fused_inv_rope_fp8_quant_per_head Kernel (zuständig für Fused Rotary Position Embedding und FP8-Quantisierung) bei jedem neuen num_tokens Wert neu kompiliert. Das Hinzufügen von do_not_specialize Annotationen zu den Parametern variabler Länge entfernte diese Neukompilierungen vollständig und verbesserte die TTFT um 9 Prozent auf dem H200 bei 8-fachem Tensor-Parallelismus (PR #42849).
In einem Multi-GPU-Cluster müssen alle 8 GPUs ihre Kernel in perfekter, mikrosekundengenauer Synchronisation ausführen. Wenn auch nur eine GPU anhalten muss, um ihren lokalen _fused_inv_rope_fp8_quant_per_head Kernel neu zu kompilieren, weil sich ihre lokale Token-Batch-Anzahl geändert hat, sitzen die anderen sieben GPUs untätig da und warten auf sie. Durch die Beseitigung von Neukompilierungen im gesamten Cluster glätteten wir den Multi-GPU-Koordinationsoverhead und erzielten eine 9 prozentige Beschleunigung der anfänglichen Antwortlatenz für den Nutzer. Das Prinzip dabei ist, den Compiler als erstklassige Optimierungsfläche zu behandeln. Das Verständnis, wie Triton Spezialisierungssemantik handhabt, und das Erkennen, wann Parameter totd oder variabel sind, erschließt Latenzverbesserungen mit minimalem Codeaufwand.
Wir haben diese Optimierung zu vLLM hochgeladen, und sie ist in Version 0.22.0 oder später verfügbar.
Fazit
Durch unsere Zusammenarbeit mit der vLLM-Community haben wir mehrere Kernel-Optimierungen für fused MoE-Modelle implementiert und als Open Source veröffentlicht. Wir wenden diese Optimierungen im LMI Deep Learning Container auf Amazon SageMaker AI an. Zusammen haben diese Optimierungen einen bis zu 10 Prozent höheren Durchsatz und ein bis zu 9 Prozent schnelleres TTFT ermöglicht. Informationen zu den ersten Schritten mit dem Hosting eigener Modelle finden Sie in der Amazon SageMaker AI Hosting-Dokumentation.