
SpaceXAI’s Grok 4.7 ist jetzt auf Amazon Bedrock verfügbar, das eine Auswahl von Foundation Models (FMs) von mehreren Anbietern bietet. Laut SpaceXAI wurde Grok 4.7 darauf trainiert, länger an schwierigeren Aufgaben zu arbeiten, und weiß, wann es seine eigene Arbeit überprüfen muss. Das ist vor allem für Agenten relevant, die eine Aufgabe über viele Schritte hinweg ausführen und dabei überprüfen müssen, was sie unterwegs finden.
Ein Agent, der auf diese Weise arbeitet, muss mehr tun, als nur Dinge nachzuschlagen. Er muss eine Kandidatenantwort formulieren, sie mit dem abgleichen, was er gelernt hat, und sie verfeinern, bis sie passt. Grok 4.7 bietet eine Reasoning-Effort-Einstellung, die steuert, wie viel Nachdenken vor jeder Antwort stattfindet, und bei Agenten-Workloads ist eine praktische Frage, welche Stufe verwendet werden soll.
In diesem Beitrag bauen wir einen Tool-calling-Agenten auf Grok 4.7 und bewerten ihn an drei Aufgaben, die Suche statt Nachschlagen erfordern. Die Aufgaben sind: die Diagnose eines Ausfalls von zwei Diensten anhand seiner Warnmeldungen, die Planung von Wartungsarbeiten unter sich beeinflussenden Randbedingungen und die Auswahl eines optimalen Satzes von Migrationen unter einem Budget. Jede Aufgabe hat genau eine richtige Antwort, die per Brute-Force verifiziert wurde. Wir haben alle drei auf jeder Reasoning-Effort-Stufe ausgeführt, jeweils sechsmal, für insgesamt 72 Agentenläufe.
Der Agent antwortete bei 67 von 72 Läufen korrekt. Bei xhigh antwortete er auf alle 18 korrekt, und bei low antwortete er bei 15 von 18 korrekt, während er etwa ein Achtel der Ausgabe-Tokens verwendete. Das ergibt einen klaren Trade-off, den Sie pro Anfrage abstimmen können, und wir zeigen, wie Sie ihn bei Ihren eigenen Aufgaben messen und in der Produktion überwachen können.
Wir geben durchgehend Token-Zahlen anstelle von Währungsbeträgen an. Token-Preise ändern sich, und die Zahlen sind das, woraus Ihre eigenen Kosten abgeleitet werden, daher bleibt eine in Tokens ausgedrückte Messung gültig.
Was SpaceXAI über Grok 4.7 berichtet
Laut SpaceXAI verwendet Grok 4.7 ein größeres Basismodell als Grok 4.6 und wurde mit einem längeren Reinforcement-Learning-Lauf zu einer härteren Mischung von Aufgaben trainiert. Diese Mischung ist auf Probleme ausgerichtet, deren Bearbeitung viele Stunden dauert. SpaceXAI berichtet, dass das Modell besser darin ist, seine eigene Arbeit zu überprüfen und längere Kontexte zu verwalten.
Die veröffentlichten Benchmark-Ergebnisse von SpaceXAI folgen dieser Gewichtung. Die größten berichteten Verbesserungen gegenüber Grok 4.6 zeigen sich in den Kategorien, die anhaltende Arbeit statt Antworten in einer einzigen Runde messen.
| Benchmark | Kategorie | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | Mehrstündige Terminal-Arbeit | 20.3% | 37.6% |
| EEBench | Elektrotechnik | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | Juristische Arbeit | 15.8% | 19.6% |
| CursorBench 4.0 | Länger andauernde Programmierarbeit | 40.4% | 46.3% |
| HealthBench Professional | Klinisches Reasoning | 48.5% | 56.7% |
| AA Briefcase v1.1 | Mehrstündige Büroarbeit | 1,546 | 1,657 |
Quelle: SpaceXAI, Introducing Grok 4.7 (https://x.ai/news/grok-4-7). Die Punkte sind wie von SpaceXAI zum Zeitpunkt des Modell-Launches veröffentlicht.
Benchmarks zeigen, wie ein Modell bei Standardaufgaben abschneidet. Für Ihre eigene Workload ist der sinnvolle nächste Schritt, an Aufgaben zu messen, die Ihren ähneln – genau das wird im Rest dieses Beitrags durchgespielt.
SpaceXAI führt ein Kontextfenster von 500K Token für Grok 4.7 auf, mit Text- und Bildeingabe sowie Textausgabe. Auf Amazon Bedrock unterstützt das Modell konfigurierbare Reasoning-Anstrengung, Tool Calling und strukturierte Ausgabe.
So greifen Sie auf Grok 4.7 auf Amazon Bedrock zu
Grok 4.7 läuft auf dem bedrock-runtime Endpunkt und wird über ein cross-Region inference Profil aufgerufen. Zwei Profile sind verfügbar:
| Inferenzprofil | Routing | Verwendung, wenn |
| us.xai.grok-4.7 | Innerhalb der US-Geografie | Sie haben Anforderungen an die Datenresidenz in den USA |
| global.xai.grok-4.7 | Kommerzielle AWS-Regionen | Sie haben keine Residenzbeschränkungen und möchten die größtmögliche Kapazität |
Cross-Region-Inference leitet Anfragen über mehrere AWS-Regionen weiter, was Ihnen einen höheren Durchschnitt ohne Verwaltung der Kapazität Region für Region verschafft. Anfragen geben eines der Inferenzprofile anstatt einer reinen Modell-ID an.
Das Modell unterstützt die OpenAI-kompatiblen Chat Completions- und Responses-APIs sowie die Amazon Bedrock Converse API. Bei Converse wird das Reasoning als ein reasoningContent -Block zusammen mit dem text -Block zurückgegeben. In inferenceConfigsetzen Sie maxTokens nur und geben modellspezifische Parameter, wie z. B. den Reasoning-Aufwand, in additionalModelRequestFields.
Die aktuelle Liste der unterstützten Regionen, Service-Tiers und Token-Preise finden Sie in der Grok 4.7-Modellkarte im Amazon Bedrock User Guide und auf der Amazon Bedrock-Preisseite (https://aws.amazon.com/bedrock/pricing/).
Voraussetzungen
- Ein AWS-Konto mit Zugriff auf Amazon Bedrock und aktiviertem Modellzugriff für Grok 4.7.
- Python 3.9 oder höher, mit
openai,boto3undaws-bedrock-token-generatorinstalliert. - AWS-Anmeldeinformationen, die in Ihrer Umgebung konfiguriert sind.
Ihre AWS Identity and Access Management (IAM)-Identität benötigt bedrock:InvokeModel sowohl für das Inferenzprofil als auch für das Standardprojekt Ihres Kontos:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7oder dasglobal.-Äquivalent.arn:aws:bedrock:{region}:{account-id}:project/default.
Fügen Sie beide Ressourcen in die Policy-Anweisung ein. Die Berechtigung für das Standardprojekt ist zusätzlich zum Inferenzprofil erforderlich.
Verbindung zum Modell herstellen
Für den Produktiveinsatz empfehlen wir, aus Ihren vorhandenen AWS-Anmeldeinformationen ein kurzlebiges Bearer-Token zu generieren, sodass die Authentifizierung an Ihre IAM-Identität gebunden bleibt und kein langlebiges Geheimnis gespeichert wird:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
Reasoning-Tokens zählen als Ausgabe-Tokens und werden max_completion_tokens abgezogen, bevor der Antworttext erzeugt wird, also bemessen Sie das Limit so, dass für beides Raum bleibt. Wird das Limit während des Reasoning erreicht, wird die Antwort ohne Antworttext zurückgegeben; prüfen Sie daher in Agent-Code auf leere Inhalte und erhöhen Sie das Limit, wenn Sie dies feststellen. Unsere Läufe verwendeten ein Limit von 32,768 Tokens, was bei jeder Effort-Stufe Spielraum ließ.
Grok 4.7 unterstützt vier Aufwandsstufen: low, medium, highund xhigh. Die Aufwandsstufen können sich zwischen Modellversionen ändern, daher lohnt es sich, sie gegen den Dienst zu prüfen, statt eine Liste fest einzucodieren:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
Designaufgaben, die Schlussfolgern erfordern
Viele Agenten-Bewertungen testen Fleiß: einen Datensatz lesen, filtern, zusammenzählen. Solche Aufgaben sind wertvoll, aber um zu sehen, was der Reasoning-Aufwand beiträgt, muss eine Aufgabe Suche erfordern: Die Antwort lässt sich nicht direkt aus den Daten ablesen, sie muss vorgeschlagen und dann überprüft werden.
Wir haben eine synthetische Umgebung mit 20 Diensten gebaut, die über sieben Tools bereitgestellt wird, und drei Aufgaben darauf aufgebaut. Jede Aufgabe hat genau eine richtige Antwort, und jede ist so konstruiert, dass eine schnelle Heuristik nicht ausreicht, um sie zu finden.
| Aufgabe | Was der Agent tun muss | Was sie zu einer Reasoning-Aufgabe macht |
| two_fault_diagnosis | Zwei Dienste fielen um 03:00 lautlos aus und 12 andere lösten Warnungen aus. Identifizieren Sie die beiden ausgefallenen | Fehlgeschlagene Dienste lösen keine Alerts aus, daher ist die Antwort nicht unter den Alarmdiensten. 190 mögliche Paare, und nur eines erklärt genau die beobachteten Alerts |
| maintenance_schedule | Acht Dienste über vier Nächte patchen, zwei pro Nacht, unter zehn Constraints und einer Regel, dass zwei Dienste desselben Teams nie eine Nacht teilen | 2,520 mögliche Pläne, einer gültig. Die Teamregel hängt von Daten ab, die der Agent nachschlagen muss |
| migration_budget | Kandidaten für die Migration auswählen, die die Risikoreduktion innerhalb eines Budgets maximieren, einschließlich transitiver Voraussetzungen | 53 zulässige Mengen, eine optimal. Die beste Ratio zuerst zu wählen ergibt eine Menge, die neun Punkte unter dem Optimum liegt |
Vier Praktiken halten eine solche Messung vertrauenswürdig, und sie gelten für die meisten Agent-Evaluierungen.
Jede Regel, auf die der Grader sich verlässt, ausdrücklich angeben. Lässt der Prompt einen Randfall offen, kann eine vernünftige Antwort als falsch bewertet werden, und die Evaluierung misst am Ende die Spezifikation statt des Modells. Der Diagnose-Prompt sagt beispielsweise ausdrücklich, dass ein fehlgeschlagener Dienst keinen eigenen Alert auslöst.
Nachweisen, dass jede Aufgabe eine Antwort hat. Jede Umgebung ist klein genug zum Aufzählen, daher haben wir jede mögliche Antwort geprüft, bevor wir irgendetwas ausgeführt haben. Beim Zeitplan sind das ein paar Zeilen:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
Eine erforderliche Schlusszeile benoten, nicht die gesamte Antwort. Jeder Prompt fordert den Agenten auf, mit einer Zeile wie FINAL: auth, checkoutzu enden. Der Grader liest nur diese Zeile, daher wird eine Antwort, die andere Kandidaten diskutiert, während sie ihre Begründung erläutert, anhand ihrer Schlussfolgerung benotet:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
Format getrennt von Korrektheit verfolgen. Eine fehlende Schlusszeile ist ein anderes Signal als eine inkorrekte. In unseren Läufen enthielten alle 72 Antworten eine benotbare Schlusszeile.
Tool-Parameter mit einem enum einschränken, wenn die gültigen Werte bekannt sind, sodass jeder Tool-Aufruf eine echte Ressource anspricht:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
Der System-Prompt ist absichtlich kurz und fordert den Agenten auf, seine Antwort vor der Ausgabe zu prüfen:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
Die Agent-Schleife ist eine Standard-Tool-Calling-Schleife: das Modell mit gesetztem reasoning_effort aufrufen, jeden zurückgegebenen Tool-Aufruf ausführen, das Ergebnis unter dem Schlüssel tool_call_idanhängen und wiederholen, bis das Modell keine Tools mehr anfordert. Das Verfolgen von prompt_tokens und completion_tokens über die Schleife ergibt die im folgenden Abschnitt berichteten Token-Zahlen.
Ergebnisse
Sechs Läufe pro Aufgabe pro Effort-Stufe, insgesamt 72 Läufe. Der Agent antwortete 67 Mal korrekt.
| Aufgabe | low | medium | high | xhigh |
| two_fault_diagnosis | 5 von 6 | 6 von 6 | 6 von 6 | 6 von 6 |
| maintenance_schedule | 5 von 6 | 5 von 6 | 5 von 6 | 6 von 6 |
| migration_budget | 5 von 6 | 6 von 6 | 6 von 6 | 6 von 6 |
| Alle drei Aufgaben | 15 von 18 | 17 von 18 | 17 von 18 | 18 von 18 |
| Pro Durchlauf | niedrig | mittel | hoch | xhoch |
| Mittlere Ausgabe-Tokens | 1,184 | 6,430 | 6,778 | 9,147 |
| Ausgabe-Tokens relativ zu niedrig | 1.0x | 5.4x | 5.7x | 7.7x |
| Mittlere Tool-Aufrufe | 17.2 | 18.7 | 17.8 | 18.1 |
| Median der verstrichenen Zeit | 18 s | 98 s | 89 s | 106 s |
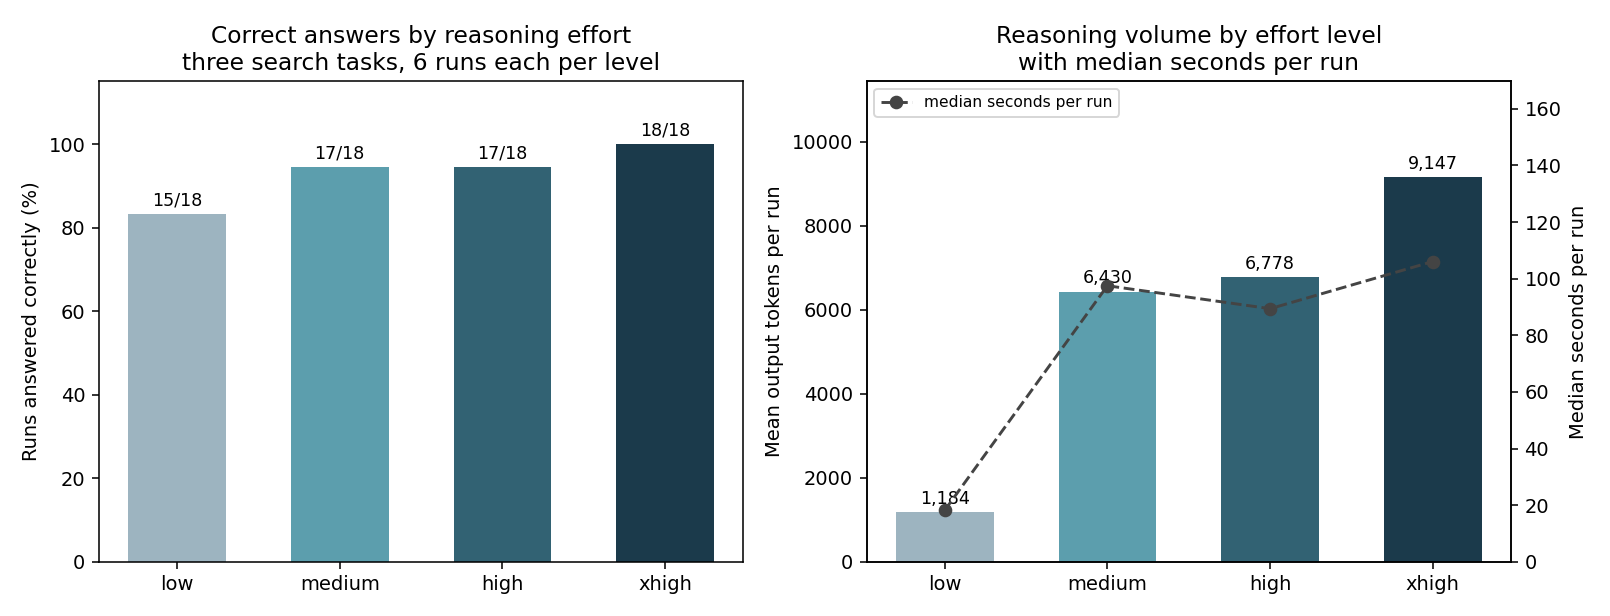
Abbildung 1: Anteil der Durchläufe, die bei jeder Reasoning-Effort-Stufe korrekt beantwortet wurden (links), sowie mittlere Ausgabe-Tokens pro Durchlauf mit eingeblendetem Median der Sekunden pro Durchlauf (rechts)
Drei Beobachtungen.
xhigh beantwortete jeden Durchlauf korrekt. Alle 18 Durchläufe über die drei Aufgaben hinweg waren korrekt bei xhigh, und medium und high und beantwortete jeweils 17 von 18 richtig. Mit sechs Läufen pro Aufgabe und Stufe sind die Unterschiede zwischen den Stufen eher indikativ als statistisch belastbar, und die Richtung war über alle drei Aufgaben hinweg konsistent.
Der Effort verändert, wie viel der Agent reasoniert, nicht wie viel er erkundet. Die Tool-Aufrufe blieben im Wesentlichen konstant, zwischen 17,2 und 18,7 pro Lauf auf jeder Stufe. Der Agent sammelte dieselben Fakten unabhängig vom Effort, und was sich änderte, war, wie viel Reasoning er darauf anwendete, wobei die Output-Tokens von 1.184 bei low auf 9.147 bei xhigh.
low bietet ein starkes Kosten-Nutzen-Verhältnis. Bei lowbeantwortete der Agent 15 von 18 Läufen korrekt und verbrauchte dabei etwa ein Achtel der Output-Tokens von xhigh, mit einem Median-Lauf von 18 Sekunden. Wo eine etwas niedrigere Abschlussquote akzeptabel ist oder wo Antworten nachgelagert geprüft werden, low ist eine effiziente Wahl. Wo jede Antwort beim ersten Mal richtig sein muss, sind höhere Stufen die sicherere Voreinstellung.
Wie das Anstrengungsniveau die Antwort beeinflusst
Die Aufgaben wurden um eine bestimmte Art von Schwierigkeit herum entworfen, und ein Blick darauf, wie jedes Anstrengungsniveau sie bewältigte, verdeutlicht, wann sich das zusätzliche Nachdenken lohnt.
Optimierung. Die Migration-Aufgabe belohnt es, Kombinationen zu betrachten, anstatt Optionen einzeln zu bewerten. Die Auswahl der Kandidaten mit den besten Einzelquoten liefert eine plausible Antwort, die neun Punkte unter dem Optimum liegt. Ab medium und darüber fand der Agent in allen 18 Durchläufen die optimale Menge.
Hypothesenprüfung. Die Diagnose-Aufgabe erfordert die Prüfung eines Kandidatenpaars in beide Richtungen: Jede Warnung muss erklärt werden, und jeder Dienst, der still geblieben ist, muss mit der Antwort vereinbar sein. Ab medium und darüber identifizierte der Agent in allen 18 Durchläufen das richtige Paar.
Erfüllung von Nebenbedingungen. Die Planungs-Aufgabe kombiniert zehn aufgeführte Nebenbedingungen mit einer Teamregel, die von nachgeschlagenen Verantwortlichkeitsdaten abhängt. xhigh lieferte den gültigen Zeitplan in jedem Durchlauf, und dies war die Aufgabe, bei der das höchste Niveau den deutlichsten Unterschied machte.
Das Muster über die drei hinweg lautet, dass zusätzliche Denkleistung dort am wertvollsten ist, wo der Agent mehrere Kandidatenantworten gegeneinander abwählen muss, anstatt einem einzelnen Weg zum Ergebnis zu folgen.
Denken in der Produktion überwachen
In der Produktion hat man keine bekannte Antwort als Vergleichsmaßstab, aber man weiß, wie viele Ausgabe-Tokens und Tool-Aufrufe jeder Durchlauf verwendet hat. Das liefert ein nützliches Betriebssignal.
Korrekte Durchläufe auf jedem Niveau bleiben oberhalb einer klaren Untergrenze des Denkensvolumens. Jeder korrekte Durchlauf ab medium und darüber verwendete mindestens 1,739 Ausgabe-Tokens, und ein typischer Durchlauf verwendete mehrere Tausend. Ein Durchlauf, der keine Tool-Aufrufe macht oder weit weniger Ausgabe erzeugt, als für sein Niveau üblich ist, sollte zur Überprüfung markiert werden:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
Kalibriere die Baseline aus Durchläufen, die du bewertet hast, pro Aufgabe und pro Anstrengungsniveau, und wende sie dann auf Durchläufe an, die du nicht bewertet hast. Behandle eine Markierung als Aufforderung zur Inspektion oder zum erneuten Ausführen. Bei low, wo jeder Durchlauf kurz ist, ist das Ausgabevolumen ein schwächeres Signal, daher kombiniere es mit Stichproben.
Es ist sinnvoll, den Agenten im System-Prompt aufzufordern, seine Antwort zu überprüfen, denn so lässt sich das Denken des Agenten bei der Durchsicht eines Durchlaufs leicht nachvollziehen. Kombiniere dies mit automatisierter Bewertung, wo immer eine bekannte Antwort existiert, damit die Qualität unabhängig vom Transkript gemessen wird.
Wahl der Denkleistung
Diese Ergebnisse legen einige praktische Regeln nahe.
Passe die Anstrengung an die Art der Aufgabe an. Aufgaben, die Suche, Optimierung oder das Prüfen einer Hypothese beinhalten, profitieren am meisten von medium oder höher. Aufgaben, die einem einzelnen Pfad folgen oder deren Antworten nachgelagert überprüft werden, können effizient laufen bei low.
Lege die Anstrengung pro Anfrage fest, nicht pro Agent. Anstrengung ist ein Anfrageparameter, daher kann ein Agent seine Planungs- und Verifizierungsschritte auf einem höheren Niveau ausführen und seine mechanischen Schritte, etwa das Formatieren eines Tool-Ergebnisses, bei low. Das verbindet einen Großteil der Zuverlässigkeit eines höheren Niveaus mit niedrigeren Token-Kosten.
Miss an deinen eigenen Aufgaben, mit Wiederholungen. Ein einzelner Durchlauf pro Konfiguration liefert eine einzige Beobachtung. Das mehrfache Wiederholen jeder Konfiguration zeigt, wie konsistent sie ist.
Überwache das Denkvolumen. Ausgabe-Tokens und Tool-Aufrufe pro Durchlauf, nach Anstrengungsniveau verfolgt, geben dir ein frühes Signal, um einen Durchlauf zu überprüfen, bevor sein Ergebnis verwendet wird.
Grenzen dieser Messung
Sechs Läufe pro Aufgabe und Aufwandstufe. Genug, um eine konsistente Richtung über drei Aufgaben hinweg zu zeigen, aber nicht genug für ein Konfidenzintervall. Betrachten Sie die Unterschiede zwischen den Stufen als hinweisend.
Eine synthetische Umgebung. Die Tools lesen aus Daten, die im Code generiert werden, was es möglich macht nachzuweisen, dass jede Aufgabe genau eine Antwort hat, und automatisch zu bewerten. Echte Tools bringen Latenz, Teilergebnisse und Fehler mit, von denen hier keines getestet wird.
Minuten, nicht Stunden. Die mediane Laufzeit reichte von 18 Sekunden bei low bis zu 106 Sekunden bei xhigh. Dies ist ein herunterskalierter Stellvertreter für Arbeiten mit langem Zeithorizont. Die Methode übertragt sich. Die absoluten Zahlen tun es nicht.
Eine Modellversion, eine Region, ein Prompt pro Aufgabe. Unterschiedliche Formulierungen derselben Aufgabe können die Ergebnisse verändern, weshalb es unter anderem wichtig ist, jede Regel explizit anzugeben.
Token-Anzahlen, keine Kosten. Um in Währung umzurechnen, wenden Sie die aktuellen Tarife für Ihr Inferenz-Profil und Ihre Service-Stufe von der Amazon Bedrock-Preisseite an. Die Global- und US-Geo-Profile werden unterschiedlich bepreist, und die Service-Stufen Flex und Priority wenden Multiplikatoren an.
Operative Kontrollen für Agenten-Workloads
Bauen Sie Wiederholungen ein. Agenten, die eine hohe Anzahl von Aufrufen ausgeben, sollten Wiederholungen als Teil des Designs behandeln. Legen Sie ein Request-Timeout fest, wiederholen Sie nur fehlerhafte Aufrufe, die wiederholbar sind, warten Sie exponentiell mit Jitter ab und berücksichtigen Sie einen Retry-After -Header, wenn einer zurückgegeben wird:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
Der Durchsatz für On-Demand skaliert im Laufe der Zeit hoch, daher fahren Sie eine neue Workload mit hohem Volumen schrittweise hoch, statt mit voller Rate zu beginnen.
Prüfung eines Laufs. Das Model Invocation Logging schreibt Anfrage- und Antwortdaten nach Amazon Simple Storage Service (Amazon S3) oder Amazon CloudWatch Logs. Damit erhalten Sie das vollständige Protokoll der Läufe, die Sie nachträglich überprüfen möchten.
Überwachung des Reasoning-Volumens im großen Maßstab. Amazon CloudWatch-Metriken geben Ihnen die aggregierte Ansicht der Token-Nutzung, wodurch die zuvor beschriebenen Basiswerte pro Stufe etwas werden, auf das Sie Alarme einrichten können.
Zuordnung von Ausgaben über Agenten hinweg. Die Kostenaufschlüsselung in AWS Cost Explorer und im AWS Cost and Usage Report bricht die Nutzung pro Modell auf, was Ihnen in Kombination mit Token-Anzahlen pro Aufgabe sowohl die Stückökonomie als auch die Gesamtrechnung liefert.
Kosten an Dringlichkeit anpassen. Service-Tiers werden pro Anfrage festgelegt, sodass eine einzige Bereitstellung eine Analyse über Nacht über den Flex-Tier und eine interaktive Anfrage über Priority senden kann. Bei einer Workload, die auf einem höheren Effort-Level läuft, ist die Auswahl des Tiers ein weiterer Hebel für die Kosten.
Wahl eines Routing-Profils. Cross-Region-Inferenz erweitert den Kapazitätspool, aus dem ein langer Lauf schöpft. Das Global-Profil bedient Anfragen aus der von Ihnen gewählten Commercial-AWS-Region und ist in der Regel pro Token günstiger als geografisches Routing. Das US-Profil hält die Verarbeitung innerhalb der Vereinigten Staaten. Treffen Sie Ihre Wahl sowohl anhand Ihrer Datenresidenzanforderungen als auch der Kosten.
Aufräumen
Die Beispiele in diesem Beitrag erzeugen keine kostenpflichtigen AWS-Ressourcen über den tokenbasierten Verbrauch pro Anfrage hinaus. Wenn Sie einen langlebigen Amazon Bedrock API-Schlüssel generiert haben, löschen Sie ihn in der Amazon-Bedrock-Konsole, wenn Sie fertig sind, da er bis zum Widerruf gültig bleibt. Kurzlebige Tokens, die aus IAM-Anmeldedaten generiert wurden, laufen von selbst ab.
Wenn Sie beim Testen das Modell-Aufruf-Logging nach Amazon S3 aktiviert haben, prüfen Sie den Bucket und entfernen Sie Objekte, die Sie nicht mehr benötigen.
Fazit
SpaceXAI hat Grok 4.7 darauf trainiert, länger an schwierigeren Aufgaben zu arbeiten und zu erkennen, wann es seine eigene Arbeit überprüfen sollte. Bei drei Aufgaben, die Suche statt Nachschlagen erforderten, beantwortete der Agent 67 von 72 Läufen korrekt, und jeder Lauf bei xhigh. Da das Reasoning-Effort pro Anfrage festgelegt wird, können Sie wählen, wo jeder Schritt eines Agents auf dem Kompromiss zwischen Gründlichkeit und Token-Kosten liegt.
Drei Dinge sind wert, in Ihre eigene Evaluation übernommen zu werden. Entwerfen Sie Aufgaben mit einer beweisbaren Antwort und formulieren Sie jede Regel, von der der Prüfer abhängt. Wiederholen Sie die Läufe, damit Sie sehen, wie konsistent jede Konfiguration ist. Und überwachen Sie Ausgabe-Tokens und Tool-Aufrufe nach Effort-Level, damit Sie ein operatives Signal neben Ihren Qualitätsmessungen haben.
Weiterführende Literatur
- Introducing Grok on Amazon Bedrock
- Grok 4.7 ist jetzt auf Amazon Bedrock verfügbar
- Weiterleitung von Modellinferenzanforderungen über AWS-Regionen hinweg mit regionsübergreifender Inferenz
- Getting started with Amazon Bedrock
- Chat Completions API
- Amazon Bedrock pricing
- Introducing Grok 4.7 (SpaceXAI)