
Sicherheitsanalytiker benötigen schnelle Antworten bezüglich ihrer Cloud-Infrastruktur, ohne tiefe Kenntnisse in spezifischen Domänen-Suchsprachen zu haben. Orca SecurityDas Tool umfasst mehr als 900 Cloud-Modelle – also die Ressourttypen, die von Sonar erfasst werden, wie beispielsweise eine Amazon Elastic Compute Cloud (Amazon EC2)-Instanz oder ein Amazon Simple Storage Service (Amazon S3)-Bucket. Die Abfrage dieser Daten erforderte präzise Modelnamen, Navigations durch eingebettete Beziehungen sowie die Auswahl aus 18 Operatoren (Vergleichefunktionen wie „equals“ oder „contains“, die zur Filtration der Ergebnisse verwendet werden).
Um dieses Problem zu lösen, hat Orca Security eine Partnerschaft mit AWS eingegangen, um Discovery AI zu entwickeln – einen Agenten für natürliche Sprachanfragen auf Amazon Bedrock. Orca bietet eine kontextbewusste Sicherheit für Cloud, Code und AI, und Sonar ist sein domain-spezifisches Suchsystem, über das Benutzer im gesamten Datengraph suchen, filtern und erkunden können.
In diesem Beitrag teilen wir die Architektur und die Ergebnisse von Discovery AI mit, die eine Frage in natürlicher Sprache in eine Sonar-Frage umwandelt. Infolgedessen reduzierte Orca die Anfragekosten um 90 Prozent, die Eingabestoken um 93 Prozent und die Latenzzeit um 75 Prozent im Vergleich zum ursprünglichen Basiswert.
Übergreifend natürliche Sprache und strukturierte Anfragen
Das Sonar-Query-System von Orca Security unterstützt 900+ Cloud-Infrastrukturen und Anwendungsmodelle mit komplexen Beziehungen zwischen ihnen. Um diese Daten abfragen zu können, erstellen Benutzer JSON-Objekte, die genaue Modelnamen festlegen, aus 18 Operatoren wählen und die Eltern-und-Kind-Hierarchien unter den Cloud-Anbietern navigieren. Dies zu gut zu erledigen erfordert eine tiefe Kenntnis des Sonar-Schemas.
Um diese Fähigkeit zu entwickeln, begann das Orca-Team mit der Entwicklung einer natürlichen Sprachinterfaz, die gültige Sonar-Fragen aus einfachem Text generieren kann.
Ihre anfängliche Konzeptprüfung laden das gesamte Sonar-Schema in einem einzigen Prompt auf dem größten verfügbaren Modell ein. Dazu gehörten über 900 Modelldefinitionen, alle Beziehungsarten und eine umfangreiche Sammlung von Beispielanfragen. Die Ausgabequalität war gut (die Designpartner und interne Benutzer reagierten positiv), aber bei der Produktionsgröße zeigten sich drei wesentliche Nachteile.
Die Token-Verbrauchung war ineffizient – etwa 2 Millionen Eingabetokens pro Arbeitslast – was den Kostenaufwand erhöhte. Die Latenz war hoch; die End-to-End-Antwortzeiten betrugen etwa 60 Sekunden pro Arbeitslast. Die Genauigkeit bei komplexen, multiplen-Modell-Querstellungen war begrenzt, da eingebettete Beziehungen und multiamente-bedingte Querstellungen oft weitere Bearbeitung erforderten.
Das Orca-Team bestätigte, dass das Konzept funktioniert. Die nächste Herausforderung war es, es kosteneffizient, schnell und ausreichend genau genug für die Produktion zu machen. Um dies zu lösen, entwarf das Orca-Team eine Lösung, die tausende Anfragen pro Tag mit einer Antwortzeit von 15 Sekunden über Amazon Bedrock bearbeiten kann.
Lösungsüberblick
Orca entwarf Discovery AI als eine hybride Lösung auf Amazon Bedrock, die Retrieval Augmented Generation (RAG) mit schema-kennenzüchtiger Abfrageteilung kombiniert. Das System wandelt natürliche Sprachfragen in gültige Discovery-Filter um, indem es einen mehrstufigen Prozess durchläuft, wobei jede Stufe mit dem am besten geeigneten Amazon Bedrock-Modell abgeglichen wird.
Orca wählte Amazon Bedrock, weil es eine mehrfache Modellzugriffsmöglichkeit über eine einzige API bietet, wodurch das Team verschiedene Fundament-Modelle für jede Pipeline-Phase verwenden kann, ohne separate Integrationen zu verwalten. Amazon Bedrock übernimmt außerdem die AWS-Gouvernanzkontrollen durch AWS Identity and Access Management (IAM), Virtual Private Cloud (VPC) Endpunkte und AWS CloudTrail, was den Sicherheitsanforderungen von Orca entspricht. Die modellunabhängige Architektur bedeutete, dass das Team neue Modelversionen einführen konnte, sobald sie verfügbar waren, ohne den Pipeline-Entwurf zu ändern.
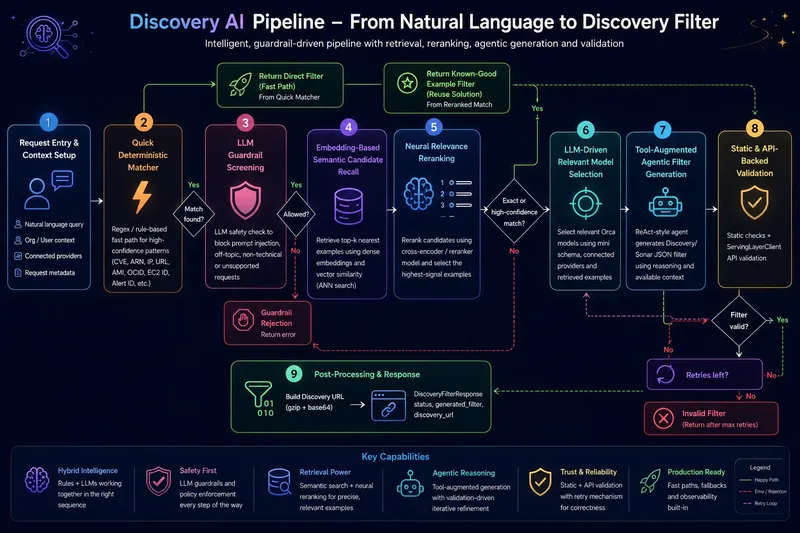
Das folgende Diagramm zeigt die neunstufige Pipeline-Architektur.
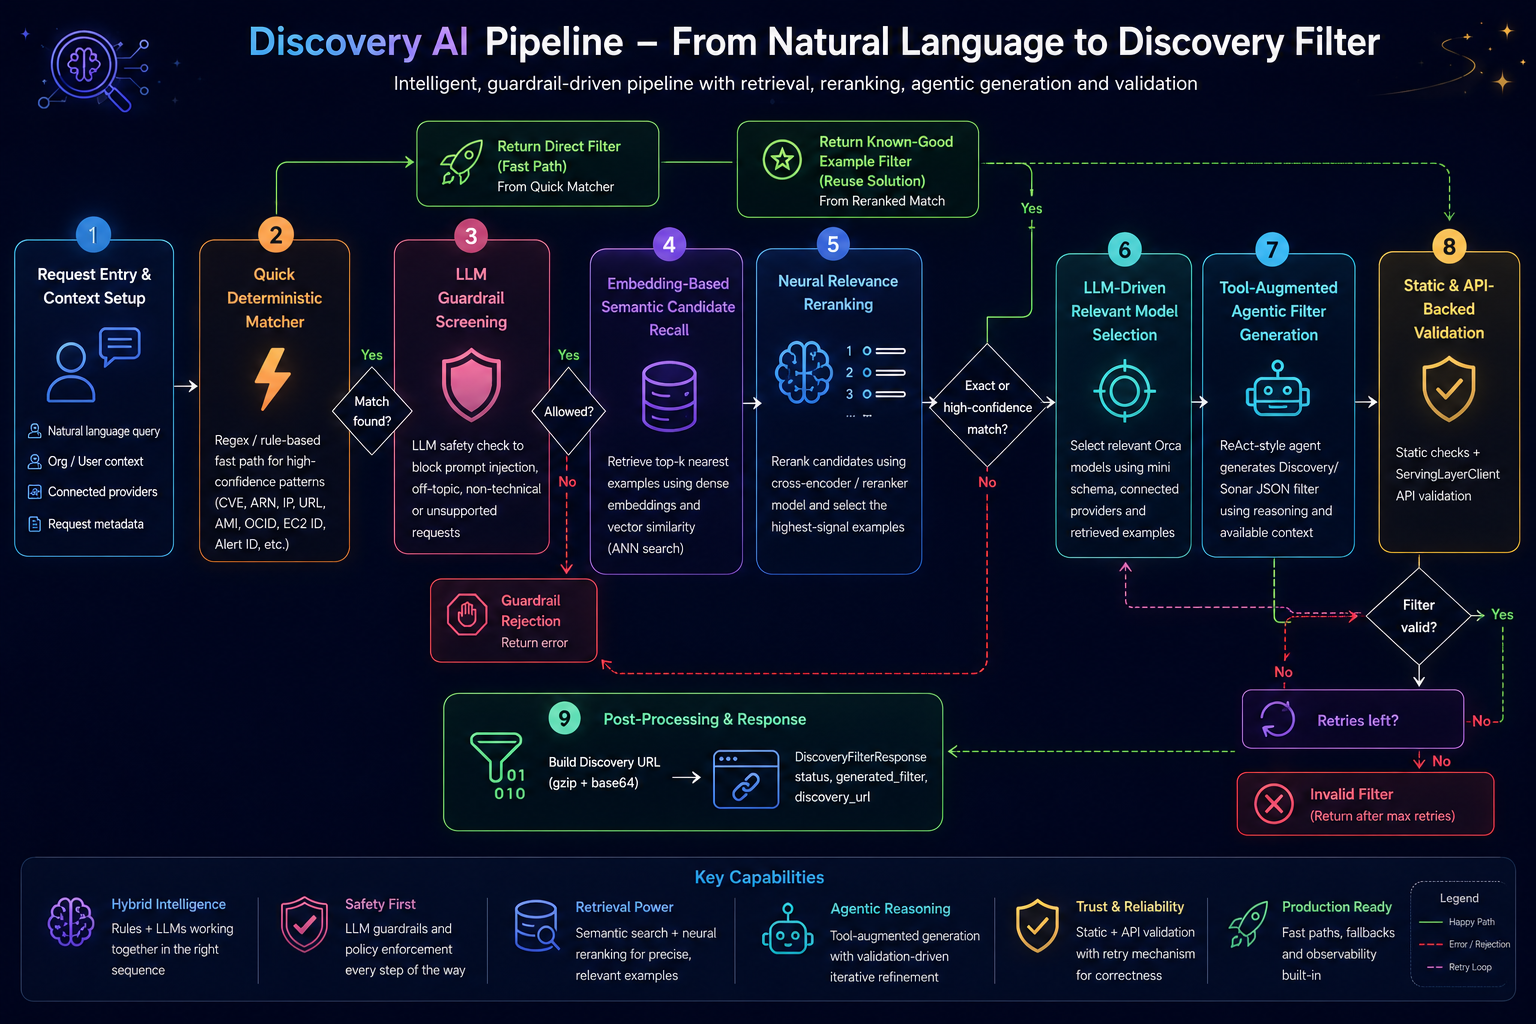
Abbildung 1: Architektur des mehrstufigen Discovery-AI-Prozesses, der den Fluss von natürlicher Sprachausgabe zu validierten Discovery-Filter-Anfragen unter Verwendung von Grundmodellen auf Amazon Bedrock zeigt
Der Discovery AI-Pipeline-Workflow wandelt einen natürlichen Sprachauftrag in einen validierten Discovery-Filter durch neun Schritte um.
- Anforderung einfügen und Kontext-Einstellung: Der Prozess beginnt mit der Kombination der natürlichen Spracheanforderung des Benutzers mit relevantem Kontext, einschließlich der Organisation des Benutzers, verbundenen Cloud-Anbietern und Metadaten der Anforderung. Dieser Kontext hilft dem Prozess, die Anforderung genau zu interpretieren und einen Discovery-Filter zu erzeugen, der dem Umfeld des Kunden entspricht.
- Schnelle deterministischeMatcher: Der SchnelleMatcher erkennt strukturierte Eingaben wie IP-Adressen, Common Vulnerabilities and Exposures (CVEs), ARNs, Dateihashes, Amazon Machine Image IDs, Oracle Cloud Identifiers, EC2-IDs, URLs und Alert-IDs. Er verwendet regex- sowie regelbasierte Matching-Techniken, um Muster mit hoher Zuverlässigkeit zu erkennen. Wenn ein Match gefunden wird, kann der Pipeline einen vorgegebenen Discovery-Filter über einen schnellen Weg zurückgeben, ohne den Einsatz eines großen Sprachmodells (LLM). Wenn kein Match gefunden wird, geht die Anfrage zum nächsten Schritt über.
- LLM Guardrail Screening: Der Guardrail-Component überprüft, ob die Anfrage sicher, relevant, technisch angemessen und unterstützt ist. Er blockiert Versuche zur Prompt-Injektion, off-topic-Anfragen und ununterstützte Eingaben, bevor sie den Rest des Prozesses erreichen. Anfragen, die die Guardrail-Prüfungen nicht bestehen, werden mit einem angemessenen Fehler abgelehnt. Genehmigte Anfragen setzen ihren Ablauf fort.
- Eingebettetes semantisches Kandidaten-Erinnern: Der Pipeline sucht nach relevanten, vorher validierten Suchbeispielen mit Amazon Titan Text Embeddings. Er holt die 20 nächsten Beispiele aus dem Vektorverzeichnis aufgrund semantischer Ähnlichkeit ab. Diese Kandidaten liefern dem Pipeline Beispiele dafür, wie ähnliche natürliche Sprachanfragen zuvor in Discovery-Filter umgewandelt wurden.
- Neural Relevance Reranking: Die ausgewählten Kandidaten werden mit Cohere Rerank 3.5 auf Amazon Bedrock neu bewertet. Dadurch werden die Beispiele identifiziert, die am relevantesten für den aktuellen Aufruf sind, und die fünf stärksten Beispiele werden ausgewählt. Wenn ein genaues oder hochverlässliches Match gefunden wird, kann der Prozess direkt den bekannten Filter verwenden. Andernfalls werden die neu bewerteten Beispiele an die generativen Schritte weitergegeben.
- LLM-getriebene relevante Modellauswahl: Die Modellauswahl reduziert mehr als 900 Sonar-Modelle auf die kleine Anzahl der relevanten Modelle für den Aufruf. Beim Auswählen der geeigneten Modelle wird die Anfrage des Benutzers, die verknüpften Anbieter sowie die abgerufenen Beispiele berücksichtigt. Die ausgewählten Modelle werden an den Generator über den entsprechenden Schema-Niveau verwendet – von kompakten Mikro-Schemata bis hin zu detaillierteren Mini-Schemata. Dadurch wird unnötiger Kontext reduziert und die Generierung effizienter gestaltet.
- Werkzeugverstärkter Agentischer Filter-Generierung: Der Generator verwendet einen werkzeugverstärkten Agenten, um den endgültigen Entdeckungsfilter zu erstellen. Er überlegt sich die ausgewählten Modellschemata, die abgerufenen Beispiele, den Benutzerkontext und die verfügbaren Werkzeuge. Der Agent kann den Filter iterativ verbessern, während er auf eine valide Darstellung des Benutzeranliegenss zusteuert.
- Statische und durch die API unterstützte Validierung: Der generierte Filter wird auf syntaktische und semantische Korrektheit überprüft. Der Pipeline führt zunächst eine statische Validierung durch und überprüft anschließend den Filter gegen die Orca-Sonar-API. Wenn die Validierung fehlschlägt, wird der Validierungsfehler an den Generator zurückgegeben, damit der Agent den Filter korrigieren und erneut versuchen kann. Wenn das maximale Anzahl von Versuchen erreicht wird, ohne dass ein gültiger Filter entsteht, gibt der Pipeline eine ungültige-Filter-Antwort zurück. Der Generator ist auf die neu sortierten Beispiele und ausgewählte Schemas beschränkt. Die statische Validierung löst jedes Modell, jede Spalte und jede Operator verantwortlich für diese Schema-definitionen wieder. Jeder Validierungsfehler wird an den Agent zurückgegeben, bei dem das fehlerhafte Element identifiziert wurde, sodass die Wiederholungen eher auf Basis der ursprünglichen Daten erfolgen als auf einer vorgegebenen Annahme.
- Postverarbeitung und Antwort: Nach der Erstellung eines gültigen Filters – sei es durch den Quick Matcher, die Wiederverwendung eines guten Beispiels oder die agentische Generierung – bereitet der Pipeline die endgültige Antwort vor. Das Team hat unterschiedliche Grundmodell-Plattformen auf Amazon Bedrock in den Komponenten verteilt, basierend auf den Anforderungen jeder Phase. Anthropic Claude Haiku 4.5 wird von dem Model Selector und Generator genutzt. Diese Komponenten benötigen eine starke Logik, um korrekte Fragen zu konstruieren. Amazon Nova 2 Lite übernimmt die Guardrail- und Validator-Komponente, wobei eine schnelle Inferenz zu niedrigeren Kosten Priorität hat. Amazon Titan liefert Embeddings für die semantische Suche in der Beispielsuche-Komponente. Cohere Rerank 3.5 ordnet die abgerufenen Kandidaten neu, um die Relevanz zu maximieren. Für die Verfügbarkeit der Modelle je nach AWS-Region siehe Regionale Verfügbarkeit der Modelle.
Maximierung der Relevanz und Vielfalt bei der Suche nach Beispielen
Das Beispiel-Retrieval erwies sich als der wichtigste Faktor für die Genauigkeit im Pipeline. Starke Beispiele lehren den Generator, Fragen effizienter in Sonar-Queries umzuwandeln als nur das Schema, sodass das Orca-Team mehrere Retrieval-Strategien auf Amazon Bedrock getestet hat. Jede Strategie zog eine andere Art von Relevanz, Vielfalt oder Geschwindigkeit nach sich, und die direkte Vergleichung zeigte, welche Kombination am besten funktionierte.
Die rein semantische Suchfunktion auf Amazon Titan Embeddings lief schnell, aber sie gab tendenziell nahezu identische Beispiele zurück, was den Generator für Vielfalt unterdrückte. Der Maximale Marginale Relevanz (MMR) verbesserte die Vielfalt, aber er zog die Relevanz in den Tod, wenn der Top-Kandidat tatsächlich die richtige Antwort war. Das Abrufen eines größeren Kandidaten-Sets und dessen anschließende Neurankenung führte zu einem breiteren Pool und nutzte einen Neuranker, um den am relevantestenen Teil der Menge auszuwählen, was auf die erfolgreiche Methode hindeutete.
Der Gewinner war die Top-20-Nähe-Rücknahme mit Amazon Titan-Embeddings. Anschließend rerankte Orca diese Ergebnisse mit Cohere Rerank 3,5 auf die Top-Fünf. Diese Methode verleiht dem Generator eine kleine, vielfältige und hochrelevante Sammlung von Beispielen, ohne einen Kompromiss zwischen Abdeckung und Genauigkeit bei der Abrufzeit erforderlich zu machen.
Laden von über 900 Modellen in den Kontext
Eine zentrale Einschränkung bestimmte die Architektur. Es war nicht möglich, 900+ Sonar-Modellskizzen in jeden Prompt einzubeziehen. Selbst bei langen Kontextmodellen führt dies zu einer Verringerung sowohl des Kostenaufwands als auch der Genauigkeit.
Der Modellauswahlgerät löst dieses Problem. Er läuft unter Anthropic Claude Haiku 4.5 und arbeitet mit kompakten, semantisch reichen Darstellungen jedes Modells (Name, Zweck, wichtige Felder und Schlüsselbeziehungen) zusammen. Angesichts der Anfrage des Benutzers gibt er nur die Modelle zurück, die der Generator tatsächlich benötigt. Der Generator erhält anschließend vollständige Schemainformationen nur für die ausgewählten Modelle sowie die Beziehungen, die sie verbinden.
Bewertungsmethodik
Um sicher iterieren zu können, hat das Orca-Team früh im Projekt ein kontinuierliches Bewertungsinstrument entwickelt. Das Instrument kombiniert eine ausgewählte Datensammlung, eine automatisierte Bewertungsschicht und einen messungsbasierten Ansatz, sodass das Team jeden Wandel vor der Veröffentlichung vertrauen kann. Gemeinsam machen diese Elemente die Bewertung zu einem Routineschritt, anstatt zu einer Nachlässigkeit.
Das ausgewählte Bewertungsdatenset umfasst die Arten von Fragen, die Modelfamilien sowie die Komplexitätsstufen, die in der Produktion vorkommen, sodass es die tatsächliche Nutzung widerspiegelt. Eine Bewertungsschicht, die als Richter eines LLMs funktioniert, bewertet generierte Anfragen hinsichtlich Korrektheit, Vollständigkeit und semantischer Gleichwertigkeit zu einer Referenzanfrage – dies gibt der Teamleitung ein konsistentes Qualitätssignal. Die Messmethodik teilt anschließend die Deltas nach Abschnitten auf, sodass das Team genau erkennen kann, wo Regressionen auftreten und was korrigiert werden muss.
Jede Änderung an einem Prompt, einer Modellnummer, einem Abrufparameter oder einem Beispiel geht durch das System, bevor sie in die Produktion kommen.
Domain-expert-in-the-loop-kennzeichnungssystem für kontinuierliche Verbesserung
Die Aufrechterhaltung der Genauigkeit, während die Kundenumgebungen sich entwickeln und neue Fragmentationsmuster auftreten, erfordert mehr als nur eine starke anfängliche Implementierung. Das Orca-Team hat ein interne Labelsystem für Produktmanager, Support-Ingenieure und Sicherheitsforscher entwickelt. Mit diesem Tool können sie Anfragen markieren, Ausgaben korrigieren und Korrekturen in das Beispieldatenbanken einfügen – in einer einzigen Aktion. Darüber hinaus sammelt das System automatisch Produktionsanfragen mit Beispielen mit niedrigem Vertrauen und leitet sie an den entsprechenden Domain-Experten für die tägliche Labelierung weiter. Bei der nächsten Pipeline-Ausführung wird das neue Beispiel durch Cohere Rerank 3.5 abgerufen, und die Genauigkeit bei dieser Art von Fragen verbessert sich gleichzeitig, ohne jegliche Bereitstellung.
„Die Labeling-UI ist die wichtigste Investition, die wir für die langfristige Qualität getätigt haben. Sie verwandelt Discovery AI von einer statischen Implementierung in ein lebendiges System, wobei unsere Fachleute es ständig in ihrem normalen Arbeitsablauf weiterentwickeln.“
— Oder Gabay, Direktor von AI, Orca Security
In Kombination mit der End-to-End-Pipeline-Beobachtbarkeit und gemeinsamen Dashboards, die die Produkt-, Engineering- und Kundenservice-Teams umfassen, sorgt diese Rückkopplungskette dafür, dass Discovery AI nach dem Erststart weiter verbessert wird.
Ergebnisse
Nach der Verteilung von Discovery AI in die Produktion überwies die neue Lösung die ursprüngliche Basisleistung hinsichtlich Kosten, Latenz und Genauigkeit. Der Verbrauch von Eingabetoken sank um 93 Prozent – von etwa 2 Millionen Tokens auf 140.000 für ein vergleichbares Arbeitsvolumen. Die Gesamtkosten sanken um 90 Prozent, was durch den geringeren Tokenverbrauch sowie die Verteilung des Modells pro Schritt über Amazon Bedrock verursacht wurde.
Die Latenzzeit verbesserte sich ebenfalls, wobei die End-to-End-Antwortzeiten um 75 Prozent abnahmen – von etwa 60 Sekunden auf 15 Sekunden. Die Genauigkeit bei komplexen, mehrmodelligen Abfragen verbesserte sich ebenfalls, und dies wurde kontinuierlich durch das Evaluationssystem des Teams gemessen.
Seit März 2026 verarbeitet Discovery AI täglich Tausende Anfragen in der Produktion, wobei interne Experten sowie Kundenerfahrungen die Qualität überprüfen.
Schlussfolgerung
In diesem Artikel haben wir gezeigt, wie Orca Security Discovery AI auf Amazon Bedrock entwickelt hat. Die Lösung reduzierte die Abfragenkosten um 90 Prozent, die Verwendung von Eingabetoken um 93 Prozent und die Latenzzeit um 75 Prozent im Vergleich zum ursprünglichen Stand. Die Lösung kombiniert mehrere wichtige Technologien. Dazu gehören die RAG-basierte Beispielsuche mit Cohere Rerank 3.5, die Modellallokation pro Stage unter Anthropic Claude Haiku 4.5 und Amazon Nova 2 Lite sowie die semantische Suche, die von Amazon Titan unterstützt wird. Außerdem ermöglicht ein kontinuierliches „Human-in-the-Loop“-Labeling-System eine ständige Verbesserung. Diese Kombination ermöglichte es Orca, ein funktionsfähiges Prototypenmodell in eine Produktionslösung zu verwandeln, die kostengünstiger und genauer ist.
Um mit der Entwicklung ähnlicher Lösungen zu beginnen, erkunden Sie Amazon Bedrock für den Zugang zu Grundmodellen (FM), Cohere Rerank auf Amazon Bedrock für die Optimierung der Suche und Amazon Titan für Embeddungen. Um mehr über das Cloud-Sicherheitstool von Orca Security zu erfahren, besuchen Sie orca.security.
Um mehr über die Art und Weise zu erfahren, wie Orca Security KI in seinem Framework einsetzt, siehe wie Orca durch KI Sicherheitsergebnisse erzielt und wie Orca die Einführung von KI sichert, einschließlich Amazon Bedrock.
Für weitere Informationen über die in diesem Artikel verwendeten Techniken, lesen Sie die verwandten Artikel im AWS Machine Learning Blog.