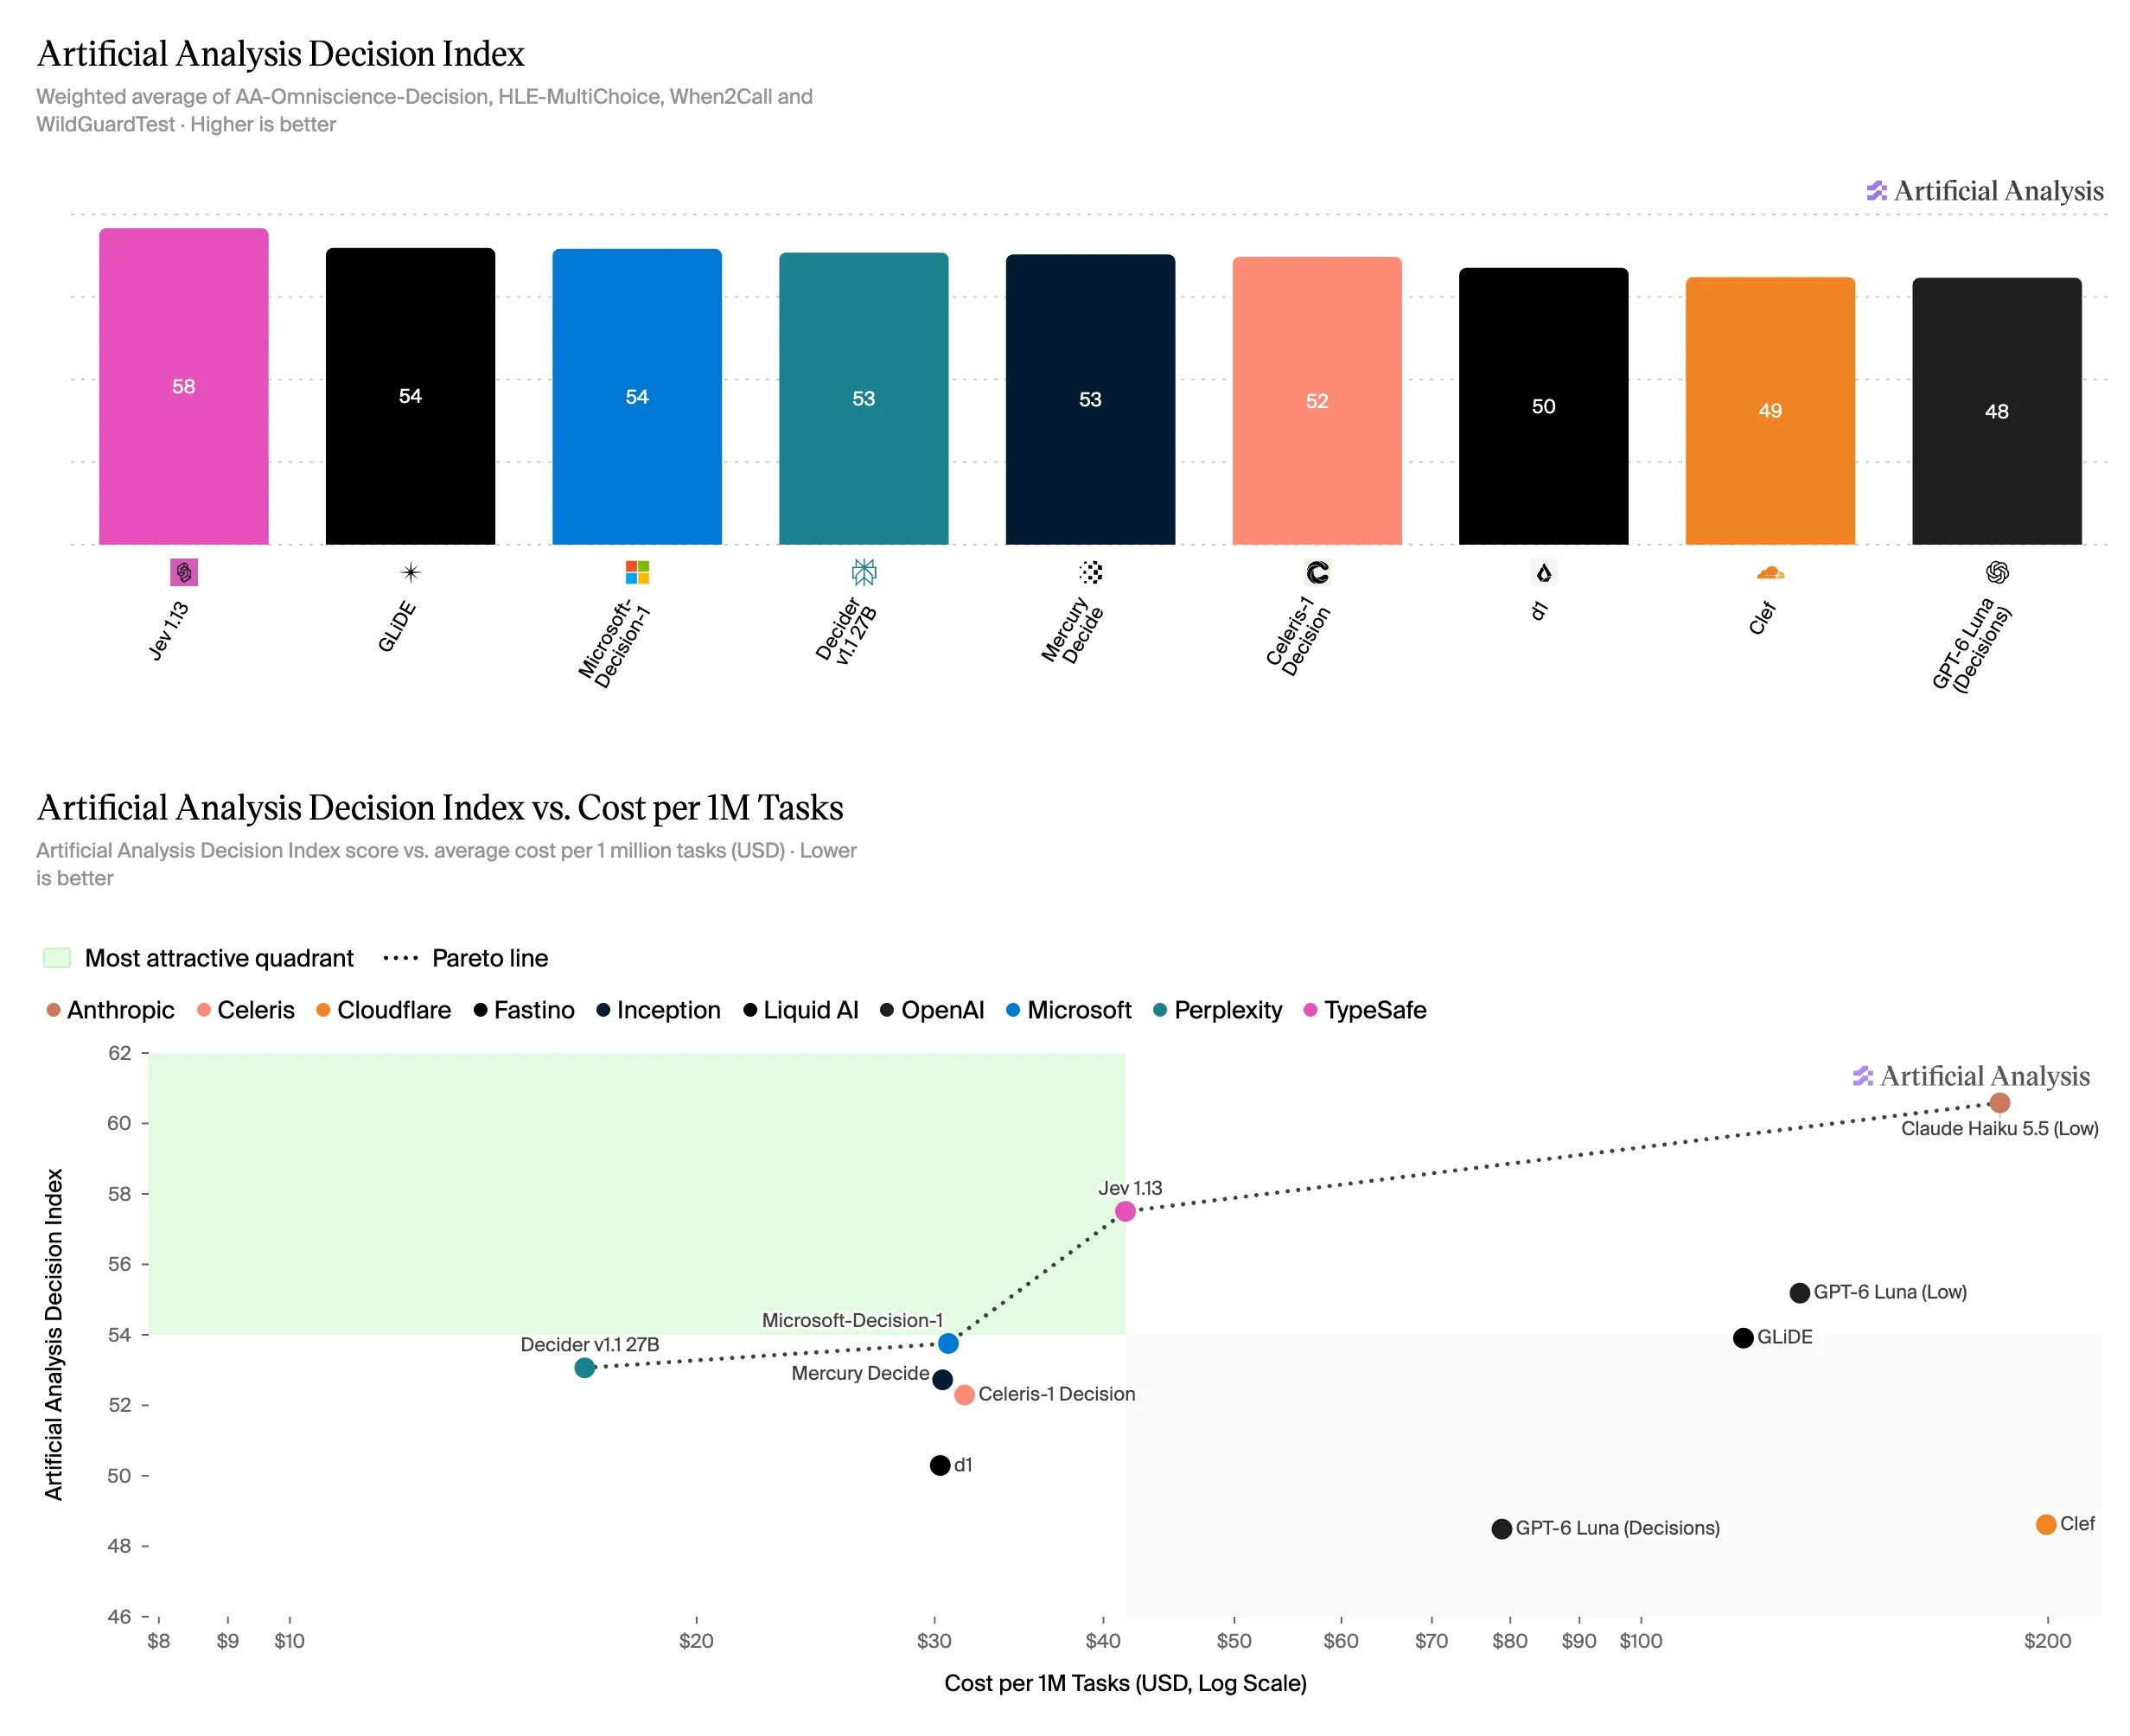
Wir stellen den Artificial Analysis Decision Index vor, der Entscheidungsmodelle in Klassifizierung, Tool-Aufrufen, Wissen und Argumentation bewertet. Jev führt unter den Entscheidungsmodellen; Sprachmodelle wie Claude Haiku 5.5 liefern weiterhin eine höhere Genauigkeit, jedoch zu deutlich höheren Kosten und Latenzen
Entscheidungsmodelle liefern strukturierte Antworten oder Klassifizierungen mit zugehörigen Wahrscheinlichkeiten und bieten schnellere Antworten sowie niedrigere Kosten als der Einsatz von Sprachmodellen. Der Artificial Analysis Decision Index v1.0 vergleicht die Leistungsfähigkeit, Kosten und Geschwindigkeit von Entscheidungsmodellen und stellt diese auch Sprachmodellen gegenüber.
Benchmarks im Artificial Analysis Decision Index v1.0:
➤ AA-Omniscience-Decision: Ein privater Datensatz mit 500 Fragen, adaptiert aus dem proprietären AA-Omniscience-Benchmark, der das Wissen und die Halluzinationstendenz von Entscheidungsmodellen misst
➤ HLE-MultiChoice: 513 rein textbasierte Multiple-Choice-Fragen aus Humanity’s Last Exam, die die Argumentationsfähigkeiten von Entscheidungsmodellen testen
➤ When2Call: Ein Tool-Calling-Benchmark von NVIDIA, der testet, ob Modelle korrekt entscheiden können, ein Tool aufzurufen, eine Klärung anzufordern, eine Antwort abzulehnen oder direkt zu antworten, und dabei Fähigkeiten bewertet, die für agentische Workflows und Tool-Routing relevant sind
➤ WildGuardTest: Ein Sicherheits-Benchmark, der die Klassifizierungsfähigkeiten von Modellen bei schädlichen Nutzeranfragen, Assistenten-Verweigerungen und schädlichen Antworten bewertet. Wir verwenden eine Teilmenge von 835 der ursprünglich 1,725 Testzeilen, bei denen alle drei menschlichen Annotatoren bei allen drei Labels übereinstimmten, nachdem Fragen ausgeschlossen wurden, die konsistent Modell-Verweigerungen auslösen
Wichtigste Ergebnisse:
➤ Jev 1.13 führt den Decision Index an und liegt auf der Capability-vs.-Cost-Pareto-Front: Jev 1.13 von @typesafeai erzielt 58 Punkte im Artificial Analysis Decision Index, vor GLiDE (54) von @fastinoAI und Microsoft-Decision-1 (54) von @Microsoft. Decider v1.1 27B von @perplexity_ai hat mit $17 die niedrigsten Kosten pro 1M Tasks, wobei auch Microsoft-Decision-1 ($31) und Jev 1.13 ($42) auf der Capability-vs.-Cost-Pareto-Front liegen. Celeris-1 Decision hat mit 0.06 Sekunden die schnellste Zeit pro Aufgabe, mehr als 2x schneller als Jev 1.13 (0.13 Sekunden pro Aufgabe)
➤ Entscheidungsmodelle sind bei Wissen- und Argumentationsaufgaben schlecht kalibriert: Über nahezu alle Wahrscheinlichkeitsstufen der gewählten Antworten hinweg liegt die Genauigkeit bei allen Entscheidungsmodellen unterhalb dieser Wahrscheinlichkeit. Diese Lücke ist bei AA-Omniscience-Decision und HLE-MultiChoice am größten, während die meisten Modelle bei WildGuardTest (Klassifizierung) und When2Call (Tool-Calling) relativ gut kalibriert sind
➤ Entscheidungsmodelle bieten erhebliche Geschwindigkeits- und Kostenvorteile gegenüber Sprachmodellen, liegen aber bei Wissen und Argumentation zurück: Bei Klassifizierungs- und Tool-Calling-Aufgaben performen führende Entscheidungsmodelle vergleichbar mit Sprachmodellen, sind dabei jedoch deutlich schneller und günstiger. Bei Wissen und Argumentation sind Sprachmodelle jedoch deutlich überlegen. Claude Haiku 5.5 (Low) erzielt 61 Punkte im Decision Index, 3 Punkte vor Jev 1.13, benötigt jedoch 1.4 Sekunden pro Aufgabe gegenüber 0.13 Sekunden (11x langsamer) und kostet $184 pro 1M Tasks gegenüber $42 bei Jev 1.13 (4.4x teurer)
Wir werden den Artificial Analysis Decision Index weiterentwickeln, um Entwicklern und Unternehmen besser zu helfen zu verstehen, wann und wie sie Entscheidungsmodelle einsetzen sollten.