
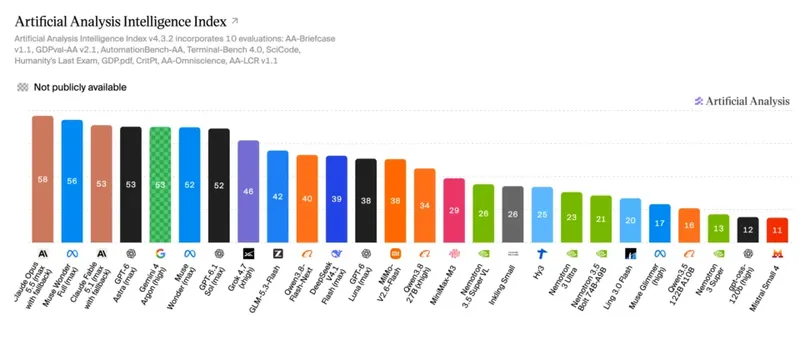
NVIDIA hat heute Nemotron 3.5 Super VL veröffentlicht, ein offenes 120-Milliarden-Parameter-Modell, das die schnellste Aufgabenerledigung und die höchste Genauigkeit für spezialisierte Always-on-Agenten liefert.
Dazu kommen zwei neue Edge-Modelle: Nemotron 3.5 Bolt 74B-A9B 24GB, optimiert, um Intelligenz und Geschwindigkeit pro GB für lokale agentische Workloads auszubalancieren, und Nemotron 3.5 Bolt E4B 4GB, optimiert für Intelligenz pro GB für schnelle dialogorientierte Agenten.
Super VL und Bolt 74B-A9B sind ab sofort verfügbar, Bolt E4B kommt am 23. Oktober.
Die drei offenen Modelle decken gemeinsam das gesamte Spektrum der Agent-Deployment-Arten ab, von großen Enterprise-Servern bis hin zu Edge-Geräten und lokaler Hardware.
Jede Organisation, die Agenten auf NVIDIA-Infrastruktur betreiben möchte, hat nun ein offenes, optimiertes Modell für ihre Stufe, ohne zwischen Leistungsfähigkeit und Deploybarkeit wählen zu müssen.
Super VL und Bolt ergänzen die Nemotron-Familie neben Lightning und Ultra.
Lightning, im August veröffentlicht, bewältigt Workloads mit hohem Durchsatz; Ultra bewältigt die schwersten Reasoning-Aufgaben; und Bolt bringt Intelligenz an den Edge.
Nemotron 3.5 Super VL: Frontier-Genauigkeit bei einem Fünftel der Größe
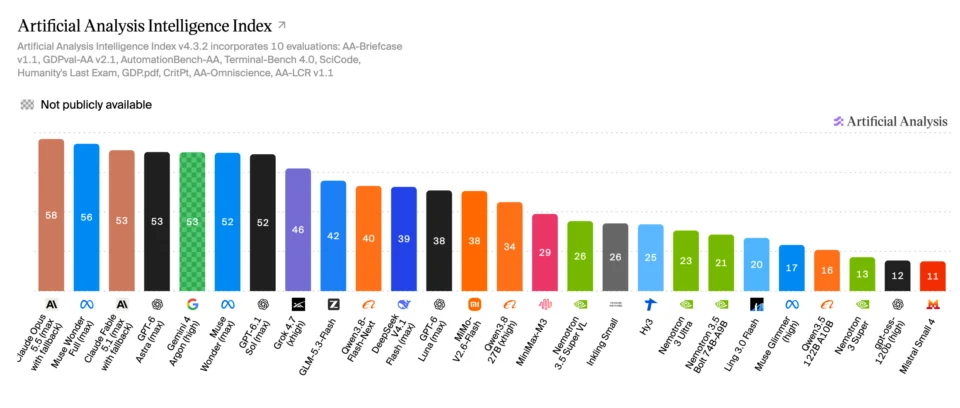
Super VL, entwickelt in Zusammenarbeit mit der Nemotron Coalition, liefert führende Genauigkeit bei multimodalen agentischen Aufgaben — Befehlsbefolgung, Tool-Nutzung, mehrstufige Geschäftsworkflows und visuelles Verständnis — vergleichbar mit NVIDIAs größtem Reasoning-Modell bei etwa einem Fünftel der Parameteranzahl.
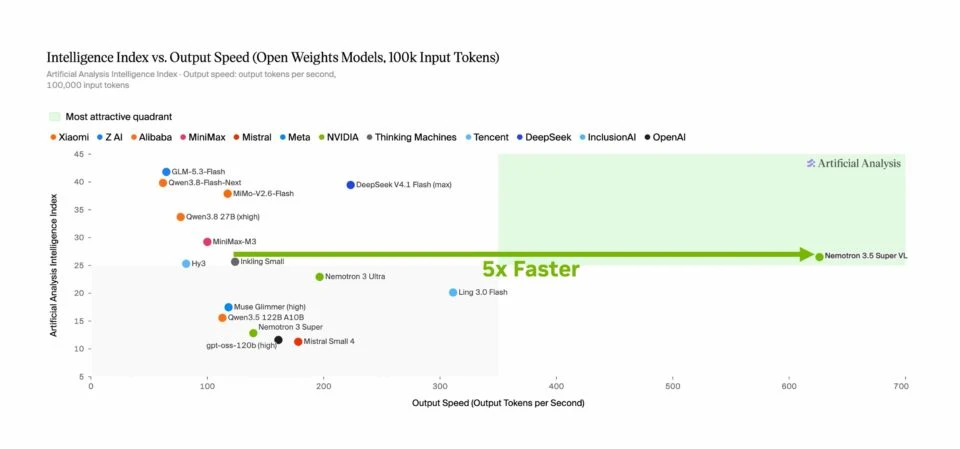
Als schnellstes offenes agentisches Modell seiner Klasse — 5x schneller als das nächstbeste — hilft es Enterprise-Agenten, Aufgaben mit hohem Volumen schneller über Workflows hinweg zu erledigen, die sich über Tage oder Wochen erstrecken.
Anders als bei geschlossenen Frontier-Modellen können Organisationen Super VL mit ihren eigenen Daten nachtrainieren, auf ihrer eigenen Infrastruktur deployen und überwachen, was sie entwickeln.
Nemotron 3.5 Bolt: Agentische Intelligenz am Edge
Bolt 74B-A9B 24GB wurde entwickelt, um alltägliche agentische Aufgaben lokal auf NVIDIA RTX/DGX Spark auszuführen, und verwendet eine native 2-Bit-Quantisierung, um in 24GB Speicher zu passen und neben anderen Anwendungen zu laufen.
Im Vergleich zu anderen Modellen mit ähnlichem Speicherbedarf bietet es eine gute Balance aus Intelligenz und Geschwindigkeit: klug genug, um die meisten Aufgaben zu erledigen, und dennoch viel schneller als die intelligentesten Modelle.
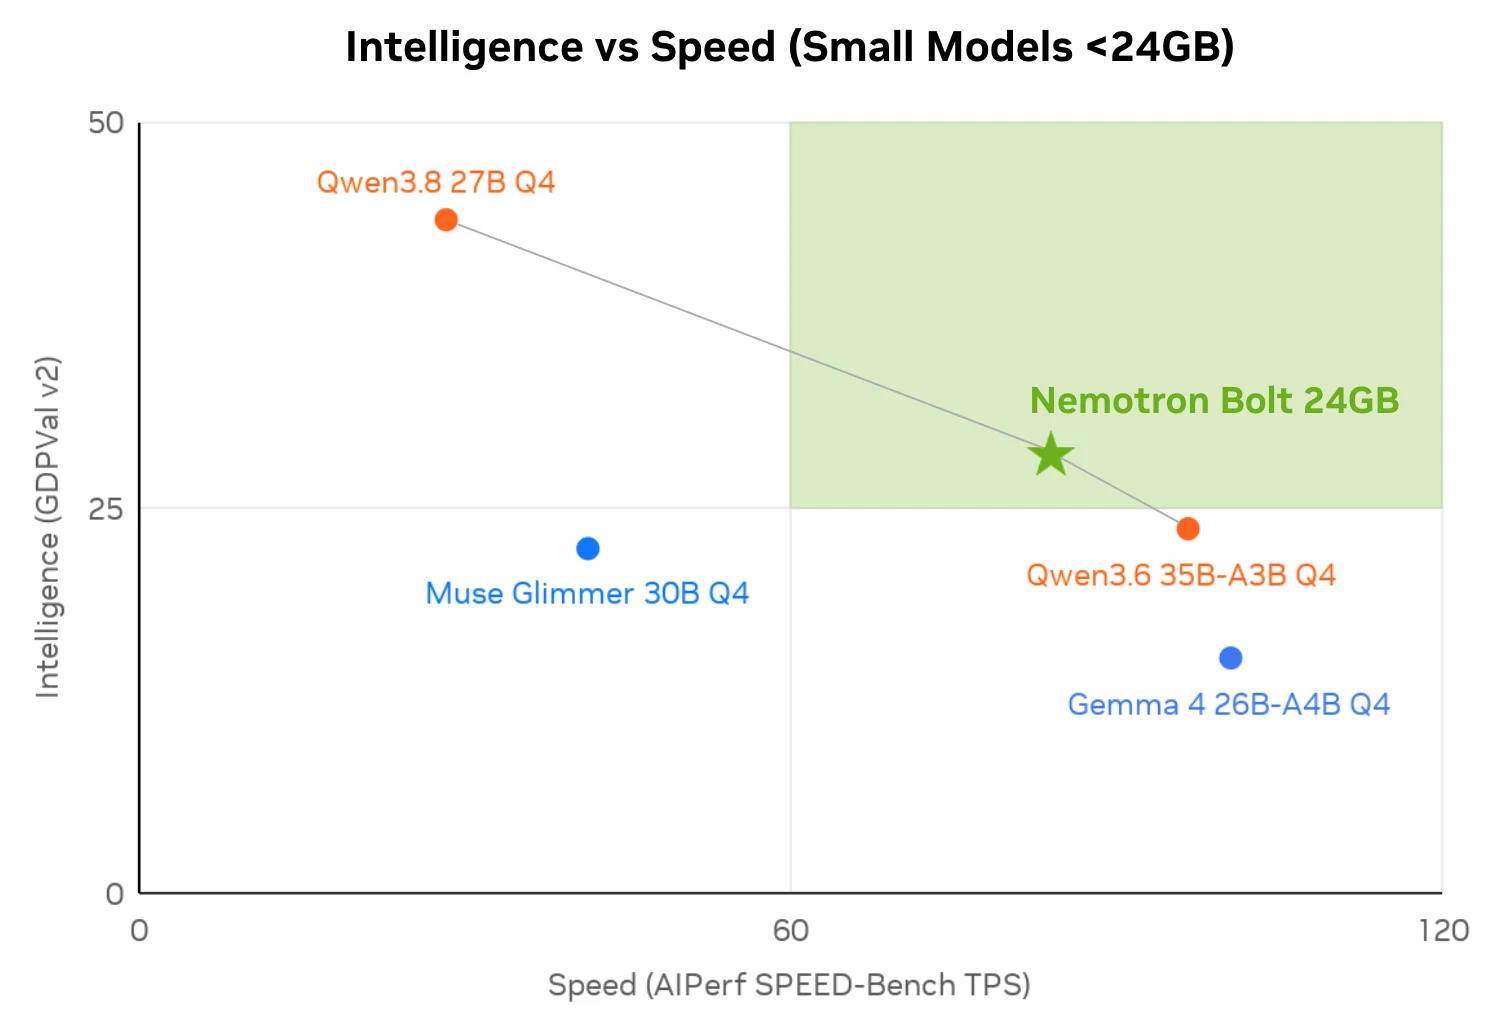
Mit Bolt 74B-A9B 24GB können Nutzer ihre Projekte an beliebte lokale Agent-Harnesses delegieren — von der Webrecherche über das Schreiben bis zum Debuggen von Code — alles ohne diese Workloads in die Cloud zu senden. Es ist das #1 offene Modell seiner Klasse auf PinchBench, und das #2 offene Modell für BrowseComp.
Bolt E4B 4GB wurde für physische und dialogorientierte Agenten auf GeForce RTX, Jetson und RTX/DGX Spark entwickelt. Es kombiniert natürliche Konversation mit mehrstufigen agentischen Fähigkeiten, um schnelle lokale Sprachassistenten, interaktive Charaktere und eingebettete Benutzeroberflächen anzutreiben.
Adoption individueller Super-Intelligenz
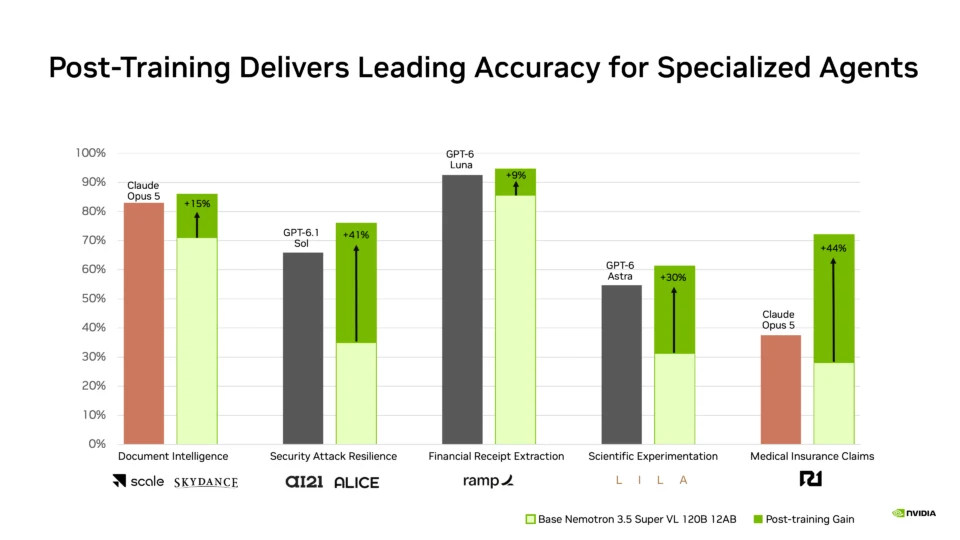
Dutzende Organisationen aus verschiedenen Branchen trainieren Super VL mit ihren eigenen Daten, Tools, Richtlinien und Workflows nach, um die Genauigkeit bei den spezialisierten Aufgaben weiter zu erhöhen, die ihre Agent-Deployment-Arten definieren.
Super VL wird von Organisationen verschiedener Branchen nachtrainiert und angepasst. Scale AI hat das Modell für Skydances Agenten für Lieferantenkreditfinanzierung und für EYs M&A-Due-Diligence-Agenten nachtrainiert. AfterQuery hat das Modell für Hebbia zur Analyse von Kreditverträgen angepasst. AI21 und Alice haben das Modell für die Resilienz gegen Cyberangriffe nachtrainiert. Mercor hat das Modell auf dem APEX-SWE-Coding-Benchmark nachtrainiert, für Coding-Agenten, die Code planen, schreiben und debuggen. ModelScope ermöglicht Entwicklern, das Modell über sein ms-swift Framework für spezielle multimodale Anwendungen zu fine-tunen.
Weitere Organisationen, die Nemotron 3.5 Super VL anpassen, sind Ramp für Dokumentenintelligenz im Finanzbereich; Dream für souveräne KI-gestützte Cybersicherheitsforschung und Schwachstellenanalyse; Lila Sciences für wissenschaftliche Entdeckung und Suche, sowie R1 für medizinische Anspruchsanalysen und Revenue-Cycle-Management. TrainLoop posttrainierte das Modell mit dermatologischen Daten von Nolla, das gerade das erste Unternehmen wurde, dem KI für das Verfassen erster Patientenrezepte genehmigt wurde.
Softwareplattform-Unternehmen, die Nemotron 3.5 Super VL integrieren, sind:
- Atlassian, für Aufgaben wie agentenbasierte Suche über Apps wie Jira und Confluence hinweg.
- CrowdStrike, das das Modell für agentenbasiertes Blue Teaming in der Unternehmenssicherheit anpasst.
- Dassault Systèmes, das Ingenieursdesign und Simulation antreibt.
- Perplexity, für Suche und agentenbasierte Aufgaben in Perplexity Search and Computer.
- Salesforce, das Nemotron anpasst, um KI-Agenten zu betreiben, die komplexe Behörden-Workflows in sicheren Kundenumgebungen durch Missionforce Operations digitalisieren und automatisieren.
- Synopsys -Software für Halbleiter-Designverifikation arbeitet mit dem Modell zusammen.
Was Nemotron 3.5 Super VL tatsächlich sieht
Nemotron 3.5 Super VLs Vision-Language -Stärken sind auf das ausgerichtet, was Agenten in der Praxis begegnen: optische Zeichenerkennung, Tabellen, Diagramme und strukturierte Informationen in visuellen Dokumenten.
Es verarbeitet eine Webseite, extrahiert Text, liest Grafiken und Diagramme und liefert Erkenntnisse aus dem, was es findet. Dasselbe gilt für PDFs und andere Dokumente, mit denen Agenten häufig arbeiten.
Nemotron 3.5 Super VL versteht Bilder, Webseiten und PDFs und handelt auf Grundlage dieses Verständnisses. Die Kombination von Text- und visueller Interpretation in einem Modell bedeutet, dass Agenten Aufgaben nicht zwischen separaten Systemen weiterleiten müssen — der Kontext bleibt erhalten, während die Arbeit vom Dokument zu den Daten zur Entscheidung fortschreitet.
Offen für maximale Kontrolle, Sicherheit und Datenschutz
Offenheit und Anpassbarkeit verstärken sich gegenseitig. Das Modell wird mit offenen Gewichten, offenen Datensätzen und Trainingsrezepten ausgeliefert.
Kontrolle wirkt in zwei Richtungen. Organisationen können das Modell überall dort betreiben, wo es ihre Sicherheits- und Datenresidenzanforderungen verlangen. Sie entscheiden sich zudem für ein Modell, das sie anpassen können, statt für eines, das den Beschränkungen eines Anbieters unterliegt.
In der Versicherungsbranche kann beispielsweise ein angepasster Agent wiederholt Schadensfälle auf Betrugsmerkmale prüfen. Im Finanzdienstleistungssektor kann ein Agent Bonitätsbewertungen überprüfen und Aktivitäten anhand der eigenen Kreditvergabekriterien eines Unternehmens kennzeichnen. Das Modell bleibt on-premises. Die Daten bleiben privat.
Die Anpassung wird durch NVIDIA NeMo, Python-basierte Pipelines und offene Datensätze unterstützt.
Nemotron 3.5 Super VL wurde auf etwa 26 Billionen Token über Pretraining und fortgesetztes Pretraining trainiert und anschließend mit rund 3,8 Millionen Samples sowie Reinforcement Learning über Dutzende von Umgebungen post-trainiert.
NVIDIA veröffentlicht außerdem offene Datensätze auf Hugging Face, die agentenbasierte Tool-Nutzung, Finanzen, Befolgung von Anweisungen, lange Kontexte, Fairness und Vision-Sprache-Verständnis, sowie die Reinforcement-Learning-Umgebungen in NeMo Gym.
NVIDIA NIM packt das Modell als produktionsreifen Microservice mit leistungsoptimierten, validierten Konfigurationen und Support auf Enterprise-Niveau, der alle zwei Wochen mit Sicherheitspatches und Leistungsverbesserungen aktualisiert wird.
Und da das Modell auf NVIDIA Dynamo läuft, können Organisationen bis zu 8x mehr Nutzer mit 85% geringerer Latenz bedienen.
Nemotron 3.5 Super VL ist jetzt auf Hugging Face, Open Router, ModelScope community und als NVIDIA NIM verfügbar.
Läuft auf DGX Spark, DGX Station und RTX
Nemotron 3.5 Super VL läuft auf NVIDIAs kompletter Hardware-Palette: auf DGX Spark, DGX Station, RTX PRO und RTX-Systemen für lokale Intelligenz am Desktop, auf NVIDIA Jetson am Edge sowie in Rechenzentren und Cloud-Umgebungen.
Nemotron 3.5 Bolt 74B-A9B 24GB ist jetzt auf Hugging Face verfügbar, mit Unterstützung für llama.cpp, Ollama, LM Studio, Unsloth, und vLLM. Entwickelt für NVIDIA RTX Spark Laptops erscheint am 16. Okt., läuft außerdem auf GeForce RTX PCs, DGX Spark, DGX Station und RTX PRO Workstations.
Laden Sie die offene Gewichte, erkunden Sie Anpassungsressourcen mit NVIDIA NeMo oder lesen Sie die technischer Blog für die vollständige Architektur-Analyse.
Bleiben Sie zu Agenten auf dem Laufenden, NVIDIA Nemotron und mehr durch ein Abonnement von NVIDIA-News, der Community beitreten, und folgen Sie NVIDIA AI auf LinkedIn, Instagram, X und Facebook.
Erkunden selbstgesteuerte Videotutorials und Livestreams.
Siehe Hinweis bezüglich Software-Produktinformationen.