
Muse Spark Open, Metas auf Programmierung optimiertes Open-Weight-Modell, ist jetzt verfügbar in Amazon SageMaker JumpStart, dem Machine-Learning-Hub (ML) von Amazon SageMaker AI. Das Modell wurde anhand echter Entwickler-Workflows trainiert, wie z. B. Multi-File-Refactorings und lange Debugging-Sitzungen, und unterstützt ein Kontextfenster von 1 Million Tokens. Sie können es in wenigen Schritten auf einem SageMaker-AI-Endpoint in Ihrem eigenen AWS-Konto bereitstellen, ohne die Serving-Infrastruktur selbst verwalten zu müssen. SageMaker JumpStart bietet zwei Varianten an: BF16 (Muse-Spark-Open-816B-A42B) und NVFP4-quantisiert (Muse-Spark-Open-816B-A42B-NVFP4).
In diesem Beitrag stellen wir Muse Spark Open vor und zeigen Ihnen, wie Sie das Modell mit Amazon SageMaker Studio und dem SageMaker Python SDKbereitstellen, ihm eine erste Inferenzanfrage senden und alles anschließend bereinigen.
Überblick über Muse Spark Open
Meta beschreibt Muse Spark Open als ein für Programmierung optimiertes Modell, das für agentische Coding-Workflows trainiert wurde, mit Fokus auf Genauigkeit beim ersten Versuch, Tool-Aufrufe und das Verständnis großer Codebasen. Es ist ein Reasoning-Modell und akzeptiert Text, Bilder, Dokumente, Audio sowie Audio-Video als Eingabe und gibt Text zurück.
Muse Spark Open verwendet eine Mixture-of-Experts-Architektur (MoE) mit insgesamt 816 Milliarden Parametern, von denen 42 Milliarden für jedes Token aktiv sind. Das Modell besitzt die Kapazität eines sehr großen Netzwerks, während der Rechenaufwand pro Token näher an dem eines deutlich kleineren Dense-Modells liegt. Meta veröffentlicht die Gewichte unter der Muse Model License, die die Muse Spark Usage Policy einschließt.
Die folgende Tabelle fasst das Modell zusammen.
| Attribut | Muse Spark Open |
| Anbieter | Meta |
| Architektur | Mixture of experts (MoE), Reasoning-Modell |
| Parameter | 816B insgesamt, 42B aktiv |
| Kontextlänge | 1M Tokens |
| Eingabemodalitäten | Text, Bild, Dokument, Audio, Audio-Video |
| Ausgabemodalitäten | Text |
| Varianten in SageMaker JumpStart | BF16 und NVFP4 |
| Lizenz | Muse Model License, einschließlich der Muse Spark Usage Policy |
Entwickelt für langlebige Coding-Agents
Meta trainierte Muse Spark Open anhand der Art und Weise, wie Entwickler in echten Repositories arbeiten: Code-Generierung, Debugging, Multi-File-Refactorings und Aufgaben, die über eine lange Zeit laufen. Mit dem 1 Million-Token-Kontextfenster kann das Modell ein ganzes Projekt aufnehmen, einschließlich seiner Abhängigkeiten, Legacy-Codes und Tausenden von Dateien. Sie müssen eine Aufgabe nicht in kleinere Teile aufteilen, damit sie in den Kontext passt.
Meta entwarf Muse Spark Open auch von Anfang an als agentisches Modell. Meta sagt, dass das Modell plant, handelt, das Ergebnis beobachtet und sich über lange Zeiträume selbst korrigiert, anstatt einzelne Tool-Aufrufe zu machen. Als Reasoning-Modell arbeitet es eine Aufgabe durch, bevor es handelt, und der SageMaker-AI-Endpunkt gibt dieses Reasoning zusammen mit der Antwort zurück, sodass Sie nachvollziehen können, was ein Agent tut und warum. Meta trainierte das Modell, im Web zu browsen, Sub-Agents für Arbeiten, die aufgeteilt werden können, zu koordinieren und Computer über Desktop-, Mobil- und Browser-Umgebungen hinweg zu bedienen. Dies sind Fähigkeiten des Modells. Auf SageMaker AI stellt Ihre Anwendung oder Ihr Agent-Framework die Tools, den Browser und die Computer-Use-Umgebung bereit, die das Modell aufruft. Über Code hinaus berichtet Meta, dass Muse Spark Open über Bilder, Dokumente, Audio und Video hinweg_REASONIERT.
Zwei Eigenschaften des Modells bestimmen, wie Sie es bereitstellen. Erstens hält die spärliche Aktivierung den Compute pro Token gering, aber das Serving erfordert dennoch genügend GPU-Speicher, um alle 816 Milliarden Parameter zu halten, sodass es bei der Instanzwahl auf die Speicherkapazität ankommt. Zweitens speichert die NVFP4-Variante die Gewichte im 4-Bit-Gleitkommaformat von NVIDIA, was ungefähr ein Viertel des Speichers der BF16-Gewichte benötigt. Auf SageMaker AI entscheidet dieser Unterschied über die Instanz: Die NVFP4-Variante läuft auf ml.p5e.48xlarge, und die BF16-Variante läuft auf ml.p6-b300.48xlarge. Das macht NVFP4 zur Variante, die Sie zuerst ausprobieren, wenn Sie auf Kosten dimensionieren. Bewerten Sie sie anhand Ihrer eigenen Workloads, um zu bestätigen, dass die Qualität zu Ihrem Anwendungsfall passt.
Mit offenen Gewichten auf SageMaker AI kontrollieren Sie auch die Bereitstellung. Der Endpunkt läuft in Ihrem AWS-Konto, sodass Ihr Quellcode und Ihre Prompts auf Infrastruktur verarbeitet werden, die Sie konfigurieren und kontrollieren. Sie können den Endpunkt an Ihre eigene Amazon Virtual Private Cloud (Amazon VPC)anhängen, sein Speichervolume mit einem Schlüssel aus AWS Key Management Service (AWS KMS)verschlüsseln und die Netzwerkisolation für den Container aktivieren. Sie wählen auch den Instanztyp und die Skalierungsgrenzen und fixieren die Modellversion, sodass sich das Modell nur ändert, wenn Sie es neu bereitstellen.
Anwendungsfälle
Sie können Muse Spark Open für ein breites Spektrum an Anwendungen einsetzen. Metas Fokus auf Coding und agentische Workflows eignet sich für die folgenden Anwendungsfälle:
- Coding-Assistenten für private Repositories: Beantworten Sie Fragen zu großen Codebasen, refaktorieren Sie sie und debuggen Sie sie mit dem gesamten Projekt im Kontext, während der Code auf einem Endpoint in Ihrem Konto verarbeitet wird.
- Langlebige Coding-Agents: Führen Sie Agents aus, die eine Änderung planen, mehrere Dateien bearbeiten, Tests in Ihrer eigenen Sandbox ausführen und anhand der Ergebnisse den Kurs korrigieren.
- Multimodale Engineering-Workflows: Verwandeln Sie Screenshots, Design-Dokumente oder einen aufgezeichneten Fehlerbericht mit Audio und Video in einen Reproduktionsplan oder einen Entwurf einer Korrektur.
Erste Schritte mit SageMaker JumpStart
Sie können Muse Spark Open aus SageMaker Studio oder mit dem SageMaker Python SDK bereitstellen. Jeder Pfad erstellt einen Echtzeit-SageMaker-AI-Endpoint in Ihrem Konto.
Voraussetzungen
Bevor Sie beginnen, stellen Sie sicher, dass Sie Folgendes haben:
- Ein AWS-Konto mit Berechtigungen zum Erstellen von SageMaker-AI-Modellen und -Endpoints.
- Eine AWS Identity and Access Management (IAM) Ausführungsrolle für SageMaker AI. Für diese Anleitung ist die
AmazonSageMakerFullAccessverwaltete Richtlinie ausreichend. Für die Produktion beschränken Sie die Rolle auf die Aktionen und Ressourcen, die Ihre Bereitstellung benötigt. Details finden Sie unter How to use SageMaker AI execution roles. - Eine SageMaker-AI-Domain mit Zugriff auf SageMaker Studio für den Studio-Pfad. Einrichtungsanweisungen finden Sie unter Use quick setup for Amazon SageMaker AI.
- Service-Quota für den Endpoint-Instanztyp: ml.p5e.48xlarge for endpoint usage für die NVFP4-Variante oder ml.p6-b300.48xlarge for endpoint usage für die BF16-Variante. Um eine Quota anzuheben, siehe Requesting a quota increase.
- Für den SDK-Pfad: Python 3.10 oder höher und SageMaker Python SDK v3 (
pip install --upgrade sagemaker). - Eine AWS-Region, in der Muse Spark Open in SageMaker JumpStart verfügbar ist. Zum Start ist Muse Spark Open in US East (N. Virginia) und US East (Ohio) verfügbar. Um die Verfügbarkeit in anderen Regionen zu prüfen, öffnen Sie SageMaker JumpStart in Ihrer Region.
Die Instanzen, die Muse Spark Open hosten, sind Multi-GPU-Instanzen, und Sie zahlen für einen Endpoint, solange er läuft, unabhängig davon, ob er Anfragen verarbeitet. Löschen Sie den Endpoint, wenn Sie fertig sind, wie im Aufräumbereich dieses Beitrags beschrieben. Zu den Preisen siehe Amazon SageMaker AI pricing.
Bereitstellung mit SageMaker Studio
Der SageMaker-Studio-Pfad eignet sich für eine erste Evaluierung: Sie finden das Modell, prüfen seine Lizenz und stellen es über eine einzige Modelldetailkarte bereit.
So finden Sie Muse Spark Open in SageMaker JumpStart
- Öffnen Sie SageMaker Studio.
- Wählen Sie im Navigationsbereich JumpStart.
- Geben Sie in das Suchfeld „Muse Spark Open“ ein.
- Auswählen Muse-Spark-Open-816B-A42B für die BF16-Variante oder Muse-Spark-Open-816B-A42B-NVFP4 für die NVFP4-Variante, um deren Modelldetailkarte zu öffnen.
Abbildung 1 zeigt die Modell-Detailkarte, die die Modellbeschreibung, die Lizenz und die Bereitstellen Option.
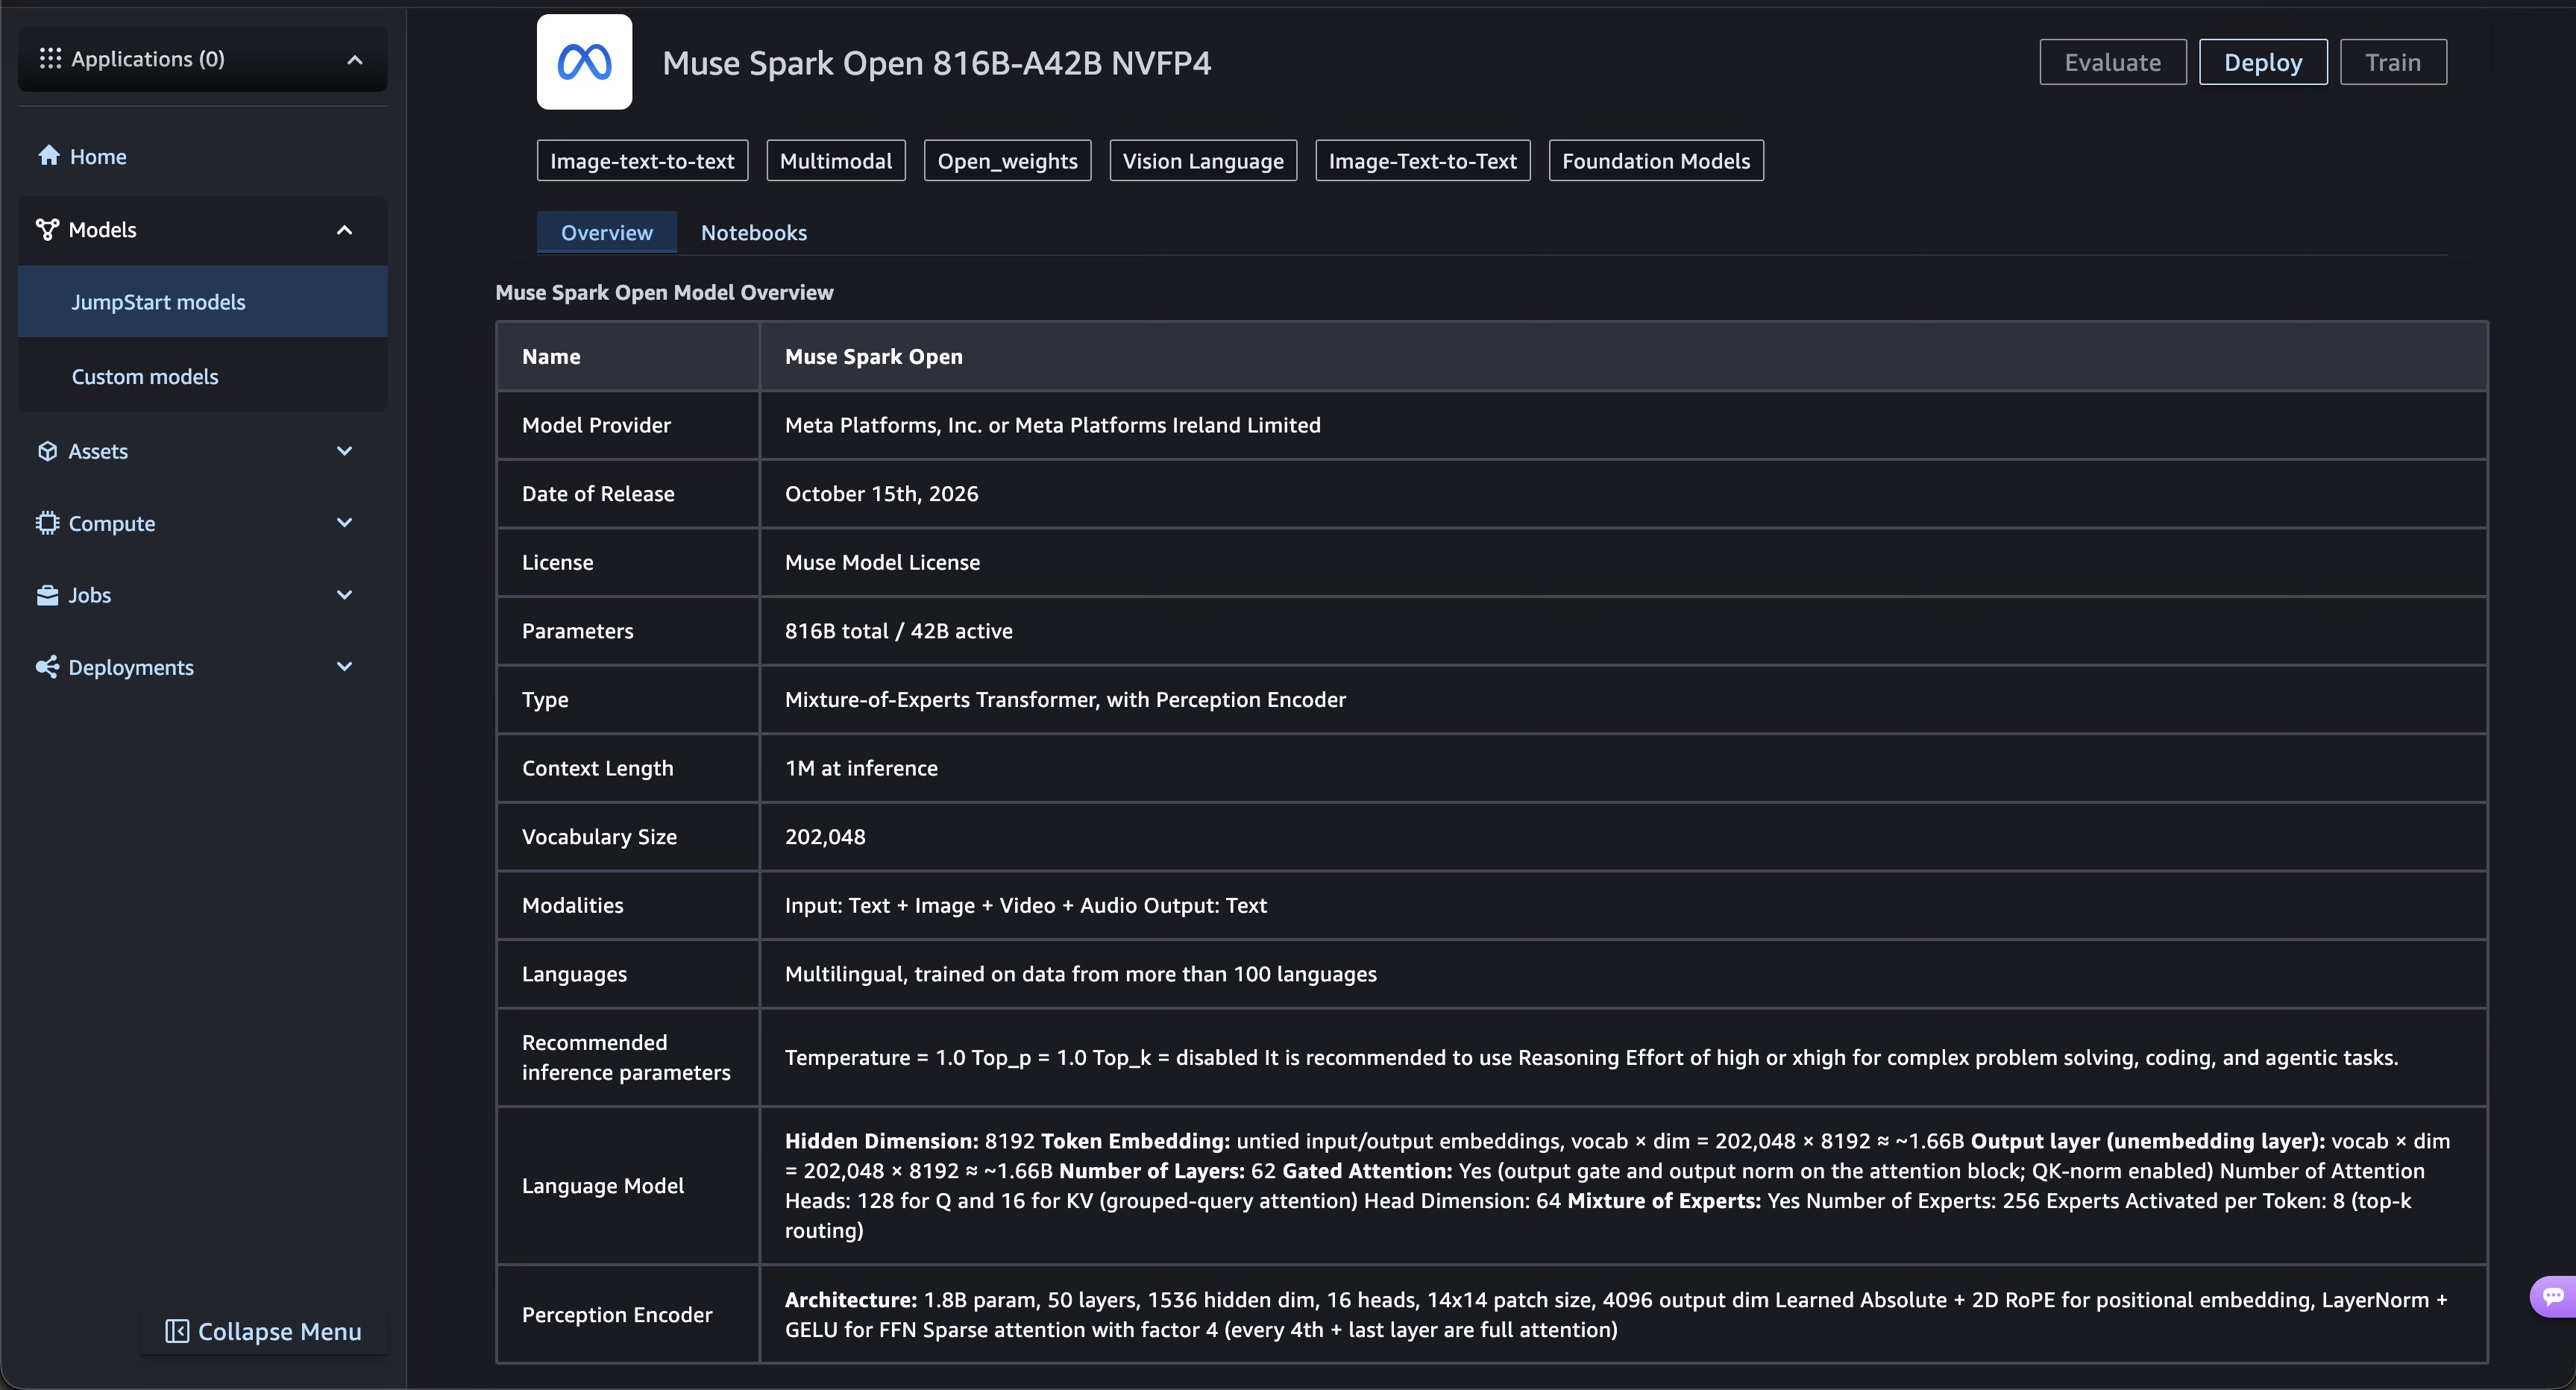
Abbildung 1: Die Modelldetailkarte des Muse Spark Open-Modells in SageMaker JumpStart
Um das Modell bereitzustellen
- Wählen Sie auf der Modell-Detailkarte Bereitstellen.
- Muse Spark Open ist ein eingeschränktes (gated) Modell, daher zeigt SageMaker Studio die Endbenutzer-Lizenzvereinbarung (EULA) an. Prüfen Sie die Vereinbarung und akzeptieren Sie sie, um fortzufahren.
- Für Endpunktname, behalten Sie den generierten Namen bei oder geben Sie einen eigenen ein.
- Wählen Sie bei Instance typeaus: ml.p5e.48xlarge für NVFP4 oder ml.p6-b300.48xlarge für BF16. SageMaker Studio listet nur die Instance-Typen auf, die das Modell unterstützt.
- Geben Sie bei Initial instance countden Wert 1 ein.
- (Optional) Unter Erweiterte Optionen, wählen Sie eine VPC und einen AWS KMS-Schlüssel aus oder aktivieren Sie die Netzwerkisolierung.
- Auswählen Bereitstellen.
Abbildung 2 zeigt die Bereitstellungseinstellungen für die NVFP4-Variante.
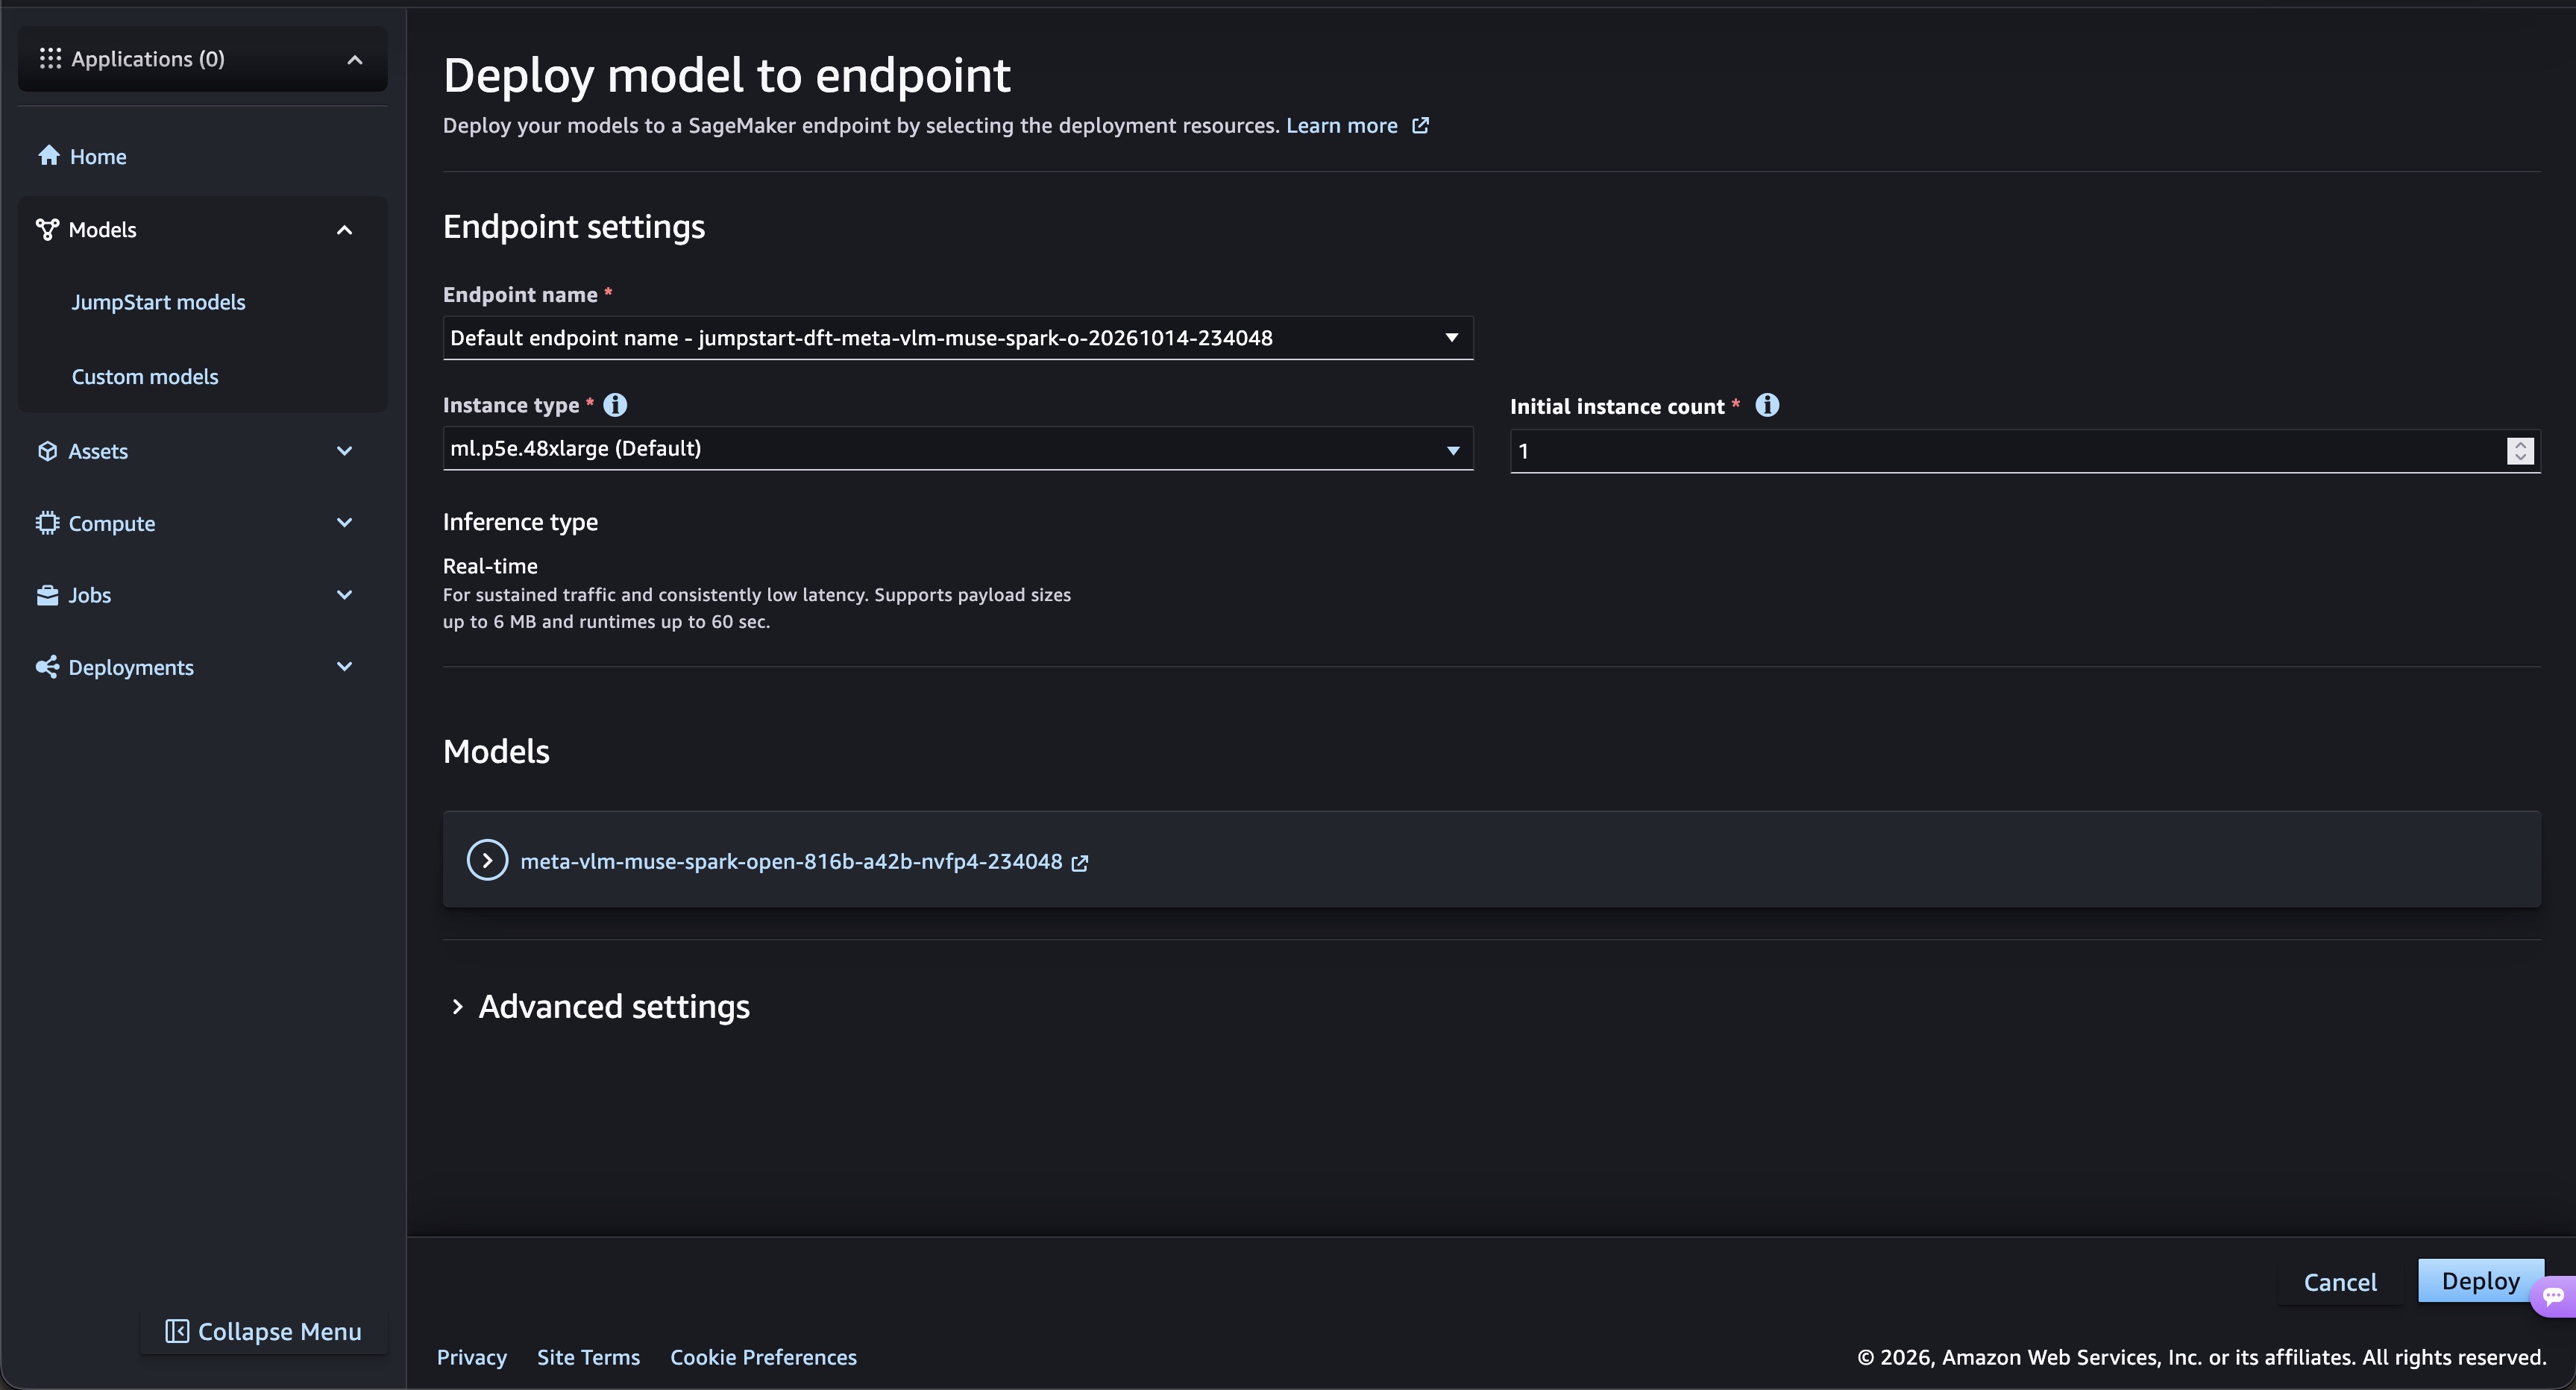
Abbildung 2: Bereitstellungseinstellungen für Muse Spark Open
Das Deployment dauert in der Regel 15–20 Minuten, während SageMaker AI die Instanz bereitstellt und die Gewichte lädt. Sobald sich der Endpunktstatus ändert zu InService, ist der Endpunkt für Anfragen bereit, wie in Abbildung 3 gezeigt.
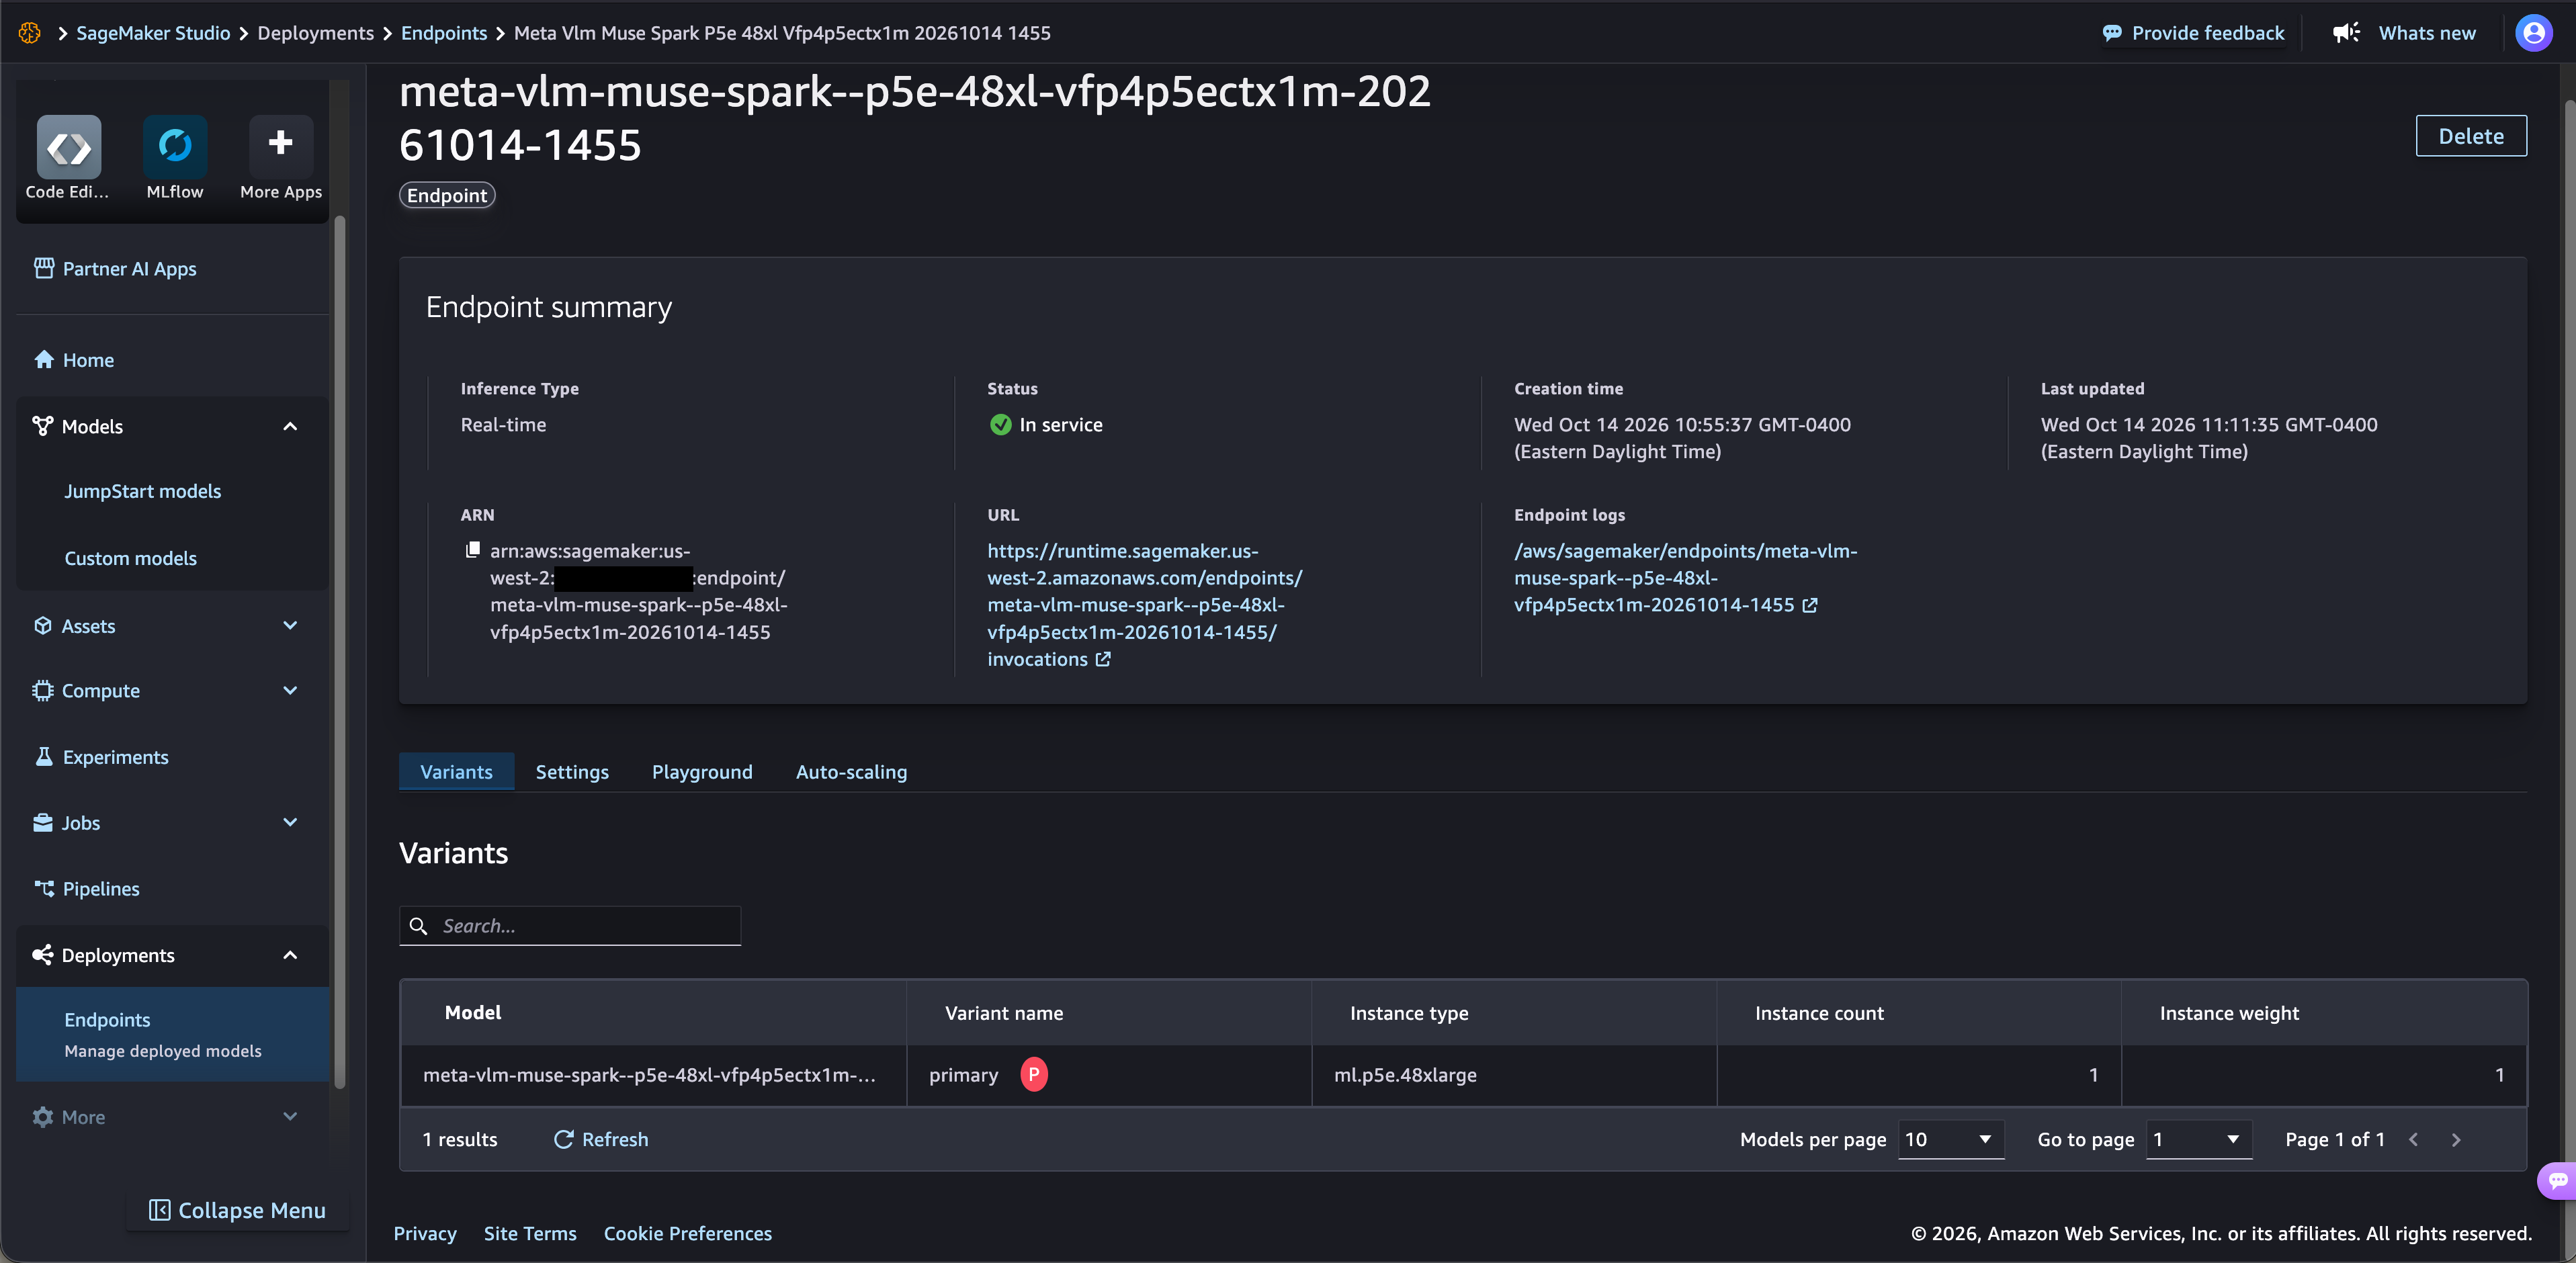
Abbildung 3: Der Muse Spark Open-Endpunkt im Einsatz
Deployment mit dem SageMaker Python SDK
SageMaker JumpStart identifiziert jede Variante über eine Modell-ID:
- BF16:
meta-vlm-muse-spark-open-816b-a42b. - NVFP4:
meta-vlm-muse-spark-open-816b-a42b-nvfp4.
Der folgende Code stellt die NVFP4-Variante mit dem SageMaker Python SDK v3 bereit. Sie können ihn in einem SageMaker-Studio-Notebook ausführen, das die Ausführungsrolle Ihrer Domain verwendet. Übergeben Sie in jeder anderen Python-Umgebung mit AWS-Anmeldeinformationen Ihre SageMaker-AI-Ausführungsrolle mit dem role_arn parameter. Muse Spark Open ist ein eingeschränktes Modell (gated model), daher müssen Sie accept_eula=True es bereitzustellen. Um eine bestimmte Modellversion festzulegen (Pinning), fügen Sie model_version zu JumpStartConfig.
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.serve import ModelBuilder
from sagemaker.train.configs import Compute

# NVFP4 variant; for BF16, use "meta-vlm-muse-spark-open-816b-a42b" with ml.p6-b300.48xlarge
model_id = "meta-vlm-muse-spark-open-816b-a42b-nvfp4"

jumpstart_config = JumpStartConfig(
    model_id=model_id,
    accept_eula=True,  # Confirms that you accept Meta's license terms
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(instance_type="ml.p5e.48xlarge"),
    # role_arn="<your-sagemaker-execution-role-arn>",  # Required outside SageMaker Studio
)

model = model_builder.build(model_name="muse-spark-open-nvfp4")
endpoint = model_builder.deploy(endpoint_name="muse-spark-open-nvfp4")
Inferenz ausführen
Wenn der Endpunkt in Betrieb ist, senden Sie ihm eine Anfrage mit der invoke -Methode. Der Endpunkt akzeptiert ein OpenAI-kompatibles Chat-Payload mit einer messages -Liste und gibt eine Chat-Vervollständigung zurück. Die endgültige Antwort befindet sich in message.content, die Überlegungen des Modells befinden sich in message.reasoning_content, und usage.reasoning_tokens gibt an, wie viele Token die Überlegungen verbraucht haben. Da Muse Spark Open ein Reasoning-Modell ist, lassen Sie in max_tokens genug Platz für seine Überlegungen und die endgültige Antwort.
import json

payload = {
    "messages": [
        {
            "role": "user",
            "content": "Write a Python function that validates ISO 8601 dates, and add pytest unit tests for it.",
        }
    ],
    "max_tokens": 4096,
}

response = endpoint.invoke(
    body=json.dumps(payload),
    content_type="application/json",
)

result = json.loads(response.body.read().decode("utf-8"))
message = result["choices"][0]["message"]
print("Reasoning:", message.get("reasoning_content"))
print("Answer:", message["content"])
Der Endpunkt unterstützt auch Streaming. Um Token zu empfangen, während sie generiert werden, fügen Sie "stream": true zum Anfragekörper hinzu und rufen Sie endpoint.invoke_with_response_stream anstelle von invoke.
Aufräumen
Um keine weiteren Kosten zu verursachen, löschen Sie den Endpunkt, wenn Sie ihn nicht mehr benötigen. Wenn Sie mit dem SDK bereitgestellt haben, löschen Sie das Modell, den Endpunkt und die Endpunktkonfiguration:
from sagemaker.core.resources import EndpointConfig

endpoint_config = EndpointConfig.get(endpoint_config_name=endpoint.endpoint_name)
model.delete()
endpoint.delete()
endpoint_config.delete()
Wenn Sie aus SageMaker Studio bereitgestellt haben, löschen Sie den Endpunkt in der SageMaker-AI-Konsole: Wählen Sie Inference, dann Endpoints, wählen Sie den Endpunkt aus und wählen Sie Actions, Delete.
Fazit
In diesem Beitrag haben wir gezeigt, wie Sie Muse Spark Open, Metas auf Programmierung optimiertes Open-Weight-Modell, von SageMaker JumpStart auf einen Endpunkt in Ihrem eigenen AWS-Konto bereitstellen. Sie haben SageMaker Studio oder das SageMaker Python SDK verwendet und eine erste Inferenzanfrage an das Modell gesendet. Benchmarken Sie beide Varianten an Ihren eigenen Repositorys, bevor Sie eine Instanz für die Produktion auswählen.
Um loszulegen, suchen Sie in SageMaker Studio nach Muse Spark Open in SageMaker JumpStart. Weitere Bereitstellungsoptionen, wie Inferenzkomponenten und optimierte Bereitstellungskonfigurationen, finden Sie unter JumpStart foundation model usage im Amazon SageMaker AI Developer Guide. Vor der Bereitstellung lesen Sie die Muse Model License, die SageMaker JumpStart bei der Bereitstellung des Modells anzeigt. Unterstützung bei der Planung einer Produktionsbereitstellung erhalten Sie unter contact AWS.