
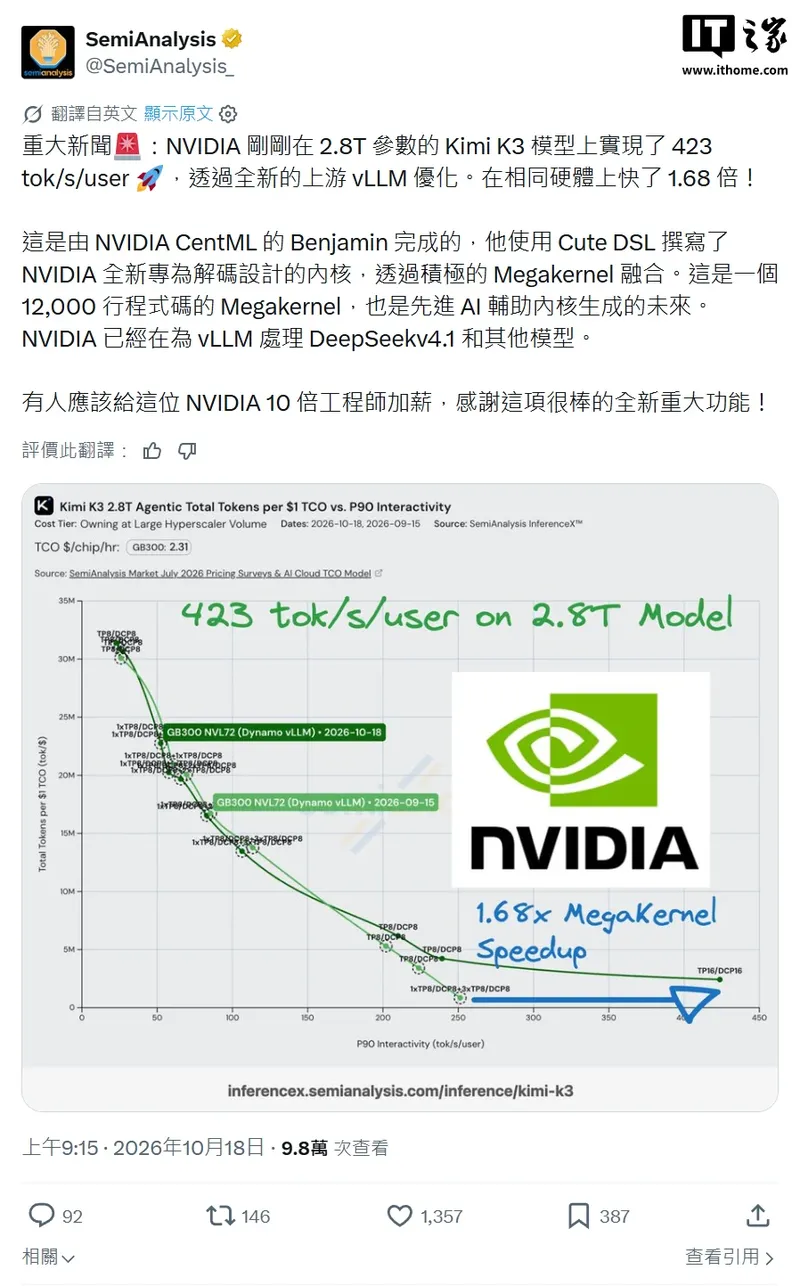
IT之家 – Bericht vom 18. Oktober: Die Forschungsorganisation SemiAnalysis berichtet heute, dass NVIDIA durch eine Optimierung von vLLM die Kimi K3-Modell mit 2,8 Billionen Parametern eine Rechengeschwindigkeit von 423 tok/s/user erreicht hat. Im Vergleich zu denselben Hardware-Parameter (GB300 NVL72) ist die Leistung um 1,68 Mal gesteigert.
Laut der Präsentation wurde diese Optimierung von Benjamin, einem Ingenieur von NVIDIA CentML, durchgeführt. Durch die massive Integration von Megakernen wurde ein neu eingeführter Decodier-Kern für NVIDIA mit Cute DSL geschrieben. Der Megakern enthält 12.000 Zeilen Code, was die zukünftige Richtung der mit AI unterstützten Erstellung von hochwertigen Rechenkernen darstellt. NVIDIA hat die Recheneffizienz des Kimi K3-Modells optimiert und um 1,68-fach verbessert.
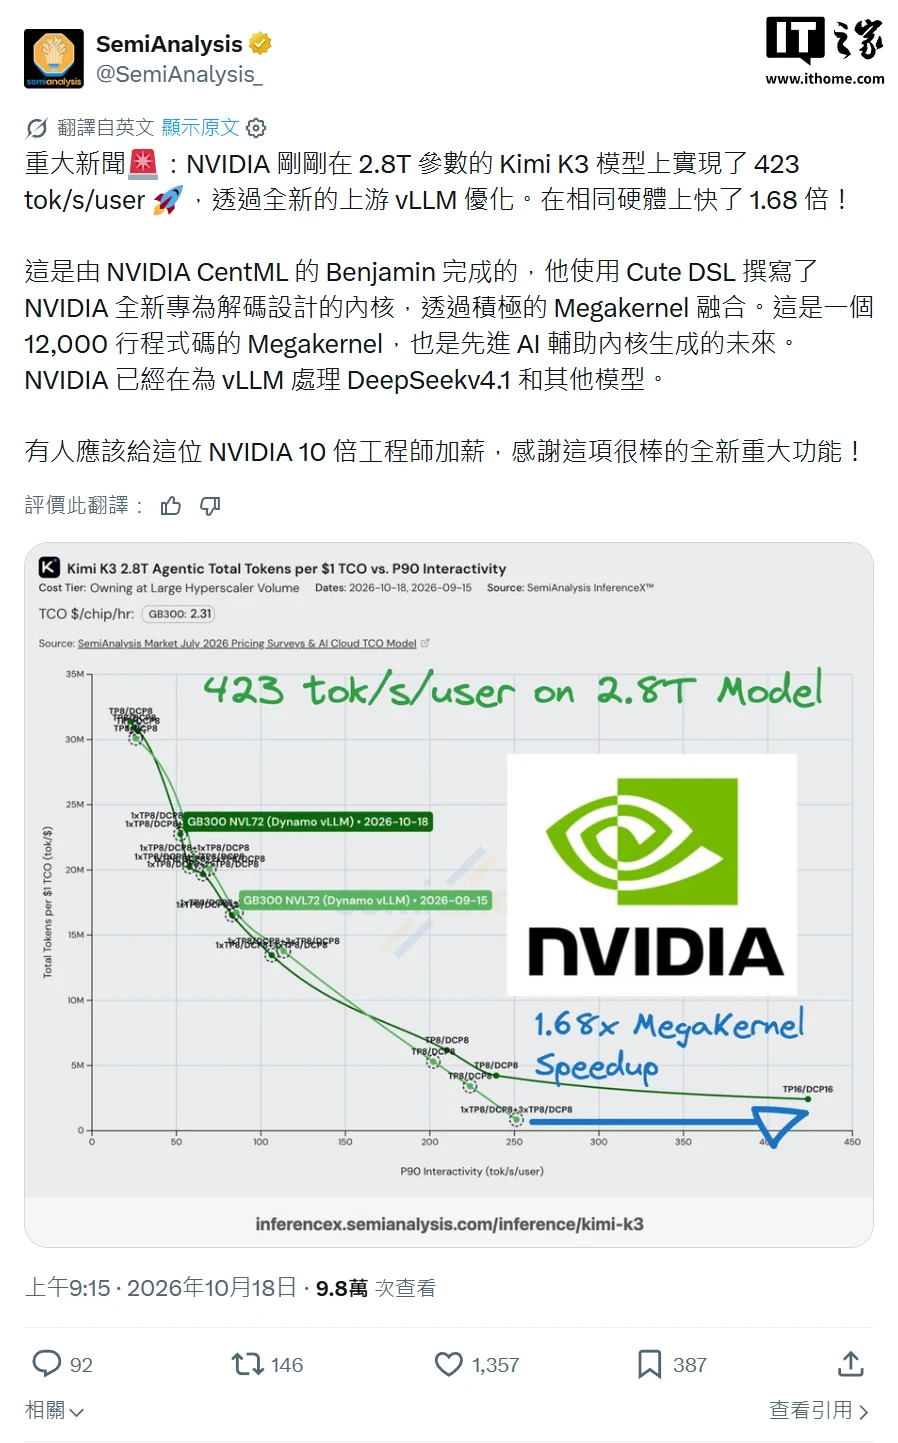
IT Home hat bemerkt, dass NVIDIA neben diesem Projekt auch die Optimierung anderer Modelle wie DeepSeek V4.1 für vLLM entwickelt.