
Am 16. Oktober fand in Shenzhen der zehnte CSDI Summit, ein Gipfel für intelligente Innovation in der Softwareentwicklung in China, statt. Xuan Shanming, Vizepräsident und CTO von SenseTime’s Large Device, hielt im Hauptforum eine Keynote mit dem Titel „Praxis und Trends der KI-Infrastruktur im Agentic-Zeitalter“, in der er Themen wie die Entwicklungstrends des Token-Wachstums im Agentic-Zeitalter, die Praxis heterogener Inferenzcluster und die Erforschung neuer Technologien für KI-Infrastruktur behandelte und die technologischen Erkundungen und die Praxis von SenseTime’s Large Device im Bereich groß angelegter Inferenzdienste vorstellte.
Xuan Shanming, Vizepräsident und CTO von SenseTime’s Large Device
Xuan Shanming wies darauf hin, dass mit dem Übergang von KI-Anwendungen von dialogbasierten Frage-Antwort-Systemen hin zu Multi-Agenten-Kollaboration und der Ausführung langer Aufgaben der Token-Bedarf um das Tausendfache wächst und dass die KI-Infrastrukturvor einer neuen Lage steht, in der explosionartige Nachfrage und Einschränkungen bei der Rechenleistungsversorgung gleichzeitig bestehen. In Zukunft wird der entscheidende Faktor im Branchenwettbewerb nicht nur sein, wie viel Rechenleistung verfügbar ist, sondern wie man durch Architekturinnovation, heterogene Koordination und Ressourcenschedulingzu geringeren Kosten, mit höherer Effizienz und stabiler kontinuierlich hochwertige Token erzeugt.
Von der Rechenleistungsskala zur Token-Produktionskapazität: Die KI-Infrastruktur erlebt einen Wandel hin zur Effizienz
Im Vergleich zu traditionellen dialogbasierten Frage-Antwort-Systemen beinhalten der Werkzeugaufruf eines einzelnen Agenten, die Multi-Agenten-Kollaboration sowie lange, unbeaufsichtigte Aufgaben deutlich mehr Modellaufrufe, Inferenzrunden und Kontextverarbeitung, sodass der Token-Verbrauch um das Tausendfache ansteigt. Gleichzeitig erschweren eine eingeschränkte Versorgung mit High-End-Chips sowie die Nichtübereinstimmung zwischen vorhandener Rechenleistung und den Ressourcenanforderungen von Inferenzaufgaben eine gleichzeitige Ausweitung der Rechenleistungsversorgung. Branchendaten zeigen, dass der Anteil der Inferenzausgaben an den Gesamtausgaben für KI-IaaS im Jahr 2026 voraussichtlich 55 % erreichen und bis 2027 auf 59 % steigen wird.
Gleichzeitig bestehen auch deutliche Unterschiede im Token-Bedarf verschiedener Anwendungen. Bei einfachen Frage-Antwort-Anwendungen stehen Stückkosten und Nebenläufigkeitsfähigkeit im Vordergrund; Szenarien wie Büro-Agenten und Kundenservice stellen höhere Anforderungen an Antwortlatenz und Generierungsgeschwindigkeit, während hochwertige Szenarien wie wissenschaftliche Forschung und Finanzquantifizierung stärker auf Ergebnisgenauigkeit, Auditauffähigkeit und Rückverfolgbarkeit achten. Kennzahlen wie Time-to-First-Token (TTFT), Generierungsgeschwindigkeit (OTPS), Long-Context-Caching, Nebenläufigkeitsfähigkeit und Erfolgsquote der Aufrufe bestimmen gemeinsam die Qualität und die Kosten der Token-Dienste.
Xuan Shanming sagte: „Das bedeutet, dass die KI-Infrastruktur nicht mehr länger auf eine einzige Hardwarekonfiguration setzen kann, um alle Aufgaben zu erfüllen, sondern die Rechenressourcen entsprechend den Serviceanforderungen verschiedener Szenarienschichtweise organisieren und gezielt steuern。und vom Ausbau der Skala zur Effizienzoptimierung sowie vom Ersatz einzelner Hardwarekomponenten zur heterogenen Koordination übergehenmuss – dies wird eine wichtige Entwicklungsrichtung der KI-Infrastruktur im Agentic-Zeitalter sein.“
Mit PD-Trennung als Kern: Aufbau eines heterogenen Inferenzclusters mit zehntausend Karten
Angesichts des Widerspruchs zwischen den Einschränkungen der High-End-Rechenleistungsversorgung und dem wachsenden Inferenzbedarf erforscht SenseTime’s Large Device eine entkoppelte Inferenzarchitektur:Durch PD-Trennung und heterogenes gemischtes Scheduling übernehmen unterschiedliche Arten von Rechenleistung jeweils die für sie besser geeigneten Aufgaben.
Im Prozess der Inferenz großer Modelle verarbeitet der Prefill-Schritt die Eingabe-Token und weist rechenintensive Merkmale auf; der Decode-Schritt erzeugt schrittweise Ausgabe-Token, muss kontinuierlich den Kontext-Cache lesen und stellt hohe Anforderungen an die Speicherbandbreite. Die PD-Trennung entkoppelt beide Vorgänge: Geeignete einheimische Rechenleistung übernimmt gebündelt die Prefill-Aufgaben, GPUs höherer Klasse mit hoher Bandbreite übernehmen die Decode-Aufgaben, und über eine KV-Cache-Übertragung werden die beiden Phasen verbunden. Dieser Ansatz ist nicht das bloße Zusammenfügen unterschiedlicher Chips, sondern eine Neuorganisation der Rechenressourcen entlang von Rechenmerkmalen, Speicherbandbreite und Aufgabenanforderungen. Einheimische Rechenleistung geht damit über die Ausführung grundlegender Inferenzaufgaben hinaus und beteiligt sich an Inferenzdiensten höherer Ebene, wodurch bei Erfüllung der Qualitätsanforderungen verschiedener Szenarien die Gesamteffizienz und das Preis-Leistungs-Verhältnis des hybriden Clusters verbessert werden.
Auf dieser Grundlage führt SenseTime’s Large Device am Lingang AIDC kontinuierlich heterogene Inferenzpraktiken durch und hat einen heterogenen Inferenzcluster mit zehntausend Karten aufgebaut. Für die Umsetzung dieser Architektur mussten die Verbindungsprobleme zwischen Rechenleistungen unterschiedlicher Generationen und Typen gelöst werden, indem Netzwerke unterschiedlicher Spezifikationen wie 800G, 400G und 200G in einem einzigen Cluster zusammengeführt wurden, um die effiziente Übertragung des KV-Cache zwischen Prefill- und Decode-Knoten sicherzustellen.
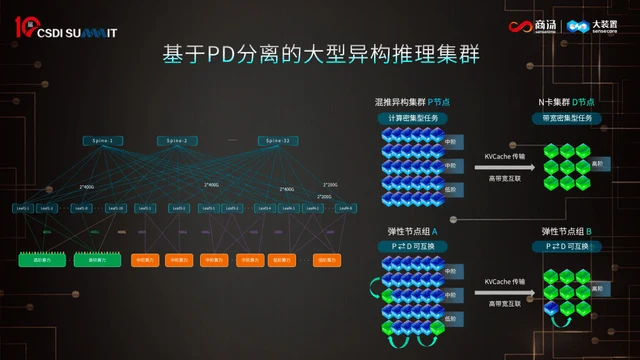
Doch mit dem Wachstum der Clustergröße sind Knotenausfälle und Ressourcenstillstand zu neuen technischen Herausforderungen geworden. So können in bestimmten heterogenen Konfigurationen beispielsweise 30 bis 50 Prefill-Knoten mittlerer und niedriger Klasse benötigt werden, um die Verarbeitungskapazität eines einzigen Decode-Knotens auszugleichen. Fällt ein Decode-Knoten aus, können zahlreiche Prefill-Ressourcen ungenutzt bleiben, was die Gesamteffizienz des Dienstes beeinträchtigt.
Daraufhin hat SenseTime’s Large Device zwei Optimierungsansätze erprobt. Einerseits wird im Prefill-Ressourcenpool eine geringe Menge an High-End-Rechenleistung reserviert, sodass bei einem Ausfall von Decode-Knoten schnell High-End-Knoten zur Lücke auffüllen eingesetzt werden können. Zum anderen verfügen die Knoten im Cluster über die Fähigkeit zum dynamischen Wechsel zwischen Prefill- und Decode-Rollen, sodass die Aufgabenverteilung der Knoten je nach aktueller Last und Ressourcendruck flexibel angepasst und eine dynamische Fließfähigkeit und elastische Steuerung der Rechenressourcen erreicht wird. Durch diese beiden Ansätze lässt sich bei gleichzeitiger Kostensenkung sicherstellen, dass der groß angelegte heterogene Cluster kontinuierlich und stabil hochwertige Token ausgibt.
Aufbauend auf diesen Praktiken hat SenseTime’s Large Device einsechsschichtiges Architektursystemweiterentwickelt, das Energieeinrichtungen, Ressourcenvernetzung, KV-Datenebene, Inferenz-Laufzeit, Service-Scheduling und Delivery-Layer umfasst und die heterogene Hardware zu einem einheitlich steuerbaren, elastisch laufenden Inferenzdienstesystem organisiert.
Laut Xuan Shanming lässt sich in einer bestimmten Testkonfiguration im Vergleich zur Referenzlösung – bei gleicher Anzahl an High-End-Flaggschiff-Karten – durch heterogene Inferenz und Ressourcenkoordinationder gesamte Token-Durchsatz auf das 5-fache des ursprünglichen Werts steigern.
Von domänenübergreifender PD-Trennung zur AF-Trennung: Kontinuierliche Erweiterung der Grenzen der Inferenzarchitektur
Aufbauend auf der groß angelegten heterogenen Inferenz erforscht SenseTime’s Large Device darüber hinausTechnikrichtungen wie domänenübergreifende PD-Trennung und AF-Trennung, um das Koordinationspotenzial verteilter Rechenressourcen weiter freizusetzen.
Das jugendübergreifende... Xuan Shanming erläuterte, dass nach der Realisierung der PD-Trennung in einem einzelnen Rechenzentrum der nächste Schritt die Erforschung der domänenübergreifenden PD-Trennung sei, um die Rechenressourcen verschiedener Regionen noch besser zu nutzen. SenseCore (die SenseTime-KI-Großanlage) arbeitet landesweit mit Regierungen verschiedener Regionen zusammen; durch übergreifende Koordination kann die lokale Rechenleistung mittlerer und niedrigerer Stufe das Prefill übernehmen und den KV Cache an Hochleistungs-Compute-Cluster in anderen Regionen übertragen, wo das Decode abgeschlossen wird.So wird eine Inferenz-Orchestrierung über Cluster, Rechenzentren und sogar Regionen hinweg erreicht.
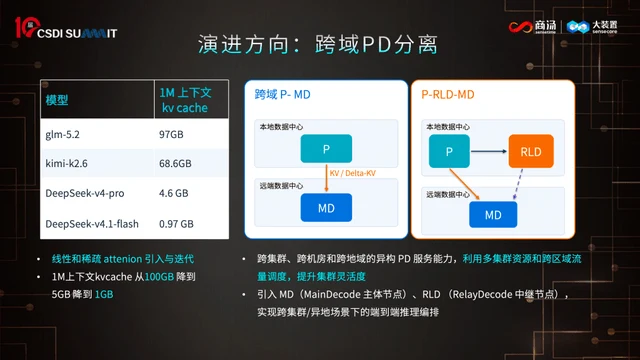
Die Machbarkeit dieser Richtung hängt eng mit der Weiterentwicklung der Modellarchitekturen zusammen: Der Umfang des KV Cache bei einem Kontext von 1 Mio. Token ist bei einigen Modellen bereits von fast 100 GB auf etwa 1 GB gesunken, was den Aufwand für die domänenübergreifende Übertragung erheblich reduziert. SenseCore untersucht außerdem die Einführung von Master-Decode-Knoten (MD) und Relay-Decode-Knoten (RLD), um die Inferenz-Orchestrierung über Standorte hinweg zu unterstützen. So kann selbst dann, wenn eine Region nicht über vollständige Hochleistungs-Compute-Kapazitäten verfügt, durch die Integration von Rechenressourcen unterschiedlicher Größe und Leistung das einheitliche Rechnernetz von der bloßen Ressourcenverbindung zur Aufgabenkoordination weiterentwickelt und ein Token-Dienst mit höherem Durchsatz und höherer Qualität realisiert werden.
Die AF-Trennung entkoppelt darüber hinaus die verschiedenen Rechenaufgaben während des Inferenzprozesses. In der Decode-Phase ist die Attention vor allem für die Verarbeitung des Kontexts und die Extraktion wichtiger Informationen zuständig und stellt hohe Anforderungen an Grafikspeicherkapazität und Bandbreite; das FFN übernimmt umfangreiche Matrizenmultiplikationen und stellt höhere Anforderungen an die Rechenleistung. In herkömmlichen Architekturen sind beide an denselben GPU-Ressourcen gebunden, was zu Ressourcenkonkurrenz führen kann. Die AF-Trennung deployed Attention und FFN auf Hardware, die besser zu den jeweiligen Aufgabenmerkmalen passt, und ermöglicht so eine unabhängige Skalierung und Ressourcenoptimierung.
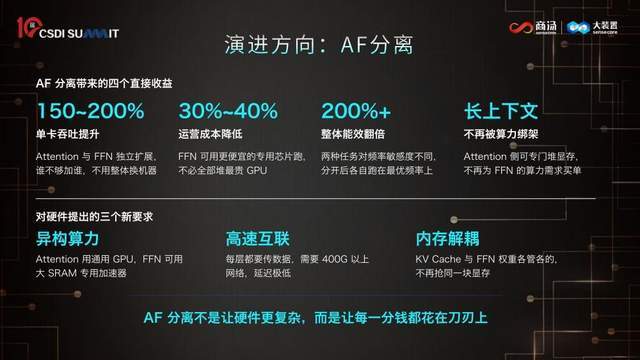
Künftig könnte die AF-Trennung eine Steigerung des Durchsatzes pro Karte um 150 % bis 200 %, eine Senkung der Betriebskosten um 30 % bis 40 % und eine Erhöhung der Gesamtenergieeffizienz auf mehr als das Doppelte des ursprünglichen Niveaus mit sich bringen. Die tatsächlichen Gewinne hängen weiterhin von der konkreten Modellarchitektur, der Hardware-Konfiguration und der Systemimplementierung ab, doch der technische Ansatz ist einheitlich: Leistungsengpässe im Inferenzprozess kontinuierlich identifizieren und durch feinere Aufgabenzergliederung und Ressourcenzuweisung die Effizienz des Gesamtsystems steigern.
Von der PD-Trennung über die domänenübergreifende PD-Trennung bis zur AF-Trennung wird die kontinuierliche Weiterentwicklung der Inferenzarchitekturen künftig voraussichtlich die Leistungs- und Kostenvorteile der Inferenz-Infrastruktur noch weiter freisetzen.
Von der Kunst des Tunings zum Systemingenieurwesen: Der Wert der Inferenz anhand von SLA und Kosten bemessen
Xuan Shanming ist der Ansicht, dass die Optimierung der Inferenz-Infrastruktur auf zwei Kernkennzahlen zurückkommen muss: erstens die End-to-End-Dienstqualität, d. h. ob das System die vereinbarte Antwortgeschwindigkeit, Generierungseffizienz, Nebenläufigkeit und Aufruferfolgsquote erfüllen kann; zweitens die Kosten, d. h. wie viele nutzbare Token unter Einhaltung der entsprechenden Anforderungen an die Dienstqualität pro investierter Einheit erzeugt werden können.
Dies stellt auch höhere Anforderungen an die Infrastruktur. Einheimische Rechenleistung und Hochleistungs-Compute müssen laufend mit verschiedenen Modellen abgestimmt werden, und die schnelle Iteration von Modellen und Anwendungen erhöht die Komplexität der Optimierung weiter. Nur wenn Hardware-Konfiguration, Modellmerkmale, Aufgabenanforderungen und Scheduling-Strategien in ein einheitliches System eingebunden werden, lässt sich in der mehrdimensionalen Kombination kontinuierlich eine bessere Lösung finden.
Derzeit verbessert SenseCore durch das Token-Fabrik-Modell seine Fähigkeit zur Bereitstellung von Inferenzdiensten im großen Maßstab. Das tägliche Token-Dienstvolumen der SenseCore-Plattform hat bereits 6 Billionen erreicht; für das Gesamtjahr 2026 wird eine 25-fache Steigerung des Token-Dienstvolumens erwartet, und im vierten Quartal soll ein Volumen von 10 Billionen Token pro Tag erreicht werden.
Xuan Shanming erklärte, in der Agentic-Ära sei nicht der Mangel an Chips das Problem, sonderndie Systemfähigkeit, stabil, kostengünstig und auf hohem Niveau kontinuierlich Token zu erzeugen— ein vollständiges System, das Systemeffizienz, Architekturinnovation und industrielle Lieferfähigkeit umfasst. Von der technischen Praxis bis zur Geschäftsumsetzung möchte SenseCore die Inferenz-Infrastruktur von einem erfahrungsbasierten Tuningprozess hin zueinem messbaren, optimierbaren und abnehmbaren Systemingenieurwesenentwickeln, damit die Investitionen in Rechenleistung letztlich in eine stabile Token-Service-Produktionskapazität umgesetzt werden.
Dieser Artikel wurde von SenseTime bereitgestellt; QbitAI hat ihn mit Genehmigung nachgedruckt. Die Meinungen liegen beim Originalautor.