
Numan ist ein britisches digitales Gesundheitsunternehmen, das Patienten dabei unterstützt, langfristige Erkrankungen im Bereich Gewicht, Hormone und sexuelle Gesundheit zu bewältigen. Viele unserer Patienten sind in einem Abnehmprogramm und nutzen das App die täglich, um ihre Fortschritte zu verfolgen.
Bei der Entwicklung von Nu, unserem AI-Health-Coach, war eine unserer Designherausforderungen, hochwertigen Gesundheitscoaching zu bieten, ohne die Grenzen der medizinischen Diagnose, Rezeptverordnung oder klinischer Entscheidungen zu überschreiten – all diese sind strenge Grenzen für Agenten in unserem stark regulierten medizinischen Bereich. Obwohl wir anfangs auf den Agenten und die damit verbundene Automatisierung konzentrierten, erwies sich die Qualität unserer Bewertungskriterien als am wichtigsten. Dies ist die Geschichte davon, wie wir unsere Bewertungskriterien entwickelt und verbessert haben, um hochwertige Benutzererlebnisse zu bieten, während wir die Bereiche, die von Regulierungen betroffen sind, ausblenden.
Wo die Standard-Eval-Methoden für Nu nicht ausreichen
Wir begannen dort, wo die meisten Teams beginnen – mit einem Datensatz an Eingaben und erwarteten Ausgaben sowie einem LLM-Judge, der jede Antwort bewertet. Obwohl diese Vorgehensweise für einen Q&A-Agenten gut funktioniert, ist Coaching eine Unterhaltung, keine Antwort. Jede Methode, die Nu’s Antwort im Voraus festlegte, scheiterte auf zwei Arten:
1. Einzige-Rotation-Tests auf statischen Prüfungen (eine feste Eingabe, eine feste erwartete Ausgabe und ein Richter, der eine Antwort allein bewertet). Verhaltenscoaching hat selten eine einzige richtige Antwort auf eine Anweisung, und ob eine Antwort sicher ist, hängt von dem darum entstehenden Gespräch ab. Nu muss verstehen, was den Patienten im Weg steht, bevor es Ratschläge gibt und die richtige Grenze einhält, wenn der Patient Druck ausübt.
Die Durchschnittswertung eines Scores für das gesamte Datenset zeigte, wo Nu versagt hatte. Ein paar schlechte Antworten verändern kaum die Zahl, sodass das Gespräch so aussieht, als wäre es in Ordnung, obwohl es nicht ist. Die Spieltermine verursachten auch ein weiteres Problem. Bei einer Ausgabe erwies sich eine Gruppe niedriger Scores als Fehler der Evaluierung, nicht von Nu. Die Bewertungskriterien erwarteten Empathie und Exploration. und Tipps werden alle in einem zweigeteilten Austausch gegeben, während ein menschlicher Trainer diese im Laufe einer Unterhaltung vermittelt. Nu war eine ordentliche Betreuung, aber die enge, feste Bewertung signalisierte Fehler falsch.
2. Skriptierte mehrmalige Gespräche. Die offensichtliche Lösung für einzelne Gespräche ist, die erwarteten Antworten des Patienten im Voraus festzulegen. Mit diesem „Skript“ ermöglicht es dem Richter, am Ende die gesamte Aufzeichnung zu bewerten, indem er mehrere Gesprächsszenen nacheinander durchgeht. Obwohl dies dem Richter mehr Freiheit gibt als eine einzelne Antwort, zerfällt die Bewertung genauso. Wenn die zweite Antwort des Patienten im Voraus festgelegt ist, ignoriert der Test das, was Nu in der ersten Runde tatsächlich gesagt hat. Sobald Nu etwas sagt, was nicht im Skript vorgesehen war, ist jede spätere Antwort eine Antwort auf ein Gespräch, das nie stattgefunden hat.
Diese 2 Fehlermodi haben alles geprägt, was wir danach gebaut haben.
Das eval-Framework, das wir heute verwenden
Nu ist ein LangGraph-Graphen. Ein Supervisor-Modell orchestriert die Handoffs zu sub-Agenten, die sich auf bestimmte Trainingsbereiche konzentrieren und jeweils ihre eigenen Anleitungen und Werkzeuge verwenden. Dieses Kompositionsterminom macht die Hinzufügung neuer Spezialisten kostengünstig und, was noch wichtiger ist, erhält die Bewertungsebene bei allen gleichmäßig.
Einige der Dinge, die Nu richtig machen muss ist, sind mit einer einzigen Antwort entscheidbar. Zum Beispiel, ob der Supervisor den richtigen Spezialisten gerufen hat, ob eine Medikamentenfrage eine sichere Antwort erhielt oder ob der Sicherheitswächter das erhaltene Ergebnis korrekt festnahm. Für diese Aufgaben verwenden wir thematische Datensätze, die sich auf die Trainingsqualität, Sicherheit, Medikamentenanfragen, Routing und Zusammenfassung beziehen. Im Gegensatz zu unseren ursprünglichen Einzelantworttests haben wir zwei Dinge verändert: 1) Jeder Datensatz wird von einem LLM-Judge nach Kategorien bewertet, anstatt durch eine einzige Durchschnittsbewertung, sodass Cluster von Fehlern in einer Kategorie auch dann sichtbar bleiben, wenn die anderen Bereiche gesund erscheinen. 2) Jede Bewertungskriteriumliste fragt nur nach dem, was eine einzige Antwort zeigen kann, sodass der Judge Nu nicht mehr wegen des Verhaltens während des Gesprächs bestraft, wie es ein Trainer tun würde.
Alles, was ein Fixier nicht abdecken kann – also das, was die Form einer ganzen Konversation erfordert – bekommt eine eigene Schicht, die unten beschrieben wird. Da Nu ein Graph ist, kann eine Eval-Operation das gesamte System oder einen einzelnen Sub-Agenten zielgenau ansprechen, und ein neuer Spezialist erbt die Eval-Oberfläche.
„Das, was wir liefern, ist das, was wir testen.“
Die einfache Methode zur Erstellung einer Eval ist die Verwendung eines separaten Harnesses, der den Prompt des Agents kopiert und das Modell direkt aufruft… was funktioniert, bis der Harness und die Produktion abweichen. Wir verwenden keinen separaten Harness und arbeiten nach dem Prinzip das, was wir versenden, ist auch das, was wir testen. Jede Eval durchläuft denselben LangGraph-Graphen, mit dem ein Patient spricht, sodass das, was wir bewerten, das ist, was der Patient erlebt.
Während wir die Skalierung durchführten, begannen wir zu überprüfen, ob ein einziger Anbieter für jeden Agent geeignet war, da der Supervisor und die Domänenspezialisten unterschiedliche kognitive Aufgaben haben. Heute läuft Nu auf zwei Grenzanbietern – jeweils für den Supervisor und für die Spezialisten. Dank der Portabilität unserer Evaluations-Suite, die aus offenen, thematischen Datensätzen besteht, können wir jede Konfiguration verwenden. Wir haben die gleichen Datensätze bei verschiedenen Anbietern verwendet und die Ergebnisse nebeneinander betrachtet. Die Migration zwischen den Grenzdienstanbietern – normalerweise mehrere Wochen manueller Tests – dauerte nur einen Tag.
Verhaltenstests zur Aufrechterhaltung der regulatorischen Grenzen
Unter der Leitung der MHRA wird ein Softwarebasiertes Produkt mit medizinischem Zweck (z. B. Bereitstellung von klinischen Ratschlägen, Diagnose oder Empfehlung von Behandlungen) zu einem medizinischen Gerät. Nu wurde als Wellnessprodukt für Lifestyle-Coaching und Bildung konzipiert, nicht für klinische Versorgung.
Das Halten von Nu innerhalb dieses Bereichs ist etwas, das wir bei jeder Änderung überprüfen. Die Sicherheitsprüfungen werden nach Kategorie-Metriken und Gate-Veröffentlichungen durchgeführt: eine Abweichung dort blockiert die Veröffentlichung automatisch. Wir richten uns nach safe-completion, einer Umleitung, die die Verbindung aufrechterhält, während sie dennoch wie ein Trainer klingt – so erhält ein Patient, der etwas außerhalb des Bereichs fragt, eine warme, nützliche Antwort, anstatt eine abrupte Ablehnung.
Abgesehen von der Tests werden die Sicherheitsknoten in jeder Konversation im Graphen ausgeführt. Ein Sicherheitsbeobachter überprüft jedes Ausgangsantwort gegen ein festes Set klinischer Sicherheitsregeln, bevor der Patient es sieht. Ein unsicheres Entwurf wird zurück an den Supervisor gesendet, um neu erstellt zu werden. Wenn es weiterhin fehlschlägt, wird die Nachricht durch eine sichere Alternative ersetzt, anstatt das unsichere Antworten zu übermitteln. Und da die Wächter im Graphen sitzen, befinden sie sich auf derselben Evaluationsfläche – wo eines unserer thematisierten Datensätze speziell dazu dient, zu überprüfen, ob der Sicherheitswächter das richtige erfasst. Darüber hinaus prüfen Gesundheitscoaches täglich eine Auswahl von echten Gesprächen und markieren alles, was wie ein Sicherheitsfehler aussieht, damit die menschlichen Experten bestimmen können, was als sicher gilt.
Konversationen simulieren anstatt sie zu Skripten zu machen
Unsere neueste Schicht, die heute im Prototyp vorliegt, simuliert den Dialog anstatt ihn zu skripten. Wir geben dem eval eine Patientenpersönlichkeit, ein Szenario, die wichtigsten Probleme, die Nu identifizieren soll, sowie eine Turnbegrenzung. Ein kostengünstigeres Modell spielt die Patientin und führt einen mehrstufigen Dialog mit dem echten Agenten ein, der auf alles reagiert, was Nu sagt. Anschließend bewertet ein Richter den gesamten Transkript nach Kategorien. Da der Patient eher generiert als fest ist, können wir gegenüberstehende Fälle untersuchen (Formulierungen, die dazu dienen, eine klinische Anfrage vor dem Trainer durchzulassen, Manipulationen, die als normale Fragen getarnt sind), und Fehler erkennen, die ein Standardfall nie erlebt. Zum Beispiel: Nu, der sofort eine Antwort gibt, anstatt den richtigen Weg des Trainers zu untersuchen.
Diese Art der Prompt-Härtung durch simulierte Gespräche reduzierte ernsthafte Überschreitungen der Regelungsgrenzen in Jailbreak-Szenarien. Wir führten parallele Medikamenten-Fragen-Tests als Regressionsgate durch, sodass die Verbesserungen des Prompts das Verhalten nicht beeinflussten, auf das wir bereits vertrauten.
Die Verwendung der simulierten Konversationsebene zur kontinuierlichen Verbesserung ohne die Einführung von Regressen ist eher ein Problem der Bewertungskriterien als ein technisches Problem. Als wir zuerst die Kriterien für diese Ebene entwarfen, erwiesen sich zwei Themen, die wir als kompatibel hielten, als widersprüchlich: Eines besagte Abfluss und Anweisung an den Arzt, das andere sicheres Abschlussverfahren mit allgemeinen Informationen aus dem Patienteninformationheft. Ein einzelnes Prompt kann beides nicht erfüllen. Dieses Beispiel eines Promptkonflikts lehrte uns, dass das knappe, wertvolle Gut nicht das Prompt ist, das ein fähiges Modell aus begrenztem Kontext gut erstellt; es sind die Bewertungskriterien. Und an einer regulierten Grenze müssen diese Kriterien von einem Arzt verfasst und genehmigt werden, der auch die regulatorischen Vorgaben kennt – nicht von einem Ingenieur. Die Ergebnisse der simulierten Konversationen von Nu werden gegen die von den Ingenieuren entworfenen Kriterien bewertet, weshalb diese Ebene keine Veröffentlichung oder Information über Sicherheitsaspekte vornimmt, bis der Arzt die Bewertungskriterien genehmigt hat (was dazu führt, dass das Produkt auf der Seite des „Wohlbefindens“ bleibt).
Die Stack: LangGraph und LangSmith
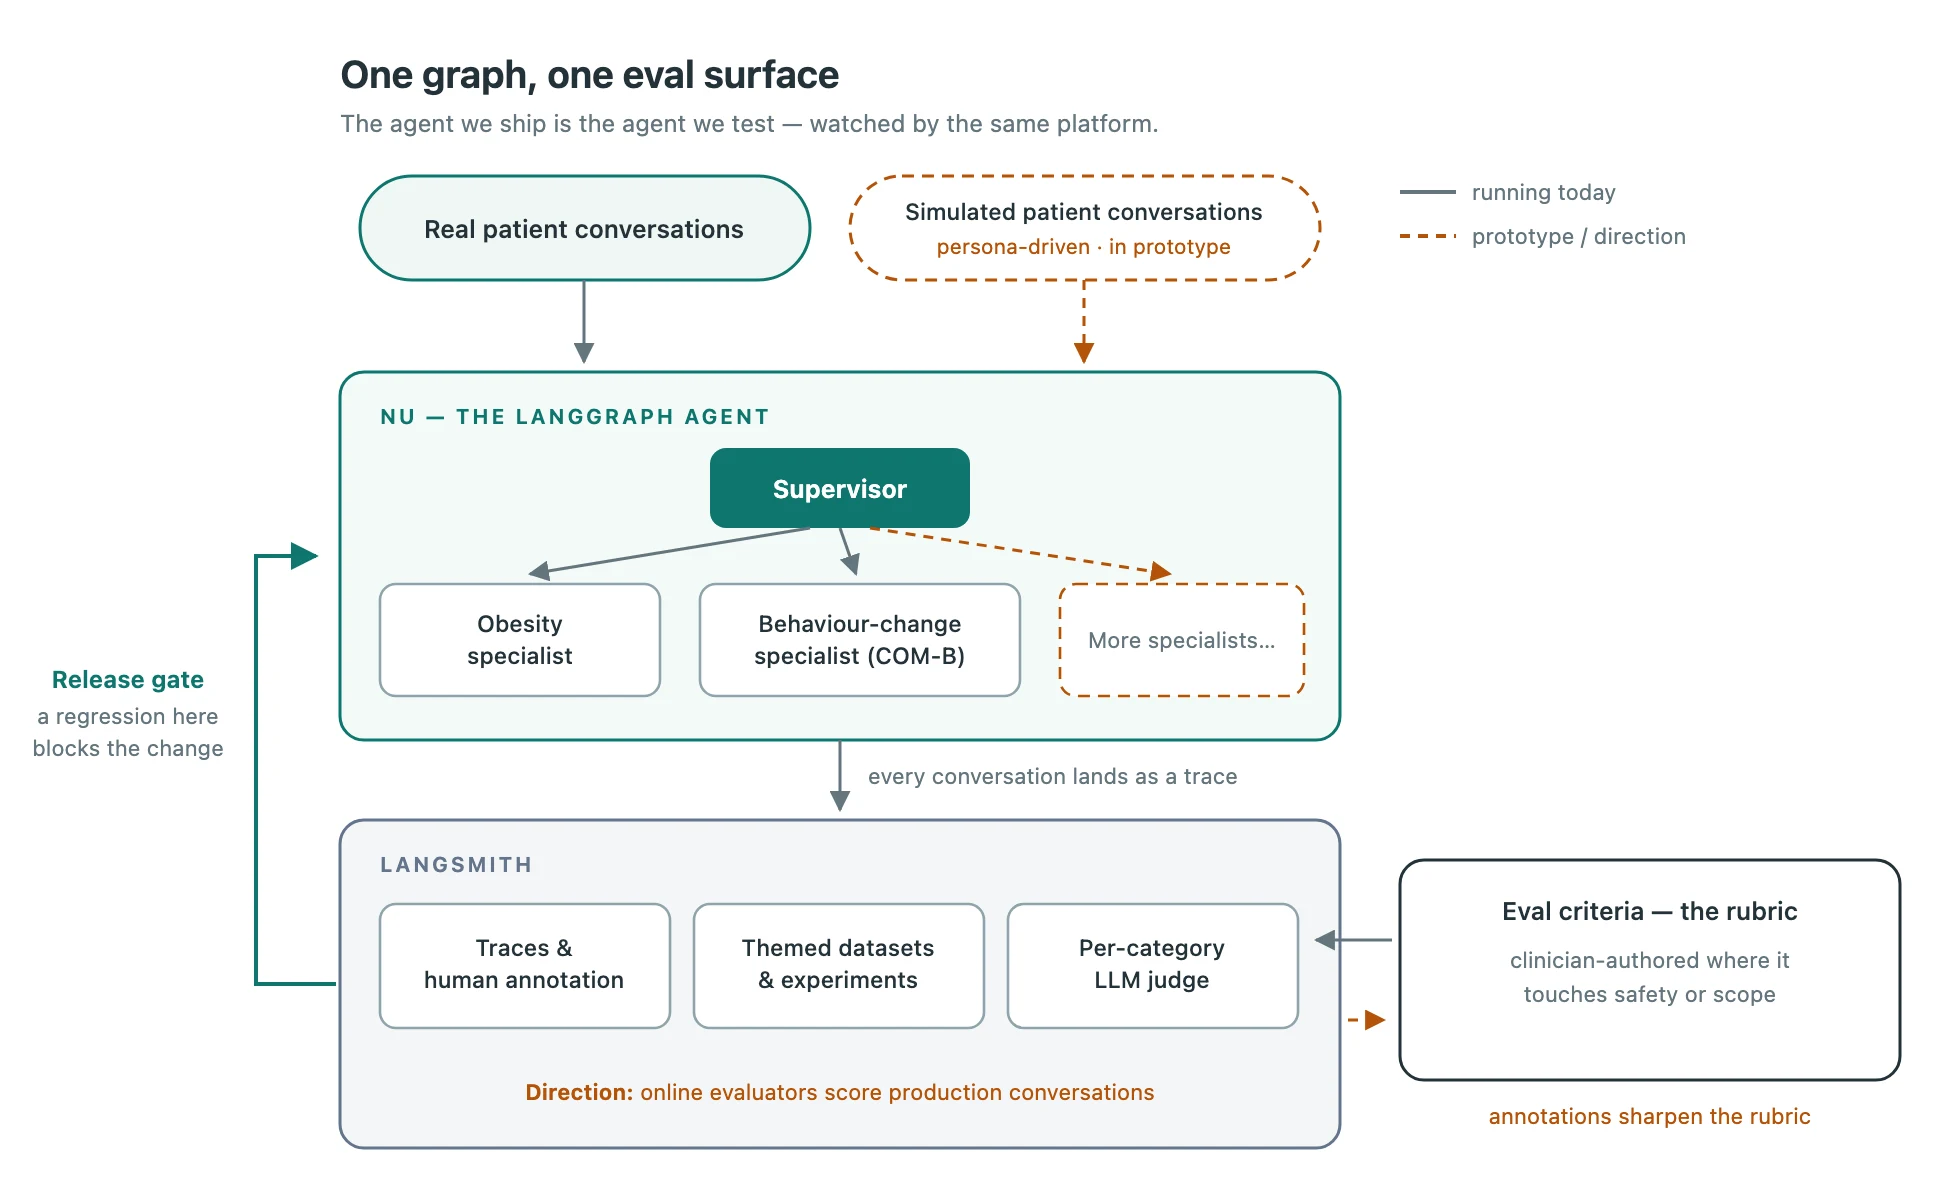
LangGraph und LangSmith fungieren zusammen als ein System, das unsere Agententwicklungsstack bildet.
LangGraph ist der Agent. Ein Supervisor aktiviert Domain-Spezialisten, jeder mit seinem eigenen Prompt und Tools.
Die Evaluierungen werden über denselben Graphen durchgeführt. Sowohl die simulierte Konversationseval-Schicht als auch die Festlegungsschicht treffen auf den echten Agenten und können das gesamte System oder einzelne Sub-Agenten zielgenau beeinflussen.
LangSmith ist der Ort, an dem alles gemessen wird. Jede Konversation, egal ob simuliert oder real, wird als Spur festgehalten. Rezensenten annotieren diese Spuren und starten so den kontinuierlichen Prozess der Qualitätsoptimierung. Datensätze und Experimente befinden sich ebenfalls dort. Zum Beispiel wurde die Vergleichstabelle zwischen den Anbietern hinter unserer einstündigen Migration direkt aus LangSmith gelesen.
Die Integration zwischen LangGraph und LangSmith macht die Auswertung kostengünstig. Es gibt keine Zusammenschnitt-Code, der drei unabhängige Tools miteinander verbindet. Das, was wir liefern, und das, was wir testen, ist derselbe Graph, der von derselben Plattform überwacht wird.
Wohin wir unterwegs sind: Die Kriterien zu skalieren, nicht nur den Agenten
Die Qualität des Coaching hängt von 1) den Kriterien ab, die entscheiden, ob eine Konversation gut war, und 2) von der Ausweitung des Bereichs, gegen das diese Kriterien getestet werden. Deshalb konzentrieren wir uns darauf, mehr antagonistische Personen und Szenarien zu testen, mehr Themen hinzuzufügen, während wir mehr Spezialisten aufbauen, und die Rubrik „Kliniker im Loop“ auszuweiten, wo sie auch die Sicherheit oder den Umfang betrifft. Die Überprüfer lesen weiterhin echte Konversationen in LangSmith, und ein Ingenieur überprüft immer noch jede Anpassung des Prompts.
Alles, was bisher beschrieben wurde, ist offline – das zeigt, dass eine Änderung die regulatorischen Vorgaben vor dem Veröffentlichungsprozess einhält. Der nächste Schritt sind Online-Bewertungsinstrumente, die die gleichen Kriterien kontinuierlich gegen echte Gespräche anwenden, sobald diese in LangSmith eintreffen, und dabei die Seite von Nu im Gespräch bewerten. Anstatt der täglichen Bewertung durch Trainer wird die menschliche Bewertung nun von den Gesprächen ausgehen, die bereits von einem Bewertungsinstrument markiert wurden – um zu überprüfen, ob die Grenzen in der Produktion gewahrt bleiben und die Kriterien bei falschen Alarmen verbessert werden können.
Wir sehen auch ermutigende Ergebnisse aus den frühen Experimenten, die die Automatisierung der Arbeitsabläufe ermöglichen, die nach einem vertrauenswürdigen Kriterienkatalog erfolgen – einschließlich der Klassifizierung geprüfter Gespräche in eine geordnete Liste und der Anpassung eines Prompts an einen festen Benchmark. Kürzlich zeigte ein offline Prompt-Optimierungssystem, dass ein einzelnes Verhaltenskriterium die Punktzahl erheblich verbesserte, ohne weitere manuelle Anpassungen… was unserer Hypothese zugutekommt, dass, wenn die Kriterien richtig eingehalten werden, der Rest automatisch möglich ist.
Ein AI-Coach entwickeln nahe einer Regulierungslinie
Wenn Sie einen Konversationseigner in der Nähe einer Regulierungslinie entwickeln, sind hier unsere Empfehlungen:
- Ein festes Datenset kann keine gesamte Konversation abdecken. Halten Sie feste Werte für das, was eine einzelne Antwort zeigen kann, simulieren Sie die Konversationen für den Rest und bewerten Sie nach Kategorie – anstatt auf eine Gesamtzahl zu hoffen.
- Machen Sie die Grenze zu einer Prüfung. Führen Sie sie bei jeder Änderung durch, lassen Sie eine Regression den Release verhindern und richten Sie denselben Maßstab auf die Produktion aus.
- Auf einer regulierten Grenze gehört das Kriterium dem Arzt. Die von der Ingenieursabteilung entwickelten Kriterien reichen aus, um ein System zu betreiben; sie reichen jedoch nicht aus, um einen Sicherheitsanspruch zu bestätigen.
- Setzen Sie den größten Teil Ihrer Anstrengungen in die Evaluationskriterien. Alles darunter folgt aus den Evaluationskriterien: eine bessere Betreuung, eine verlässliche Grenze und schließlich Automatisierung, der man vertrauen kann.
Wir werden wieder als Kriterien und mit der Reifung der Automatisierung schreiben.
Nu basiert auf LangGraph und LangSmith. Das AI-System von Numan verarbeitet Gesundheitscoaching-Dialoge in verschiedenen Gesundheitsbereichen. Nu ist als Wellnessprodukt konzipiert und nicht als medizinisches Gerät. Es bietet Coaching und Gesundheitsbildung und diagnostiziert, verschreibt, überwacht Krankheiten oder trifft klinische Entscheidungen nicht.