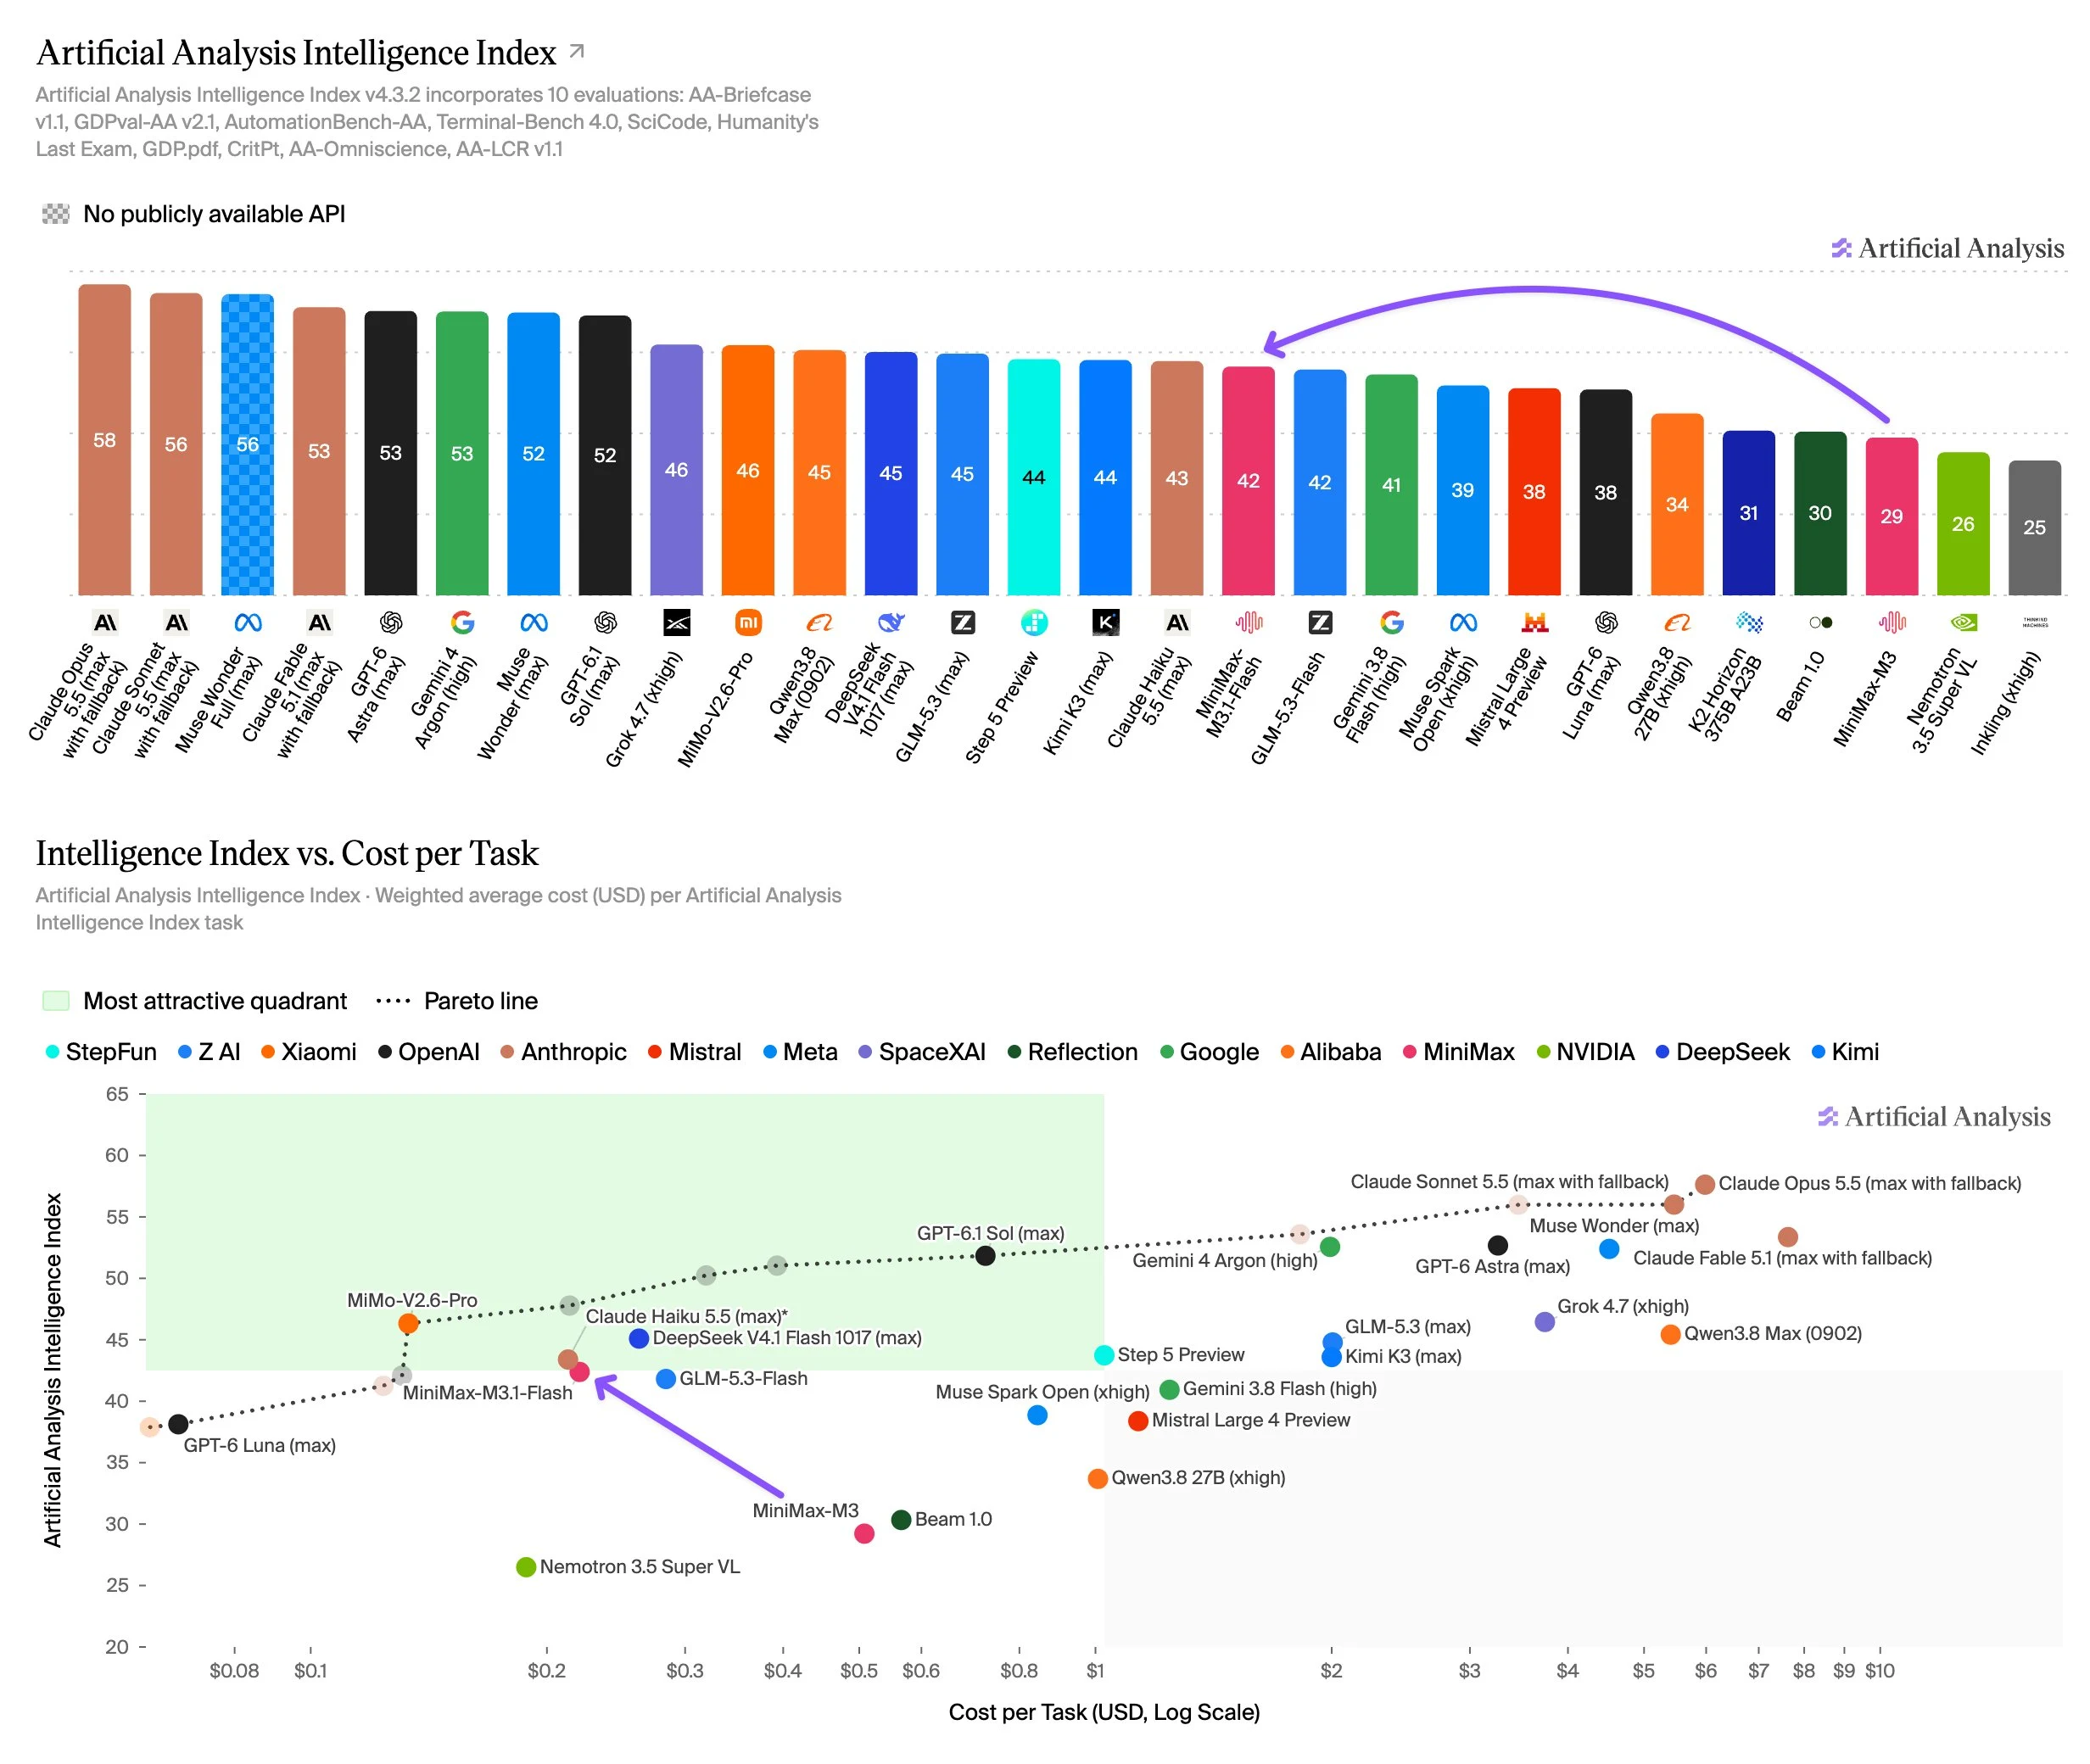
MiniMax-M3.1-Flash erreicht 42 Punkte auf dem Artificial Analysis Intelligence Index, 13 Punkte mehr als MiniMax-M3 und weniger als die Hälfte der Kosten pro Aufgabe. Damit liegt es auf dem Niveau von GLM-5.3-Flash, aber hinter DeepSeek V4.1 Flash 1017
MiniMax-M3.1-Flash ist @MiniMax_AI's neues Flash-Reasoning-Modell, das wir mit seiner maximalen Effort-Einstellung benchmarkt haben. Es erreicht 42 Punkte auf dem Artificial Analysis Intelligence Index, auf dem Niveau von GLM-5.3-Flash (max, 42), knapp vor Gemini 3.8 Flash (high, 41) und hinter DeepSeek V4.1 Flash 1017 (max, 45)
Die wichtigsten Erkenntnisse:
➤ Komplexes Reasoning hat sich gegenüber M3 deutlich verbessert: MiniMax-M3.1-Flash erreicht 48% bei Humanity's Last Exam, vor GLM-5.3-Flash (max, 40%) und DeepSeek V4.1 Flash 1017 (max, 43%) und auf dem Niveau von Gemini 3.8 Flash (high, 48%). Bei CritPt erreicht es 22%, vor GLM-5.3-Flash (15%) und Gemini 3.8 Flash (18%) und knapp hinter DeepSeek V4.1 Flash 1017 (24%). Dies ist eine Steigerung gegenüber MiniMax-M3, das 39% bzw. 4% erzielte
➤ Weniger Output-Tokens, geringere Kosten pro Aufgabe: MiniMax-M3.1-Flash verwendete ~189M Output-Tokens für den Intelligence Index, deutlich weniger als GLM-5.3-Flash (max, ~324M), DeepSeek V4.1 Flash 1017 (max, ~224M) und Gemini 3.8 Flash (high, ~334M). In Kombination mit einem Preis von $0.15/$0.60 pro 1M Input-/Output-Tokens ergeben sich Kosten von ~$0.22 pro Intelligence-Index-Aufgabe, gegenüber ~$0.28 für GLM-5.3-Flash, ~$0.26 für DeepSeek V4.1 Flash 1017 und ~$1.24 für Gemini 3.8 Flash, und weniger als die Hälfte von MiniMax-M3's ~$0.51
➤ Hohe AA-Omniscience-Genauigkeit, ausgeglichen durch eine hohe Halluzinationsrate: MiniMax-M3.1-Flash beantwortet 56% der Fragen korrekt bei AA-Omniscience, unserem Benchmark für Faktenwissen und Halluzinationen, gegenüber 28% für GLM-5.3-Flash (max) und 43% für DeepSeek V4.1 Flash 1017 (max). Es versucht fast jede Frage zu beantworten, was zu einer Halluzinationsrate von 93% und einem Gesamtergebnis von 16 bei AA-Omniscience führt
Wichtige Modelldetails:
➤ Kontextfenster: 1M Tokens
➤ Multimodalität: Text- und Bildeingabe, Textausgabe
➤ Preise: $0.15/$0.60 pro 1M Input-/Output-Tokens, mit zwischengespeichertem Input zu $0.015/M
➤ Verfügbarkeit: MiniMax-First-Party-API, wobei MiniMax eine Open-Weights-Veröffentlichung für den 23. Oktober angekündigt hat
➤ Lizenzierung: Derzeit geschlossene Gewichte, wobei MiniMax eine Gewichtsveröffentlichung für den 23. Oktober angekündigt hat