
vLLM ist eine Open-Source-Inferenz- und Serving-Engine für große Sprachmodelle (LLMs). Die LLM-Inferenz besteht aus zwei unterschiedlichen Phasen: Prefill, das den Eingabeprompt verarbeitet und den Key-Value-Cache (KV-Cache) aufbaut, und Decode, das diesen Cache verwendet, um die Ausgabe Token für Token zu erzeugen. Diese Phasen haben unterschiedliche Compute-, Speicher- und Skalierungseigenschaften. Prefill-Decodier-Disaggregation (P-D) führt diese Phasen auf separaten Engine-Instanzen aus, sodass jede Phase unabhängig skaliert und optimiert werden kann. Dies kann die Ressourcenauslastung, den Durchsatz und die Latenz unter Last verbessern. Allerdings erfordert es auch, den KV-Cache von der Prefill-Instanz auf die Decode-Instanz zu übertragen, bevor die Token-Generierung beginnen kann, wodurch eine effiziente KV-Übertragung entscheidend für die Time-to-First-Token (TTFT) ist.
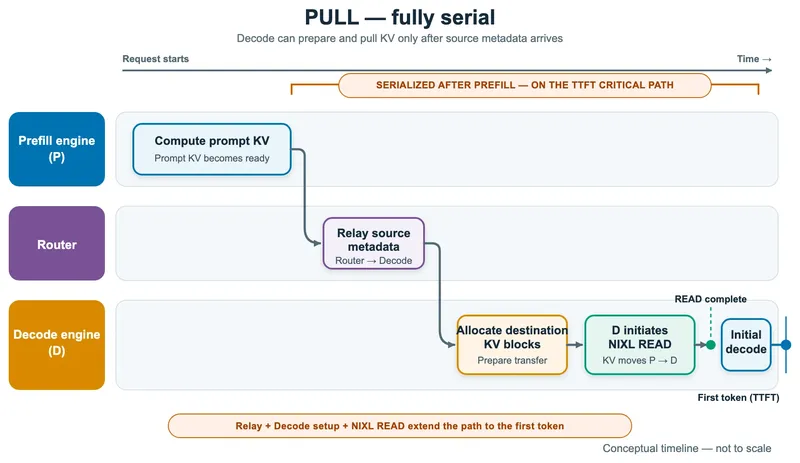
Eine der Möglichkeiten, wie vLLM diese Übertragung durchführt, ist über den NVIDIA Inference Xfer Library (NIXL) Connector, der KV-Blöcke über Interconnects überträgt, die Remote Direct Memory Access (RDMA) unterstützen, wie z. B. den AWS Elastic Fabric Adapter (AWS EFA, das RDMA-Netzwerk mit niedriger Latenz, das serverübergreifend in AWS eingesetzt wird). Auf unterstützten Instanztypenunterstützt AWS EFA GPUDirect RDMA und Neuron Direct RDMA. NIXL kann daher KV-Blöcke direkt zwischen GPU- oder AWS Trainium -Gerätespeicher übertragen, ohne den Umweg über den Hostspeicher. Der Standardmodus für den NIXL-Connector ist pull-basiert: Nachdem die Prefill-Instanz die Berechnung des Prompt-KV-Caches abgeschlossen hat, leitet der Router die Quellmetadaten, einschließlich der Prefill-Block-IDs, an die Decode-Instanz weiter. Die Decode-Instanz reserviert dann Zielblöcke, bereitet die NIXL-Übertragung vor und initiiert NIXL READ, um die KV-Blöcke von der Prefill-Instanz zu ziehen. Da diese Koordinations- und Einrichtungsschritte sequenziell nach dem Prefill und vor Beginn der Decodierung erfolgen, verlängern sie den kritischen TTFT-Pfad, wie in der folgenden Zeitleiste dargestellt.
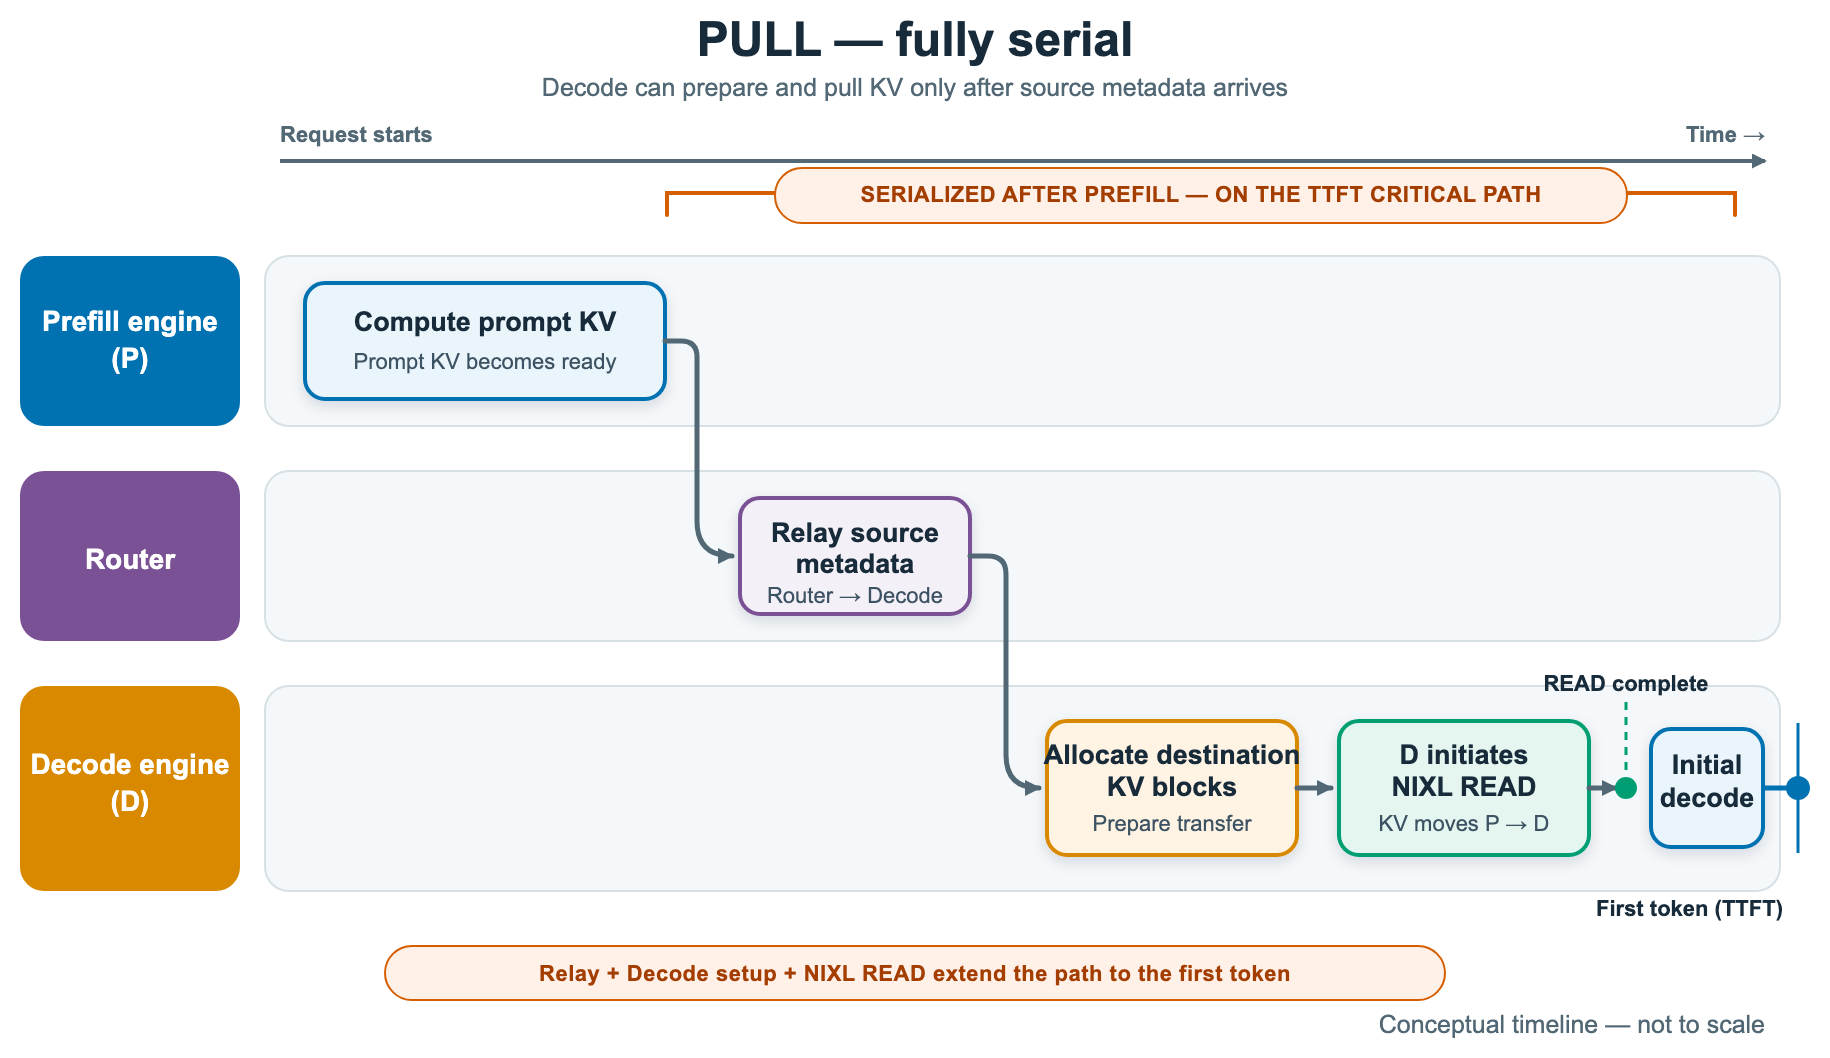
Abbildung 1: Zeitleiste der KV-Übertragung im Pull-Modus, bei der die Router-Weiterleitung, die Zuweisung auf der Decode-Seite und NIXL READ seriell auf dem Pfad zum ersten Token ausgeführt werden
Dieser Beitrag stellt einen push-basierten NIXL-Connector vor, der die Übertragungskoordination und -einrichtung nach dem Prefill vom kritischen Pfad verlagert. Wenn Sie disaggregierte Prefill/Decode-Inferenz mit vLLM betreiben, kann der Push-Modus die Anwendungsreaktionsfähigkeit verbessern, indem TTFT und TPOT reduziert werden, insbesondere bei hohen Anforderungsraten.
In unserem Benchmark auf einer 1P1D-Bereitstellung mit Amazon Elastic Compute Cloud (Amazon EC2) P5en-Instanzen, die über EFA verbunden sind, lieferte der Push-Modus für das Modell Qwen3-32B ein bis zu 3x besseres TTFT und ein bis zu 30 Prozent besseres Time-per-Output-Token (TPOT) im Vergleich zum Pull-Modus (siehe Abschnitt Performance data). Die Ergebnisse hängen von Arbeitslast und Konfiguration ab.
Wir haben die Funktion auf AWS Trainium-Instanzclustern mit EFA entwickelt und validiert und dann als accelerator-agnostische Funktion zu vLLM beigetragen. Die hier gezeigten Ergebnisse stammen aus einem Amazon EC2 P5en (GPU)-Cluster mit EFA und zeigen, dass die Gewinne auf GPUs übertragbar sind. Dieser Beitrag erläutert die push-basierte Architektur, den Übertragungsfluss, das Threading-Modell, die Leistungsergebnisse und wie man den Benchmark reproduziert.
Push-basierte KV-Übertragung
Dieser Abschnitt erläutert das push-basierte Design: seine Architektur, das Übertragungsprotokoll und das Threading-Modell, das die KV-Übertragung vom kritischen Pfad fernhält.
Architekturübersicht
Die push-basierte Übertragung verbessert TTFT und Decode-Durchsatz aus zwei Gründen:
- Sie beseitigt die Serialisierung des Pull-Modells durch die Überlappung von Producer- und Consumer-Arbeit. Die Decode-Instanz registriert ihre Zielblöcke im Voraus, während der Producer noch KV berechnet. Die Übertragung beginnt dann, sobald die Blöcke des Producers bereit sind, statt nach einem ID-Discovery-Roundtrip auf der Consumer-Seite, wodurch dieser Roundtrip vom Pfad zum ersten Token entfernt wird.
- Sie verlagert die Einrichtungszeit der Übertragung von der Decode-Instanz weg. Diese Einrichtung läuft auf der Prefill-Seite und in einem Hintergrund-Thread. Sie bereitet die NIXL-Deskriptoren vor und sendet die Übertragung, sodass die Decode-Instanz diese Zyklen nicht während ihrer latenzkritischen Token-Generierungsphase verbraucht.
Der Nettoeffekt sind eine niedrigere TTFT und ein höherer Durchsatz bei Ausgabe-Tokens auf der Decode-Instanz.
Der Push-Connector koordiniert drei Akteure: Die Decode-Instanz registriert ihre Zielblöcke im Voraus, die Prefill-Instanz ordnet jede Anfrage zu und stößt die Übertragung an, und ein dedizierter Hintergrundthread verlagert den KV-Schreibvorgang aus der Forward-Pass-Schleife der Engine. Das folgende Diagramm zeigt, wie diese Bausteine zusammenspielen.
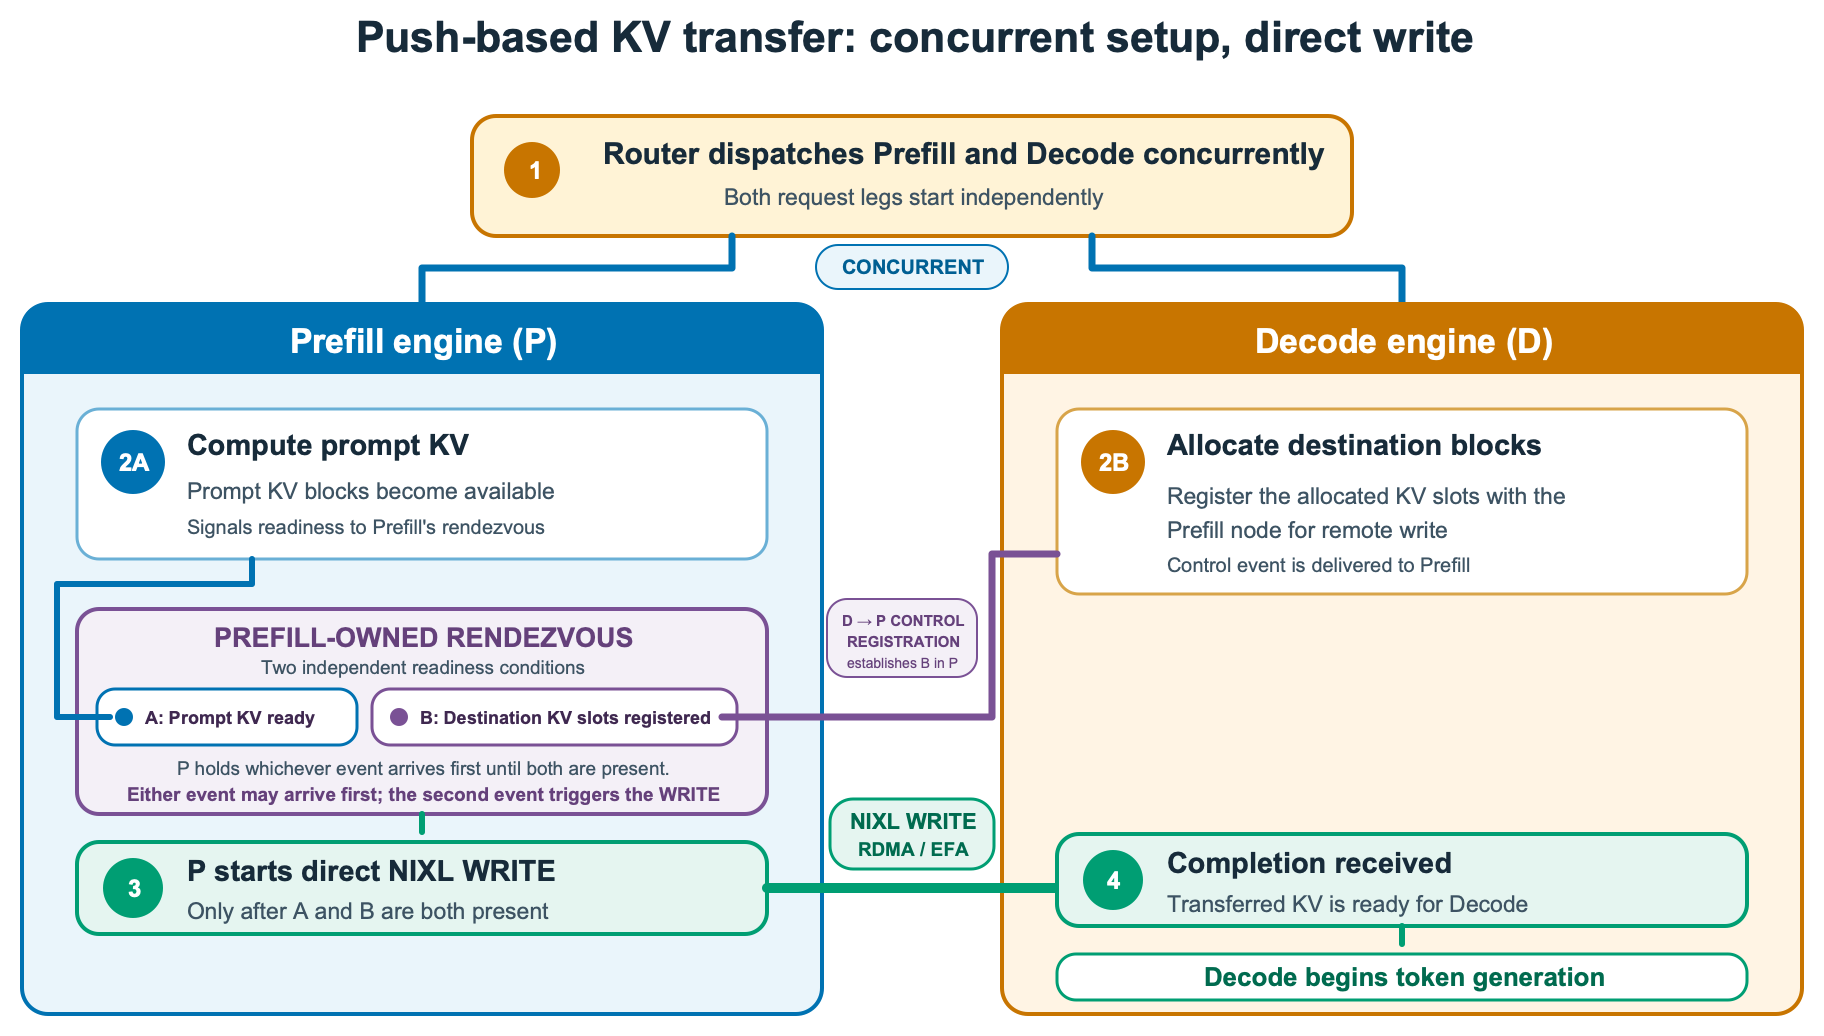
Abbildung 2: Push-basierte KV-Transfer-Architektur, die zeigt, wie die Decode-Instanz, die Prefill-Instanz und der Hintergrund-Übertragungsthread koordinieren
Implementierungsdetails
Das Protokoll hat drei logische Schritte.
1. Registrierung (Decode-Seite). Wenn die Decode-Instanz lokale Blöcke für eine Anfrage zuweist, die ein Remote-Prefilling erfordert, bereitet sie eine Registrierung vor, die beschreibt, wohin die Prefill-Instanz das KV schreiben soll: ihre eigene Identität und die Blockpositionen, die sie gerade reserviert hat. Innerhalb desselben Engine-Schritts überträgt der Worker diese Registrierung als NIXL-Benachrichtigung an die Prefill-Instanz. Da die Registrierung zum Zeitpunkt der Allokation erfolgt, kennt der Connector die Zielblöcke, bevor die Prefill-Instanz das Prefilling abgeschlossen hat.
2. Rendezvous (Prefill-Seite). Die Registrierung vom Decoder und der Abschluss des Prefillings auf der Producer-Seite können in beliebiger Reihenfolge eintreffen, und der Connector behandelt beide Fälle. Trifft die Registrierung zuerst ein, hält der Producer sie zurück, bis sein eigenes Prefilling abgeschlossen ist. Ist das Prefilling zuerst fertig, hält der Producer die Blöcke der Anfrage zurück, bis die Registrierung eintrifft. Welches Ereignis auch immer als zweites eintritt, löst die Übertragung aus. Der Connector ordnet Anfragen anhand der ID zu, und die Zuordnung berücksichtigt erneut gesendete Anfragen und ordnet verdrängte oder wiederholte Anfragen korrekt zu.
3. Übertragung (Prefill-Seite). Sobald eine Anfrage zugeordnet ist, baut der Producer eine Verbindung zur Decode-Instanz auf (sofern noch keine existiert) und führt einen NIXL WRITE aus, der die KV-Blöcke direkt in den registrierten Speicher des Decoders kopiert, wobei jeder Ziel-Tensor-Parallel-Rank adressiert wird. Producer und Consumer können unterschiedliche interne Blocklayouts verwenden. Jede Seite bildet die Blockpositionen zum Zeitpunkt der Übertragung auf ihr eigenes physisches Layout ab, was unterschiedliche Blockgrößen auf jeder Seite erlaubt. Jeder WRITE trägt eine Abschlussbenachrichtigung, die NIXL der Decode-Instanz zustellt, sobald die Daten angekommen sind. Der Decoder zählt diese Benachrichtigungen, eine pro Producer-Rank, der in ihn schreibt. Er betrachtet das KV erst als empfangen, wenn alle erwarteten Benachrichtigungen eingegangen sind; zu diesem Zeitpunkt geht die Anfrage zur Dekodierung über.
Threading-Modell
Der Push-Connector trennt die Modellausführung von der Vorbereitung der KV-Übertragung, indem er auf jedem Prefill-Worker einen dedizierten Hintergrund-Übertragungsthread verwendet. Zu Beginn einer Anfrage allokiert die Decode-Hauptschleife ihre Ziel-KV-Blöcke und registriert sie bei der Prefill-Instanz, während die Prefill-Hauptschleife den Prompt-KV-Cache berechnet. Sobald sowohl die Zielregistrierung als auch der Prompt-KV bereit sind, übergibt die Prefill-Hauptschleife die KV-Blöcke an den Hintergrundthread und kehrt schnell zur Modellausführung zurück.
Der Hintergrundthread baut die NIXL-Verbindung auf oder verwendet sie wieder, bildet die KV-Block-IDs der Anfrage auf Speicherdeskriptoren ab, fasst zusammenhängende Blöcke zu größeren Übertragungsregionen zusammen und sendet den NIXL WRITE an die Decode-Instanz. Wenn NIXL die Übertragung abschließt, sendet es eine Abschlussbenachrichtigung an die Decode-Instanz, die daraufhin mit der Token-Generierung beginnt. Die Vorbereitung der Deskriptoren und das Absenden der Übertragung außerhalb der latenzkritischen Hauptschleifen zu halten, verhindert, dass diese arbeitsintensive Pro-Anfrage-Aufgabe die Modellausführung verzögert. Das folgende Diagramm zeigt diese Übergaben zwischen Hauptschleife und Hintergrundthread für eine einzelne Anfrage.
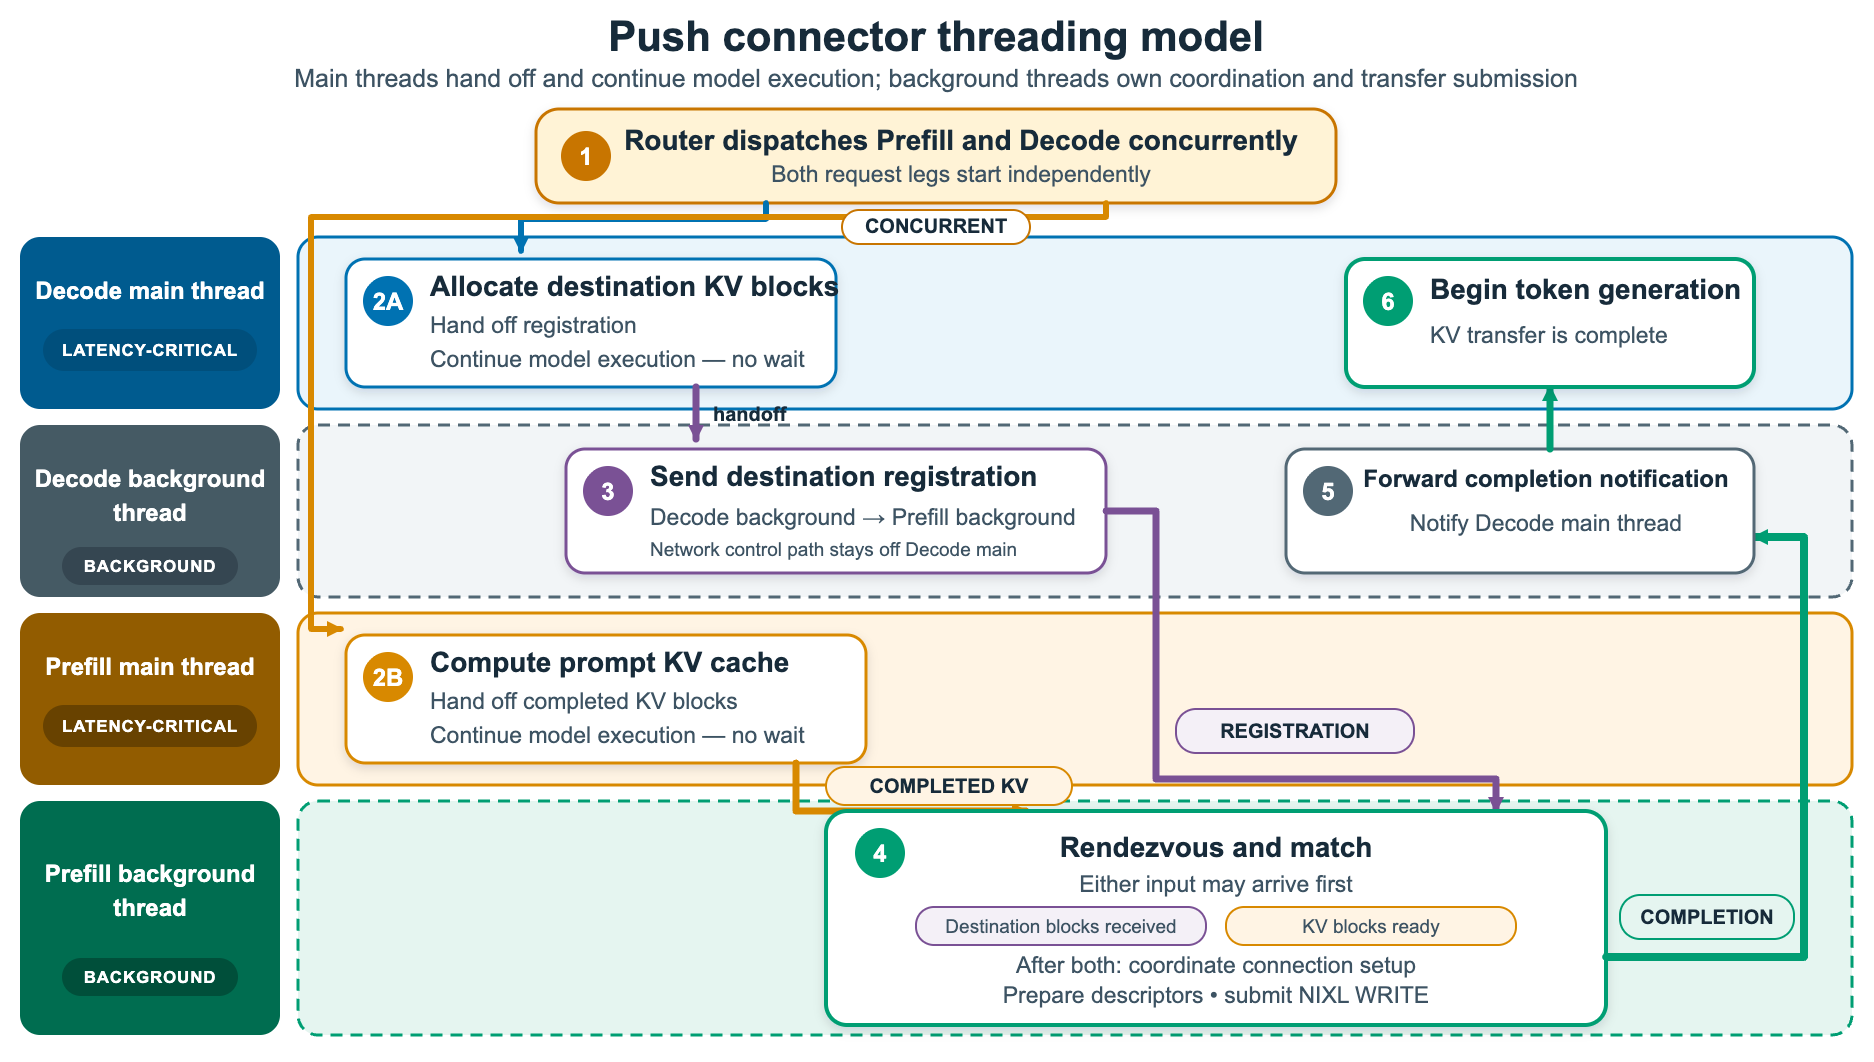
Abbildung 3: Übergaben zwischen Hauptschleife und Hintergrundthread für eine einzelne Anfrage im push-basierten Threading-Modell
Zeitvergleich von Pull und Push
Das folgende Diagramm fasst die in den vorangegangenen Abschnitten beschriebenen Pull- und Push-Übertragungsabläufe zusammen und hebt deren Auswirkung auf die TTFT hervor. Obwohl beide Modi denselben NIXL- und EFA/RDMA-Datenpfad verwenden, führt Pull die Metadaten-Weiterleitung und das Decode-seitige Setup nach dem Prefilling durch, während Push das Decode-seitige Setup mit dem Prefilling überlappt. Dadurch entfernt Push diese Operationen aus dem kritischen Pfad nach dem Prefilling, sodass die Dekodierung früher beginnen kann.
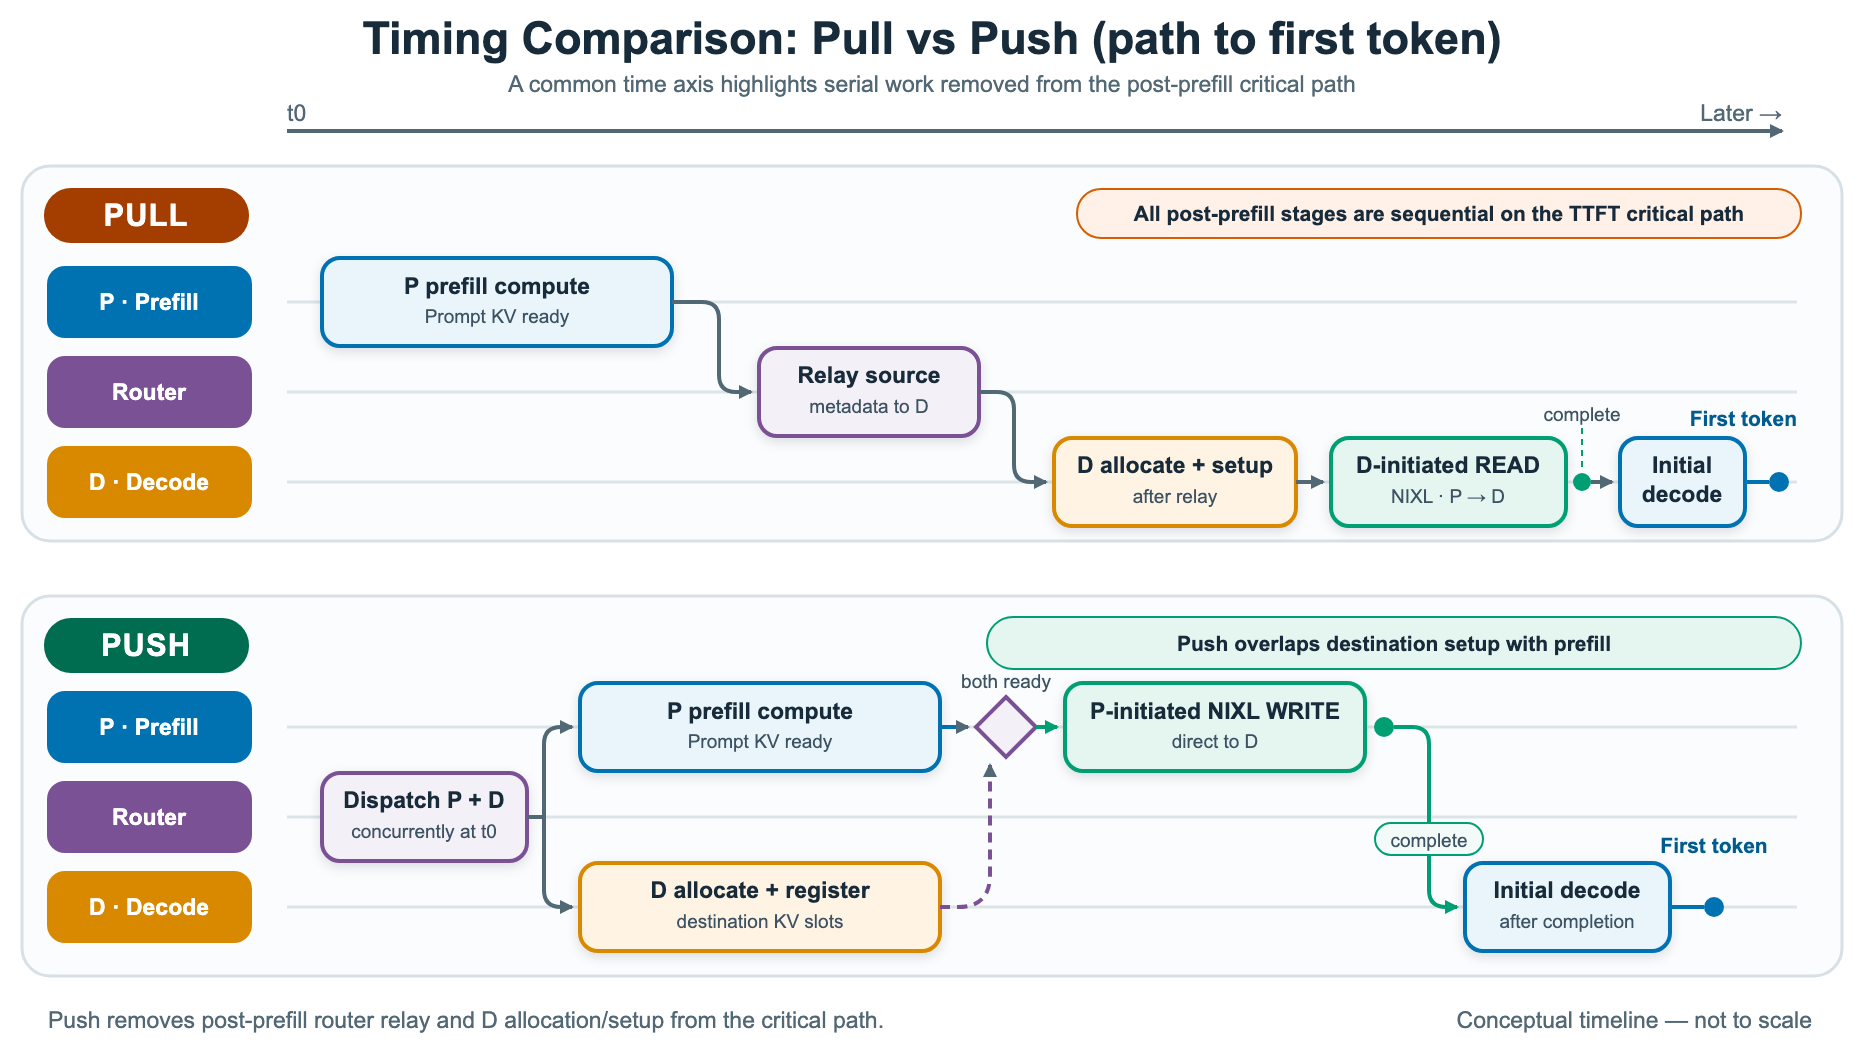
Abbildung 4: Vergleich der Pull- und Push-Übertragungsabläufe, der hervorhebt, wie Push das Decode-seitige Setup mit dem Prefilling überlappt
Die beiden Modi beinhalten auch einen Routing-Kompromiss. Der Pull-Modus erlaubt dem Router, eine Decode-Instanz erst nach Abschluss des Prefillings auszuwählen, was mehr Flexibilität für lastbewusstes Routing und Quality-of-Service-Management bietet. Der Push-Modus wählt die Decode-Instanz früher aus, damit das Ziel-Setup mit dem Prefilling überlappen kann. Dafür kann die Prefill-Instanz unter vergleichbarer Last ihre KV-Blöcke früher freigeben, weil die Übertragung beginnt, sobald sowohl der Prompt-KV als auch die Zielregistrierung bereit sind.
Leistungsdaten
Für die Evaluierung verwendeten wir das Modell Qwen3-32B auf einer 1P1D-Bereitstellung mit Amazon EC2 P5en-Instanzen, die über EFA verbunden sind. Um die P→D-Übertragungsleistung zu isolieren, konfigurierten wir den Benchmark so, dass Prefix-Caching deaktiviert ist mit --no-enable-prefix-caching. Diese Konfiguration sorgt dafür, dass der Decode-Knoten für jede Anfrage den vollständigen KV-Cache vom Prefill-Knoten abruft. Andernfalls könnten sich überlappende Prompts den lokalen Cache des Decode-Knotens zunutze machen und die Übertragung umgehen, was zu irreführenden Vergleichsergebnissen führen würde.
Das folgende Diagramm vergleicht die TTFT für Push- und Pull-KV-Übertragung. Wir variieren Eingabelängen von 1k–16k und Anfragenraten von 1–8 Abfragen pro Sekunde (QPS). Bei geringer Last und kurzen Prompts verhalten sich beide Modi nahezu identisch. Mit wachsender QPS und Eingabelänge verschlechtert sich der Pull-Modus deutlich und erreicht etwa 1,744 ms bei 8 QPS und 16k. Der Push-Modus bleibt mit etwa 540 ms deutlich darunter, eine Reduzierung um rund 3x. Die Lücke entsteht, weil der Pull-Modus die NIXL-Deskriptoren inline auf dem Decode-Worker postet, synchron innerhalb seiner Engine-Schleife, sodass diese Arbeit die Token-Generierung blockiert. Der Push-Modus verlagert sie in einen Hintergrundthread, außerhalb des kritischen Pfads.
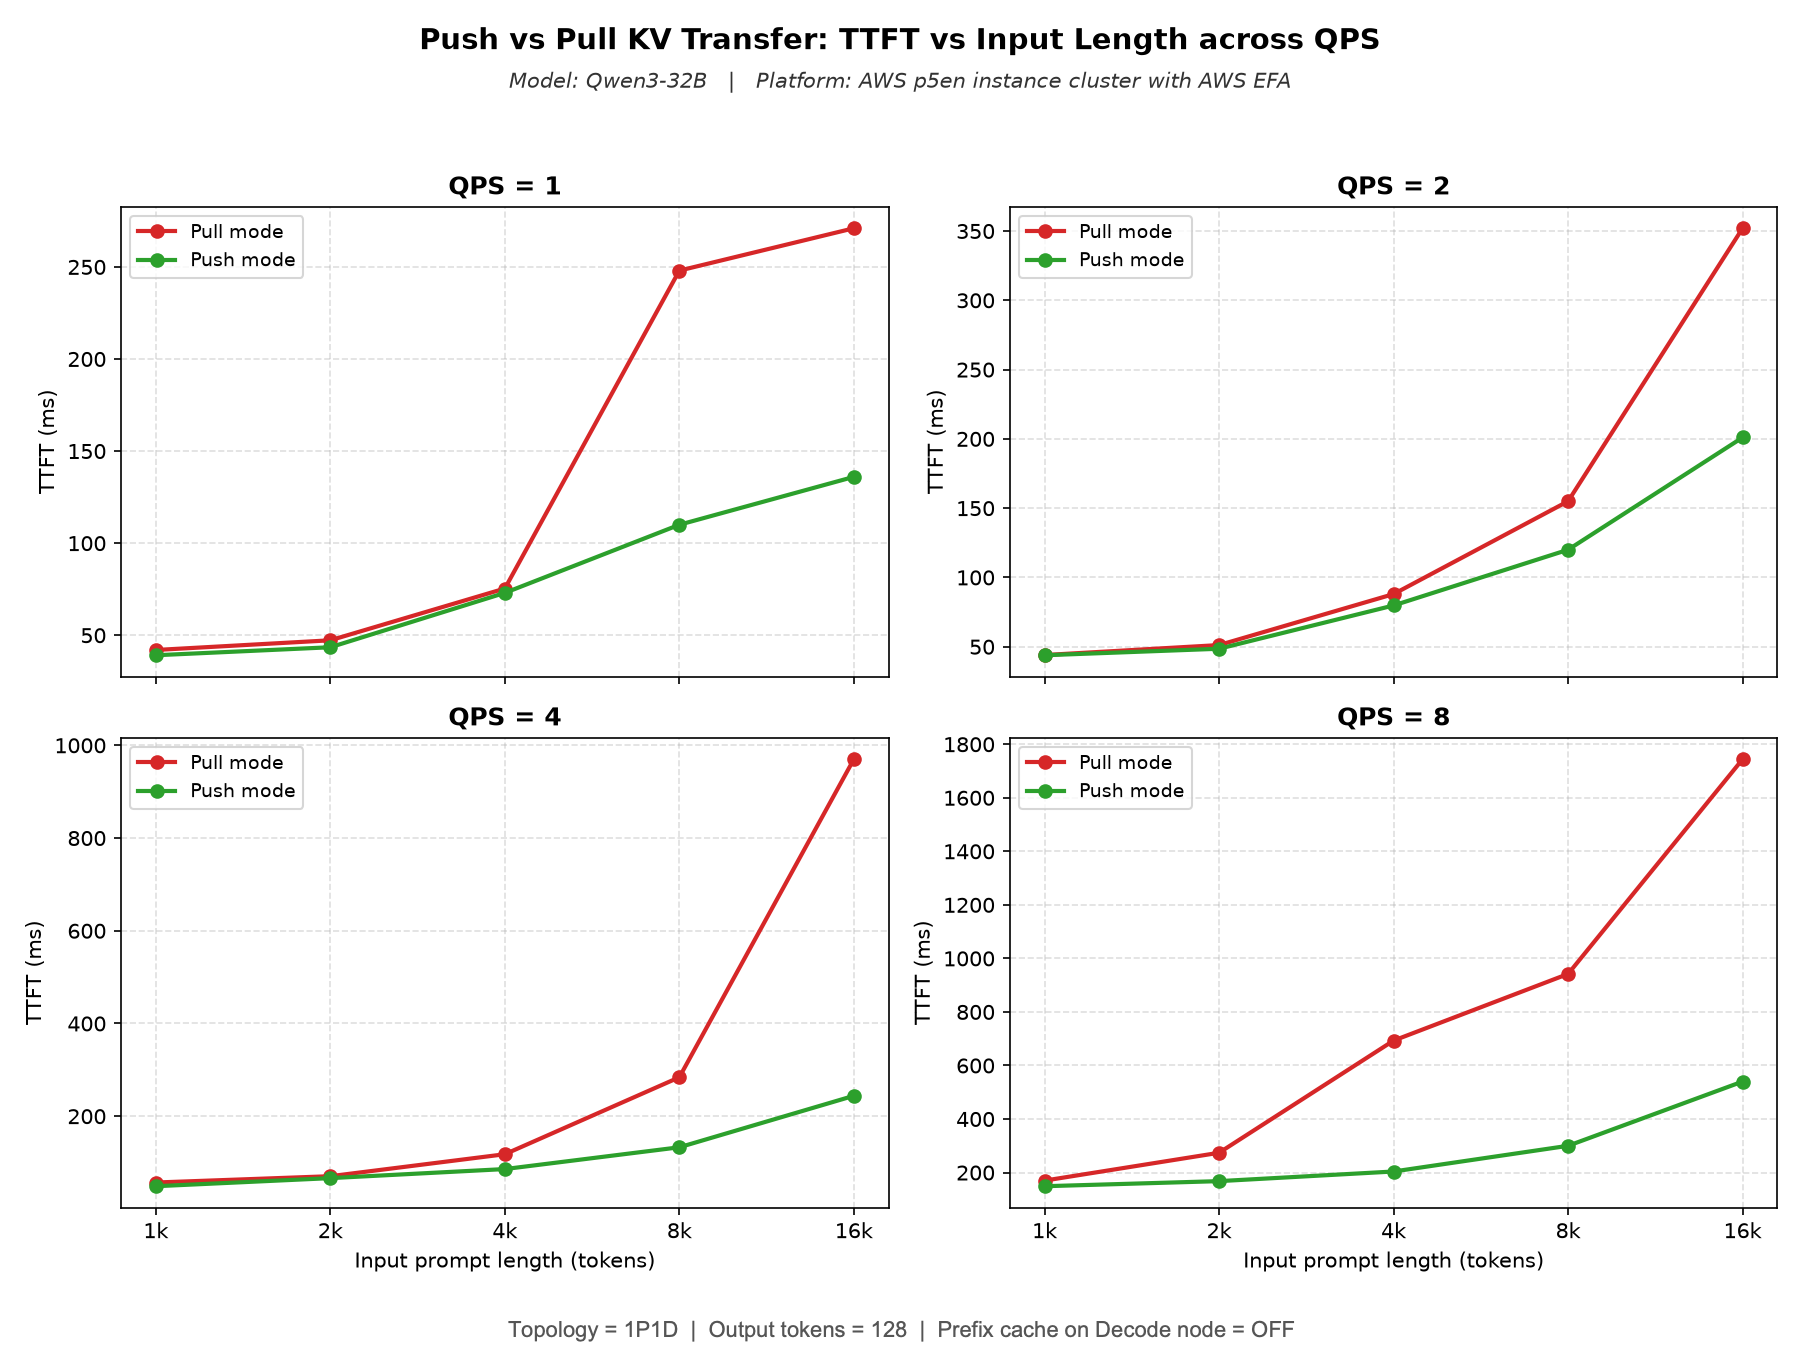
Abbildung 5: TTFT für Push im Vergleich zur Pull-KV-Übertragung über Eingabelängen und Anfragenraten (1P1D-Topologie, 128 Ausgabe-Tokens, auf dem Decode-Knoten deaktiviertes Prefix-Caching)
Dieses Diagramm zeigt die TPOT unter denselben Bedingungen. Das Muster spiegelt die TTFT wider. Bei geringer Last liegen Push und Pull nahe beieinander, bei etwa 5.6–5.8 ms. Steigen Last und Eingabelänge, klettert Pull auf etwa 10.4 ms bei 4–8 QPS und 16k, während Push bei etwa 7 ms bleibt. Der Grund ist, dass Push die Deskriptorvorbereitung und das Absenden der Übertragung vom Decode-Worker auslagert. Die Token-Generierung wird nicht ausgehungert, sodass die Latenz pro Token auch bei hoher Konkurrenz und langen Kontexten konstant bleibt.
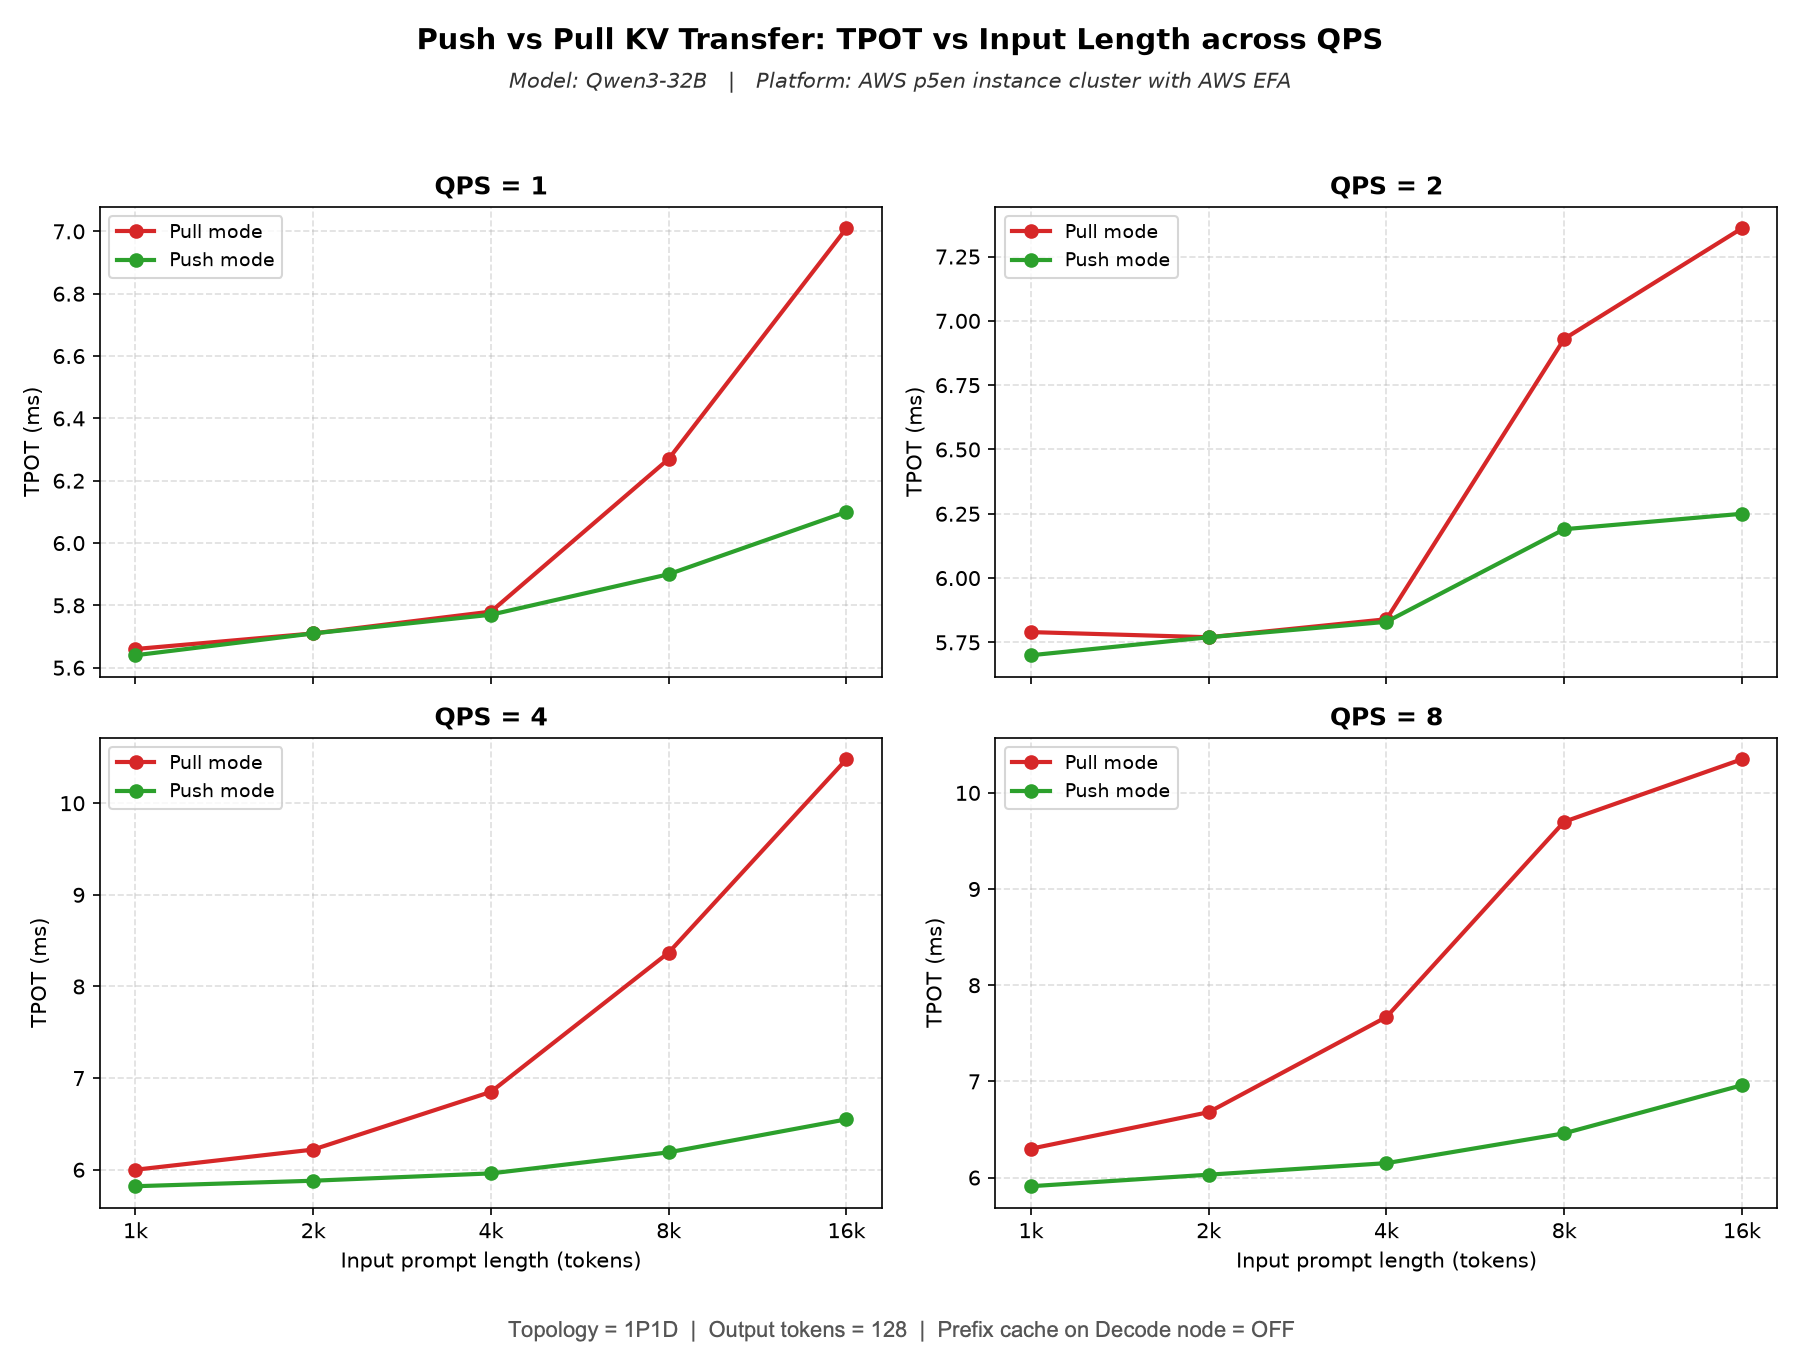
Abbildung 6: TPOT für Push im Vergleich zu Pull KV-Transfer über Eingabelängen und Anforderungsraten (1P1D-Topologie, 128 Ausgabe-Tokens, Prefix-Caching auf dem Decode-Knoten deaktiviert)
So führen Sie den Benchmark aus
Um unsere 1P1D-Benchmark-Konfiguration mit einem Prefill-Knoten und einem Decode-Knoten unter Verwendung von Amazon EC2 P5en-Instanzen, die mit EFA verbunden sind, zu reproduzieren, folgen Sie den detaillierten Anweisungen im Reproducing our results -Guide. Der Guide behandelt die Einrichtung der Umgebung, das Starten der vLLM-Prefill- und Decode-Server, die Ausführung des Benchmarks und das Sammeln der Ergebnisse. Das Feature kann auf anderen unterstützten Konfigurationen ausgeführt werden, aber die Leistungsergebnisse variieren je nach Hardware, Modell, Workload und Netzwerkkonfiguration.
Fazit
In diesem Beitrag haben wir gezeigt, wie der push-basierte KV-Connector die Prefill-Berechnung mit der Blockallokation und Registrierung auf der Decode-Seite überlappt und dadurch die Router-Roundtrip-Nach dem-Prefill sowie die Transfer-Einrichtung auf der Decode-Seite aus dem kritischen Pfad entfernt. Dies reduziert TTFT und TPOT, insbesondere bei hohen Anforderungsraten. In unserem Qwen3-32B-Benchmark auf einer 1P1D-Bereitstellung mit Amazon EC2 P5en-Instanzen, die mit EFA verbunden sind, bot der Push-Modus eine bis zu 3x Verbesserung bei TTFT und 30 Prozent Verbesserung bei TPOT im Vergleich zum Pull-Modus. Die Ergebnisse variieren je nach Workload und Konfiguration. Um den Push-Modus zu verwenden, konfigurieren Sie sowohl die Prefill- als auch die Decode-Server so, dass sie NixlPushConnector verwenden, anstatt NixlConnector.
Wählen Sie den push-basierten Connector, wenn eine frühe Decode-Knotenauswahl akzeptabel ist und ein niedrigerer TTFT Priorität hat. Der pull-basierte Connector bleibt die bessere Wahl für Workloads, die bidirektionalen KV-Transfer erfordern oder die Decode-Instanzauswahl bis nach dem Prefill verzögern, um ein lastbewusstes Routing zu ermöglichen. vLLM unterstützt sowohl push- als auch pull-basierte KV-Connectors, sodass Sie den Ansatz wählen können, der am besten zu Ihrer Bereitstellung passt.
Als zukünftige Verbesserung untersuchen wir, das Hintergrund-NIXL-Threading-Modell in den Pull-Modus-Connector zu bringen, um die NIXL-Einrichtung aus dem kritischen Pfad zu verlagern, sodass auch Pull-Modus-Workloads von denselben Optimierungen profitieren könnten. Wir haben einen Pull-Request geöffnet, um dies zu untersuchen.
Verwandte Ressourcen
Danksagungen
Wir danken der vLLM-Community für ihre Unterstützung bei der Pflege dieses Features.