
Multi-Turn-Agentic-Workloads bauen auf akkumuliertem Kontext auf, während ein Agent argumentiert, Tools aufruft und frühere Ergebnisse einbezieht. Bei jedem neuen Zug sendet der Client den Konversationsverlauf erneut, einschließlich Systemanweisungen, früherer Prompts, Tool-Ergebnissen und Modellantworten, wodurch der wachsende Kontext wiederholt verarbeitet wird. In Prefill-Decode (P-D) Disaggregation, wird jede Anfrage auf spezialisierte Knoten aufgeteilt: Der Prefill-Knoten verarbeitet den Prompt und erstellt dessen Key-Value-(KV-)Cache, dann ruft der Decode-Knoten diese KV-Blöcke ab und generiert die Antwort.
Konventionelles disaggregiertes Serving überträgt den KV-Cache jedoch nur in eine Richtung: vom Prefill- zum Decode-Knoten. Dieser einseitige Datenfluss führt bei Multi-Turn-Workloads zu zwei Ineffizienzen. Erstens hält der Decode-Knoten nach der Generierung einer Antwort KV-Cache-Einträge sowohl für den Prompt als auch für die neu generierten Tokens. Bei der Verarbeitung des nächsten Zuges kann der Prefill-Knoten diese Einträge nicht abrufen und muss daher die KV-Projektionen für die vorherigen Antwort-Tokens neu berechnen. Zweitens verwaltet der Decode-Knoten den Sitzungszustand, während die Prefill-Knoten dies nicht tun, was die Wahrscheinlichkeit einer Cache-Verdrängung aktiver Sitzungen auf den Prefill-Knoten erhöht. Bei einem vollständigen Cache-Miss muss der Prefill-Knoten die KV-Projektionen für den gesamten Konversationsverlauf neu berechnen, einschließlich Systemanweisungen, früherer Benutzeranfragen, Tool-Ergebnisse und modellgenerierter Antworten. Mit wachsender Konversation verbraucht diese redundante Arbeit mehr Rechenleistung der Beschleuniger und erhöht die Time to First Token (TTFT).
Wenn Sie Konversationsassistenten und Agentic-Anwendungen entwickeln, können längere Interaktionsverläufe die Latenz erhöhen und durch wiederholte Prefill-Berechnungen Rechenleistung der Beschleuniger verbrauchen. In diesem Beitrag zeigen wir, wie bidirektionaler KV-Cache-Transfer es Prefill- und Decode-Knoten ermöglicht, zuvor berechneten Kontext über mehrere Züge hinweg wiederzuverwenden, was die Auslastung der Beschleuniger verbessert und Anwendungen hilft, ein responsives TTFT bei wachsenden Konversationen aufrechtzuerhalten.
In unseren Multi-Turn-Benchmarks auf einer 1P1D-Bereitstellung mit Amazon Elastic Compute Cloud (Amazon EC2) P5en-Instances reduzierte der bidirektionale KV-Transfer die TTFT um bis zu 1.6x für Qwen3-32B und um bis zu 3.3x für zai-org/GLM-5-FP8 (siehe Abschnitt Performance data). Die Ergebnisse variieren je nach Workload und Konfiguration. Die Instances sind über den AWS Elastic Fabric Adapter (AWS EFA) verbunden, ein Netzwerk mit geringer Latenz für Remote Direct Memory Access (RDMA), das serverübergreifend in AWS eingesetzt wird. Auf unterstützten Instance-Typenunterstützt AWS EFA GPUDirect RDMA und Neuron Direct RDMA, um KV-Blöcke direkt zwischen dem GPU- oder AWS Trainium-Gerätespeicher auf den Prefill- und Decode-Knoten zu verschieben.
Wir haben die Funktion ursprünglich auf AWS Trainium -Instance-Clustern mit EFA entwickelt und validiert und als beschleunigeragnostische Fähigkeit zu vLLM beigetragen. Die hier präsentierten Ergebnisse stammen aus einem Amazon EC2 P5en-GPU-Cluster mit EFA und zeigen, dass die Vorteile auch auf GPUs übertragbar sind. Dieser Beitrag erläutert die Architektur des bidirektionalen KV-Transfers, den Router-Metadatenfluss, die KV-Block-Retention und die Recompute-Steuerung, die Leistungsergebnisse sowie die Reproduktion des Benchmarks.
Bidirektionaler KV-Transfer
Bidirektionaler KV-Transfer ist ein Mechanismus, bei dem ein Decode-Knoten bei nachfolgenden Zügen einer Konversation zuvor berechnete KV-Daten an einen Prefill-Knoten zurückgibt. Dies vermeidet die Neuberechnung des gemeinsam genutzten Kontexts auf dem Prefill-Knoten und wird durch einen konfigurierbaren KV-Recompute-Schwellenwert gesteuert. Es mindert beide zuvor beschriebenen Szenarien rechnerischer Redundanz. Damit dies funktioniert, muss der KV-Cache über den Zug hinaus, der ihn erzeugt hat, bestehen bleiben und in umgekehrter Richtung übertragen werden, koordiniert durch einen KV-Cache-bewussten Router.
NIXL-KV-Connector-Erweiterungen für bidirektionalen Transfer
Wir haben den NVIDIA Inference Xfer Library (NIXL) KV connector erweitert, damit Prefill-Knoten entfernte KV-Blöcke konsumieren können, ähnlich wie Decode-Knoten bereits KV-Blöcke konsumieren, die der Prefill-Knoten bereitstellt. Dies ist keine triviale Änderung, da die beiden Knotentypen architektonisch unterschiedlich sind: Prefill-Knoten berechnen KV-Repräsentationen für neue Prompt-Tokens und können vollständige Prompt-KV-Blöcke bereitstellen. Decode-Knoten verfügen nicht über die Fähigkeit (oder Effizienz), vollständige KV-Repräsentationen zu generieren, und können nur zuvor zwischengespeicherte KV-Blöcke bereitstellen. Daher behalten Prefill- und Decode-Knoten weiterhin ihre eigenen Rollen und Logiken zur Berechnung der Metadaten entfernter und lokaler KV-Blöcke. Der eigentliche KV-Transfer-Mechanismus (ein NIXL READ) ist jedoch für beide Richtungen, die P->D - und die D->P -Richtung, gemeinsam.
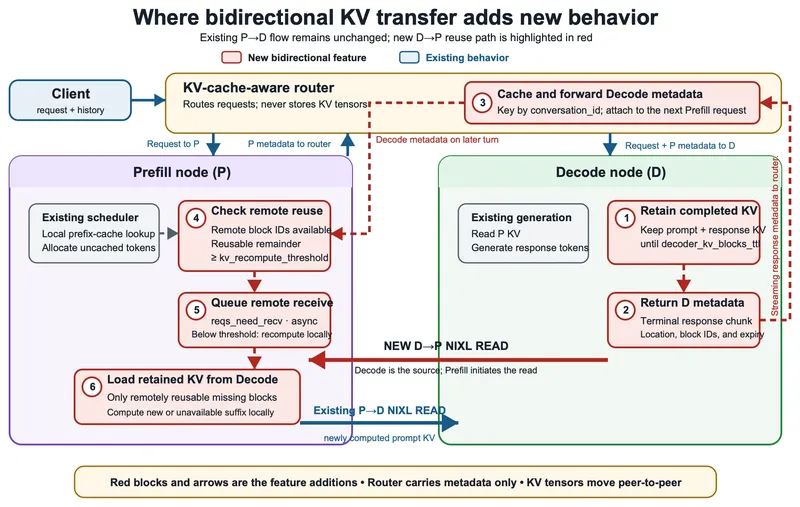
Das folgende Diagramm zeigt zunächst den bestehenden Ablauf in Blau. Der Router sendet die Anfrage an den Prefill-Knoten, der Prefill-Knoten berechnet das Prompt-KV und gibt seine Block-Metadaten zurück, und der Router leitet die Anfrage und die Metadaten zur Standard-P→D-NIXL READ an den Decode-Knoten weiter. Der nummerierte rote Pfad veranschaulicht die Ergänzungen für die bidirektionale KV-Übertragung: (1) der Decode-Knoten behält geeignete KV-Blöcke nach der Generierung bei, (2) gibt deren Metadaten in der Streaming-Antwort zurück, und (3) der Router speichert diese Metadaten für die nächste Prefill-Anfrage im Cache. Der Prefill-Knoten (4) prüft dann das remote wiederverwendbare KV, nachdem er lokale Cache-Treffer angewendet hat, (5) stellt einen asynchronen Empfang in die Warteschlange, wenn die Anzahl der wiederverwendbaren Tokens den Schwellenwert erreicht, und (6) führt ein D→P NIXL READ durch, bevor er das verbleibende Suffix berechnet.
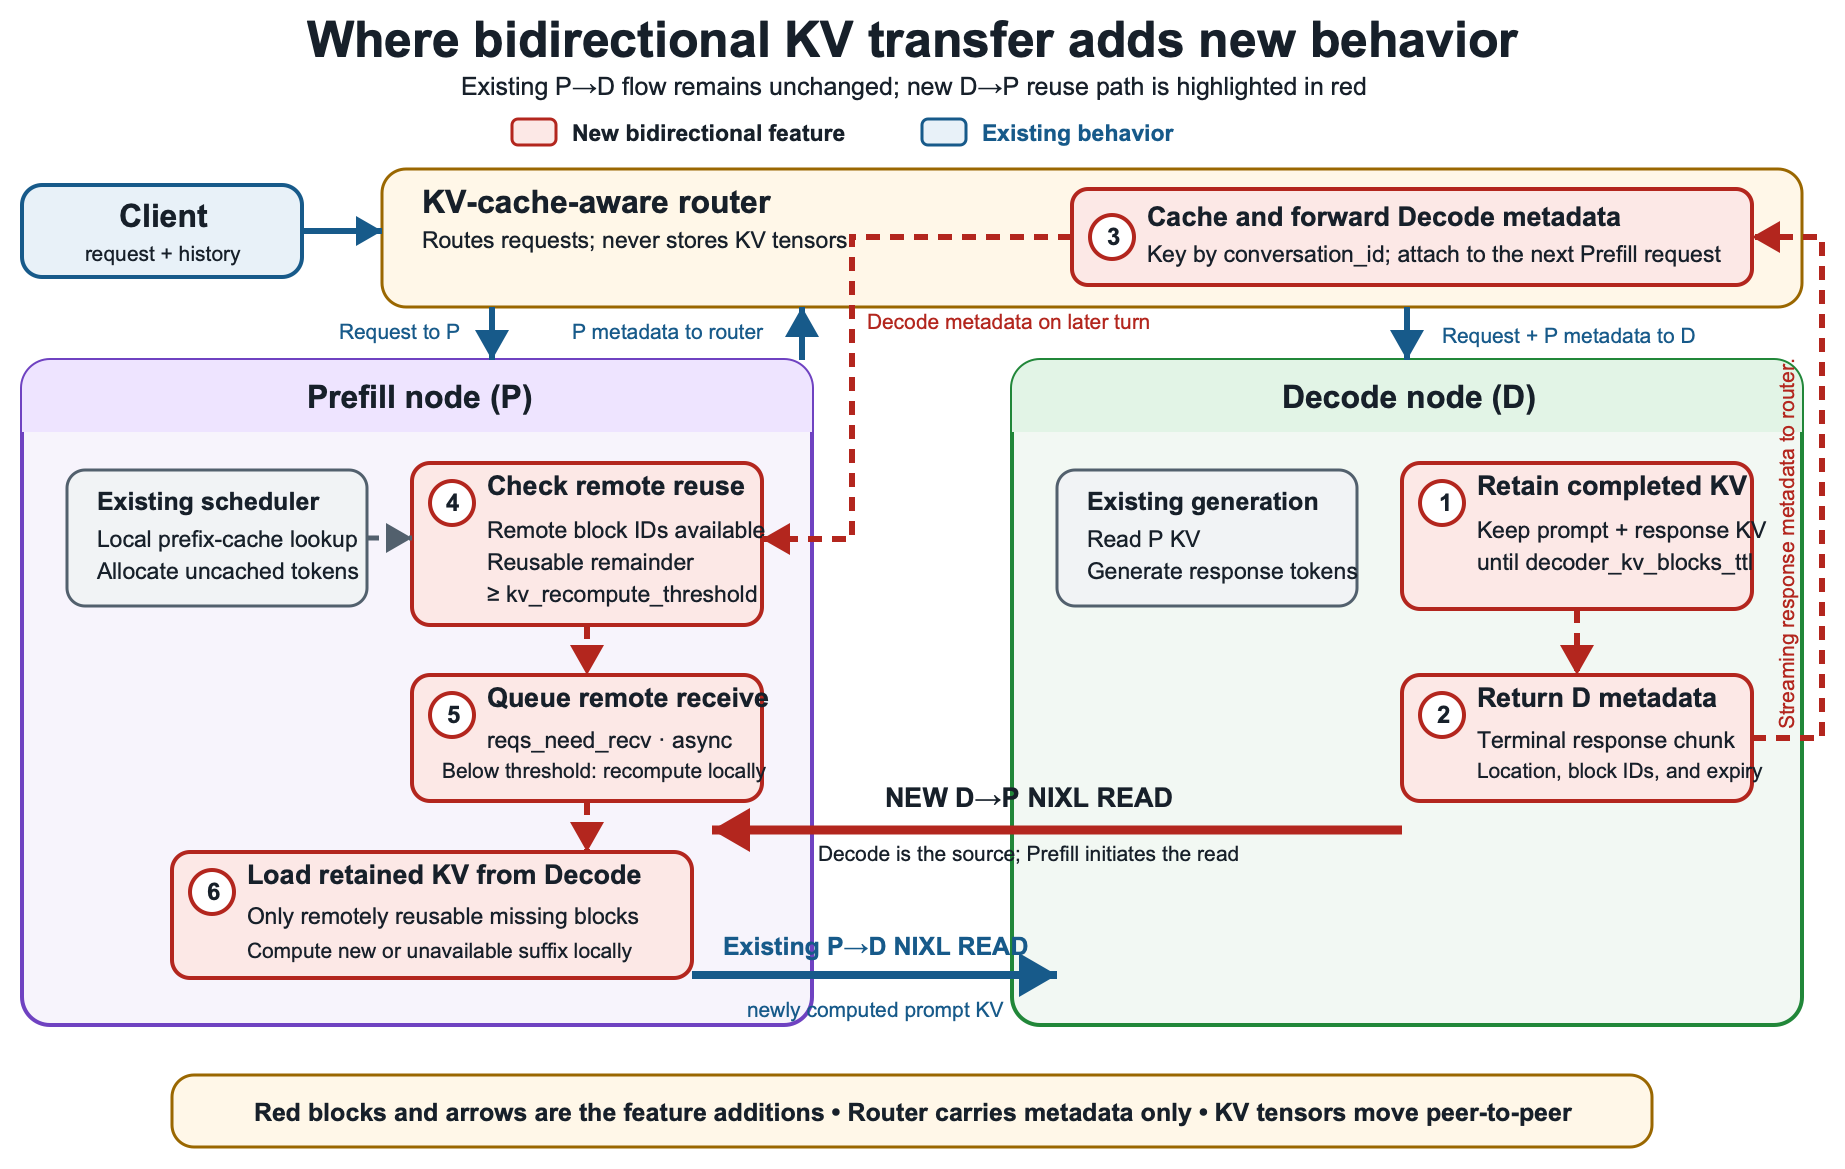
Abbildung 1: Standardmäßiger Prefill-to-Decode-Ablauf (blau) und die Ergänzungen für die bidirektionale KV-Übertragung (rot)
KV-Cache-bewusster Router
vLLM bietet connector-seitige Unterstützung für bidirektionale KV-Übertragung, während die Koordinierung der KV-Wiederverwendung über Gesprächsrunden hinweg einen KV-cache-bewussten Router erfordert. vLLM GitHub stellt eine Beispiel-Proxy der den in diesem Beitrag verwendeten Ablauf implementiert und an Ihre Umgebung angepasst werden kann.
Der KV-Cache-bewusste Router ist eine leichtgewichtige, zustandsbehaftete Control-Plane-Komponente zwischen dem Client, den Prefill- und Decode-Knoten. Er verwaltet eine In-Memory-Zuordnung von der vom Client bereitgestellten conversation_id von decode kv_transfer_params. Der Router speichert nur Metadaten zu den Blockpositionen, keine KV-Tensoren, und bezieht diese Metadaten aus dem Antwortstrom, statt separat den Decode-Knoten abzufragen.
Das folgende Diagramm zeigt, wie der Router die KV-Metadaten über Gesprächsrunden hinweg verwaltet. In der ersten Runde schlägt der Cache-Lookup fehl und die Anfrage folgt dem Standard-P→D-Ablauf. Der Router speichert dann die Decode-Metadaten aus dem Antwortstrom. In späteren Runden ruft der Router diese Metadaten über die conversation_id damit Prefill die KV aus Decode wiederverwenden kann. Anschließend aktualisiert sie die Metadaten nach der Generierung für den nächsten Zug.
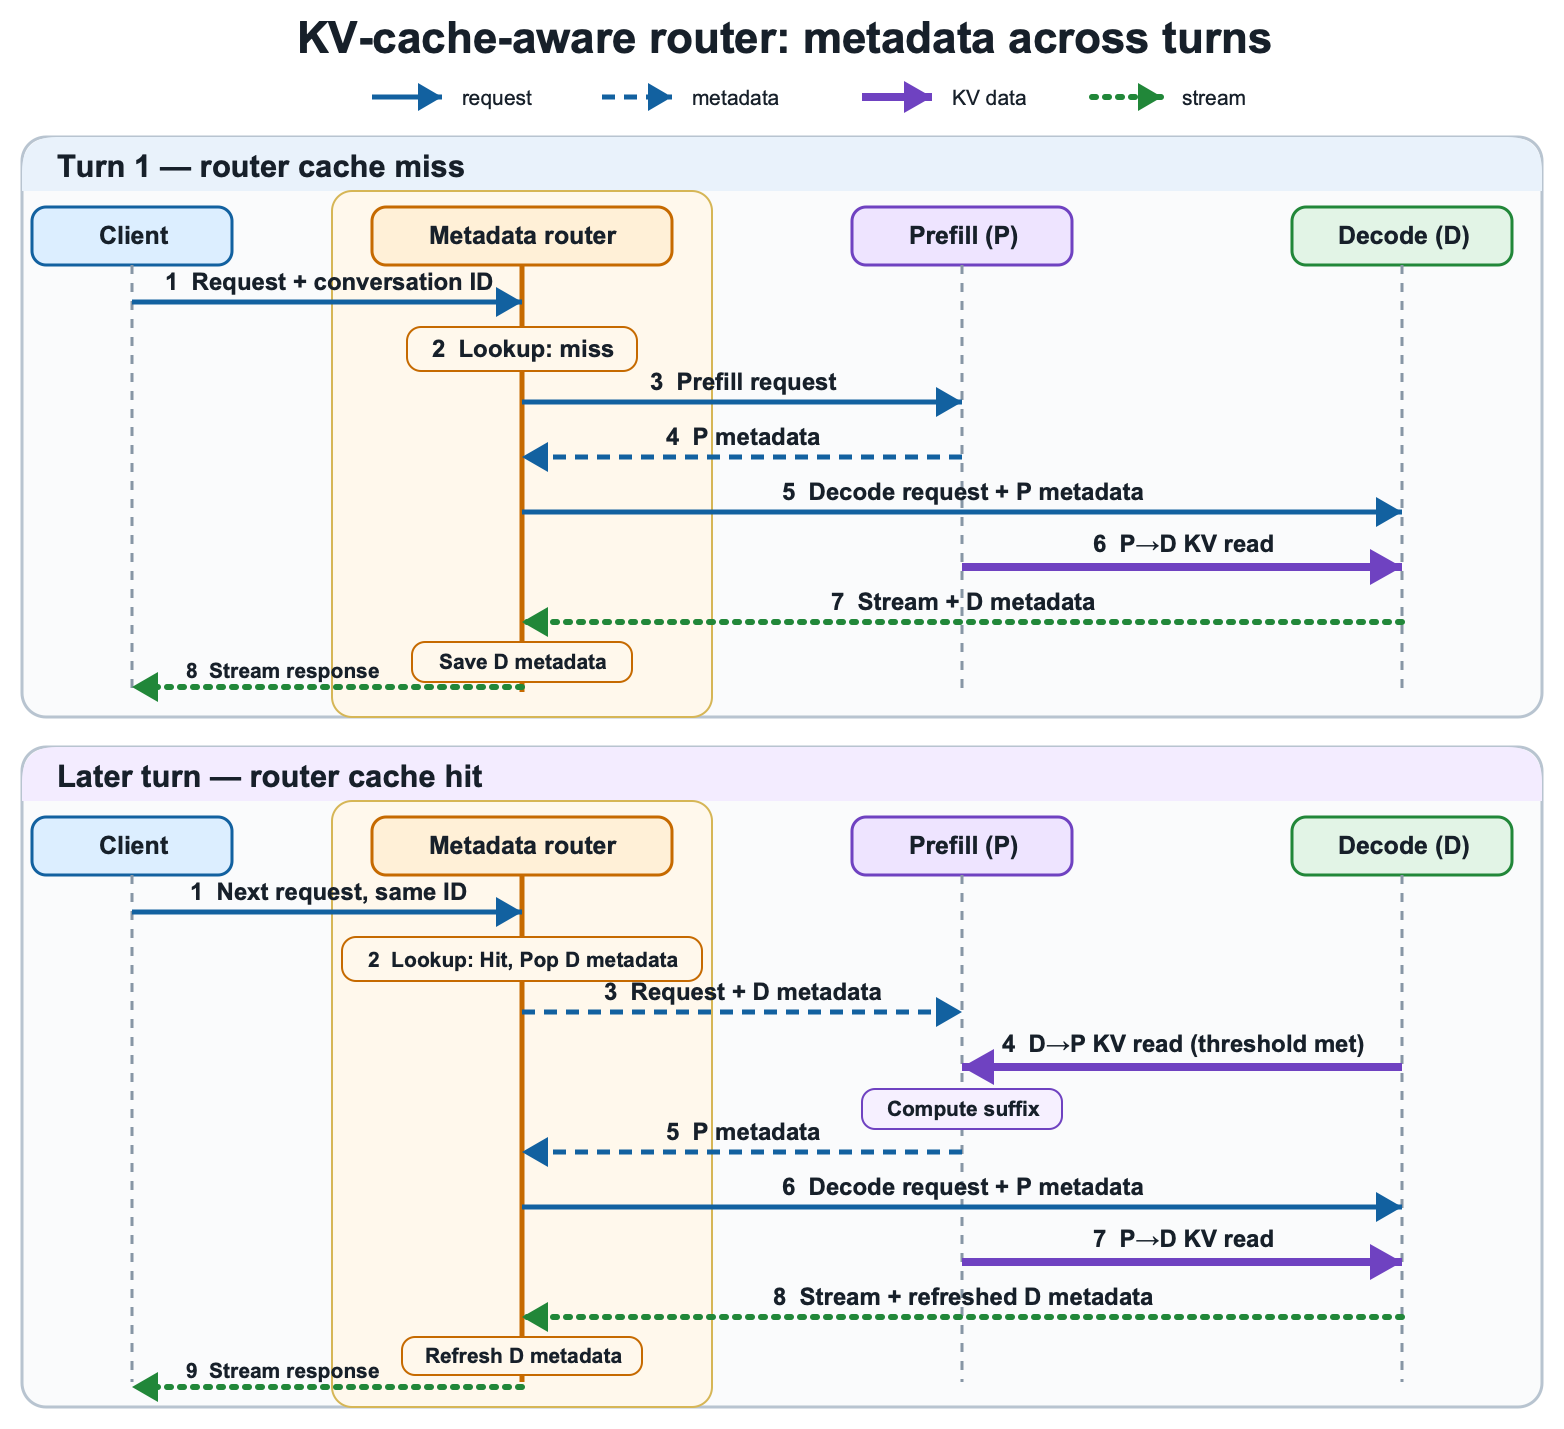
Abbildung 2: Metadatenfluss des KV-cache-bewussten Routers über Konversationsrunden hinweg
Block Retention TTL
Ein Decode-Instance gibt die Blöcke einer Anfrage normalerweise frei, sobald die Generierung abgeschlossen ist. Im bi-direktionalen KV-Übertragungsmodus hält sie diese für eine konfigurierbare Lebensdauer (decoder_kv_blocks_ttl, Standardwert 480 Sekunden) und veröffentlicht deren Speicherort und Ablaufzeit. Der KV der Konversation, sowohl der Prompt-Präfix als auch die generierte Antwort, bleibt dann für den nächsten Turn verfügbar. Für einen Turn, der eintrifft, bevor die Time to Live (TTL) abläuft, verwendet der Prefill-Knoten den KV wieder. Ein Turn, der später eintrifft, fällt auf normales Prefill zurück. Da diese TTL festgelegt und nicht verlängert wird, stimmen Sie sie auf die erwartete Zeit zwischen Turns ab, um die KV-Wiederverwendung gegen die Nutzung des Beschleunigerspeichers abzuwägen. Eine naheliegende nächste Verbesserung wäre, den durch Heartbeat verlängerten Lease auf die Decode-Seite auszuweiten. Eine Decode-Instanz könnte dann Blöcke zurückfordern, sobald eine Konversation in den Leerlauf übergeht, statt am Ende eines festen Timers.
KV-Recompute-Schwellenwert
Die Wiederverwendung des KV-Caches ist nicht immer schneller als die lokale Neuberechnung. Bei einem kurzen wiederverwendbaren Präfix können die Kosten für Interconnect und Koordination die Zeit übersteigen, die zur Neuberechnung der Tokens benötigt wird. Die kv_recompute_threshold Einstellung, die standardmäßig auf 64 Tokens gesetzt ist, steuert diese Entscheidung. Der Prefill-Knoten berechnet neu, wenn die zu berechnende Token-Anzahl unter dem Schwellenwert liegt, und zieht KV vom Decode-Knoten, wenn sie bei oder über dem Schwellenwert liegt. Deployments können diesen Wert basierend auf der Modellrechenzeit, der KV-Größe und der Interconnect-Leistung anpassen.
Leistungsdaten
Für die Evaluierung verwendeten wir die Modelle Qwen3-32B und GLM-5-FP8 in einer 1P1D-Bereitstellung auf Amazon EC2 P5en-Instanzen, die über EFA verbunden sind. Um Szenarien nachzubilden, in denen der Prefill-Knoten seinen lokalen Cache verworfen hat oder der Router einen anderen Prefill-Knoten auswählt, der die KV-Blöcke der Konversation nicht besitzt, deaktivierten wir das Prefix-Caching auf dem Prefill-Knoten mit --no-enable-prefix-caching.
Bei beiden Modellen reduziert die Aktivierung der bidirektionalen KV-Übertragung die Prefill-Berechnung bei Konversationen mit mehreren Runden, und der Vorteil wächst typischerweise mit der Prompt-Länge. Bei ausgeschaltetem Feature berechnet die Prefill-Instanz jedes Mal den gesamten gewachsenen Kontext neu, wodurch die TTFT steil ansteigt. Qwen3-32B steigt von 158 ms bei 2k auf 778 ms bei 24k, und GLM-5-FP8 von 500 ms bei 2k auf 2,334 ms bei 20k. Bei eingeschaltetem Feature wird der von der Decode-Instanz vorgehaltene KV-Cache wiederverwendet statt neu berechnet, wodurch die TTFT deutlich flacher bleibt. Qwen3-32B steigt über denselben Bereich nur von 122 ms auf 460 ms (etwa eine 1.6-fache Reduzierung beim längsten Prompt), während GLM-5-FP8 von 358 ms auf 702 ms ansteigt und bei langen Prompts bis zu 3.3-fach unter dem Neuberechnungspfad bleibt. Die Aufschlüsselung der Prefill-Dauer erklärt, warum.
Die bidirektionale Übertragung fügt eine kleine KV-Übertragungszeit hinzu (etwa 30 ms bis 130 ms bei Qwen3-32B; etwa 29 ms bis 110 ms bei GLM-5-FP8), doch die Prefill-Berechnung, die sie einspart, überwiegt diese KV-Übertragungszeit bei weitem. Dadurch bleibt die gesamte Prefill-Dauer mit aktivierter Übertragung (Qwen3-32B: 128 ms bis 414 ms; GLM-5-FP8: 316 ms bis 541 ms) deutlich unter dem Pfad mit nur Neuberechnung (Qwen3-32B: 153 ms bis 744 ms; GLM-5-FP8: 500 ms bis 2,331 ms). Das größere Modell GLM-5-FP8 zeigt eine größere absolute und relative Lücke, da seine höhere Neuberechnungszeit pro Token die KV-Wiederverwendung noch mehr belohnt, wenn Modelle und Kontexte skalieren.
Qwen3-32B
Das folgende Diagramm stellt TTFT gegen die Prompt-Länge für Qwen3-32B dar und vergleicht bidirektionale KV-Übertragung EIN gegenüber AUS.
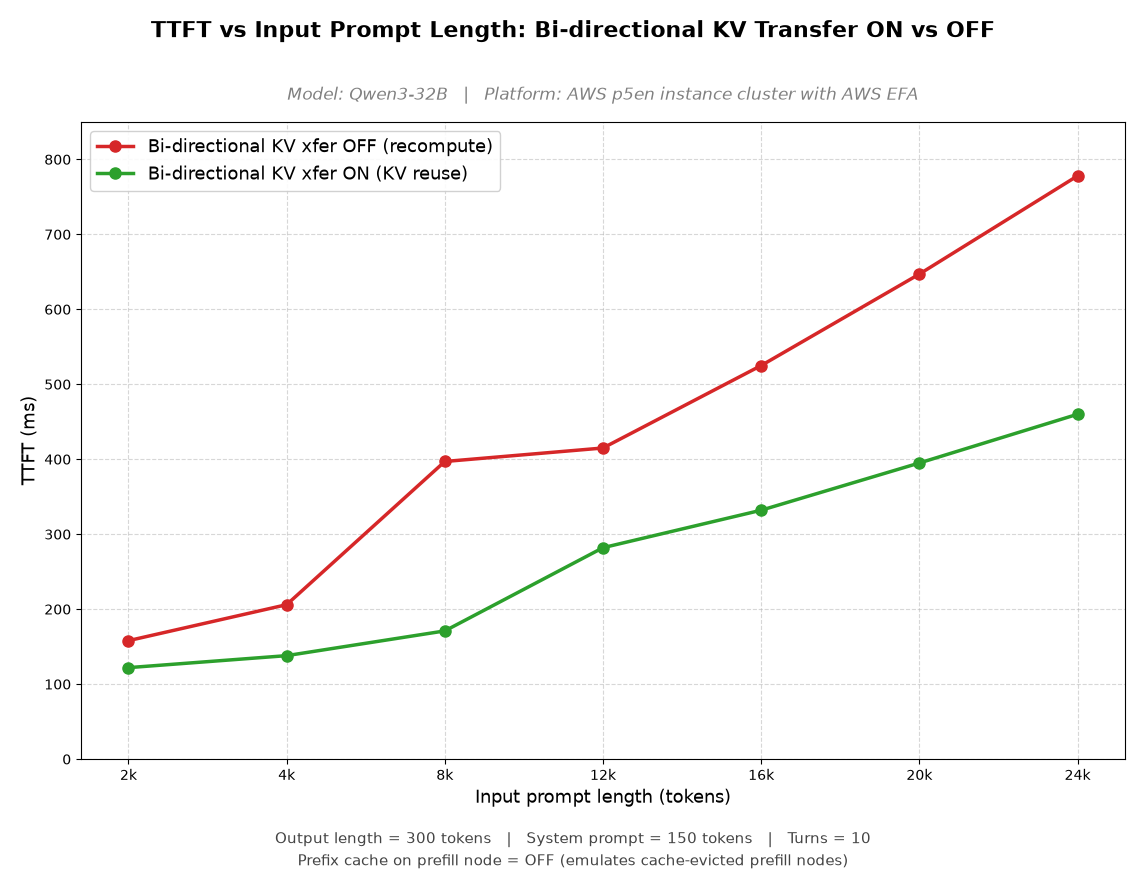
Abbildung 3: TTFT von Qwen3-32B in Abhängigkeit von der Prompt-Länge mit aktivierter und deaktivierter bidirektionaler KV-Übertragung
Das nächste Diagramm gliedert die Prefill-Dauer derselben Läufe in ihre Komponenten Recompute und KV-Transfer.
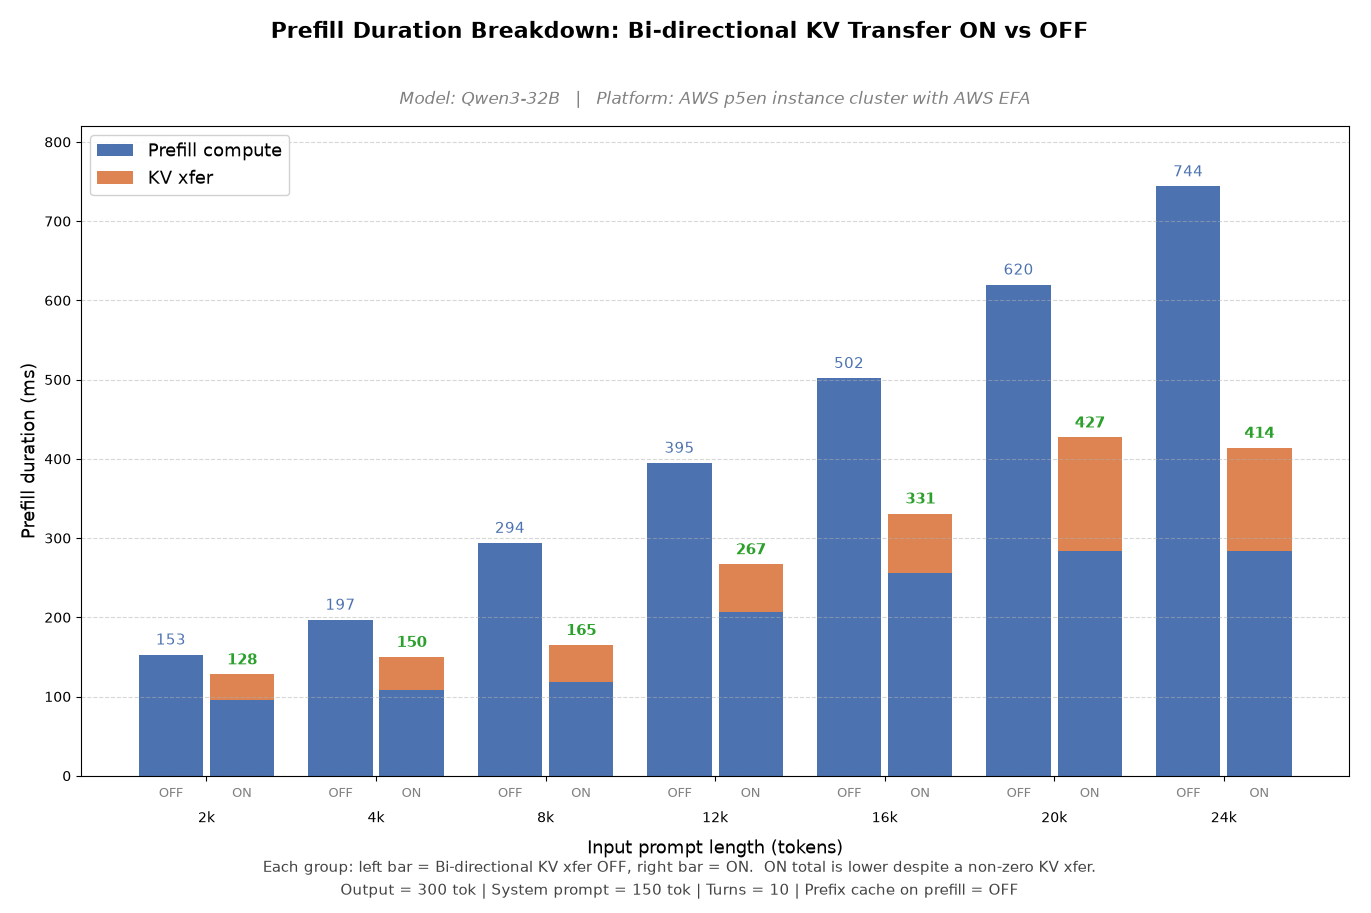
Abbildung 4: Prefill-Dauer von Qwen3-32B aufgeteilt in Recompute- und KV-Transfer-Komponenten
Zusammen zeigen die Diagramme, dass TTFT mit aktivierter Funktion nahezu flach bleibt, während der Pfad ohne die Funktion bei wachsendem Kontext steil ansteigt, da die geringe KV-Transferzeit weitgehend von der Rechenwiederholung (Recompute) aufgewogen wird, die sie vermeidet.
zai-org/GLM-5-FP8
Dieselben beiden Ansichten gelten für GLM-5-FP8. Die erste Abbildung zeigt TTFT in Abhängigkeit von der Prompt-Länge mit aktivierter gegenüber deaktivierter Funktion.
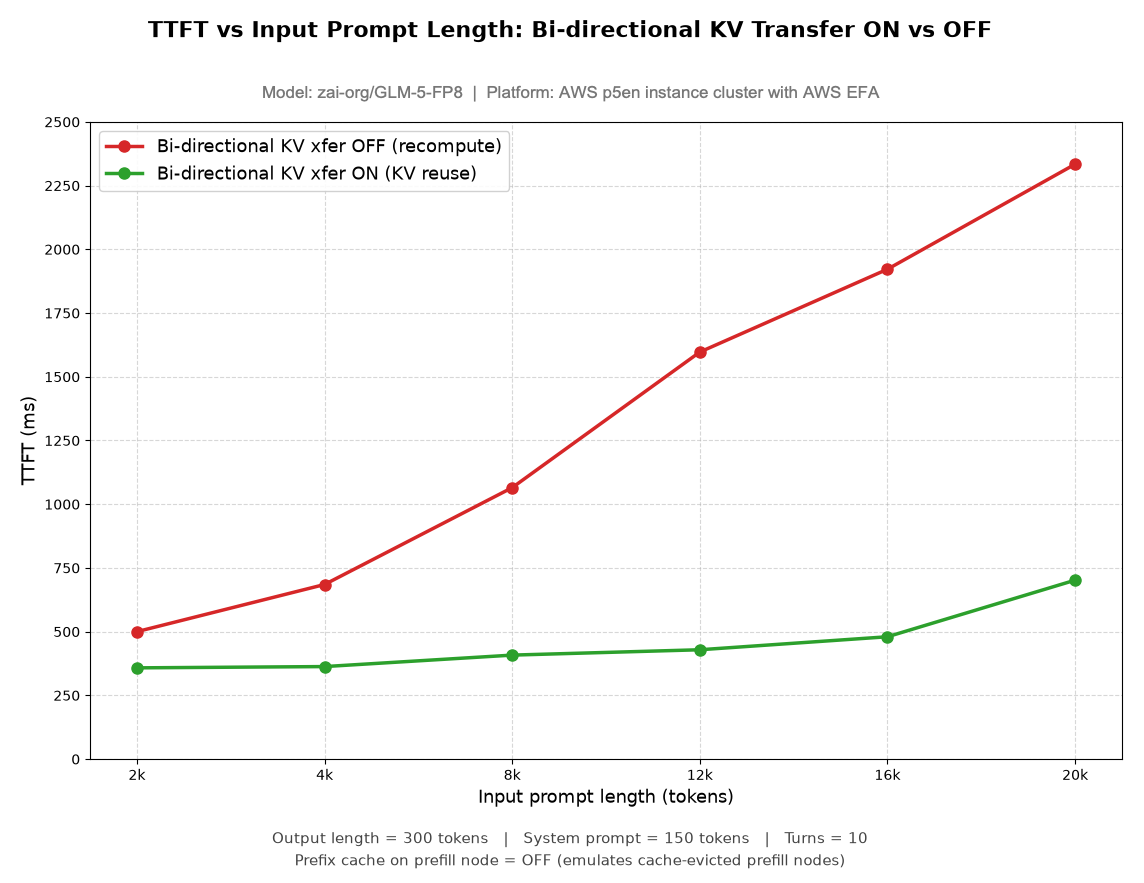
Abbildung 5: zai-org/GLM-5-FP8 TTFT mit KV-Wiederverwendung ein und aus
Die zweite Abbildung zerlegt die Prefill-Dauer in ihre Komponenten Recompute und KV-Transfer.
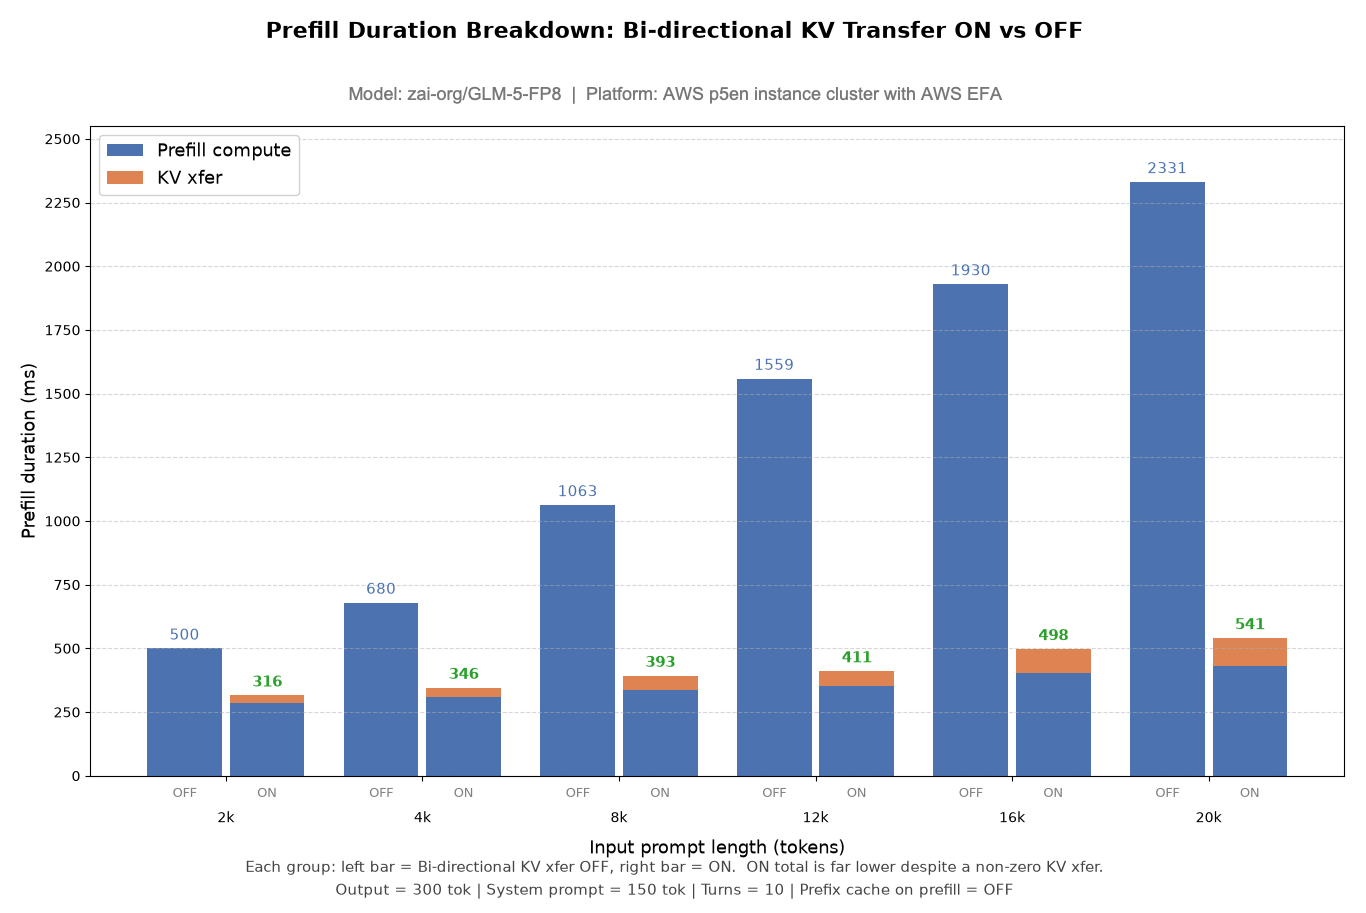
Abbildung 6: zai-org/GLM-5-FP8 Aufteilung der Prefill-Dauer
GLM-5-FP8 zeigt eine deutlich größere Lücke als Qwen3-32B, mit bis zu etwa 3.3x niedrigerem TTFT bei langen Prompts, da seine höhere Recompute-Zeit pro Token die KV-Wiederverwendung mit wachsender Kontextlänge noch stärker bezahlt macht.
So führen Sie den Benchmark aus
Um unsere 1P1D-Benchmark-Konfiguration – ein Prefill-Knoten und ein Decode-Knoten – mit Amazon EC2 P5en-Instanzen mit EFA zu reproduzieren, folgen Sie den Schritt-für-Schritt-Anleitungen im Reproducing our results guide. Die Anleitung deckt die Einrichtung der Umgebung, das Starten der vLLM-Prefill- und Decode-Server, die Ausführung des Benchmarks und das Sammeln der Ergebnisse ab. Die Funktion kann auf anderen unterstützten Konfigurationen ausgeführt werden, wobei die Leistungsergebnisse je nach Hardware, Modell, Workload und Netzwerkkonfiguration variieren.
Fazit
In diesem Beitrag haben wir gezeigt, wie bidirektionaler KV-Cache-Transfer den TTFT senken kann, wenn der Konversationsverlauf eines Agenten wächst. In P-D-disaggregierten Bereitstellungen ermöglicht die Funktion dem Prefill-Knoten, KV-Blöcke wiederzuverwenden, die der Decode-Knoten über mehrere Runden hinweg beibehalten hat, wodurch wiederholte Berechnungen reduziert werden. Konfigurierbare Schwellenwerte für Blockaufbewahrung und Recompute bestimmen, wann die Wiederverwendung erfolgt. In einer 1P1D-Bereitstellung mit über EFA verbundenen Amazon EC2 P5en-Instanzen beobachteten wir bei den längsten getesteten Prompt-Längen TTFT-Reduktionen von 1.6x für Qwen3-32B und 3.3x für zai-org/GLM-5-FP8. Die Ergebnisse hängen vom Workload und der Bereitstellungskonfiguration ab. Um dies in Ihrer Umgebung umzusetzen, verwenden Sie vLLM v0.21.0 oder höher mit NixlConnector, aktivieren Sie bidirectional_kv_xfer auf beiden Prefill- und Decode-Servern, verwenden Sie einen kv-cache-bewussten Router und folgen Sie dem GitHub reproduction guide.
Verwandte Ressourcen
- AWS EFA
- Prefill-Decode (P-D) disaggregated serving
- Benchmark KV Cache Offloading with Multi-Turn Conversations
Danksagungen
Wir danken der vLLM-Community für ihre Unterstützung bei der Pflege dieser Funktion.