
Da die Stimme zu einer erstklassigen Modalität für KI wird, umfassen die Modelle von Deepgram Sprach-zu-Text-, Text-zu-Sprache- und Voice-Agenten. Sie verarbeiten derzeit Quadrillarden von Audiotokens pro Jahr für mehr als 200.000 Entwickler und 1.400 Organisationen. Kunden nutzen sie über die Deepgram-API oder führen sie in ihren eigenen Umgebungen aus, einschließlich auf Amazon SageMaker AI.
Für Deepgram bestimmt die Dienstleistungseffizienz die Menge an Audio, die das System mit einem gegebenen Infrastrukturbudget verarbeiten kann. Hochvolumige Batch-Arbeitslasten üben eine starke Belastung auf dieses Budget aus; je effizienter jede Akkumulatorstunde genutzt wird, desto mehr Audio kann Deepgram mit derselben Flotte bereitstellen. Dadurch wurde die Inferenzeffizienz zu einem natürlichen Ziel, und Deepgram wandte sich an AWS AI-Chips, um sie zu verbessern. Sie arbeiteten mit AWS zusammen, um das Sprach-zu-Text-Modell Nova-3 zu AWS Trainium2 zu bringen, für Offline-Batch-Arbeitslasten wie Analysen im Kontaktzentrum und medizinische Transkriptionen.
Die Integration begann mit der Übermittlung von Nova-3 als Standard-PyTorch-Code durch Deepgram. Über mehrere Monate portierten Deepgram und das AWS Forward Deployed Engineering (FDE) Team Nova-3 auf AWS Trainium2 in einer PyTorch-Rekonstruktion und passten es an das neue Hardware an. Die endgültige Konfiguration führt acht Modellreplikationen auf einer einzigen Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge-Instanz aus. Bei Deepgrams offline, Durchsatz-orientierten Batch-Arbeitslasten verarbeitete diese Konfiguration 11–70 Prozent mehr Audio pro Dollar als die Berechnungsoptionen, die Deepgram bisher verwendet hatte. Wir maßen dies anhand der Instanzpreise zum Zeitpunkt der Bewertung. Diese Verbesserungen helfen Deepgram, effizient skalieren zu können, bessere Modelle zu versenden und sie zu Kunden zu bringen – zu niedrigeren Preisen. Diese Vorteile können auch Kunden erreichen, die Deepgram-Modelle in ihrem eigenen virtuellen privaten Cloud (VPC) auf Amazon SageMaker AI selbst hosten. Dort verbessern Deepgram und AWS weiterhin die Einrichtungsfreundlichkeit, Zuverlässigkeit und Beobachtbarkeit.
In diesem Artikel zeigen wir den vollen Optimierungsprozess für die Inference bei Trainium: die Portierung von Nova-3 auf das AWS Neuron-Softwarestack, die nachfolgenden Kernel-Ebene-Optimierungen, den datenparallelen Rust-Runtimes, der es Deepgram’sem eigenen Modellserver ermöglicht, Trainium zu callen, sowie die Durchsatz- und Kostenergebnisse, die wir bei Batch-Transkription gemessen haben.
Optimierung von Nova-3 zu Trainium2 mit nativem PyTorch
Mit dem Standard-PyTorch-Code begannen wir damit, TorchNeuron zu verwenden – die native PyTorch-Integration des Neuron-Compilers, die sowohl Eager-Exekution als auch torch.compile unterstützt. Zuerst führten wir Nova-3 im Eager-Modus auf Trainium2 aus und überprüften, welche Operationen auf den CPU zurückfielen, anschließend kompilierten wir sie mit torch.compile. Die kompilierte Version führte alle Modelleingriffe auf Trainium2 ohne festzustellen, dass auf den CPU zurückgegriffen wurde.
Wir kompilierten den Encoder und den Decoder als separate statische-Form-Graphen mit torch.compile. Unterwegs überprüften wir die numerische Genauigkeit auf zwei Ebenen: die Konsequenz des Ausgabes auf Ebene der Schichten im Vergleich zum CPU sowie die end-to-end Word Error Rate (WER), die den Referenzwerten und dem Ziel von Deepgram entsprechen musste.
Von diesem Arbeitsgrundlagenpunkt begannen wir mit der Optimierung, indem wir mehrere Schichten durch fusionierte Kerne aus der öffentlichen NKI-Bibliothek (NKILib) ersetzt haben – eine Sammlung vorgefertigter Referenzkerne, die mit der Neuron Kernel Interface (NKI) erstellt wurden. Die Kerne umfassten Operationen wie gefusekte QKV-Projektionen, gefusekte Feed-forward-Netzwerk-Schichten und tiefe 1D-Konvolution.
Wir haben die Leistung und somit auch die Kosteneffizienz optimiert, um die Offline-Inferenzlasten von Deepgram zu bearbeiten. Die Leistung wird als relative Verbesserung gegenüber einer Grundkonfiguration angegeben, anstatt als absolute Audio-Verarbeitungsleistung pro Sekunde. Wir haben die Batchgrößen von 1 bis 128 ausgehende Tests durchgeführt, um die Batchgröße zu finden, die die Leistung am meisten maximiert.
Kernlevel-Optimierung mit Neuron Explorer und NAD
Das Aktivieren der Kernels ist nur der erste Schritt eines Optimierungskreislaufs: Aktivieren Sie einen NKI-Kernel (custom oder aus NKILib), profilieren Sie die Arbeitslast, und dann passen Sie entweder den bestehenden Kernel an oder ersetzen Sie ihn durch einen neuen Kernel auf Grundlage der Profilergebnisse. Dieser Prozess wiederholt sich, bis das Leistungsziel erreicht ist. Bei jedem Schritt beschleunigt ein unterschiedlicher Teil der Neuron-Stapel die Arbeit: NKILib bietet Ersatzkerne, die direkt eingebunden werden können, Neuron Explorer ist das Standardwerkzeug für die Profilierung von Neuron-Arbeitslasten, und das Neuron Agentic Development (NAD) Toolkit beschleunigt die Analyse sowie die Kernel-Anpassung durch seine Fähigkeiten in Bezug auf Profilierung und Kernel-Programmierung.
In unserem Fall haben uns die NKILib-Kerne einen großen Teil des Weges gebracht, und das Profiling zeigte, wo ein handgeschriebenes Kernel besser funktionieren würde. Jedes Mal führten die NAD-Profiling-Fähigkeiten uns von einem Neuron Explorer-Profil zu der Wurzelempfehlung, und die NAD-Kernel-Schreibfähigkeiten halfen dabei, die Ersatzkernels zu erstellen.
| Schicht | Was wir entdeckt und geändert haben | Gain |
| FFN | Die referenzielle Kernel-Tiling-Planung laden die gesamte Menge der Projektionselemente aus dem off-chip-Memory für jedes Token-Tile neu, sodass die Speicherbandbreite mit zunehmender Anzahl an Tokens den Durchsatz einschränkt. Unser manuell angepasster Kernel lädt jedes Gewichts-Tile einmal ein, verwendet es wiederholt für mehrere Token-Tiles und führt die Gewichts-Leseoperationen mit dem on-chip-Rechenverfahren durch. | 2,0x niedrigere Latenzzeit im Vergleich zum Referenzkern bei Batch-Größe 96 |
| Tiefenweite conv1d | Das experimentelle NKILib-Kernel fasste die Operation als eine implizite General-Matrix-Multiplikation (GEMM) zusammen, wodurch die Nutzung des Tensor-Engine wurde reduziert. Wir haben es in einen Broadcast-Multiply-Accumulate-Loop auf dem Vector-Engine umgebaut, sodass der gesamte Engine vollständig genutzt wurde – was ausreichte, um den niedrigeren Peak-Throughput des Vector-Engine mehr als auszugleichen. | 1,5x Beschleunigung im Vergleich zum Referenzkernel bei einer Batch-Größe von 96 |
| Conv2d | Die conv2d-Schichten des Modells erreichen einen Kompressionsengpass: Über eine Batchgröße von 32 hindern diese Schichten das Modell daran, als ein einzelnes Graph zu kompilieren. Da NKILib kein conv2d-Kernel hatte, haben wir eines in NKI von Grund auf geschrieben. Der Kernel durchlief mehrere Iterationen unter Anwendung des Profilers, wie bereits beschrieben, und ermöglichte so Batchgrößen über 32. | Bis 50-fach auf dem Konvolutionsmodul bei Batch-Größen ≤32 |
Datenparallellaufzeit in Rust
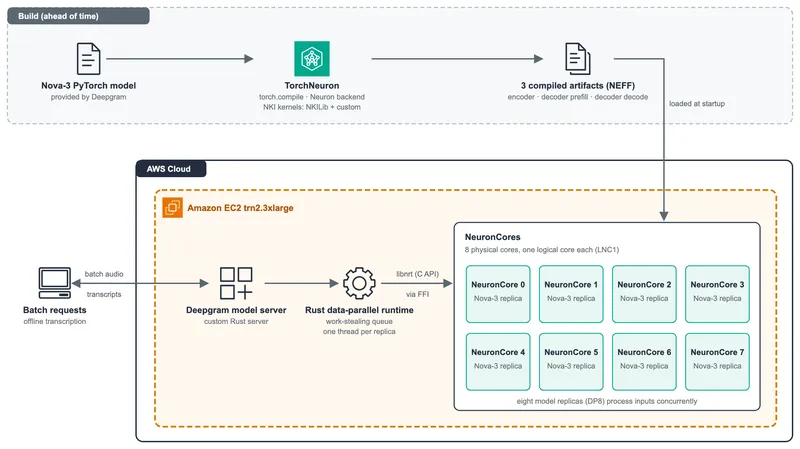
Jedes Trainium2-Gerät verfügt über acht physische NeuronCores, die standardmäßig als vier logische NeuronCores (LNC2) ausgegeben werden. Da jede Nova-3-Modellinstanz bequem auf einen einzigen physischen Core passt, wurde die Anzahl der physischen Cores pro logischem Core auf eins reduziert (LNC1). Diese Konfiguration ermöglicht es uns, acht Modellreplikationen (DP8) pro Trainium2-Gerät zu hosten. Die Eingaben werden gleichzeitig verarbeitet, wodurch die Durchsatzrate pro Gerät maximiert wird. Der datenparallele Laufzeitmodus wird durch eine Arbeit-Stohlen-Kette mit einer Thread pro Replica gesteuert.
Die Produktions- und Bereitstellungsstack von Deepgram ist in Rust geschrieben, sodass die Portierung von Nova-3 auf Trainium2 mehr als nur das Kompilieren des Modells erforderte: Es musste auch ohne Python oder PyTorch im Bereitstellungsprozess funktionieren. Wir entwickelten daher ein leichtes Betriebssystem, in dem Rust die Modellrepliken über eine gemeinsame Work-Stealing-Kette koordiniert. Eine C-Schicht lädt und ausführt vorab kompilierte Neuron-Executable File Format (NEFFs) direkt über die Neuron-Runtime-API (libnrt). Das Betriebssystem integriert sich direkt in die Bereitstellungsarchitektur von Deepgram und reproduziert die Referenz-Token-Sequenzen genau bei jedem getesteten Batch-Größe.
Wir haben es mit multithreaded (MT) und multiprocessing (MP) Python-Datenparallelsystemen verglichen. Im Vergleich zum MP-Baseline entfernt das Rust-Systemprogramm vollständig die Überhead des Python-Interpreters. Im Vergleich zum MT-Baseline löst es außerdem die Global Interpreter Lock (GIL)-Serialisierung, sodass Aufrufe von Dispatchen aus konkurrierenden Arbeitsprozessen nicht mehr innerhalb eines einzelnen Prozesses abgelehnt werden. Diese Vorteile sind wichtig, weil die Nova-3 eine Reihe kleiner Decodierungsanrufe pro Audiobatch durchführt, wodurch die Abwicklung auf der Hostseite bei kleinen Batchgrößen ein Engpass darstellt. Die Verbesserung des Durchsatzes ist daher am größten, und bleibt auch bei der durchsatzmaximierenden Batchgröße bedeutend. Dort erzielte das Rust-Runtimes den 7,5-prozentigen Durchsatzvorteil gegenüber dem multiparallelen Python-Baseline.
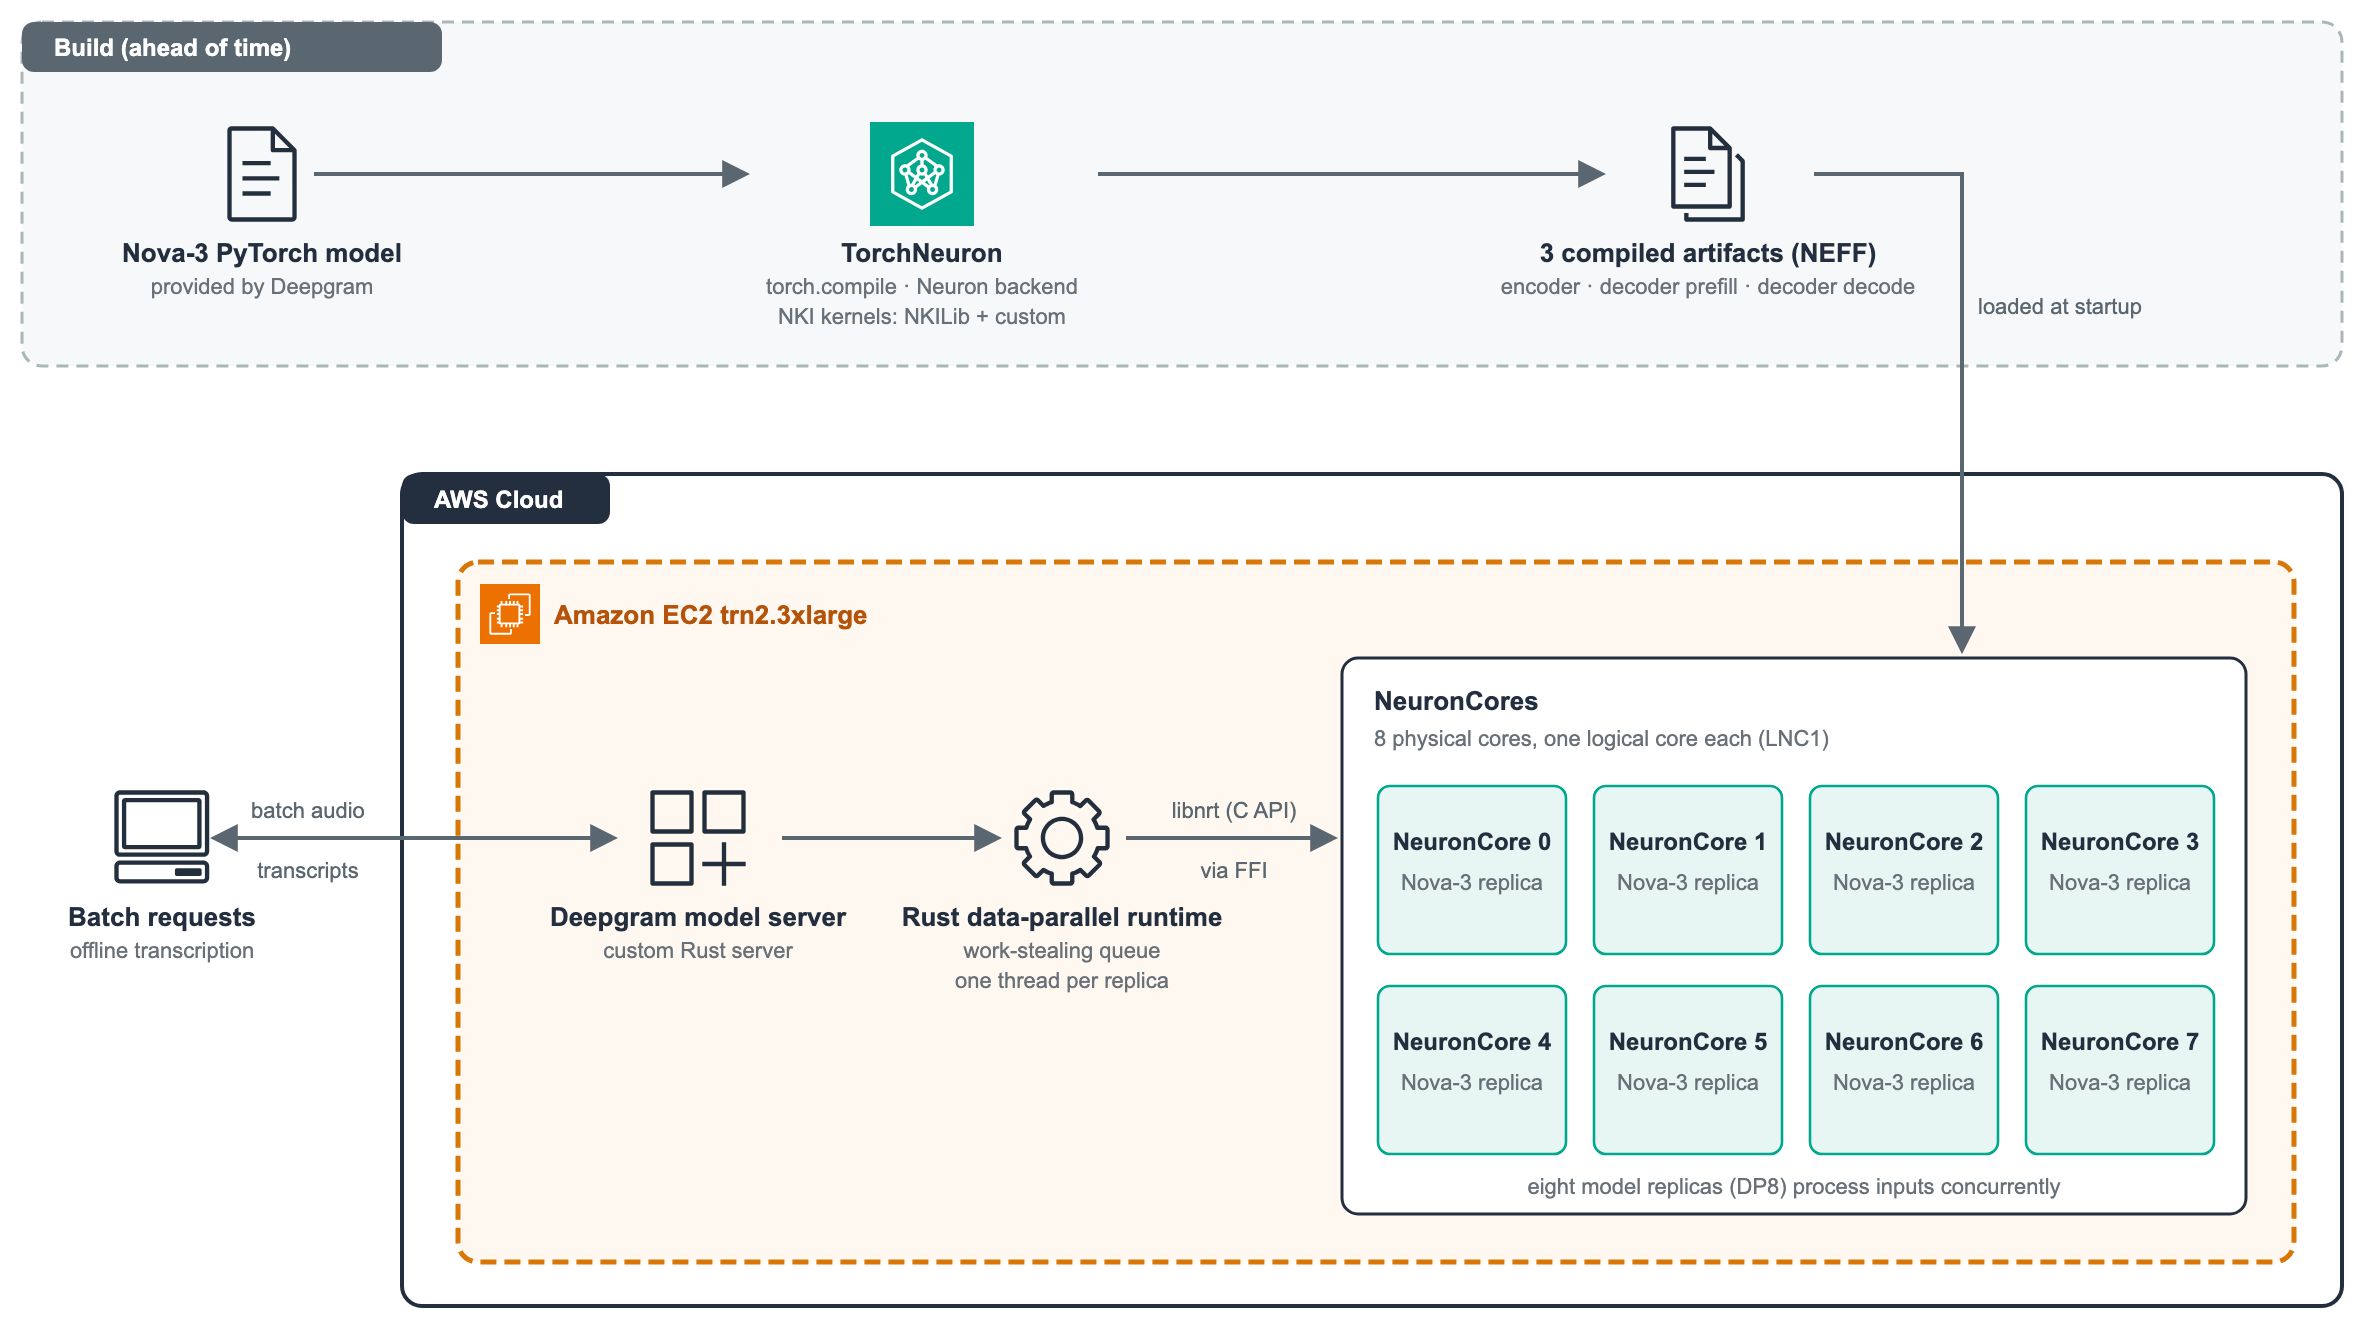
Abbildung 1: Deepgram Nova-3 auf AWS Trainium2, vorgebündelt und über Rust bereitgestellt
Kosteneinsparungseffekt
Wir maßen den Preis-Leistungs-Verhältnis als Audio-Prozess pro Dollar. Bei den offline, Durchsatz-orientierten Batch-Arbeitslasten von Deepgram hat die Einzelgerät-Setup-Trainium2 (trn2.3xlarge) 11–70 Prozent mehr Audio pro Dollar verarbeitet als die Berechnungsoptionen, die Deepgram betrieb.
Schlussfolgerung
In diesem Artikel haben wir gezeigt, wie Deepgram und die AWS FDE das Nova-3-Sprache-zu-Text-PyTorch-Modell auf Trainium-Hardware mit TorchNeuron portierten, was eine native Integration des PyTorch-Frameworks für AWS Trainium ermöglicht. Wir verbesserten die Leistung, indem wir die Schichten direkt durch vorgefertigte Kernels aus NKILib ersetzten. Anschließend wurden die Leistung mit Neuron Explorer bewertet und die Profiling-Fähigkeiten des Neuron Agentic Development (NAD) verwendet, um die Profilingdaten abzurufen und das Problemlösen der Leistung zu beschleunigen. Auf dieser Erkenntnis basierend, adaptierten wir den Quellcode des Kerns unter Verwendung der Fähigkeiten zur Kernel-Entwicklung von NAD. Schließlich entwickelten wir einen leichten Rust-Datenparallelspeicher-Runtime für AWS Trainium, der die Neuron-Runtime-API aus Rust aufruft. Unsere Umsetzung zeigte Einsparungen in Kosten im offline- und durchsatzorientierten Szenarien, was AWS Trainium als eine praktikable und effiziente Option für die Inferenzlasten von Deepgram bestätigt.
Um diese Methode an Ihren eigenen Modellen auszuprobieren, beginnen Sie mit der AWS Neuron-Dokumentation, die den Compiler, den Laufzeitprozess und unterstützte Frameworks behandelt. Die Neuron Kernel Interface (NKI)-Leitfaden erklärt, wie die in diesem Artikel beschriebenen Kernels geschrieben werden, und der NKI-Sample-Repository enthält die Referenzkernel, von denen wir ausgingen. Die Neuron-Entwicklungswerkzeuge-Dokumentation behandelt die Profilierung und agentische Werkzeuge, die wir hier verwendeten, einschließlich Neuron Explorer und Neuron Agentic Development. Für Größen und Preise siehe Amazon EC2 Trn2 Instances. Für Unterstützung bei der Planung einer ähnlichen Portierung kontaktieren Sie das AWS Forward Deployed Engineering.