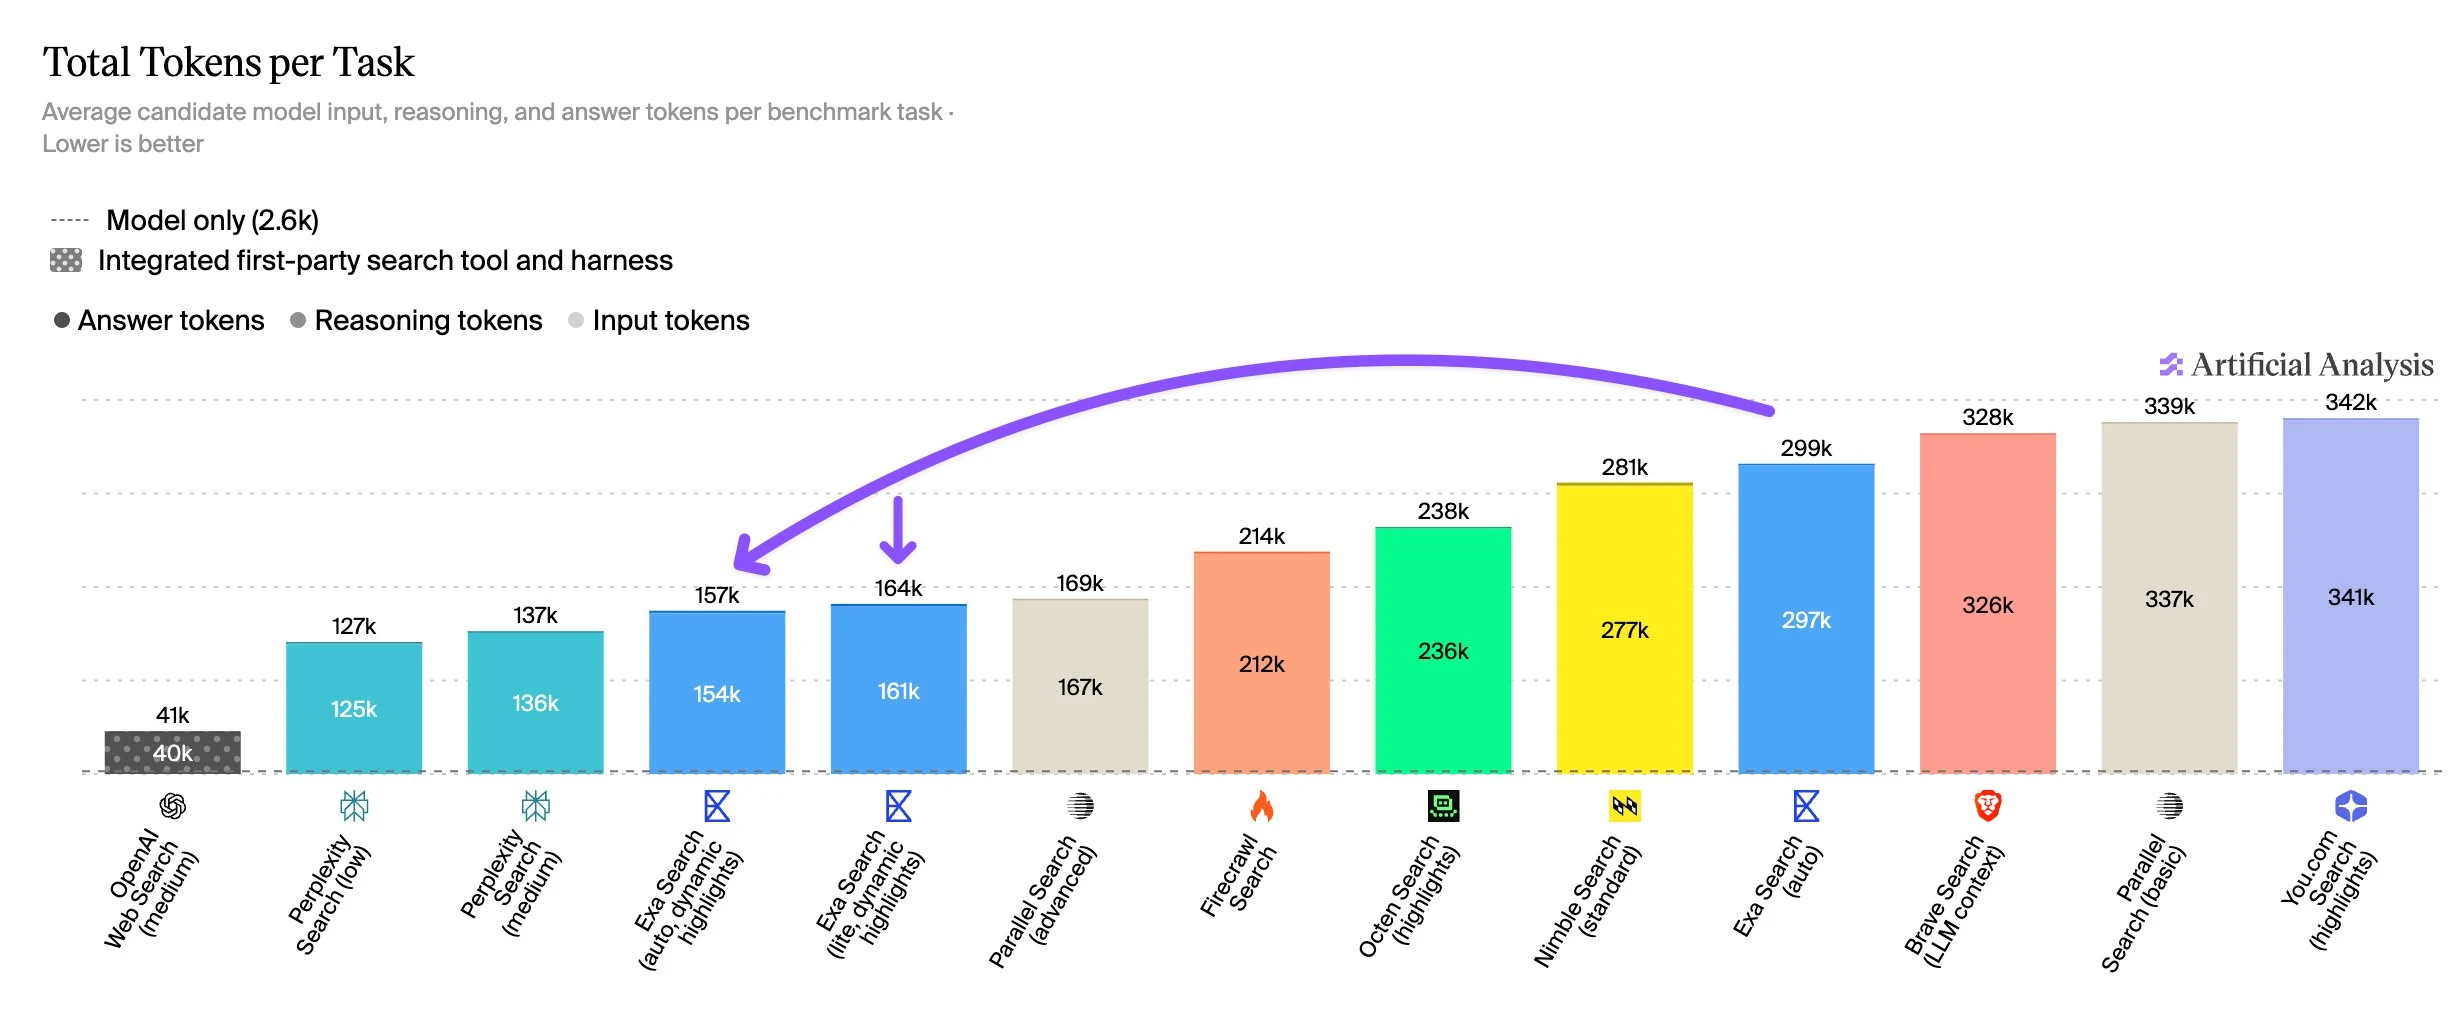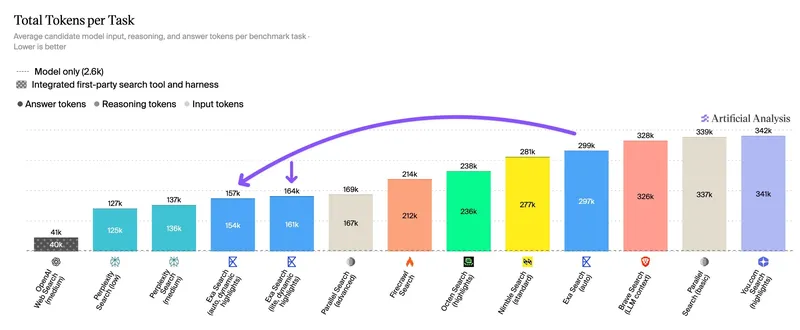
Die Gesamtzahl der Tokens pro Aufgabe misst die Anzahl der Input-Tokens, der Rechen-Tokens und der Output-Tokens des Modells
Exa (Auto, Dynamic Highlights) verwendet 157k Tokens pro Aufgabe, 47% weniger als Auto mit Standard-Highlights (299k). Exa (Lite, Dynamic Highlights) verwendet 164k Tokens, eine Reduzierung von 45%.
Die Dynamic Highlights reduzieren die Menge an Suchinhalten, die an das Modell übermittelt werden, und verringern somit den Tokenverbrauch sowie die Kosten für die Modellinferenz. Unter den Such-APIs verwenden nur Perplexity (niedrig, 127k) und Perplexity (mäßig, 137k) weniger Tokens pro Aufgabe.