
Bisher erforderte das Ändern der Anzahl der GPUs in einem vLLM-Dienst das Hinzufügen oder Entfernen ganzer Modellreplikate oder einen Neustart der Engine mit einer anderen GPU-Anzahl. Da Modelle immer größer werden, benötigt jedes Replikat mehr GPUs, sodass die Skalierung über Replikate GPUs in immer größeren Schritten hinzufügt oder entfernt. Der Neustart von vLLM, um DeepSeek V4 Pro von 16 auf 20 GB200-GPUs zu skalieren, unterbrach den Dienst für 197 Sekunden (siehe die Leistungsabschnitt Einzelheiten), wodurch diese teuren GPUs belegt bleiben, ohne Token zu generieren.
In unserem erster Elastic-EP-Beitrag, zeigten wir, wie vLLM GPUs zu einer laufenden DEP-Bereitstellung (datenparallele Aufmerksamkeit mit expertenparallelem MoE) hinzufügen oder daraus entfernen konnte, ohne sie neu zu starten. Obwohl wir einen Neustart vermieden, wurde der Dienst während der gesamten Neukonfiguration dennoch unterbrochen, da wir neue Worker initialisierten, die erweiterten Kommunikationsgruppen vorbereiteten, Modellgewichte luden und Kernel-Warmup sowie CUDA-Graph-Capture wiederholten. In unserem DeepSeek V4 Pro Benchmark dauerte diese Pause „100 Sekunden beim Skalieren von 16 auf 20 GPUs“ und 56 Sekunden beim Zurückskalieren auf 16 GPUs (weitere Details in der Leistungsabschnitt).
In diesem Beitrag beschreiben wir, wie die asynchrone Vorbereitung und NIXL EP aktivierte eine Elastic-EP-Rekonfiguration mit nahezu null Ausfallzeit. Im selben Benchmark reduzierten wir die Ausfallzeit auf 0,82 Sekunden beim Skalieren von 16 auf 20 GPUs und 1,96 Sekunden beim Zurückskalieren auf 16 GPUs, sodass wir nahezu ohne Auswirkung auf die Serving-Leistung hoch- und herunterskalieren können.
Überlappende Topologie-Vorbereitung mit Serving
Wir reorganisierten vLLMs Rekonfigurationsablauf in zwei Phasen: Hintergrundvorbereitung und ein kurzer Commit. Bestehende Worker verwenden separate Hintergrund-Threads, um die Zielkommunikation vorzubereiten und aufzuwärmen, Modellgewichte zu übertragen und ausführungsrelevante Informationen (wie Autotuning-Ergebnisse) mit beitretenden Workern zu synchronisieren, während sie weiterhin Anfragen mit ihren aktuellen Kommunikationsgruppen und CUDA-Graphen bedienen. Parallel dazu initialisieren sich beitretende Worker, empfangen Modellgewichte und bereiten ihre Kommunikation und GPU-Ausführung vor. Während der Commit-Phase pausiert vLLM kurz seine Scheduler, aktiviert die vorbereitete Topologie und nimmt das Serving wieder auf. Diese Änderungen wurden in asynchronous preparation und prepare/commit optimizations.
Die Vorbereitung umfasst vier Hauptaufgaben:
- Initialisierung beitretender Worker. Start ihrer Prozesse und Zuweisung von Speicher für das Modell und die Ausführung.
- Vorbereitung der Kommunikation. Richten Sie die Ziel-Kommunikationsgruppen ein und erweitern Sie den EP-Kommunikator.
- Modellgewichte übertragen. Übertragen Sie die erforderlichen Gewichte über NVLink oder RDMA von bestehenden Workern zu hinzukommenden Workern.
- Ausführung vorbereiten. Schließen Sie die erforderliche Kompilierung, Kernel-Warmup, Tuning-Einrichtung und CUDA-Graph-Erstellung auf den hinzukommenden Workern ab.
Nach der Commit-Phase ermöglicht asynchrones Expert Parallel Load Balancing (EPLB), dass neue Worker beginnen, Attention zu verarbeiten, während bestehende Worker die Expertenberechnung übernehmen. EPLB verteilt dann die Experten im Hintergrund über die erweiterte Gruppe neu.
Die größte Herausforderung besteht darin, Kommunikation und GPU-Ausführung vorzubereiten, ohne die Worker, die Anfragen bedienen, einzubeziehen oder zu stören.
EP-Kommunikation in-place erweitern
Vor NIXL EP verwendeten die in vLLM verfügbaren EP-Kommunikations-Backends eine feste Mitgliedschaft: Jede Instanz wurde für einen bestimmten Satz von Ranks erstellt. Das Hinzufügen oder Entfernen von Ranks erfordert eine neue Instanz. Selbst wenn diese Instanz im Hintergrund erstellt werden kann, verbleiben zwei Probleme.
Erstens benötigen die alte und die neue Instanz separate Kommunikationspuffer und andere Ressourcen, einschließlich Speicherregistrierungen, IPC-Handles und RDMA Queue Pairs (QPs). Das gleichzeitige Halten beider Instanzen erhöht den Kommunikationsspeicherverbrauch und erfordert eine Wiederholung der Einrichtung, anstatt bestehende Ressourcen wiederzuverwenden.
Zweitens ändert der Wechsel des EP-Kommunikators die Puffer und den Kommunikationszustand, die von den EP-Kommunikationskernels verwendet werden. Dadurch werden zuvor aufgenommene CUDA-Graphen ungültig, die erneut aufgenommen werden müssen, bevor der Dienst fortgesetzt werden kann. Das erfordert eine Wiederholung von Warmup und Graph-Erstellung für viele Batch-Formen auf allen erhaltenen Workern. In unserem DeepSeek V4 Pro Benchmark führte die Durchführung von Warmup und erneuter Graph-Aufnahme während der Commit-Phase – selbst mit asynchroner Vorbereitung – zu Dienstunterbrechungen von 58 Sekunden beim Scale-up und 44 Sekunden beim Scale-down.
Um diese Probleme zu lösen, haben wir NIXL EPentworfen, eine EP-Kommunikationsbibliothek, die maßgeschneidert für Elastic EP ist. Sie fügt Ranks in-place hinzu oder entfernt sie und verwendet dabei denselben NIXL-Agent, dieselben Puffer und Verbindungen wieder. Neue Peers können verbunden werden, während bestehende Worker weiter Dienste bereitstellen, und nur hinzukommende Peers benötigen neue Verbindungen und Registrierungen. NIXL EP hält außerdem die aufgenommenen EP-Dispatch- und Combine-Einträge über Rekonfigurationen hinweg gültig, sodass erhaltene Worker ihre vorhandenen CUDA-Graphen wiederverwenden können.
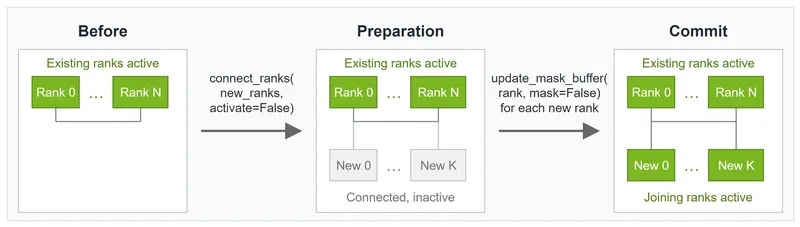
Während der Vorbereitung verbindet vLLMs Hintergrund-Thread beitretende Peers, ohne sie zu aktivieren. In der Commit-Phase werden dann die vorbereiteten Peers aktiviert, ohne den Kommunikator zu ersetzen.
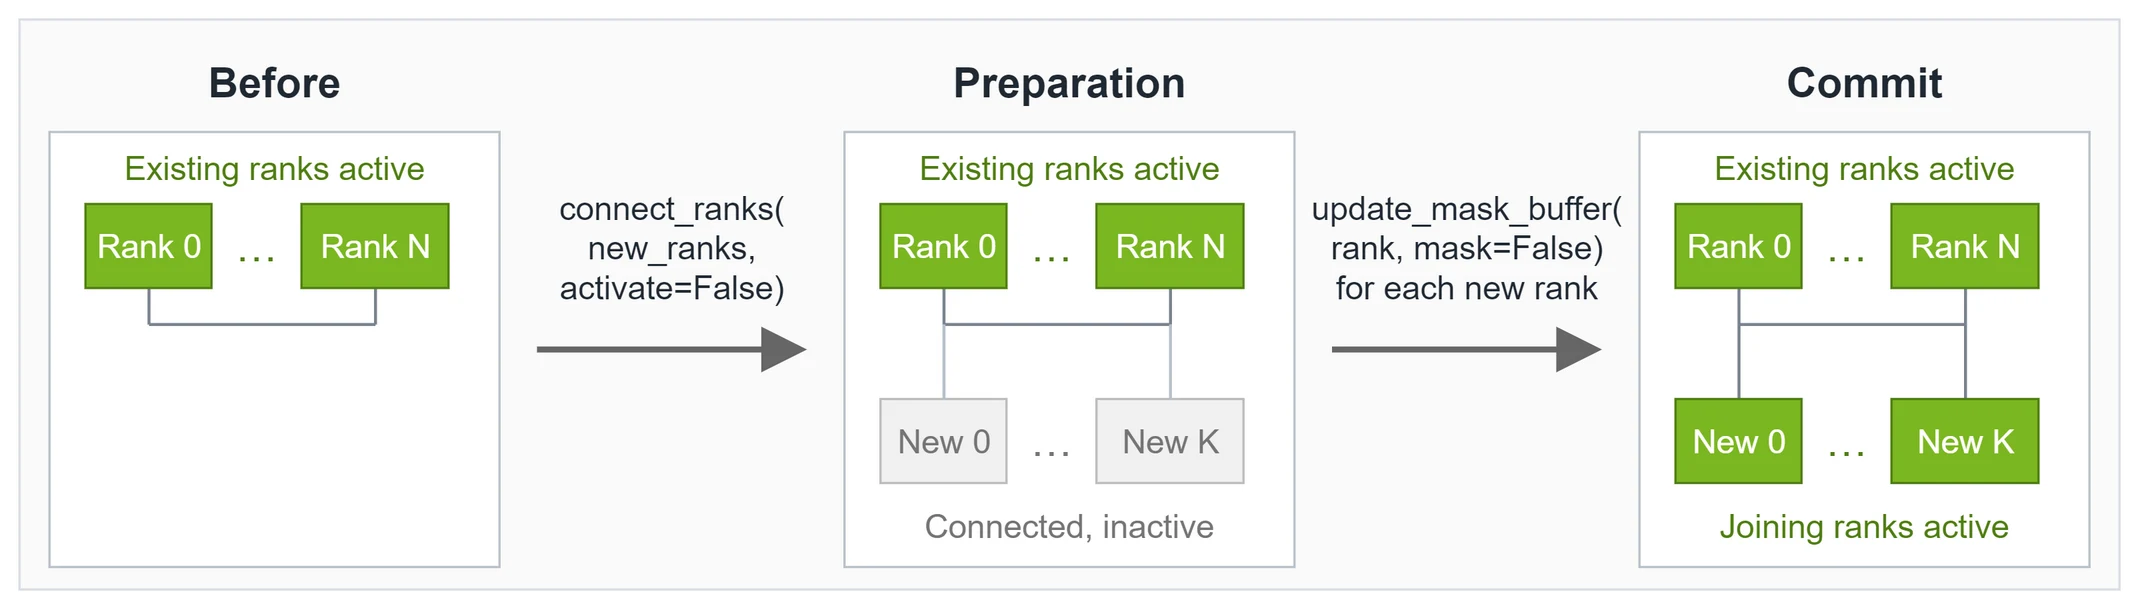
Abbildung 1. Verbinden und Aktivieren neuer EP-Peers. Grüne Ranks sind aktiv; graue Ranks sind verbunden, aber maskiert. Während der Commit-Phase werden neue Peers aktiviert, ohne den Agenten oder die Puffer zu ersetzen.
vLLM erstellt weiterhin neue DP-Koordinationsgruppen und EPLB-Gruppen für die Zieltopologie, aber ihre Kommunikation läuft außerhalb des erfassten Modell-Forward-Pass, sodass ein Wechsel zu ihnen CUDA-Graphen nicht ungültig macht.
CUDA-Graphen auf vorhandenen Workern beibehalten
Ein CUDA-Graph zeichnet GPU-Operationen auf, sodass vLLM einen Forward-Pass wiedergeben kann, ohne jede Operation wiederholt von der CPU aus zu starten. Ein erfasster Kernel-Knoten enthält seine Launch-Konfiguration und Argumentwerte, einschließlich Zeigern auf Input- und Output-Tensoren. Speicherinhalte können sich zwischen Wiedergaben ändern, aber die aufgezeichneten Zeiger müssen gültig bleiben. Diese Anforderungen sind Teil der CUDA-Graph-Ausführungsvertrag.
vLLM erfasst separate Diagramme für verschiedene Batch-Formen und Ausführungsmodi und führt Warmup-Forward-Passes vor jeder Aufzeichnung durch.
Das Bewahren aufgezeichneter CUDA-Graphen erfordert mehr, als nur das Kommunikator-Objekt am Leben zu erhalten. NIXL EP hält auch Kernel-Startkonfigurationen, für Graphen sichtbare Kommunikationsargumente sowie Eingangs- und Ausgangstensor-Adressen über Rekonfigurationen hinweg stabil. Seine Kernel lesen die aktive Gruppenmitgliedschaft aus einem Gerätestatus, der an Ort und Stelle aktualisiert werden kann.
Wir haben außerdem vLLM so geändert, dass die aufgezeichneten Argumente, Startkonfigurationen sowie Eingangs- und Ausgangstensor-Adressen der umgebenden Compute-Kernel über Rekonfigurationen hinweg stabil bleiben:
- Wir verwenden die fused-MoE-Ausführungsobjekte der erhaltenen Worker wieder, statt sie für eine andere aktive EP-Größe neu aufzubauen.
- Wir halten die Adressen und Layouts der für Graphen sichtbaren Workspaces und Dispatch-Ausgaben über Rekonfigurationen hinweg stabil, damit aufgezeichnete Expert-Kernel sie weiter verwenden können. Dispatch-Ausgaben dienen auch als Eingaben für die Expert-Berechnung. Würden sich ihre Adressen oder Layouts mit der EP-Größe ändern, würden aufgezeichnete Expert-Kernel weiterhin die alten Zeiger und Offsets verwenden.
- Wir bewahren den zugrunde liegenden Speicher der Expert-Routing-Tensoren und aktualisieren die Zuordnungen an Ort und Stelle. Dies ermöglicht EPLB, die Zuordnungsinhalte zu ändern, ohne die von aufgezeichneten Kerneln verwendeten Tensoren zu verschieben.
Zusammen ermöglichen diese Änderungen den erhaltenen Arbeitern, ihre bestehenden CUDA-Graphen sowohl nach Hoch- als auch nach Herunterskalierung wiederzuverwenden.
Beitretende Worker unabhängig vorbereiten
Bestehende Worker haben Graphen zu bewahren. Beitretende Worker haben keine.
Beitretende Worker bereiten sich normalerweise vor, indem sie Modell-Forward-Passes mit EP-Dispatch und -Combine ausführen sowie Batch-Informationen mit anderen Workern austauschen. Diese Schritte erfordern die Teilnahme anderer Worker, doch bestehende Worker bedienen bereits echte Anfragen auf der aktuellen Topologie.
NIXL EP ermöglicht es jedem beitretenden Worker, während des Warmups und der Graphenvorbereitung vorübergehend jeden entfernten EP-Peer zu maskieren. Nur der lokale Rang dieses Workers ist für die EP-Kommunikation aktiv. Wir haben zudem vLLM so angepasst, dass diese Vorbereitungspasses nicht auf DP-Batch-Informationen von anderen Workern warten. So können beitretende Worker ihre Dummy-Batches ausführen und CUDA-Graphen aufzeichnen, ohne dass bestehende Worker teilnehmen müssen.
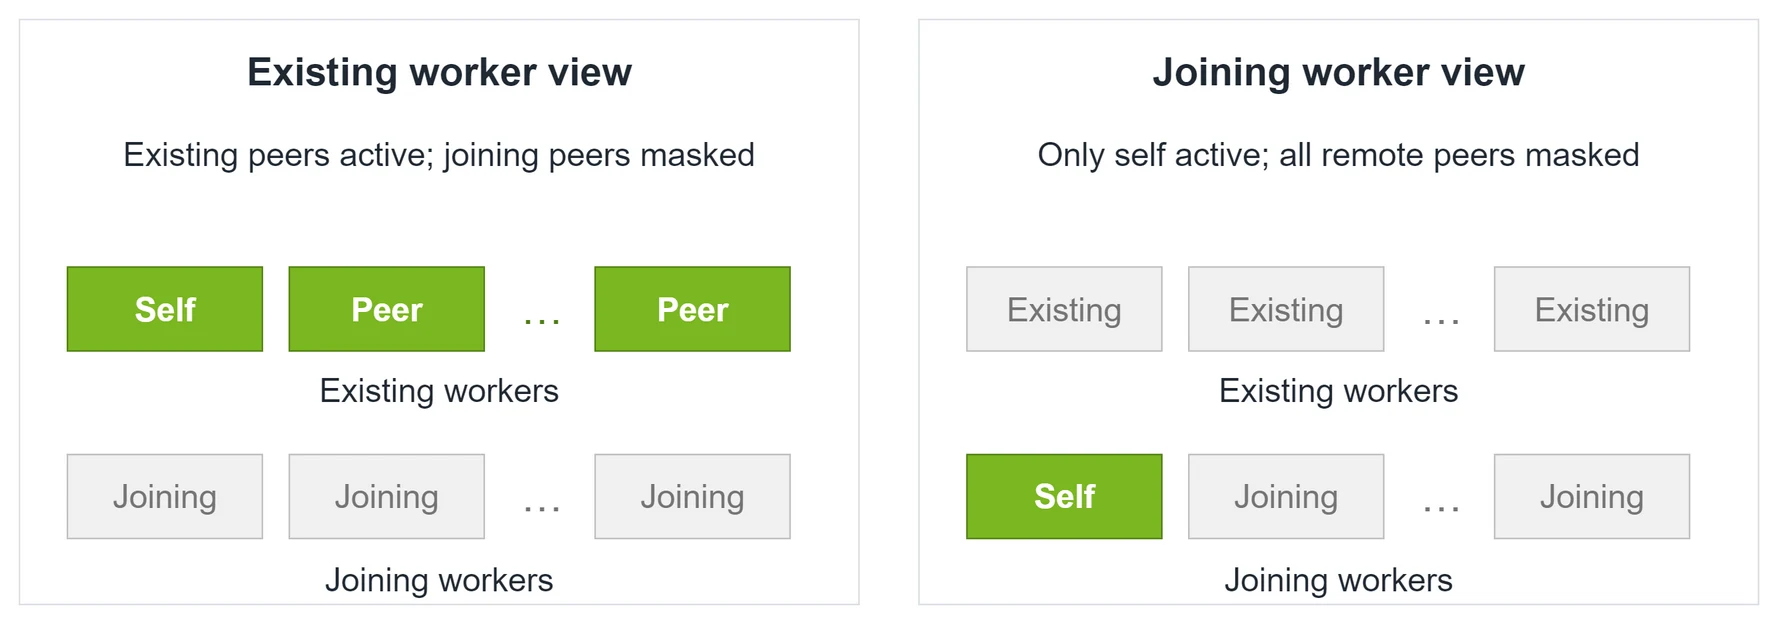
Abbildung 2. Grüne Ränge sind für die EP-Kommunikation aktiv; graue Ränge sind maskiert. Bestehende Worker dienen gemeinsam, während jeder beitretende Worker alle entfernten EP-Peers zur Vorbereitung maskiert.
Nach der Aufzeichnung kann NIXL EP die Peers reaktivieren, ohne die Graphen zu ungültig machen. Beitretende Worker verwenden ihre lokal aufgezeichneten Graphen wieder, wenn sie als Teil der erweiterten Gruppe zu dienen beginnen.
Leistung auf DeepSeek V4 Pro
Alle Experimente in diesem Abschnitt verwendeten DeepSeek V4 Pro auf GB200-GPUs mit TP=1 und DP/EP-Größen von 16 und 20. Die Modellgewichte wurden im safetensors-Format vorgeladen auf gemeinsam genutztem Lustre-Speicher abgelegt und mit der Standardmethode geladen --load-format auto. Die Messungen verwendeten warme Kernel-Kompilierungscaches (Triton, TileLang und FlashInfer).
Hoch- und Herunterskalierungs-Zeitpunkte
Die Tabelle zeigt, welche Stufen ausgeführt werden, während die Bereitstellung pausiert ist, und welche im Hintergrund ausgeführt werden, während bestehende Worker weiter bereitstellen.
| Stufe | A: Blockierend | B: Asynchrone Vorbereitung | C: Asynchrone Vorbereitung + Graph-Wiederverwendung |
|---|---|---|---|
| Beitretende Worker initialisieren | Bereitstellung pausiert | Hintergrund | Hintergrund |
| Zielkommunikation vorbereiten | Serving pausiert | Hintergrund | Hintergrund |
| Modellgewichte übertragen | Serving pausiert | Hintergrund | Hintergrund |
| Warmup und Graph-Erfassung auf beitretenden Workern | Serving pausiert | Serving pausiert | Hintergrund |
| Warmup und Graph-Erfassung auf bestehenden Workern | Serving pausiert | Serving pausiert | Nicht erforderlich (bestehende Graphen bleiben gültig) |
| Die Ziel-Topologie aktivieren | Serving pausiert | Serving pausiert | Serving pausiert |
Konfiguration C wird unterstützt nur von NIXL EP.
- Ausfallzeit: die beobachtete Serving-Unterbrechung, wenn laufende Anfragen nicht mehr voranschreiten und neue Anfragen nicht angenommen werden.
- Gesamtzeit: die Dauer des gesamten Skalierungsvorgangs, einschließlich der Vorbereitung.
Die beiden Zeiträume werden separat gemessen.
| Metrik | A: Blockierend | B: Asynchrone Vorbereitung | C: Asynchrone Vorbereitung + Graph-Wiederverwendung |
|---|---|---|---|
| 16 zu 20 GPUs: Ausfallzeit | 99.62 s | 58.04 s | 0.82 s |
| 20 auf 16 GPUs: Ausfallzeit | 56.25 s | 44.07 s | 1.96 s |
| 16 auf 20 GPUs: Gesamtzeit | 99.72 s | 97.27 s | 92.34 s |
| 20 auf 16 GPUs: Gesamtzeit | 56.21 s | 51.46 s | 9.32 s |
Alle Konfigurationen bestanden die numerischen Korrektheitsprüfungen, einschließlich Prüfungen auf jedem beitretenden Worker.
Aufrechterhaltung des SLO beim Hinzufügen von GPUs
Wir bedienten DeepSeek V4 Pro auf 16 GPUs und erhöhten dann schrittweise die eingehende Anforderungsrate von etwa 8 auf 16 Anforderungen pro Sekunde. Wir spielten dasselbe Szenario mit 11,391 Anforderungen gegen drei Bereitstellungen ab: eine blieb bei 16 GPUs, eine startete mit 20 GPUs neu, und eine skalierte mit Elastic EP mit NIXL EP auf 20 GPUs. Das Service-Level-Ziel (SLO) war ein rollierender p95-Zeit bis zum ersten Token unter 5 Sekunden.
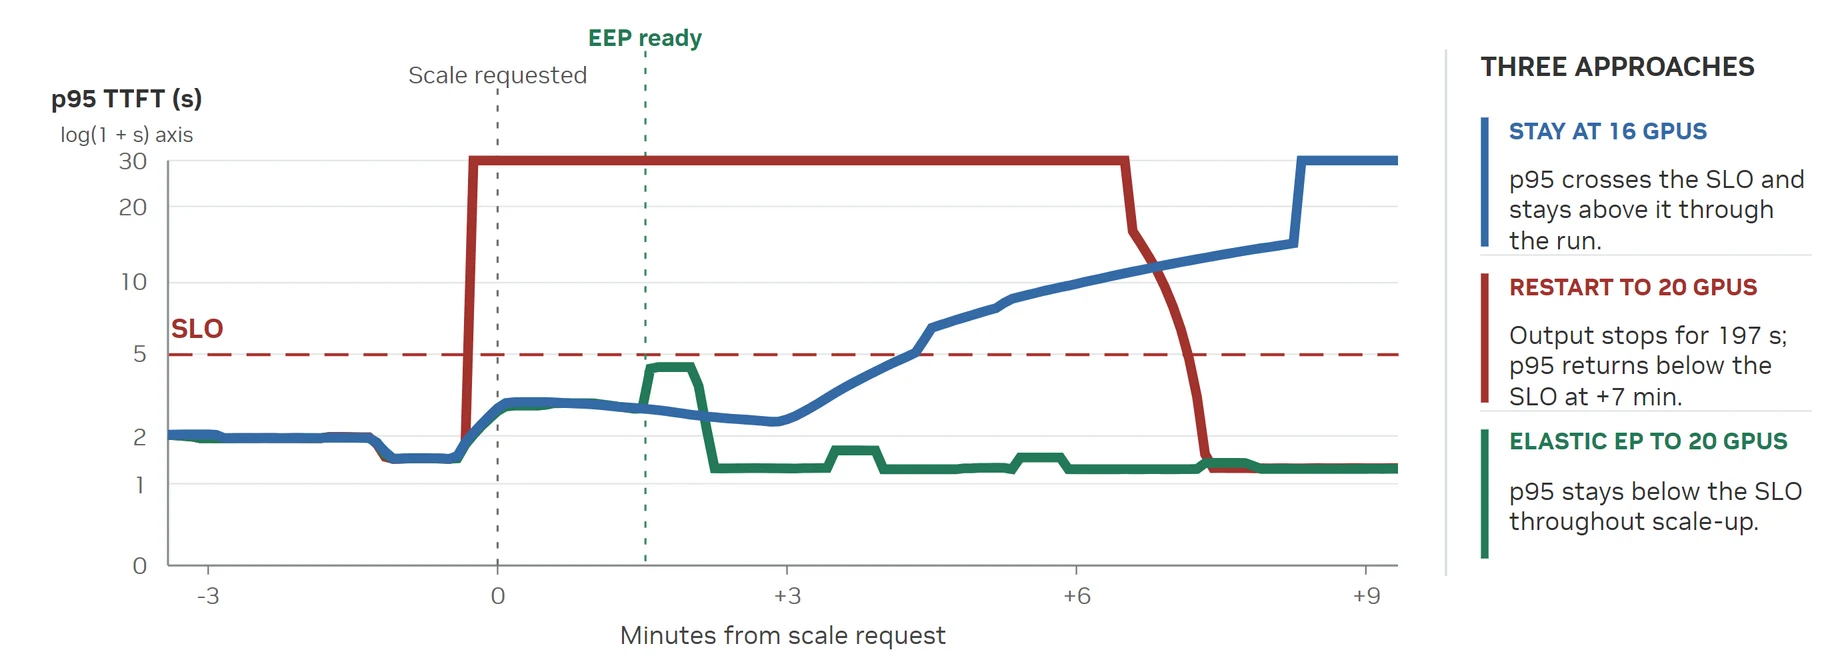
Abbildung 3. End-to-End-Bereitstellung unter steigender Anforderungslast. Die Kurven zeigen 30-Sekunden-rollierende p95-Ergebnisse, wobei fehlgeschlagene Anforderungen eine 30-Sekunden-Strafe statt eines gemessenen TTFT erhalten.
- Elastic EP bearbeitete alle 11,391 Anforderungen und blieb während des gesamten Szenarios unter dem SLO.
- Während der Vorbereitung entsprach Elastic EP der Bereitstellungsleistung der statischen Bereitstellung mit 16 GPUs, ohne sichtbare Verschlechterung durch die Hintergrundvorbereitung.
- Nach der Skalierung entsprach Elastic EP der Leistung der wiederhergestellten Bereitstellung mit 20 GPUs, ohne sichtbare Verschlechterung nach der Skalierung.
Elastic EP ausprobieren
Hintergrundvorbereitung, Wiederverwendung von CUDA-Graphen und unabhängige Graphenerfassung auf beitretenden Workern sind heute alle in den neuesten vLLM - und NIXL -Veröffentlichungen verfügbar. Installieren Sie sie mit pip und beginnen Sie, Elastic EP zu verwenden.
Ein vollständiges Verwendungsbeispiel finden Sie im cuda_graphs_heavy_nixl_ep Fall in vLLMs Elastic-EP-Test. Das Beispiel enthält die Serverkonfiguration und die Skalierungs-API-Aufrufe. Es skaliert von zwei GPUs auf vier und zurück, während Anforderungen gesendet werden, und prüft die Bereitstellung während der Vorbereitung sowie die Modellgenauigkeit um jede Größenänderung.
Was kommt als Nächstes
Warme Worker mit Dynamo Snapshot wiederherstellen
Wir haben die lange Bereitstellungsunterbrechung effektiv gelöst. Die nächste Herausforderung ist es, neue Kapazität früher bereitzustellen. Wir planen zu integrieren Dynamo-Snapshot so dass beitretende Worker den initialisierten Prozess- und CUDA-Zustand wiederherstellen können, anstatt Kompilierung, Kernel-Aufwärmphase, Graph-Erstellung und andere Startarbeiten zu wiederholen.
Die Kommunikation für die Ziel-Topologie muss separat vorbereitet werden, da sie nicht aus dem Snapshot wiederhergestellt wird. Die Wiederherstellung großer Modellgewichte aus dem Checkpoint-Speicher kann die Wiederherstellungszeit dominieren, daher planen wir, die GPU-zu-GPU-Gewichtsübertragung von Elastic EP von bestehenden Workern beizubehalten.
State-of-the-art-EP-Kommunikation mit NIXL EP erreichen
Wir streben mit NIXL EP eine State-of-the-art-Dispatch- und Combine-Leistung an und erhalten dabei die volle Unterstützung für Elastic EP und Fehlertoleranz. Ein bevorstehendes NIXL-EP-Leistungsupdate ist der nächste Schritt in Richtung dieses Ziels (siehe die NIXL-EP-Roadmap-RFC).
Elastic EP mit der Dynamo- und llm-d-Orchestrierung verbinden
Da die Engine-Level-Fähigkeit vorhanden ist, besteht der nächste Schritt darin, Elastic EP aus Orchestrator-Autoscalern zu nutzen. Die Arbeit an dieser Integration läuft bereits in den Communities von vLLM, Dynamo und llm-d.
Diese Bemühungen umfassen vLLMs Arbeit an einem externen Lastverteiler und Dynamics Elastic-EP-Vorschlag.
Wenn Sie Inferenz im großen Maßstab betreiben, ermutigen wir Sie, Elastic EP auszuprobieren und uns Ihre Workloads und operativen Anforderungen mitzuteilen. Wenn Sie Inferenz-Infrastruktur aufbauen, freuen wir uns über Beiträge zu vLLM Elastic EP und NIXL EP. Bringen wir Elastic EP in den Produktivbetrieb.
Danksagungen
- Tyler Michael Smith und Sage Moore von Red Hat für ihr unschätzbares Feedback und ihre gründlichen Reviews während dieser Arbeit.
- Linoy Geva (NVIDIA) für ihre Arbeit an der Serving-Performance während der Vorbereitung.
- Das gesamte NIXL-Team für seine Bemühungen rund um NIXL EP.
- Tzu-Ling Kan, Julien Mancuso und das gesamte Dynamo-Team für ihre Bemühungen, Elastic EP in Dynamo zu unterstützen.