
TorchNeuron bietet einen neuen nativem Backend für PyTorch auf AWS Trainium. Transformers, Diffusers und Kernels unterstützen ihn nativ, was es ermöglicht, Modelle auf Trainium zu ausführen und sie auf dem HF-Hub zu teilen – einfacher als je zuvor.
TorchNeuron
TorchNeuron ist ein PyTorch-Plugin, der einen neuen Backend für Trainium bereitstellt und die Unterstützung für den Eager-Mode, torch.compile sowie native verteilte APIs wie FSDP und TP ermöglicht.
Lesen Sie den Blog von PyTorch, um mehr über TorchNeuron zu erfahren.
Ab dem 20. Oktober 2026 wird TorchNeuron als öffentliche Beta-Version verfügbar sein. Forscher und Entwickler können es mit pip install torch-neuronx installieren.
Neuer Backend, native Interface in HF-Libraries
Bis heute wurde die Hugging Face-Erfahrung auf AWS Trainium und Inferentia – AI-Chips, die jeweils für kosteneffizientes Training und Inference in großem Maßstab entwickelt wurden – über optimum-neuron bereitgestellt. Diese Bibliothek beruht auf dem torch-neuronx-Paket, das auf PyTorch XLA basiert. Es war damals die natürliche Wahl, aber es bedeutete, wie ein Compiler zu denken: lassende Tensoren anstelle von eager Ausführung, nur statische Formen und eine erneute Kompilierung bei jeder Graph-Brücke. Optimum Neuron existierte, um diese Komplexität zu verbergen, und enthielt dazu eigene Code (Modellklassen, Trainer usw.).
TorchNeuron ändert dies. Es wird direkt in PyTorch integriert und macht neuron zu einem nativen Gerät mit Eager- Ausführung, den eigenen distribuierten Primitiven von PyTorch (DTensor, FSDP2) sowie torch.compile zugänglich.
Für die Hugging Face-Libraries ist Trainium wie jedes andere Gerät: Transformers, Diffusers, Accelerate, PEFT und TRL laufen direkt darauf, mit denselben Klassen und Skripten, die man bei any other accelerator verwenden würde. Von nun an empfehlen wir den Nutzern von Neuron, diese Bibliotheken direkt zu verwenden, anstatt durch Optimum Neuron zu gehen.
Transformers
Inference
Die Textgenerierung wird nun nativ von Transformers für eine breite Palette von Modellen unterstützt. Mit TorchNeuron werden 89% der 100 am häufigsten verwendeten Architekturen für Textgenerierungsmodelle direkt unterstützt, im Vergleich zu 46% bei Optimum Neuron v0.4.5. Sie müssen nur den device_map=neuron Parameter in Ihrem Code einsetzen, sodass Ihr Modell auf die Neuron-Geräte umgelegt wird.
Der folgende Text ist ein Beispiel für die Textgenerierung mit Tensor-Parallelschaltung, die es ermöglicht, vollständig von Ihrer Neuron-Instanz zu profitieren. Bitte beachten Sie, dass eine statische Cache für die Generierung verwendet wird, da dies bei Neuron stark empfohlen wird, um häufige Rekompilierungen zu vermeiden.
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
>Trainierung
Da Neuron ein nativem PyTorch-Gerät ist, verwendet das Training auf Trainium dieselben Hugging Face-Bibliotheken wie jeder andere Accelerator: Transformers, Accelerate, PEFT und TRL. Sie benötigen keine spezielle Trainer oder eine für Neuron spezifische Version des Modellcodes mehr. Ein standardmäßiger TRL-Fine-tuning-Skript läuft auf einer Trainium-Instanz mit nur wenigen für Neuron spezifischen Einstellungen.
Hier ist ein überwachter Fine-Tuning-Skript, das auf TRLs SFTTrainer basiert. Wenn Sie zuvor ein Modell mit TRL auf GPUs gefine-tuned haben, sollte es Ihnen bekannt vorkommen.
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
Der Parallellismus wird nativ von Transformers behandelt. Man fügt eine DistributedConfig mit den Größen für die Tensor-Parallelität (TP) und FSDP in model_init_kwargs ein, SFTTrainer übermittelt sie an from_pretrained, und das Modell wird in Schichten aufgeteilt, während seine Gewichte geladen werden. Der Trainer erkennt, dass das Modell bereits verteilt ist, und wickelt es nicht erneut um. Es ist nicht notwendig, das --fsdp-Flag oder eine Config für den Accelerate FSDP zu verwenden.
Nichts im Skript ist an Trainium gebunden: derselbe Code funktioniert auf jedem Hardware. Einige Dinge sind wichtig zu wissen, wenn man ihn auf Trainium ausführt:
- Statische Formen. Der Skripte deaktiviert automatische dynamische Formen in
torch.compileund verwendet verpackte Strukturen, um Sequenzen bis zu 2048 Tokens zu erzeugen. Bei TRL ≥ 1.16 werden Batch auf Neuron auf eine multiple von 128 Tokens ausgelegt, was die Anzahl der Eingangsformen einschränkt. Kompilierte Graphen werden für folgende Schritte mit denselben Formen wieder verwendet. torch.compileaktiv. Es reicht aus,--torch_compile truezu senden: Bei einer Trainium-Instanz erkennttorch.compiledas Gerät und wählt automatisch den Neuron-Backend aus, ohne weitere Konfigurationen erforderlich.- Async Gewichtsladen deaktiviert. Die integrierte asynchrone Gewichtsladen-Funktion in Transformers wird auf Neuron nicht unterstützt, daher deaktivieren wir sie vorerst mit
HF_DEACTIVATE_ASYNC_LOAD=1.
Der untere Befehl startet das Training mit torchrun, wobei pro NeuronCore ein Prozess gestartet wird. TP_SIZE und FSDP_SIZE bestimmen die Parallelitätseinrichtung, und ihr Produkt ergibt die Anzahl der Prozesse: hier ist 4 x 8 = 32, was --nproc_per_node entspricht. Die 32 Prozesse bilden eine 4 x 8-Grid-Struktur. Die Tensor-Parallelität teilt jede Schicht auf die 4 Kerne einer TP-Gruppe auf, und FSDP verteilt die Parameter, Gradienten und Optimierer-Zustand auf die 8 TP-Gruppen.
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
Wir haben es auf 8 Trainium2-Chips (32 NeuronCores) ausgeführt, was die Hälfte einer trn2.48xlarge-Instanz ist.
Die Trainingsrunde ist abgeschlossen, und trainer.save_model schreibt einen Standard-Transformers-Checkpoint. Nichts darin ist mit Neuron verbunden: Sie können ihn einfach auf den Hugging Face Hub hochladen und auf any other Hardware laden.
Diffusers
Inference
Viele Pipeline-Algorithmen aus der Diffusers-Bibliothek sind in Eager- und kompilierten Modus mit TorchNeuron kompatibel. FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 und H3 sind ebenfalls mit Tensor-Parallelität kompatibel, um das Beste aus Ihren Neuron-Deviceen herauszuarbeiten. Im Folgenden findet sich ein Beispiel, wie Sie TP verwenden können:
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
Sie können diesen Code mit folgender Anweisung ausführen: NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py.
Immer mehr Pipelines werden mit TP kompatibel sein. Wenn ein gewünschter Pipeline nicht kompatibel ist, können Sie auch die Unterstützung für ihn hinzufügen, nachdem Sie diesen Leitfaden verwendet haben.
Kernels
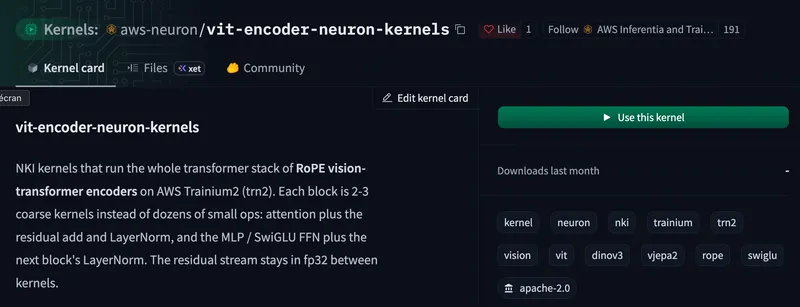
Bitte besuchen Sie die Kernen der Neuron-Team, da immer mehr Neuron-Kerne auf dem Hub verfügbar werden, um Ihre Modelle zu beschleunigen. Neuron-Kerne können mit der Neuron Kernel Interface (NKI) erstellt werden, wodurch eine geringere Kontrolle über die Optimierung der Operationen gegeben ist. Auf diese Weise können Benutzer eigene benutzerdefinierte Operationen ausführen und sie auf dem Hub teilen.
Sie können beispielsweise diesen Kernel verwenden, um Ihre Vision-Transformers zu beschleunigen – bis zu einer Geschwindigkeitssteigerung von 2,4 auf Trainium!

Danksagungen
Besonderer Dank an das AWS-Team für seine Arbeit an TorchNeuron und für seine Reaktivität auf unsere Rückmeldungen, damit die HF-Integration so gut wie möglich ist.