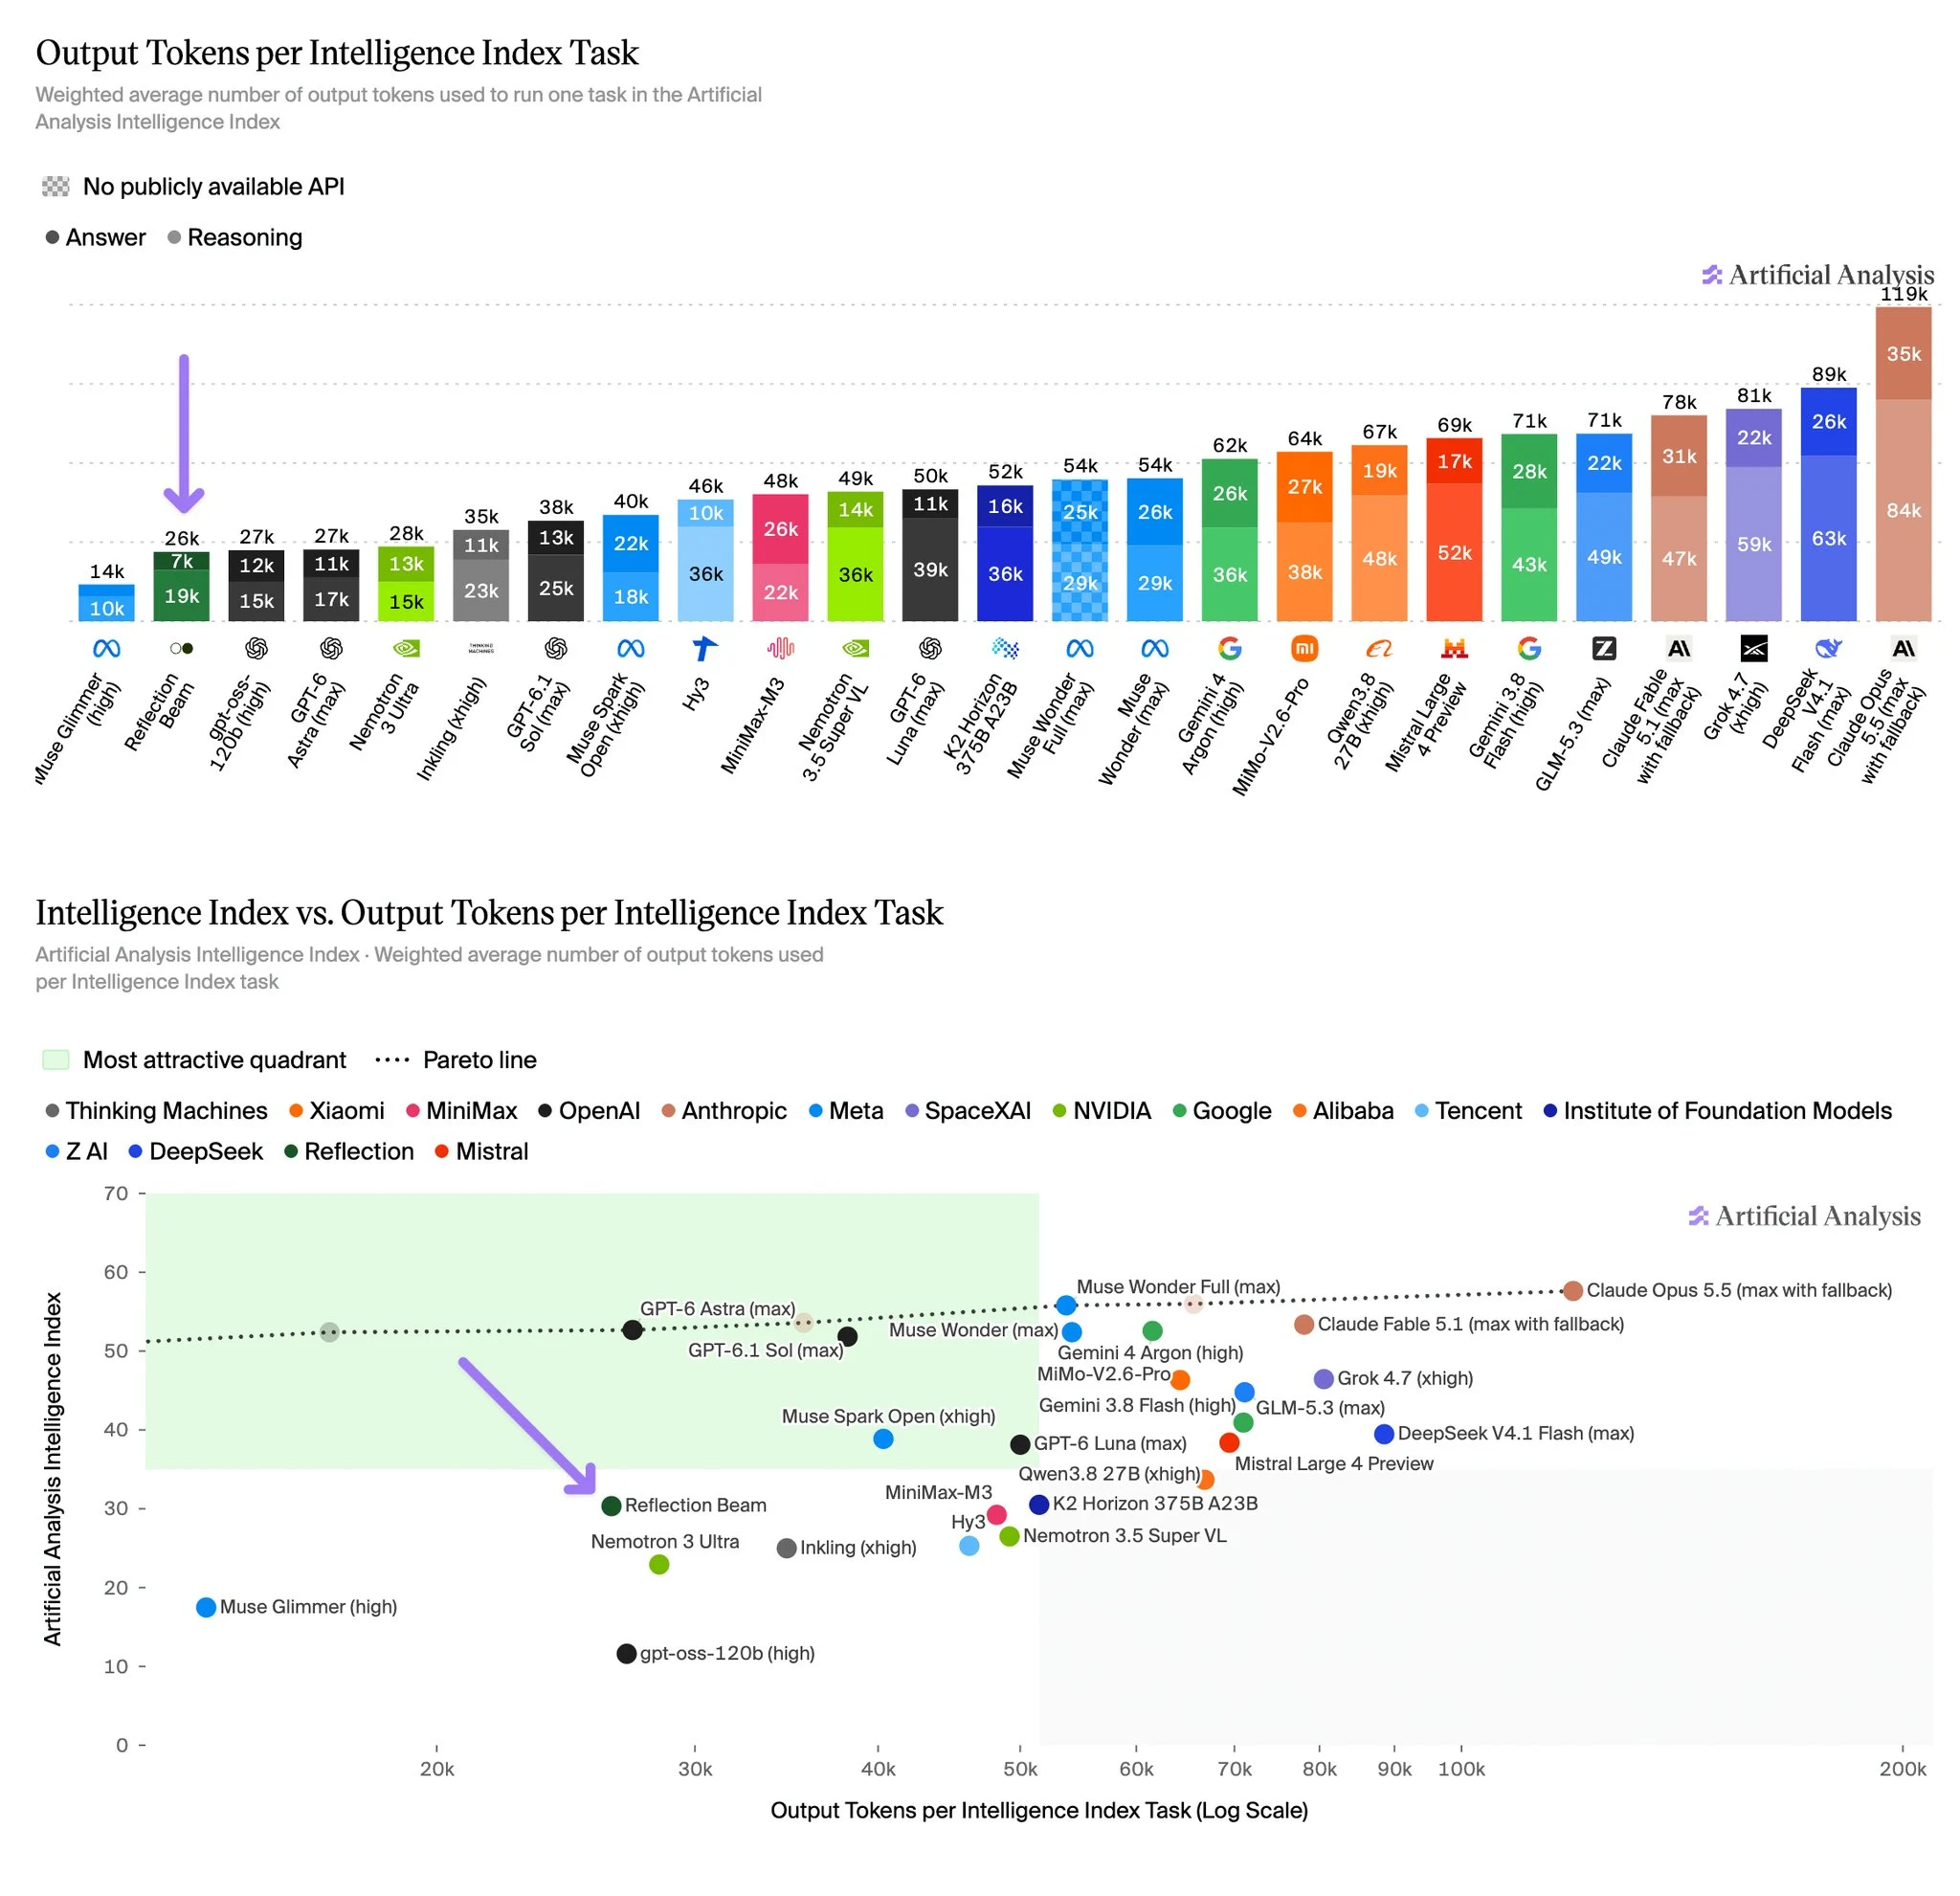
Beam verbraucht ~26k Output-Tokens pro Intelligence-Index-Aufgabe: ~19k für das Reasoning und ~7k für die Antworten. Nur 26% seines Outputs gehen in die endgültigen Antworten, der 28.-niedrigste Anteil von 219 Modellen, die auf Intelligence Index v4.3 getestet wurden