
KI-Labore haben ihren Ruf aufs Spiel gesetzt für das Model-Benchmarking – das angeblich neutrale und genaue System von Evaluierungen, das darauf ausgelegt ist zu messen, ob ein KI-Produkt besser ist als ein anderes.
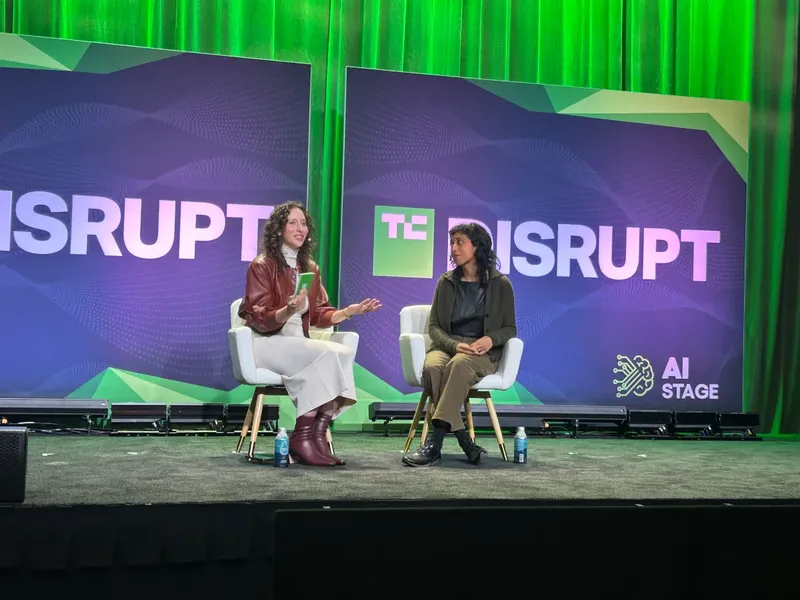
Die Methoden hinter diesen Evaluierungen seien jedoch kompliziert und reiften noch, sagte Irene Solaiman, Chief Policy Officer bei Hugging Face, während einer Diskussion auf der TechCrunch Disrupt in der vergangenen Woche. Das Testen müsste zu einer konsistenteren Wissenschaft zusammenwachsen, wenn sich die Industrie künftig darauf verlassen soll.
Vor diesem Hintergrund: Können wir den aktuell veröffentlichten Tests vertrauen?
„Vertrauen ist ein so schwerwiegendes Wort“, sagte Solaiman. „Was die Frage angeht, ob wir den Ergebnissen vertrauen können, ist ein großer Teil davon: Kann man die Ergebnisse einer Evaluierung reproduzieren? Hat man den benötigten Zugriff auf das Modell selbst – hier kommen die offenen Gewichte in großem Maß ins Spiel“, fügte sie hinzu.
Die Reproduzierbarkeit von Modellevaluierungen ist seit langem einer der kniffligeren Aspekte des Benchmarkings – und bleibt ein Thema von bedeutenden Debatten in der Branche.
Abgesehen von der Gültigkeit eines einzelnen Tests stellt sich auch die Frage, wie sich dieser Test mit anderen Evaluierungen vergleichen lässt.
„Sie sind eine sich entwickelnde Wissenschaft – wobei wir nicht wissen, wie wir sie sinnvoll miteinander vergleichen können“, sagte Solaiman.
„Sie werden relativ schnell un wirksam, und wir haben nicht so blühendes Ökosystem, wie wir es bräuchten“, fügte sie hinzu. „Es besteht jetzt dieser Hunger nach einem Ökosystem eingebetteter Bewerter, aber die Qualifikationen, die festlegen, wer über welche Aufgaben hinweg ein wirksamer Bewerter ist, brauchen deutlich mehr Standardisierung.“
Die Idee der eingebetteten Bewerter – bei der angeblich „neutrale“ Beobachter dritter Partei innerhalb von KI-Organisationen platziert werden – hat in den letzten Monaten an Popularität gewonnen, da KI-Labore mit einer Vielzahl von Sicherheitsvorfällen zu kämpfen haben, die Bedenken über die potenziellen Schäden ihrer Technologie ausgelöst haben. Hugging Face war bekanntermaßen das Ziel eines dieser Vorfälle.
Anstelle einer aktiven staatlichen Regulierung zur Identifizierung und Minderung von Modellsicherheitsbedenken haben die Labore die Lösung durch Dritte vorangetrieben. Es bleiben jedoch Zweifel, wie neutral oder wirksam diese Bewerter tatsächlich sein werden. Anthropics Entscheidung, Accenture einzustellen als ersten Bewerter löste eine ordentliche Gegenreaktion aus, wobei einige Kritiker sich lustig machten über die Vorstellung, die Beratungsfirma sei für die anstehende Aufgabe qualifiziert.
Evaluierungen gehen inzwischen von einem bloßen Test des Modells selbst zu einem Test des gesamten Systems um das Modell herum über – einschließlich Harness und Agent. Der Harness – also das Werkzeug, mit dem der Nutzer auf das Modell zugreift – hat insbesondere viel mit der Leistung eines Modells zu tun, und ein schwächeres Modell mit besserem Harness könnte problemlos ein Frontier-Modell übertreffen, teilte Solaiman mit.
„Agentic-Evals sind wirklich schwierig und wirklich teuer“, sagte Solaiman. „Wir haben einfach mehr Evaluierungen für Modelle. … Wir haben nicht so viele Evaluierungen für Harnesses, und wir entwickeln bessere Evaluierungen für den ganzheitlichen Agenten – denn daraus ziehen viele Leute den Nutzen“, fügte sie hinzu.
Mit anderen Worten: Der Bereich der Evaluierungen ist derzeit ein bisschen wie ein Selbstbedienungsladen, und wenn das Benchmarking weiterhin als nützliches Werkzeug für Branchenführer gelten soll, könnte ein einheitlicherer, branchenweiter Ansatz – bei dem alle auf demselben Stand sind – notwendig sein.