
Von Mengchen aus Aofeisi
QbitAI | Offizieller WeChat-Kanal QbitAI
Der beste Witz, den man in letzter Zeit aus der KI-Welt hören konnte:
Im nächsten Monat werden alle drei großen Anbieter neue Modelle veröffentlichen.
Das neue Claude-Modell wurde als „gewaltiger Sprung“ bewertet: Bei der Behebung eines Bugs kann es „die Wurzel angehen“, indem es das dahinterliegende größere Problem erkennt und gleich mitbehebt.
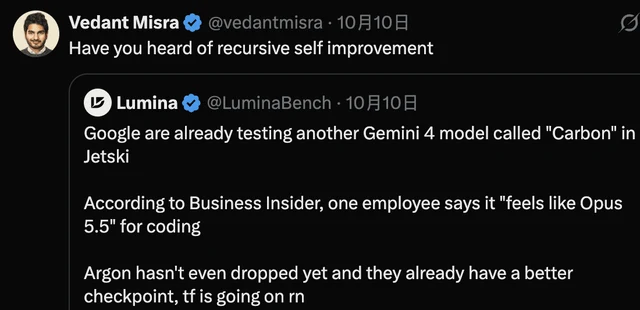
Google wird das Argon-Nachfolgemodell Carbon veröffentlichen; internes Mitarbeiter-Feedback im Test lautet: „kann mit Opus 5.5 mithalten“.
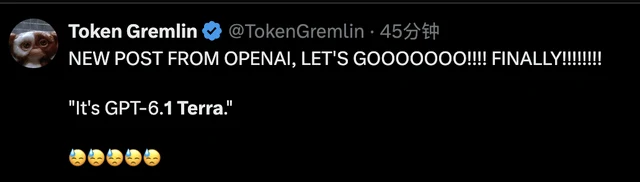
ChatGPT bringt das Mittelklasse-Modell 6.1 Terra……
Na toll. Ich dachte, das jetzige 6.1 Sol sei schon ein umbenanntes Terra.
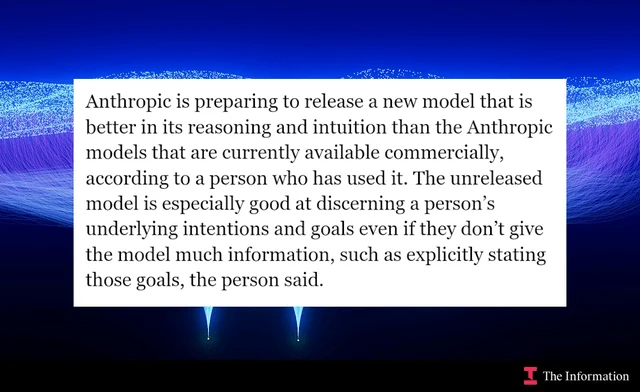
Das neue Claude-Modell kann eingefahrene Denkmuster durchbrechen
Die Information stammt von Information.
Wer findet, dass die neuen Modelle im vergangenen Monat schon schnell aufeinander folgten, sollte nicht erwarten, dass es im nächsten Monat langsamer wird.
Laut Aussagen von Nutzern der internen Tests ist das neue Claude beim Schlussfolgern und der Intuition besser und besonders darin, die zugrunde liegenden Absichten und Ziele einer Person zu erkennen.
So könnte eine Person etwa das Modell bitten, einen einzelnen Bug zu beheben, während das Modell die dahinterliegende fundamentale Problemklasse erkennt und nachfragt, ob die gesamte Problemklasse behoben werden sollte, so eine Person, die das Modell verwendet hat.
Das neue Claude schneidet auch besser darin ab, eingefahrene Denkweisen zu verlassen, statt übliche, naheliegende Ratschläge oder Lösungen zu wiederholen.
Fragt man es nach Rat zum Investieren in Aktien, empfiehlt es nicht den alten Hut, die Kurs-Gewinn-Verhältnisse zu prüfen, sondern schlägt eigene kreative Algorithmen vor, um die zukünftige Aktienentwicklung vorherzusagen.
Noch ist unklar, ob es sich beim neuen Modell um Fable oder Opus handelt – jedenfalls ist es stärker.
Gemini 4 Carbon könnte RSI verwenden
Inzwischen entwickelt Google ebenfalls ein neues Modell mit dem Codenamen „Gemini 4 Carbon“.
Frühere Versionen von Argon lagen bei einigen Programmieraufgaben hinter Claude Opus 5 zurück.
Carbon ist bei Programmieraufgaben besser als Argon und zeigt weiterhin bei Aufgaben mit visuellem Verstehen bessere Leistungen, etwa bei der Analyse von Videos oder beim Testen von Frontend-Seitenfunktionen (dank Training mit YouTube-Daten).
Carbon war mehrere Tage auf Googles interner Programmierplattform Jetski für Mitarbeiter zugänglich; Mitarbeiter, die es ausprobierten, fanden, dass es sich „vergleichbar mit Opus 5.5 anfühlt“, wobei noch mehr Tests nötig seien.
Google hat eine Reihe von Gemini-4-Modellen mit den Codenamen Argon, Barium und Carbon getestet.
Dabei wurde das Modell mit dem internen Codenamen „Barium-B“ schließlich ausgewählt und als das heutige Argon veröffentlicht.
Nach dem Leak der Leistungen aus dem internen Carbon-Test antwortete der Google-Mitarbeiter Vedant Misra mit einem Beitrag: „Hast du schon von rekursiver Selbstverbesserung (RSI) gehört?“
Es ist unklar, ob das andeuten sollte, dass Carbon die RSI-Technik verwendet.
OpenAI hat nichts Neues mehr?
GPT-6.1 Terra ist bereits im Code von Microsoft Copilot aufgetaucht.
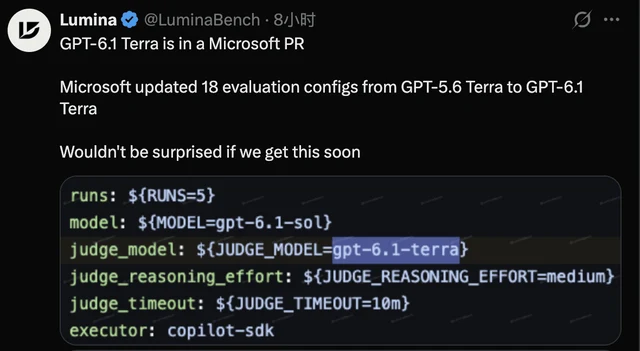
Dass viele zuvor vermutet hatten, 6.1 Sol sei eigentlich ein umbenanntes Terra, war also falsch. Stattdessen ist 6.1 Sol offenbar nur ein Update, das im Vergleich zu 5.6 Sol nicht viel bringt.
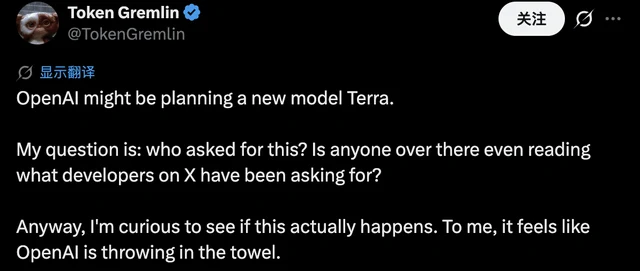
Auf die Nachricht vom 6.1 Terra reagierten viele mit dem Gefühl, OpenAI habe sich inzwischen selbst aufgegeben und schlage nur noch kaputtes Porzellan weiter.
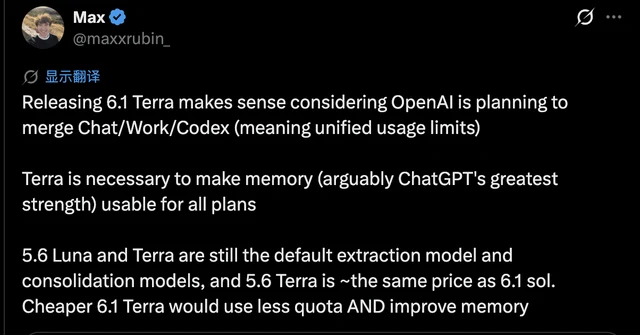
Allerdings gibt es auch Stimmen, die meinen, dass das Terra-Upgrade für OpenAI tatsächlich sehr wichtig ist.
Denn sie beabsichtigen, die Chat/Work- und Codex-Modi von ChatGPT zusammenzuführen, und dann brauchen sie ein günstigeres Modell für Gratisnutzer.
In der Zwischenzeit meldet OpenAI einen neuen Fortschritt.
Die neuesten GPT-Modelle schneiden in seltenen Programmiersprachen (FORTRAN, COBOL) besser ab.
Viele Banken und Versorgungsunternehmen sind auf diese Antik-Software angewiesen, und es gibt kaum noch menschliche Programmierer, die sie warten können.
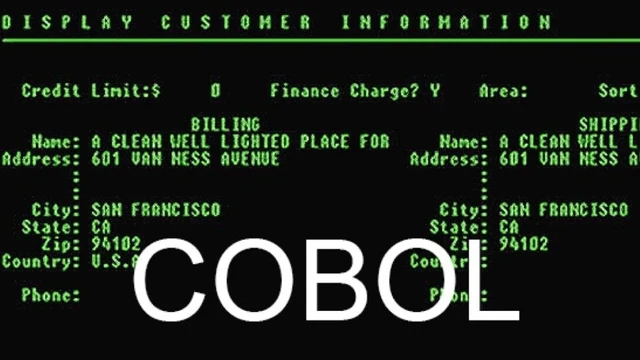
COBOL unterstützt über 40% der Bankensysteme, 80% der Kreditkartentransaktionen von Angesicht zu Angesicht und 95% der ATM-Transaktionen, während Fortran für Wettervorhersagen und Sicherheitsanalysen von Kernreaktoren verwendet wird.
In Tests zur Migration von COBOL-Programmen in andere Sprachen erreichte GPT‑6.1 Sol auf der low-Stufe eine Genauigkeit von 86.6%, während GPT‑5.6 Sol nur 5.4% erreichte. Auf höheren Inferenzstufen lag die Genauigkeit bei 97.9% – der Test wurde damit fast komplett durchgespielt.
Was schließlich die chinesischen Modelle betrifft: DeepSeek hat als erstes sein Schweigen beendet, und in der Folge werden auch die neuen Modelle von Kimi, GLM und Minimax nacheinander erscheinen.
Kurz gesagt, der kommende 11. Monat, der November, bleibt weiterhin spannend.
Referenzlinks:
[1]
https://x.com/kimmonismus/status/2112242007062233122?s=20
[2]
https://x.com/maxxrubin_/status/2112256163761016977?s=20
[3]
https://openai.com/index/low-resource-programming-languages/