
HealthBench und HealthBench Professional: Bewertung von Modellen in realistischen Gesundheitsgesprächen
Wir starten Leaderboards für HealthBench und HealthBench Professional, zwei Benchmarks, die bewerten, wie KI-Modelle in realistischen Gesundheitsgesprächen reagieren
HealthBench und HealthBench Professional sind Benchmarks von OpenAI, die Modellantworten auf realistische Gesundheitsgespräche anhand von von Ärzten erstellten Rubriken bewerten.
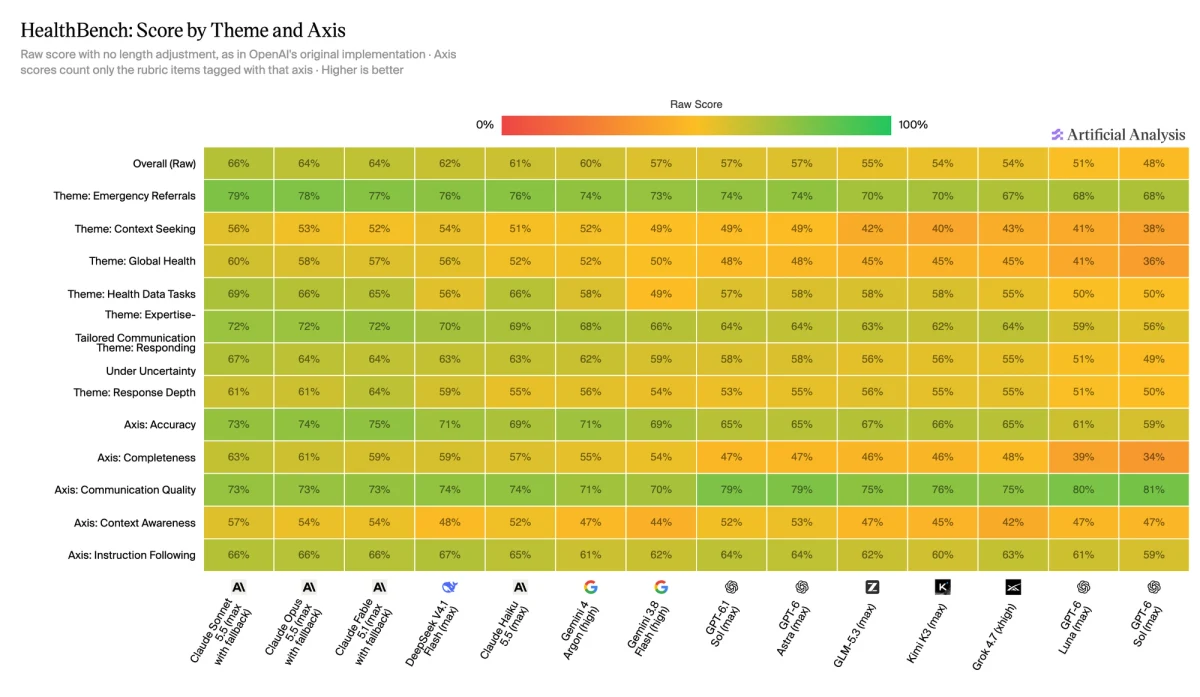
HealthBench testet Modelle anhand von 5,000 Gesundheitsgesprächen mit alltäglichen Nutzern und Gesundheitsfachkräften. Diese decken sieben Themen ab, von Notfallüberweisungen bis zur globalen Gesundheit, und jedes Rubrikkriterium fällt unter eine von fünf Achsen: Genauigkeit, Vollständigkeit, Kommunikationsqualität, Kontextbewusstsein und Befolgen von Anweisungen. HealthBench Professional ist ein kleinerer Satz von 525 Gesprächen, die – anders als bei HealthBench – alle mit Klinikerinnen und Klinikern geführt werden. Diese umfassen Konsultations-, Schreib- und Rechercheaufgaben und beinhalten adversarielle und schwierige Gespräche, die darauf ausgelegt sind, Modelle zu fordern.
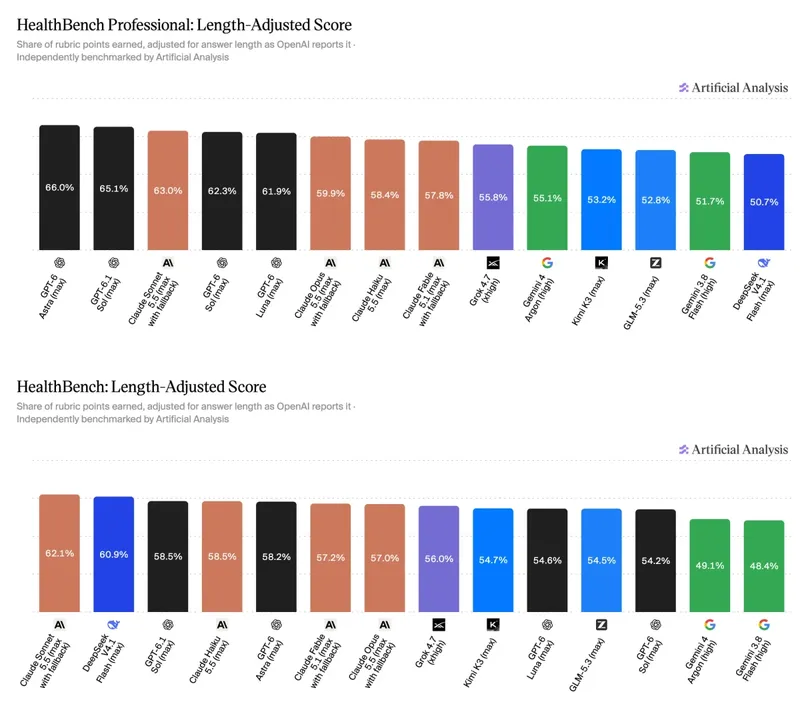
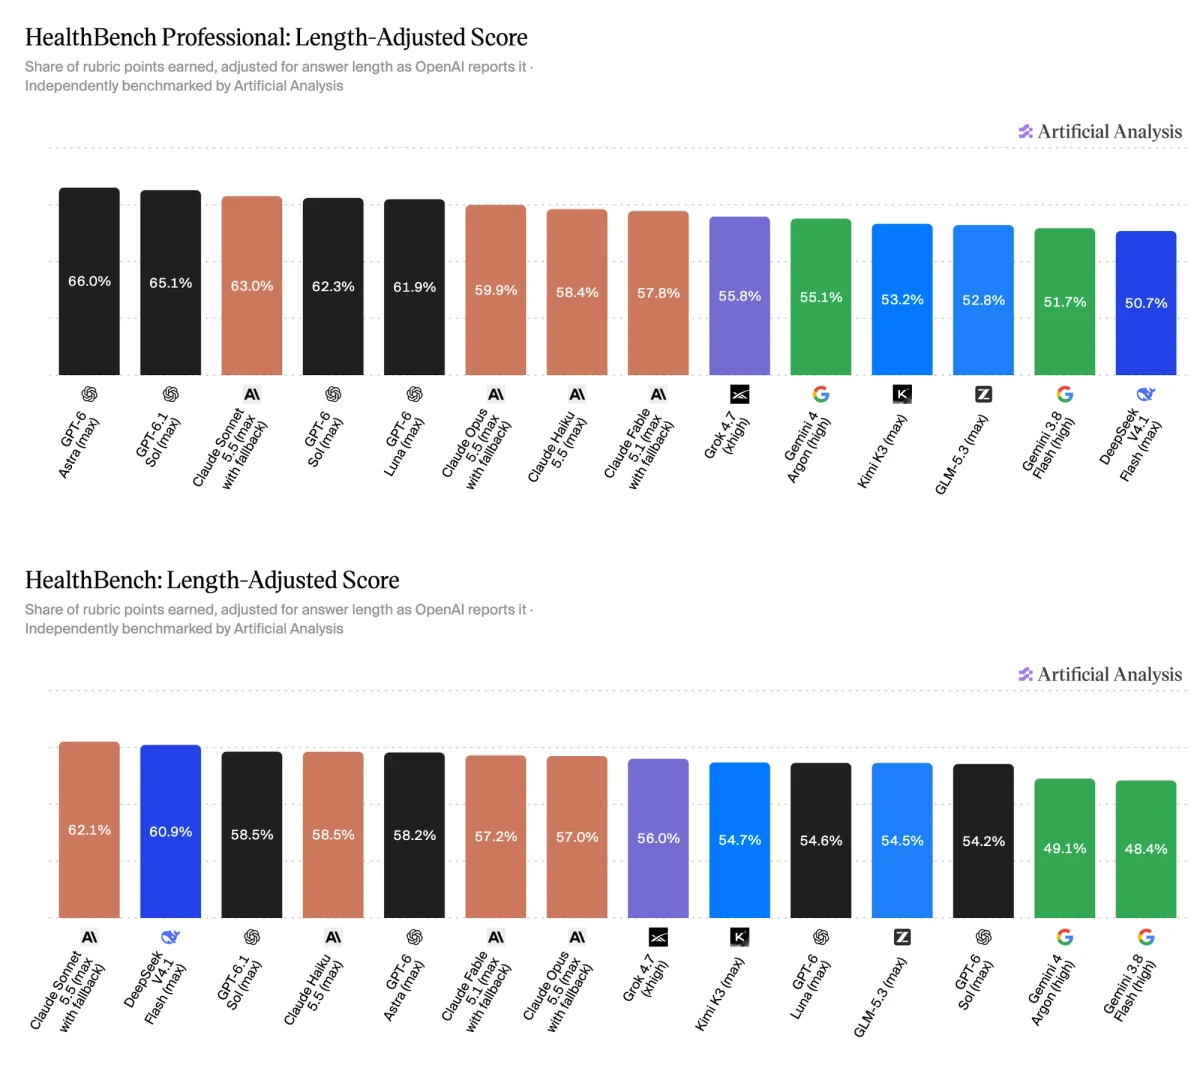
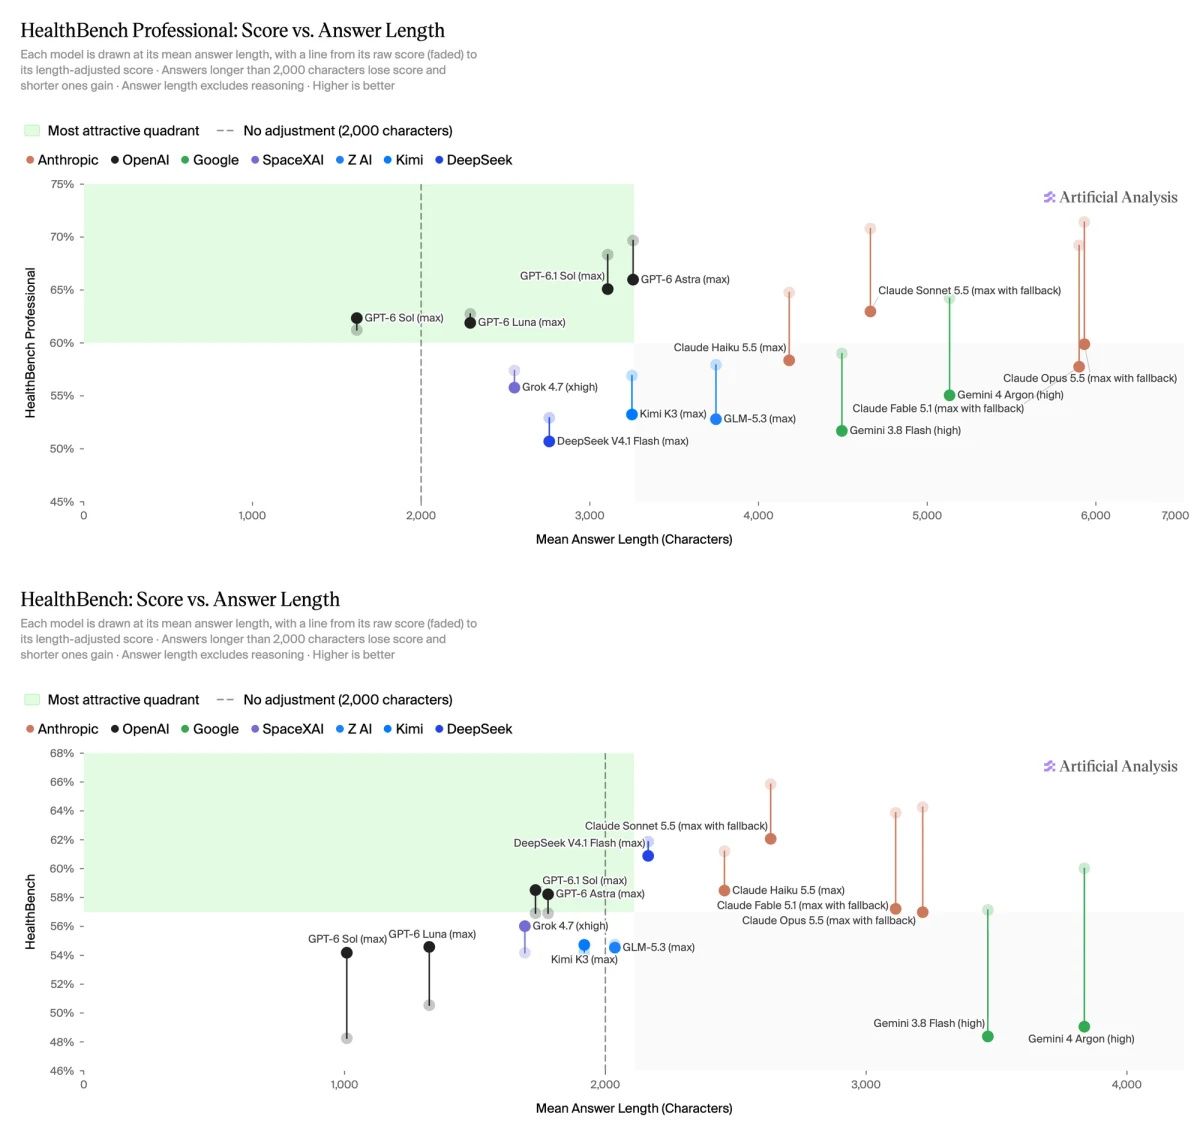
Wir berichten sowohl über den Rohwert (den Anteil der erzielten Rubrikpunkte) als auch über den längenadjustierten Wert, den OpenAI angibt. Der längenadjustierte Wert senkt den Wert von Antworten, die länger als 2,000 Zeichen sind, und erhöht den Wert kürzerer Antworten. Konsistent mit OpenAIs ursprünglicher Implementierung werden die Antworten von GPT-5.4 (low) (HealthBench Professional) und GPT-4.1 (HealthBench) bewertet.
Zentrale Ergebnisse für HealthBench Professional:
➤ GPT-6 Astra und GPT-6.1 Sol führen das Leaderboard an: GPT-6 Astra (max) erzielt 66.0% beim längenadjustierten Wert, vergleichbar mit GPT-6.1 Sol (max, 65.1%) und vor Claude Sonnet 5.5 (max with fallback, 63.0%)
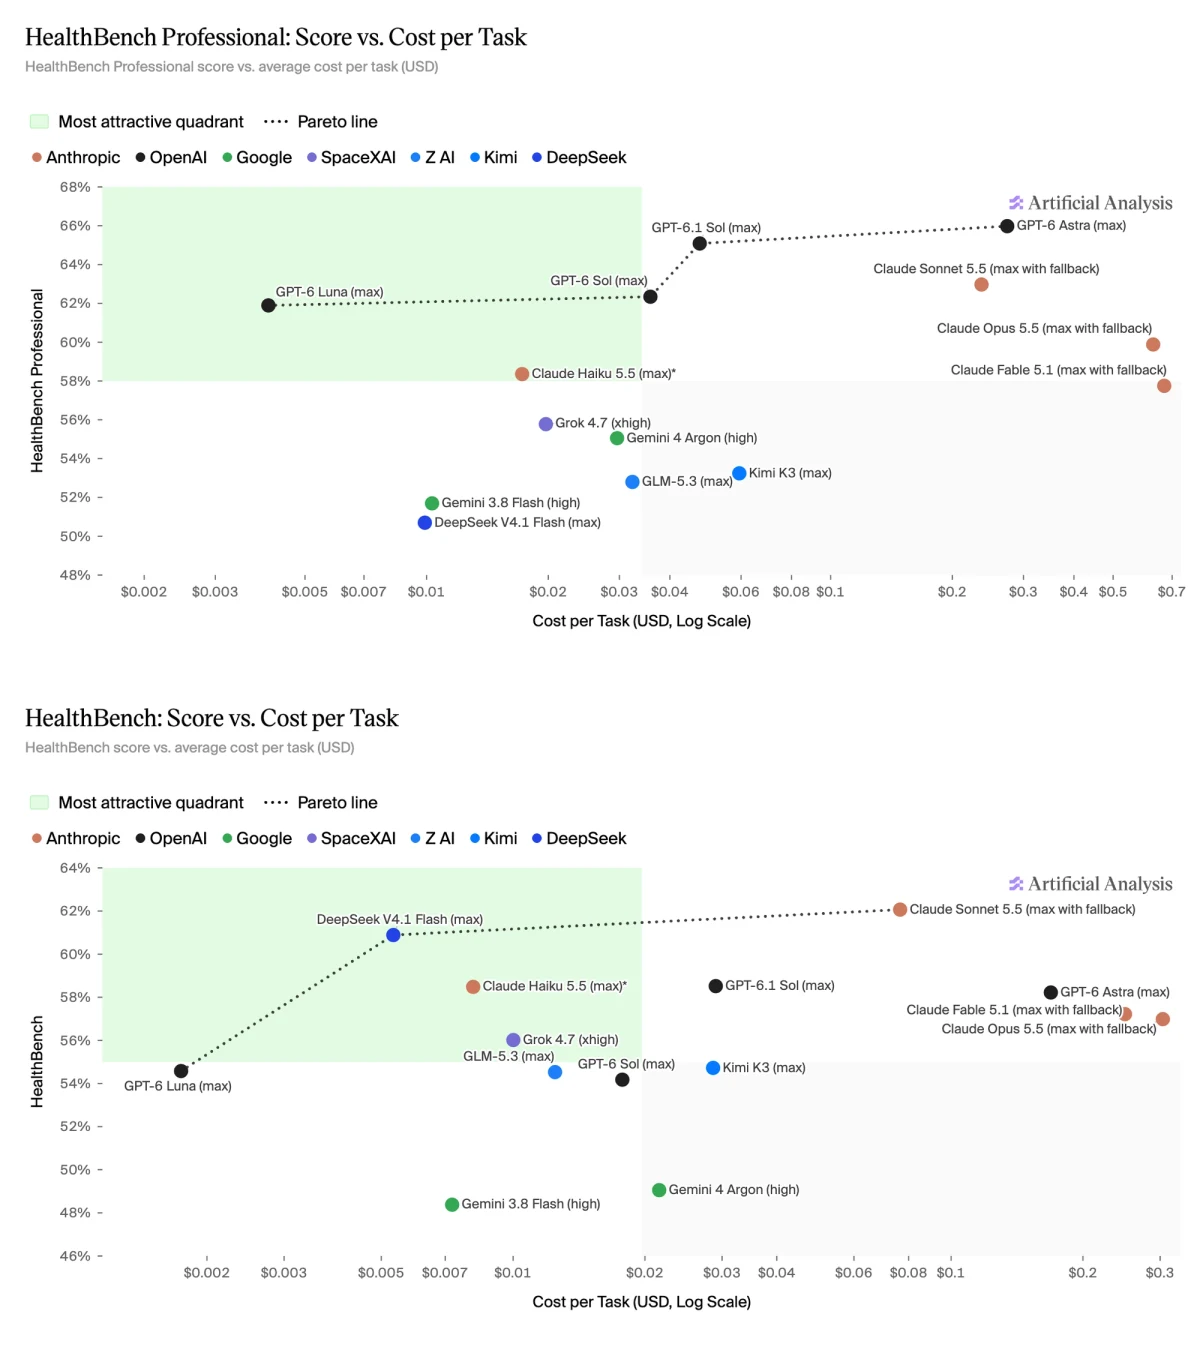
➤ OpenAI-Modelle bilden die gesamte Punktzahl-vs.-Kosten-pro-Aufgabe-Pareto-Frontier: Die Pareto-Frontier besteht aus GPT-6 Luna (max, 61.9%, $0.004 pro Aufgabe) über GPT-6 Sol (max, 62.3%, $0.036) und GPT-6.1 Sol (max, 65.1%, $0.047) bis zu GPT-6 Astra (max, 66.0%, $0.27). GPT-6 Luna (max) liegt 4 Punkte unter GPT-6 Astra (max) bei weniger als 2% der Kosten
➤ Claude Opus 5.5 und Claude Fable 5.1 erhalten die größten Längenabzüge: Beide haben durchschnittlich ~5,900 Zeichen pro Antwort, fast das 3-fache des 2,000-Zeichen-Schwellenwerts, und verlieren nach der Anpassung über 11 Punkte. Claude Opus 5.5 (max with fallback) hat den höchsten Rohwert (71.4%), fällt aber auf den sechsten Platz (59.9%). GPT-6 Sol (max) ist das einzige Modell mit einem Durchschnitt von unter 2,000 Zeichen (~1,600) und das einzige, dessen Wert steigt
Zentrale Ergebnisse für HealthBench:
➤ Claude Sonnet 5.5 führt HealthBench an: Claude Sonnet 5.5 (max with fallback) erzielt 62.1% beim längenadjustierten Wert, vor DeepSeek V4.1 Flash (max, 60.9%) und GPT-6.1 Sol (max, 58.5%)
➤ GPT-6 Luna, DeepSeek V4.1 Flash und Claude Sonnet 5.5 bilden die Punktzahl-vs.-Kosten-pro-Aufgabe-Pareto-Frontier: GPT-6 Luna (max) erzielt 54.6% bei $0.002 pro Aufgabe und DeepSeek V4.1 Flash (max) erzielt 60.9% bei $0.005 pro Aufgabe. Claude Sonnet 5.5 (max with fallback) hat durchschnittliche Kosten pro Aufgabe von $0.08, ~16x teurer als DeepSeek V4.1 Flash für eine Verbesserung des Werts um ~1 Punkt
➤ Kürzere Antworten tauschen Vollständigkeit gegen Kommunikationsqualität: Jedes HealthBench-Rubrikelement ist mit einer von fünf Achsen versehen. Vollständigkeit prüft, ob eine Antwort alle wichtigen Informationen enthält, während Kommunikationsqualität prüft, ob sie klar, gut strukturiert und in der richtigen Länge und Detailtiefe gehalten ist. GPT-6 Sol (max) schreibt die kürzesten Antworten (~1,000 Zeichen) und hat den höchsten Rohwert bei Kommunikationsqualität (81%), aber den niedrigsten Wert bei Vollständigkeit (34%). Claude Sonnet 5.5 (max with fallback) führt bei Vollständigkeit (63%)
Die vollständigen Leaderboards finden Sie hier:
➤ HealthBench Professional: https://artificialanalysis.ai/evaluations/healthbench-professional
➤ HealthBench: https://artificialanalysis.ai/evaluations/healthbench