
Wenn Sie Modelle auf Ihrem Mac ausführen oder MPS als Hauptverarbeitungstool für die Berechnungen verwenden, gibt es viel zu erwarten in PyTorch 2.15! FP8 ist nun auf MPS verfügbar, die Decodierung von Sprachmodellen hat durch lineare Schichten und softmax schnellere Prozesse, und neue Metal-Kerne lösen einige anspruchsvolle Aufgaben im Bereich Audio, Video und Trainingslasten.
Eine kurze Erklärung darüber, wer wir sind: Wir sind das PyTorch-Team bei Hugging Face. Wir tragen zu PyTorch bei, und einer unserer Schwerpunkte ist der MPS-Backend – das Ziel ist es, Ihren Mac zu einem erstklassigen Ort für die Ausführung und Trainierung von PyTorch-Modellen zu machen. Zu Beginn des Jahres 2026 bedeutete die Ausführung sogar kleiner Modelle auf MPS oft, mit ununterstützten Operationen, Leistungsproblemen und unerwartetem Speicherwachstum umzugehen. Wir führen echte Modelle vom Hugging Face Hub für Sprache, Bilder und Videos durch und identifizieren die Stellen, in denen MPS unzureichend ist, sowie diese im Vorfeld in PyTorch korrigieren – häufig durch das Ersetzen von MPSGraph durch spezialisierte Metal-Kerne. Ein Großteil dieses Artikels ist das Ergebnis dieser Arbeit, die gemeinsam mit den PyTorch-Entwicklern und Community-Mitwirkenden erledigt wurde.
TL;DR
- FP8 kommt auf den Mac: Speichern Sie Werte von
float8_e4m3fnin der Hälfte des Raums von BF16 und verwenden Sie skalierte Matrixmultiplikation sowie alle anderen Operationen, die auf CUDA/CPU unterstützt werden! - MoE-Modelle dekodieren 5–6,5× schneller als in 2.14: Qwen3.6-35B-A3B erreicht von 9,4 auf 61,3 Tokens/s auf einem M3 Ultra, dank eines nativen gruppierten matmul mit einer speziellen Dekodierungsroute, weniger GPU-CPU-Synchrone und schnellerer Top-k-Routing.
- Kürzerer Zeitaufwand pro Token für jedes LLM: Einzelzeilen-lineare Schichten verwenden spezialisierte Matrix-Vektor-Kerne, und die Softmax-Operation über das Vokabular ist etwa 8× schneller.
- Mehr Linearkommutatorentwicklung auf der GPU: komplexe LU- und Triangul-Solutionen, schnellere Inverses kleiner Matrizen sowie schnellere QR-Dekompositionen.
- Audio, Video und Training erhalten ebenfalls Aufmerksamkeit: schnellere Wege für Konvolutionen, Padding, Dropout, Interpolation rückwärts und Reduzierungen. Die Video-VAE-Decodierung von Wan2.2 erreicht jetzt einen Speicherpegel von 8 GiB anstatt 270 GiB.
- Mehr Kontrolle durch Python: öffentliche MPS-Streams und zuverlässigere Ereigniszeiten.
- Aufgehäufter Anforderungen: MPS erfordert jetzt macOS 15 oder später; PyTorch 2.15 erfordert Python 3.11 oder später.
- Ein Blick auf 2.16: volle Aufmerksamkeit auf Metal, mehr MPSGraph-zu-Metal-Übertragungen und schnellere LLM-Dekodierung.
Was das für Sie bedeutet
Wenn Sie Modelle auf einem Mac mit Transformern, Diffusers oder Tools wie ComfyUI ausführen, bedeutet die Version 2.15 folgendes in der Praxis:
- Viel schnellere lokale LLMs. Modelle mit Mischung aus Experten dekodieren 5–6,5× schneller als in 2.14: Bei einem M3 Ultra mit
torch.compileerreicht Qwen3.6-35B-A3B von 9,4 auf 61,3 Tokens/s und LFM2.5-8B-A1B von 23,6 auf 123,6 Tokens/s. Dichte Modelle profitieren ebenfalls – durch schnellere lineare Schichten und eine 8-fach schnellere Softmax-Funktion für das Sampling. (Mehr) - Video-Generierung, die in den Speicher passt. Die Decodierung eines Videos mit Wans2.2s tiled VAE führte dazu, dass der Driver-Speicher auf 270 GiB anstieg; aktuell erreicht er einen Höchstwert von etwa 8 GiB. (Mehr)
- Correctes Bildbearbeiten mit Qwen-Image-2.1. Am 2.14 korrektierte der Qwen-Image-2.1 VAE-Encoder Bilder auf MPS stillschweigend, wodurch die Bildbearbeitungsworkflows gestört wurden (berichtet in ComfyUI). Die gleiche Pufferänderung behebt das Problem: eine Encode-Decode-Schleife erreicht nun 29.95 dB PSNR im CPU, gegenüber 10.06 dB.
- FP8-Weights auf Ihrem Mac. FP8-Tensors benötigen die Hälfte der Speichermenge von BF16, und
F.scaled_mmmultipliziert sie direkt auf dem GPU. (Mehr)
Inhalt
- Erstellen eines Projekts
- FP8 kommt zu MPS
- Schnellere Decodierung von Sprachmodellen
- Lineare Algebra erhält einen Aufschwung
- Konvolutions, Padding und Training
- Softmax und Reduzierungen
- Ein viel kleineres Speicherverbrauch für Video-dekodierung
- Mehr Kontrolle mit MPS-Streams
- Mehr Operationen funktionieren auf MPS
- Ein Blick in PyTorch 2.16
- Zusammenfassung
Einführung
Sie benötigen einen Apple-Silicon-Mac mit macOS 15 oder neuer und Python 3.11 oder neuer (siehe die 2.15-Kompatibilitätsmatrix). Wenn Ihr Betriebssystem zu alt ist oder kein Metal-GPU verfügbar ist, gibt die Überprüfung der Verfügbarkeit von MPS jetzt Auskunft darüber, warum.
Um den Release-Candidate in einer separaten Umgebung auszuprobieren:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
FP8 kommt zu MPS
FP8 bietet eine weitere Möglichkeit, Speicher auf Ihrem Mac zu sparen. PyTorch 2.15 fügt Tensoren auf MPS hinzu torch.float8_e4m3fn: ein Byte pro Wert, also die Hälfte des Speicherbedarfs von FP16 oder BF16.
Sie können diese Tensoren mit einander multiplizieren. F.scaled_mm, das sowohl auf Tensorebene als auch auf Zeilenebene skaliert werden kann. Hier ist ein kleines Beispiel mit einer Skalierung pro Tensor:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
>Beschleunigte Decodierung von Sprachmodellen
Jedes LLM hat eine Vorspannphase und eine Dekodierungsphase. Während der Dekodierung durchläuft jedes neue Token als einzelne Zeile durch das Modell, sodass die großen Matrizenmultiplikationen in Matrizen-Vektor-Produkte übergehen. PyTorch 2.15 beschleunigt beide Arten von Schichten, die diesen Schritt dominieren: dichte lineare Schichten und Mixture-of-Experts-Schichten.
Lineare Schichten
MPS hat seit 2.14 die GEMV-Kerne für torch.mm verwendet, aber F.linear verlief immer noch über MPSGraph. PyTorch 2.15 verbindet sie mit F.linear, sodass der gemeinsame [1, 1, hidden_size] Decodierungseingang direkt diese verwendet und die zulässigen Bias-Anpassungen integriert werden. Bei 96 BF16-Schichtformen aus echten Modellen ergibt sich eine 1,23× Geschwindigkeitssteigerung durch geometrische Mittelwerte. Die größten Vorteile entstehen bei kleinen Projektionen, wie den Gates in MoE-Modellen, wo der alte Weg den größten Teil des Speicherbandbreitens ungenutzt ließ. Große Schichten und LM-Heads waren bereits nahe an Bandbreitenbegrenzung, daher bleiben sie bei etwa 1×.
Mixture-of-experts-Layern
Eine Mischschicht aus Experten sendet unterschiedliche Anzahl von Tokens an jeden Experte. Gruppiertes matmul handhabt diese ungleichen Gruppen in einer einzigen Operation, und 2.15 gibt MPS eine native Implementierung.
In 2.14 kopierte die gruppierte matmul-Operation die Gruppenzuordnungen an den CPU und durchlief die Gruppen. Die neuen Metal-Kerne lesen die Zuordnungen direkt auf der GPU, wobei Metal Performance Primitives verwendet werden, sofern verfügbar, und ein separater Metal-Pfad an anderen Stellen. Kleine Gruppen, was während der Decodierung häufig vorkommt, erhalten ebenfalls ihren eigenen Kernel.
Zum Beispiel können 64 Tokens in Gruppen von 16, 32 und 16 geteilt werden:
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
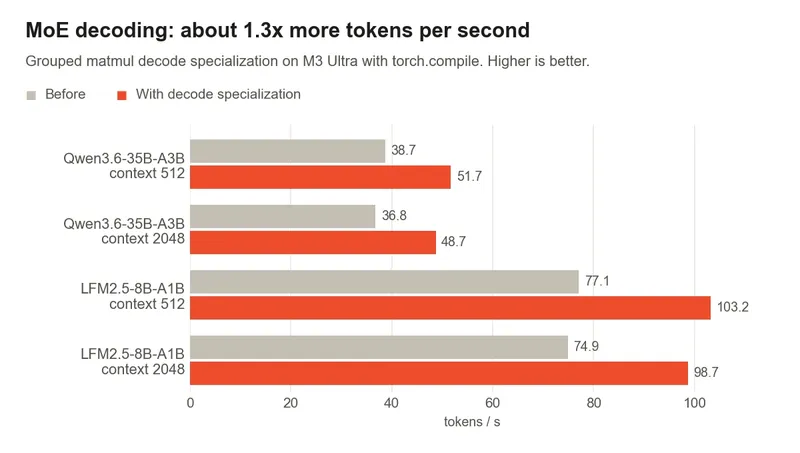
Der Decodierungskernal wird direkt im Token-Throughput angezeigt. Bei einem M3 Ultra mit torch.compile erzeugen MoE-Modelle etwa 1,3× mehr Tokens pro Sekunde.

Lineare Algebra erhält einen Aufschwung
Komplexwertige Berechnungen
Die Arbeit mit komplexen Tensoren wird einfacher. complex64 LU-Faktorisierung, LU-Lösung und Trianguläre Lösung laufen jetzt auf MPS, was auch die darauf basierten Operationen und Gradienten ermöglicht, wie z. B. komplexe Determinanten. Hier ist ein kleines System, das direkt auf dem GPU gelöst wird:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
Kleine Matrizen und größere Lösungen
Kleine Matrizen erhalten auch schnelle Kerne. Für Kamerageometrie und Bildtransformationsen werden Batches von FP32-Matrizen bis zu 4 × 4 in einem einzigen Metal-Kernel umgekehrt, wodurch Factorisierung und Lösung kombiniert werden. Größere Probleme erhalten ebenfalls Aufmerksamkeit: QR verwendet blockierte Updates, und trianguläre Lösungen machen einen großen Teil ihrer Arbeit in effiziente Matrizenmultiplikation um.
Die Gated DeltaNet-Arbeitslasten erhalten einen dedizierten schnellen Pfad für Batches von 16 × 16, 32 × 32 und 64 × 64 FP32-Triangulärsystemen, die mindestens acht rechte Seiten haben.
SVD ist auch bei numerischen Extremen robuster. Es handhabt nun korrekt sehr kleine Singularwerte, sehr große oder sehr kleine Eingangsgrößen und Basiserfüllung mit full_matrices=True, was wiederum die Ergebnisse der Pseudoinverse- und Least-Squares-Lösungen zuverlässiger macht.
Konvolutionen, Paddling und Training
Audiomodelle, Video-Decodierungen und Trainingszyklen haben ihre eigenen kostspieligen Operationen. Diese Veröffentlichung bietet mehreren davon neue Wege durch Metal:
| Operation | Was ändert sich in 2.15? |
|---|---|
conv1d forward |
Spezialisierte Kernels ersetzen MPSGraph, und es gibt einen im2col-plus-matmul Pfad für kurze Ausgaben. Nützlich für Audiowellen- und Streaming-Modellformen. |
| Konstante Puffer | Verschiebung auf Metal-Kerne, Behebung des unkontrollierten Wachstums von Treiber und Speicher bei der Decodierung von Tiled-Video-VAE (mehr unten). |
| Reflektion und Replikationsbezug | Neue Metall-Implementierungen, die schneller sind und die Rückwärtigkeitskorrektheit beheben. |
| Out-of-place-Dropout | nn.Dropout und F.dropout verwenden jetzt den vorhandenen gefusionten Kernel. |
| Upsampling zurückwärts | Ein Metal-Gather-Kern ersetzt den MPSGraph-Ressourcen-Resizing-Gradient-Pfad. |
Nachfolge von conv2d im Channel |
Bleibt auf einem effizienten Kanallastpfad anstatt eines NCHW-Graphen mit kostspieligem gestrichenen Zugriff. |
Softmax und Reduzierungen
Die Token-Sampling-Geschwindigkeit wird in 2.15 ebenfalls schneller. softmax und log_softmax laufen jetzt auf dedizierten Metal-Kernen, und große Vokabulargrößen profitieren am meisten: Ein FP32-softmax über eine [1, 128256] Reihe von Logits verkürzt sich von 57 µs auf 7 µs, etwa 8× schneller als die MPSGraph-Version. Die Geschwindigkeitssteigerung bleibt auch bei anderen gängigen Vokabulargrößen bestehen:

>Ein viel kleineres Speicherverbrauch für Video-dekodierung
Einer der beeindruckendsten Ergebnisse in dieser Veröffentlichung resultiert aus dem Wechsel bei der konstanten Pufferung. Die VAE-Dekodierung in Wan-AI/Wan2.2-TI2V-5B-Diffusers führt über eine vollständige 28-Tile-Dekodierung 8.764 Puffer-Calls aus. Mit Pufferung auf Metal sinkt der maximale Treiberspeicher von etwa 270 GiB auf 8 GiB:

| Speichermetrik | MPSGraph-Padding | Metall-Puffer |
|---|---|---|
| Aktueller Peak bei der Tensor-Allokation | 4.422 GiB | 4.095 GiB |
| Reservierter Höchststand des Anrechners | 8.070 GiB | 8.070 GiB |
| Gesamtspitze von Fahrer-Memorie | 270.135 GiB | 8.108 GiB |
Mehr Kontrolle mit MPS-Streams
Sie können jetzt direkt in Python wählen, welcher MPS-Stream Ihre Arbeit ausführt. torch.mps.Stream und der torch.mps.stream Kontextmanager bieten die Schnittstelle, und Tensor.record_stream ermöglicht es dem Allokator, den Gebrauch eines Tensors auf einem anderen Stream zu verfolgen.
Hier ist ein kleines Beispiel, das die Arbeit an einen separaten Stream sendet und sie vor dem Lesen des Ergebnisses synchronisiert:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
Mehr Operationen funktionieren auf MPS
Mehrere weitere Operationen laufen jetzt auf MPS: torch.frexp, torch.logspace, torch.take und Tensor.put_, torch.heaviside, torch.special.laguerre_polynomial_l und unterschiedliche Vergleiche von ungezwungenen Ganzzahlen. logspace unterstützt noch keine Integer- oder Boolean-Ausgaben mit mehr als einem Element.
Die Korrektheit von Attention wird ebenfalls verbessert: Die MPS-Math-Implementierung des skalierten Dot-Products-Attentionsmechanismus löst jetzt das Batch- und Head-Broadcasting korrekt.
>Ein Sneak- peek bei PyTorch 2.16
Die Arbeit an der Version 2.16 ist bereits im Gange. Einige der unten aufgeführten Änderungen sind bereits in main implementiert und verfügbar für die Nightlies; andere sind noch in Überprüfung, sodass die Details vor der Veröffentlichung noch geändert werden könnten.
>Bessere Decodierung von LLMs
Wenn der Dekodierpfad eines Modells keine MPSGraph-Operationen mehr enthält, startet die GPU erst nachdem die CPU alle Kerne gekodiert hat. PyTorch 2.16 kommt den Befehlsbuffern alle 16 Kerne, sodass die GPU mit der Arbeit beginnt, während die CPU noch die restlichen Kerne kodiert. Für die kompilierte BF16-Dekodierung in einem 2048-Token-Kontext:
| Modell | Bevor | Nach | Ändern |
|---|---|---|---|
| LFM2.5-8B-A1B | 108,8 Tokens/s | 126,0 Tokens/s | +16% |
| Qwen3.6-35B-A3B | 52,9 Tokens/s | 62,8 Tokens/s | +19% |
| Qwen3.8-27B | 12.1 Tokens/s | 12.6 Tokens/s | +4% |
Die Attention-Funktion wird vollständig auf Metal ausgeführt
Die skalierten Dot-Product-Attention-Technik ist das vollständige Entfernen von MPSGraph: Jede Form wird mit Metal-Kernen ausgeführt, mit speziellen Vektor-Kernen für die Decodierung und Metal Performance Primitives für das Halbpreciser-Fill auf neuen macOS-Versionen. Die Formen, die früher auf MPSGraph zurückgriffen, profitieren am meisten. Auf einem M5 Pro sinkt die Decodierung mit grouped-Query-Attention (32 Query-Heads, 8 KV-Heads, Kopf-Dimme 80, 4K Kontext) von 465 µs auf 65 µs, und ein 4K × 4K-Fill mit Kopf-Dimme 40 sinkt von 42 ms auf 6 ms.
Mehr MPSGraph-to-Metal-Migrationen
Der Rückzug von MPSGraph setzt sich fort. Die Vorwärts-Transformation und die Rückwärts-Transformation sind in Bearbeitung, während die MSE-Verlust-Transformation (bis zu 12× schneller bei kleinen Eingaben), die std_mean und var_mean (bis zu 4× schneller) sowie die bincount bereits implementiert sind. bincount ist besonders beeindruckend: Wenn die meisten Werte in ein einziges Bin fallen, dauert die Zählung von 4 Millionen Ganzzahlen 6,8 Sekunden – jetzt nur noch halb ein Millisekunde.
>Ein kleinere Installation
Die eingebundenen Shaders werden standardmäßig für Metal 3.1 gebaut, wobei die Metal-4-Versionen nur für die Kerne kompiliert werden, die sie benötigen. Dadurch wird libtorch_cpu.dylib um etwa 25% reduziert, von 384 MiB auf 287 MiB, und das Fundament für die Metal-4.1-Shaders mit schnelleren matmuls und nativem FP8-Matrixmultiplikation wird gelegt.
Zusammenfassung
PyTorch 2.15 bringt FP8 auf den Mac, eine schnellere LLM-Dekodierung für dichte und MoE-Modelle, mehr Lineare Algebra auf der GPU sowie eine lange Liste von Operationen, die von MPSGraph in dedizierte Metal-Kerne verlegt wurden. Probieren Sie den Release-Candidate aus!
Was kommt für uns als Nächstes
- Mehr MPS: 2.16 wird sich vollständig auf Metal konzentrieren, und wir werden weiterhin die Operationen von MPSGraph abziehen.
torch.compile: Wir versuchen, die Graphunterbrechungen zu beseitigen, sodass mehr Modelle vollständig kompiliert werden können.- Ihre Ideen: Worüber sollten wir noch in PyTorch arbeiten? Wenn etwas langsam, fehlt oder kaputt ist – sei es auf MPS oder an anderen Orten – öffnen Sie ein Problem im GitHub und teilen Sie uns mit.
Vielen Dank Nikita Shulga, Kurt Mohler und Aaron Gokaslan für die Überprüfung vieler dieser Arbeiten und für alle, die bei der MPS in dieser Veröffentlichung mitgewirkt haben.