
Cornerstone OnDemand, Inc. (Cornerstone) es un líder global en soluciones de preparación de la fuerza laboral, que atiende a 140 millones de usuarios en 186 países. La empresa construyó un sistema de IA multiagente que transforma las operaciones de bases de datos de la lucha reactiva contra incendios en flujos de trabajo proactivos y autoorquestados. El sistema, llamado Orion AI, utiliza Amazon Bedrock y Strands Agents, un marco de orquestación de agentes de código abierto de AWS, para coordinar agentes especializados.
Antes de Orion AI, el equipo de Enterprise DataOps de Cornerstone pasaba hasta 45 minutos por incidente de base de datos consultando manualmente vistas del sistema y cruzando registros antes de transferir el trabajo entre equipos. Con Orion AI, el diagnóstico de bases de datos se redujo de 45 minutos a 10, una reducción del 78%. Un equipo de tres personas entregó el sistema en seis meses.
En esta publicación, repasamos el problema operativo al que se enfrentó Cornerstone, cómo diseñaron Orion AI, los resultados que midieron y las decisiones de diseño que otros equipos pueden reutilizar.
El desafío operativo
Antes de Orion AI, el equipo de Enterprise DataOps de Cornerstone operaba de forma reactiva, con cuatro puntos de dolor recurrentes:
- Las investigaciones de rendimiento de bases de datos tomaban aproximadamente 45 minutos por incidente, distribuidos entre múltiples herramientas y vistas del sistema.
- Los flujos de trabajo del ciclo de vida de las bases de datos requerían 10 o más pasos manuales, desde establecer conexiones hasta comunicar actualizaciones de estado.
- Los informes entre el equipo de ingeniería de confiabilidad del sitio (SRE) y el equipo de datos funcionaban con un retraso de 15 minutos.
- Las alertas redundantes y superpuestas creaban ruido que enterraba las señales importantes.
En conjunto, esto significaba que los ingenieros pasaban su tiempo en coordinación manual en lugar de resolver problemas.
La solución: Orion AI
Orion AI es un sistema multiagente en el que un agente coordinador (el meta-orquestador) delega el trabajo a agentes secundarios especializados organizados en una topología de hub-and-spoke. Los ingenieros interactúan con él a través de una aplicación web, haciendo preguntas y aprobando acciones en el mismo lugar donde ya coordinan el trabajo operativo. Los agentes cubren la supervisión de infraestructura, el diagnóstico de bases de datos, las operaciones del ciclo de vida de las bases de datos, el análisis de clientes y el soporte basado en conocimiento.
Dos principios guiaron la construcción: la privacidad de los datos mediante controles de AWS bajo el modelo de responsabilidad compartida, y una integración profunda con las herramientas operativas existentes. Amazon Bedrock proporcionó acceso administrado a modelos fundacionales, y Strands Agents proporcionó la capa de orquestación.
Resultados
Orion AI logró mejoras medibles tanto en la velocidad como en la precisión del diagnóstico y liberó al equipo de la coordinación manual. Al automatizar los cuellos de botella manuales y agilizar los flujos de trabajo entre equipos, Cornerstone alcanzó los siguientes resultados.
| Métrica | Antes | Después | Mejora |
| Tiempo de diagnóstico de bases de datos | 45 minutos | 10 minutos | 78% más rápido |
| Pasos manuales del ciclo de vida | Más de 10 pasos | 1 interacción | Reducción del 70% |
SRE-to-data-team retraso en los informes |
15 minutos | Instantáneo | En tiempo real |
| Alertas redundantes | Alto volumen de referencia | Filtradas | Reducción del 65% (mediana) |
Solución de problemas de rendimiento más rápida
Reducir el tiempo de diagnóstico de bases de datos fue la mayor ganancia individual de eficiencia de Orion AI hasta la fecha. Anteriormente, los ingenieros se conectaban manualmente a la instancia de SQL Server afectada, consultaban las vistas del sistema para identificar cadenas de bloqueo y tipos de espera, cotejaban registros para aislar consultas de larga duración y correlacionaban evidencia para formar una hipótesis de causa raíz. Esto tomaba un promedio de aproximadamente 45 minutos por incidente.
Con Orion AI, tres agentes especializados comparten la investigación, cada uno a cargo de una etapa distinta. Más allá del diagnóstico, Orion AI lleva los problemas hasta la remediación: identifica la causa raíz, recomienda la solución y crea un ticket de Jira completo asignado al ingeniero de guardia correspondiente. Un traspaso manual de cuatro pasos se convierte en una única interacción.
Gestión automatizada del ciclo de vida de bases de datos
Las tareas que antes requerían más de 10 pasos manuales, desde establecer conexiones a bases de datos hasta ejecutar consultas entre sistemas y comunicar actualizaciones de estado, ahora se ejecutan como una única interacción en lenguaje natural. Orion AI identifica las herramientas y fuentes de datos adecuadas, ejecuta consultas en todos los sistemas, valida los resultados y devuelve una respuesta unificada. Desde la perspectiva del ingeniero, el trabajo se reduce a solicitar cosas a Orion AI y validar los hallazgos que reporta.
Monitoreo en tiempo real y reducción de la fatiga de alertas
Orion AI eliminó el retraso de 15 minutos SRE-to-data-team reporte de 15 minutos, reemplazando las verificaciones manuales periódicas con visibilidad continua entre sistemas.
Orion AI redujo las alertas redundantes en una mediana del 65 por ciento mediante deduplicación, filtrado por umbrales y correlación de señales cruzadas. Por cada 10 alertas generadas previamente, ahora solo 3–4 llegan a los ingenieros. Las alertas se enrutan directamente a los equipos responsables sin una capa intermedia de alertas.
Principios clave de diseño
Tres decisiones dieron forma a Orion AI, y usted puede aplicarlas a sus propios proyectos multiagente:
- Dividir los agentes por dominio, no por complejidad de tarea: Cada agente cuenta con un conjunto reducido de integraciones de herramientas para un solo dominio operacional. Esto mantiene el contexto del modelo enfocado y mejora la precisión de la selección de herramientas, en lugar de pedirle a un agente de propósito general que haga todo.
- Usar enrutamiento por palabras clave de forma predeterminada y recurrir a la búsqueda semántica: Las solicitudes predecibles se emparejan por palabra clave para mayor velocidad. Las solicitudes ambiguas recurren a la búsqueda semántica para mayor precisión. Esto mantiene la latencia baja sin sacrificar la exactitud en las consultas más difíciles.
- Limitar la memoria conversacional a las sesiones y omitirla para las métricas en vivo: La memoria persistente admite conversaciones de múltiples turnos, pero las preguntas operativas siempre leen el estado actual del sistema. Omitir la memoria para las métricas en vivo ayuda a evitar que datos obsoletos contaminen los diagnósticos en tiempo real.
Descripción general de la arquitectura
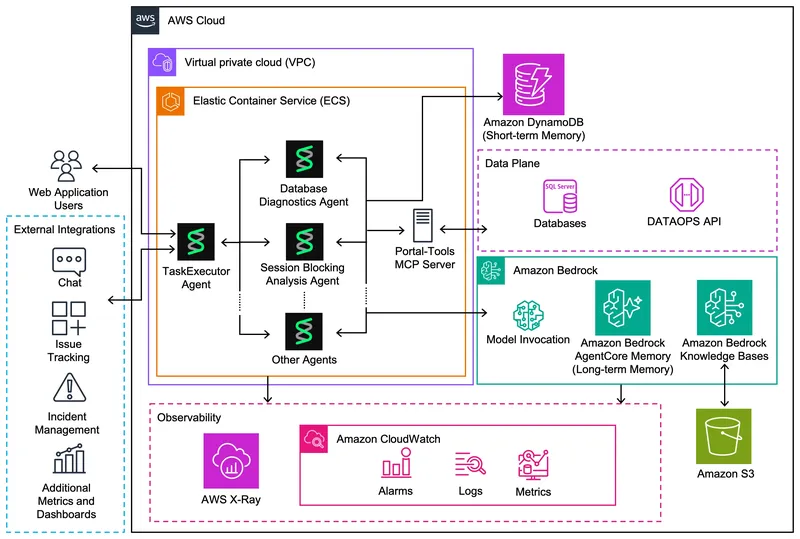
Orion AI se despliega como servicios en contenedores en Amazon Elastic Container Service (Amazon ECS). Los usuarios interactúan a través de una aplicación web que enruta cada solicitud al agente apropiado, invoca las herramientas necesarias y ensambla la respuesta. El siguiente diagrama muestra cómo se conectan estos componentes dentro de AWS Cloud.
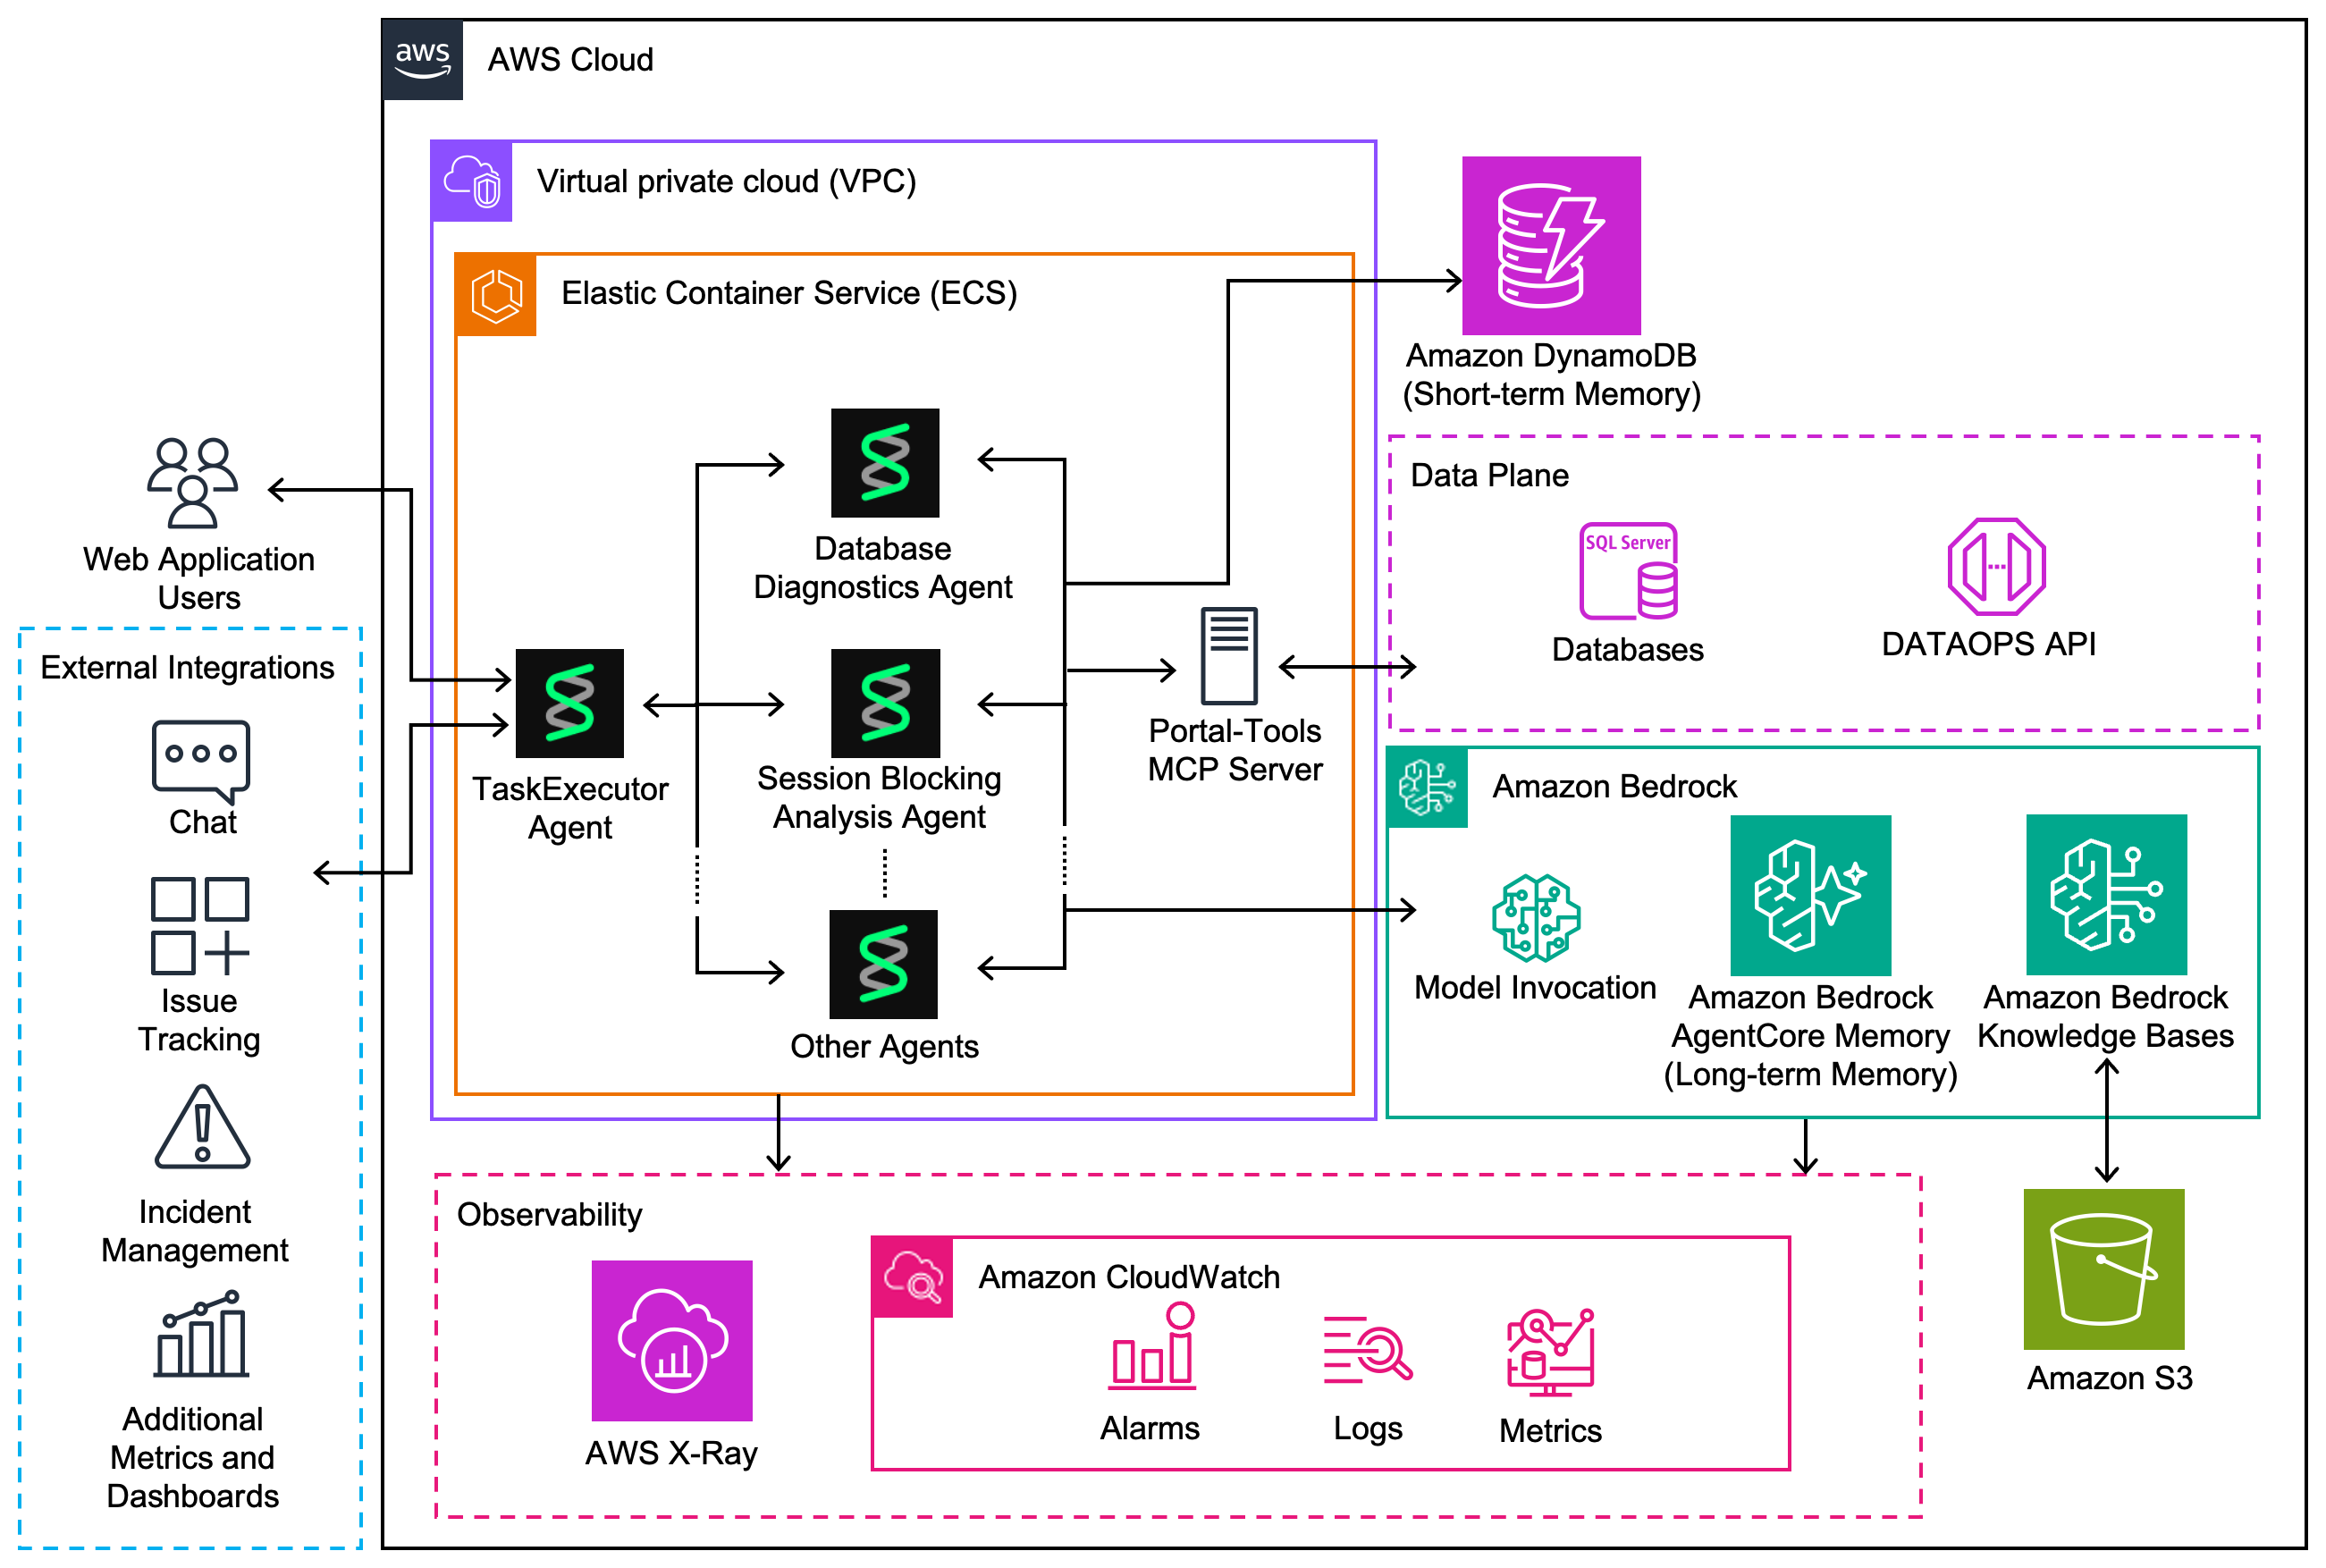
Figura 1: Arquitectura de Orion AI: un metaorquestador en Amazon ECS enruta las solicitudes a agentes especializados, que acceden a las fuentes de datos a través de un servidor Portal-Tools MCP y usan Amazon Bedrock para modelos, memoria a largo plazo y generación aumentada por recuperación
Análisis profundo de la arquitectura
Los principios de diseño anteriores se concretan en la arquitectura. El resto de esta sección repasa los componentes centrales de Orion AI.
Construcción del patrón hub-and-spoke con Strands Agents
Orion AI expresa su topología con unas pocas primitivas de Strands Agents. El Agent class es el bloque de construcción tanto para los agentes especialistas como para el metaorquestador. Las herramientas de cada agente son funciones Python ordinarias marcadas con el @tool decorador. Este deriva la especificación de la herramienta a partir de las anotaciones de tipos y la docstring de la función, lo que significa que no hay un esquema separado que mantener. BedrockModel encapsula el modelo de Amazon Bedrock sobre el que se ejecuta cada agente, y MCPClient conecta los agentes con servidores de herramientas externos.
La topología:
- El hub es un único Strands Agent que actúa como metaorquestador (el TaskExecutor). No contiene herramientas de dominio, solo herramientas de enrutamiento (
find_relevant_agents,call_agent) y herramientas de control de flujo (emit_plan_step,emit_confirmation_gate), de modo que puede razonar una solicitud paso a paso. - Los spokes son instancias independientes de
Agent, cargadas de forma perezosa mediante un registro basado en decoradores. Cada una lleva su propio modelo, herramientas de dominio y system prompt localizado.
En tiempo de ejecución, el hub invoca a un especialista por nombre a través de la herramienta call_agent registrada. Cada especialista ejecuta su propio bucle de llamadas a herramientas y devuelve texto sintetizado al hub, que ensambla la respuesta final.
Enrutamiento híbrido
Orion AI utiliza un enrutamiento basado primero en palabras clave con una alternativa de búsqueda semántica. Aproximadamente el 80 por ciento de las consultas se resuelven mediante una vía rápida de palabras clave en memoria en menos de un milisegundo. Cuando las palabras clave no son suficientes para determinar la intención, el sistema recurre a la búsqueda semántica impulsada por Amazon Titan Text Embeddings V2 para enrutar por significado. Para consultar la disponibilidad de modelos por región de AWS, consulte Supported models by AWS Region in Amazon Bedrock.
Cuando la invocación directa de herramientas no es apropiada, se activa una cadena de respaldo: Amazon Bedrock Knowledge Bases, la capacidad de Retrieval Augmented Generation (RAG) totalmente administrada, recupera documentación operativa para que las respuestas se basen en procedimientos aprobados en lugar de generarse sin contexto.
Agentes específicos de dominio y sus límites
Orion AI utiliza 13 agentes específicos de dominio. Los tres agentes de SQL Server ilustran cómo la división por dominios se corresponde con las etapas de una investigación real:
- Agente de diagnóstico de bases de datos identifica cadenas de bloqueo, tipos de espera y consultas de larga duración, y luego traduce los hallazgos técnicos en impacto empresarial con recomendaciones de remediación. Responde a “qué está sucediendo y qué significa”.
- Agente de análisis de bloqueo de sesiones ejecuta investigaciones de varios pasos con modelos de razonamiento para mapear las cadenas de bloqueo hasta un bloqueador raíz. Responde a “por qué está sucediendo esto y cuál es la causa raíz”, y entrega recomendaciones priorizadas que van desde la terminación inmediata de sesiones hasta correcciones arquitectónicas a más largo plazo.
- Agente de diagnóstico SQL en tiempo real consulta directamente las instancias de SQL Server a través de la API DATAOPS de Cornerstone para obtener datos de bloqueo en vivo y análisis de sesiones con alto uso de CPU. Responde a “qué es verdad ahora mismo”.
Los agentes restantes siguen el mismo principio de propiedad acotada: monitoreo de infraestructura, análisis operativo, gestión del ciclo de vida de bases de datos, análisis de clientes, recuperación de conocimiento desde runbooks, enrutamiento de notificaciones, descomposición de consultas compuestas, resolución de listeners de Availability Groups y calentamiento de conexiones de modelos.
Integración de herramientas y conectividad de servicios
Orion AI accede a las fuentes de datos mediante dos patrones:
- Model Context Protocol (MCP) para herramientas que varios agentes comparten (por ejemplo, el diagnóstico SQL en tiempo real). Una
@toolfunción de Strands llama a unaMCPClientmediante HTTP transmitible a un servidor Portal-Tools MCP, que accede a SQL Server y a la API DATAOPS. La integración con Jira sigue el mismo enfoque a través de las herramientas MCP externas de Atlassian. - Llamadas directas al SDK o a la API REST para fuentes que no necesitan la interfaz MCP compartida. Esto incluye métricas y paneles, calendarios de guardia y Amazon Bedrock Knowledge Bases a través de AWS SDK for Python (Boto3).
Esta división significa que cada agente utiliza el mecanismo más ligero que se adapta a su fuente, mientras que el servidor MCP centraliza las herramientas que varios agentes comparten. Estas conexiones se ejecutan sobre TLS, y las credenciales, como el token MCP y la autorización de la API REST, se suministran por solicitud, no están incrustadas en el código de los agentes.
Memoria conversacional
Amazon Bedrock AgentCore, una plataforma para construir, conectar y optimizar agentes a escala con cualquier framework o modelo, proporciona la capa de memoria entre sesiones. Orion AI coordina el contexto a través de un administrador de memoria central que lee de tres niveles en paralelo, cada uno con su propio tiempo de espera y asignación de tokens.
Orion AI coordina el contexto en tres niveles. La memoria a corto plazo mantiene el contexto de la misma sesión en Amazon DynamoDB, cifrado en reposo de forma predeterminada, junto con un resumen de conversación continuo que Amazon Nova 2 Lite genera de forma asíncrona. La memoria a largo plazo proporciona recuperación entre sesiones a través de la memoria de AgentCore, una capacidad de Amazon Bedrock AgentCore, con espacios de nombres por ID de usuario. Al completarse una tarea, Orion AI llama a create_event para activar la extracción, resumir y consolidar automáticamente. Un tercer nivel, la memoria entre agentes, es un bloc de notas efímero en memoria que transporta los hallazgos a lo largo de los pasos de los subagentes dentro de una misma tarea.
El gestor de memoria realiza recuperaciones entre los niveles dentro de un tiempo límite estricto de 500 milisegundos con un presupuesto de 4,000 tokens, respaldado por una caché de uso menos reciente (least-recently-used). Cuando una solicitud afecta al estado actual del sistema, los agentes omiten por completo la memoria y leen datos en vivo, de modo que el contexto obsoleto no contamina el diagnóstico en tiempo real.
IA responsable y salvaguardas
Como la seguridad de DataOps depende de reglas específicas del dominio, como qué operaciones de base de datos son disruptivas, el equipo construyó una lógica de salvaguardas personalizada en lugar de confiar en filtros de contenido genéricos. Orion AI aplica controles en cuatro capas:
- Restricciones de seguridad a nivel de prompt inyectadas en el system prompt de cada agente, que bloquean recomendaciones peligrosas (por ejemplo, terminar procesos críticos de la base de datos) y exigen métodos no disruptivos.
- Una puerta de confirmación con humano en el ciclo que pausa las operaciones destructivas hasta que el usuario confirma dentro de una ventana de cinco minutos, con denegación por defecto al expirar el tiempo.
- Módulos de salvaguardas personalizados para validación de entradas (límites de longitud, bloqueo de inyección de prompts y de SQL), saneamiento de salidas (ocultación de secretos e información de identificación personal), limitación de tasa, control de acceso basado en roles y seguimiento de costos por solicitud.
- Protección a nivel de enrutamiento que impide responder consultas operativas desde la memoria, forzando la ejecución de herramientas en vivo para preguntas sobre el estado actual.
Observabilidad
Orion AI utiliza servicios estándar de observabilidad de AWS para la monitorización y depuración. Amazon CloudWatch proporciona métricas y registro estructurado para la confianza del enrutamiento, la latencia y la actividad de invocación de agentes. AWS X-Ray rastrea las llamadas distribuidas a través de las ejecuciones de los agentes para ofrecer visibilidad de extremo a extremo de la ruta de las solicitudes.
Lecciones aprendidas
Las decisiones de diseño que hicieron posible Orion AI son reutilizables. Dividir los agentes por dominio permitió que cada agente llevara integraciones de herramientas específicas sin sobrecargar el contexto de un solo modelo. Usar enrutamiento por palabras clave de forma predeterminada con búsqueda semántica como alternativa mantuvo la latencia baja sin sacrificar la precisión en solicitudes ambiguas. Limitar la memoria conversacional a las sesiones mientras se omitía para métricas en tiempo real mantuvo la confiabilidad del diagnóstico en tiempo real.
El equipo también tomó decisiones pragmáticas de infraestructura. Desplegaron la computación en Amazon ECS porque Amazon Bedrock AgentCore runtime, una capacidad de Amazon Bedrock AgentCore, no estaba disponible al inicio del proyecto, y ahora la están evaluando como una opción de migración futura. Si usted está construyendo hoy, sopese la misma disyuntiva para su propia pila: comience con lo que es estable y disponible ahora, y revísela a medida que las capacidades administradas maduren.
Conclusión
Orion AI redujo el diagnóstico de bases de datos de 45 minutos a 10, evitó el 70 por ciento de los pasos manuales del ciclo de vida y redujo el ruido de las alertas en un 65 por ciento. Un equipo de tres personas lo entregó en seis meses sobre Amazon Bedrock. Los patrones detrás de esos resultados son adoptables por otros equipos de operaciones: agentes con alcance de dominio, enrutamiento híbrido y memoria con alcance de sesión con un bypass para métricas en tiempo real.
Para comenzar con la orquestación multiagente en AWS, revise la guía de AWS Solutions Library.