
A primera vista
- Agentic RL aprovechado: Microsoft Research Asia introduce un paradigma de entrenamiento en el que el mismo agente utilizado en la implementación participa directamente en el aprendizaje por refuerzo, eliminando la necesidad de reimplementar el agente dentro del marco de entrenamiento.
- De peso ligero por diseño: Agent Lightning v1.0 proporciona un plano de control RL completo para el agente en aproximadamente 3,500 líneas de código.
- Soporte nativo para Kubernetes: los agentes se ejecutan como trabajos estándar de Kubernetes en clústeres autogestionados, Kubernetes en la nube o infraestructura local, sin depender de servicios de sandbox comerciales pagados.
- Receta de entrenamiento eficiente en datos: una cadena de procesamiento de agentes de codificación de extremo a extremo elevó a Qwen3.5-9B del 41.8% al 56.4% Pass@1 en SWE-bench Verified, un aumento de 14.6 puntos porcentuales, utilizando solo aproximadamente 6,000 muestras de entrenamiento basadas en un conjunto de datos de código abierto.
Los agentes de IA han evolucionado de modelos individuales a sistemas complejos full-stack construidos con modelos, herramientas y entornos de ejecución. Sus capacidades dependen cada vez más del agente que los coordina desde fuera del modelo. El aprendizaje por refuerzo (RL) es un enfoque en el que los sistemas de IA aprenden a través de ensayo y error, guiados por recompensas y penalizaciones por sus acciones. El RL puede mejorar esos agentes, pero la mayoría de los sistemas de RL de agentes requieren que los desarrolladores reinventen el agente dentro del marco de entrenamiento. Eso es costoso, y significa que el agente que se entrena no es exactamente el mismo que se implementa en producción.
Para abordar esto, investigadores de Microsoft Research Asia han introducido el paradigma de entrenamiento de RL agentic harnessed y han puesto en la red pública Agent Lightning v1.0 (se abre en nueva pestaña) completamente reconstruido. En comparación con la versión original, Agent Lightning v1.0 pone más énfasis en ser ligero, en integrarse con harnesses reales y en una pipeline de entrenamiento de RL agentes completa y reproducible.
El Agente Lightning v1.0 fue reconstruido basándose en Harnessed Agentic RL, con mejoras clave:
- Leve: todo el framework consta de aproximadamente 3,500 líneas de código. Agent Lightning v1.0 implementa un sistema completo de RL agentic Harnessed en un código base lo suficientemente pequeño y claro para ser comprendido, modificado y extendido.
- Entrenamiento en un arnés de agente real: los agentes llegan al modelo a través del proxy del gran modelo de lenguaje (LLM) en Agent Lightning v1.0, manteniendo sin cambios el código existente del arnés.
- Soporte nativo para Kubernetes: los agentes se ejecutan directamente como tareas de Kubernetes, sin necesidad de servicios de sandbox comerciales externos. Tanto los clústeres autogestionados como la infraestructura local pueden soportar despliegues a gran escala.
- Un ejemplo completo de entrenamiento para un agente de codificación: una cadena de procesamiento de punta a punta construida sobre Qwen3.5-9B aumentó el Pass@1 en SWE-bench Verified de 41.8% a 56.4%, con un gancho absoluto de 14.6 puntos porcentuales, utilizando solo aproximadamente 6,000 muestras de entrenamiento.
Los límites de la RL agentica tradicional
El RL agentic tradicional asume que el marco de entrenamiento es el responsable del bucle de interacción con el entorno. En un bucle al estilo ReAct, el modelo genera una acción, el entorno devuelve una observación, la observación se añade al contexto y el modelo genera la siguiente acción, de modo que todo el proceso se representa en una trayectoria continua de tokens. Los sistemas de RL tempranos como verl, AReaL y slime se construyeron de esta manera, lo que significaba que entrenar un agente requería reconstruir su bucle dentro del marco de RL.
Los arneses reales han superado esa suposición. Los agentes de codificación como mini-SWE-agent, OpenHands, OpenCode, Claude Code y Codex cada uno traen su propio manejo de contexto, protocolos de herramientas, lógica de ejecución y dependencias, al igual que los sistemas de agentes de uso general. Reconstruir uno para entrenamiento es costoso, y el agente reconstruido puede ya no comportarse de la misma manera que el agente desplegado.
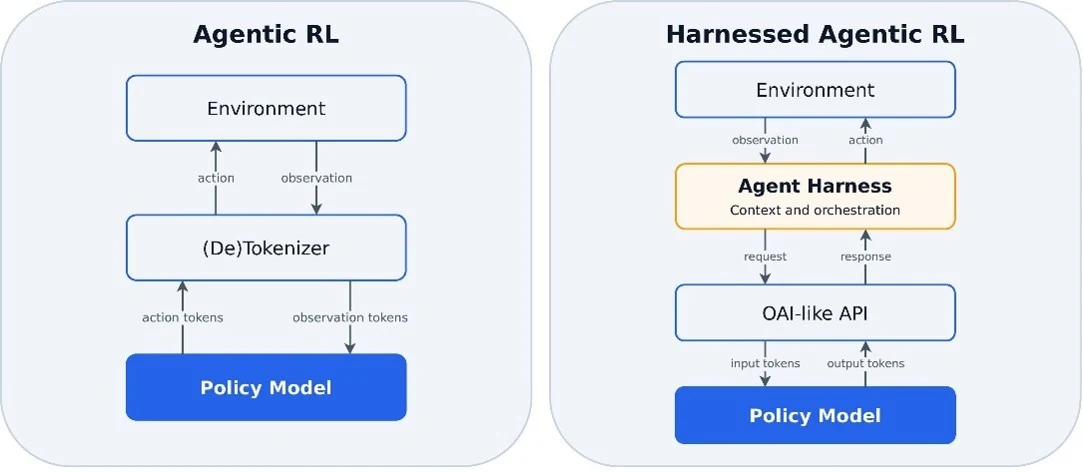
El agente Lightning sigue un camino diferente. Coloca un proxy LLM entre el agente y el modelo. El agente continúa funcionando como antes: simplemente dirige el punto de acceso que anteriormente llamaba a la API del modelo al Agent Lightning, y el marco de entrenamiento puede observar y registrar sus llamadas al modelo. En la versión 1.0, los investigadores avanzan aún más y definen formalmente este paradigma como RL Agenteico Aprovechado: el agente aprovechado utilizado en la implementación es el que participa directamente en el aprendizaje por refuerzo durante el entrenamiento (Figura 1).
Cuatro desafíos en el entrenamiento con arneses reales
La diferencia principal entre el RL agentic Harnessed y el RL agentic tradicional es que el ciclo de interacción con el entorno es gestionado por el harness del agente, y no por el marco de entrenamiento. El sistema de entrenamiento solo puede observar una serie de pares de solicitud y respuesta de LLM, por lo que un único despliegue puede dividirse en un número variable de muestras de entrenamiento. Esto plantea cuatro desafíos clave:
- Retokenización y fusión de muestras: Los harnesses mantienen el contexto como texto, pero el entrenamiento de RL necesita los IDs de tokens muestrados durante la implementación. Pasar el texto a través del plantilla de chat y el tokenizer nuevamente puede cambiar los límites de los tokens, por lo que las llamadas adyacentes no siempre pueden fusionarse en una sola muestra.
- Cálculo de ventaja: La retokenización, los subagentes y la resumenación del contexto pueden dividir una implementación en varios muestras. El cálculo de líneas base y ventajas directamente a nivel de muestra hace que las implementaciones que producen más muestras se contabilicen repetidamente, lo que altera las relaciones estadísticas originales a nivel de implementación.
- Normalización de pérdida: La media de la pérdida según el número de muestras otorga más peso a las implementaciones que producen más muestras. Dado que el número de muestras es a menudo simplemente un producto del comportamiento del sistema, la normalización de la pérdida también debe evitar que se distorsione por él.
- Entrenamiento de programación del backend: La cantidad y longitud de muestras se conocen solo después de que termine el proceso, mientras que las cantidades de GPU y las configuraciones paralelas de datos/tensor suelen ser fijas. El backend debe convertir una carga de trabajo variable en recursos fijos.
Spotlight: boletín de investigación de Microsoft
Boletín de Microsoft Research
Suscríbase hoyConstruir un plano de control RL para un agente completo con 3,500 líneas de código
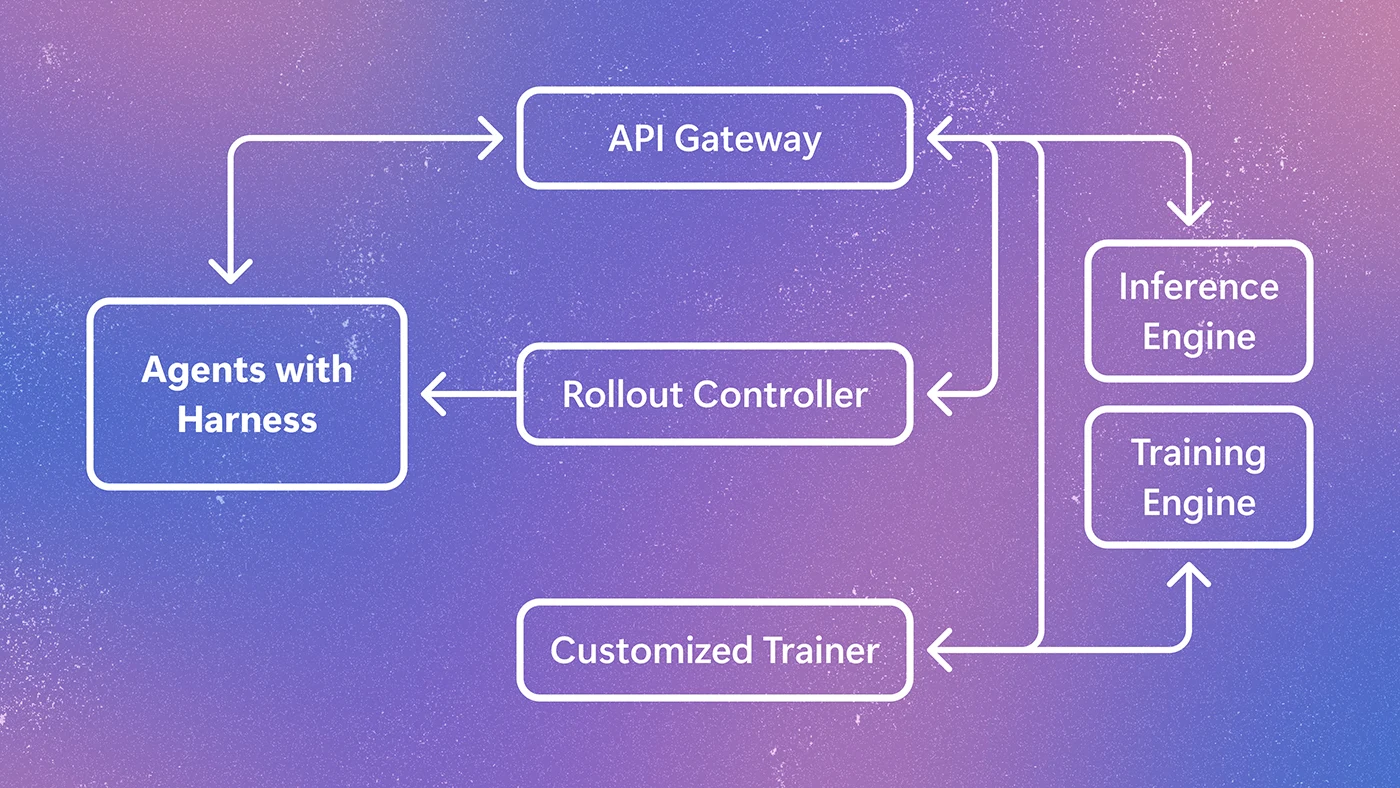
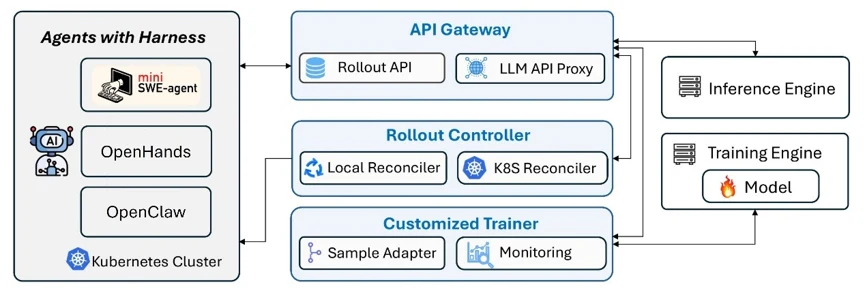
En el diseño de sistemas, Agent Lightning v1.0 considera la simplicidad como su principio fundamental. Todo el framework consta de aproximadamente 3,500 líneas de código, con tres componentes principales: el API Gateway, el Rollout Controller y el Customized Trainer (Figura 2).
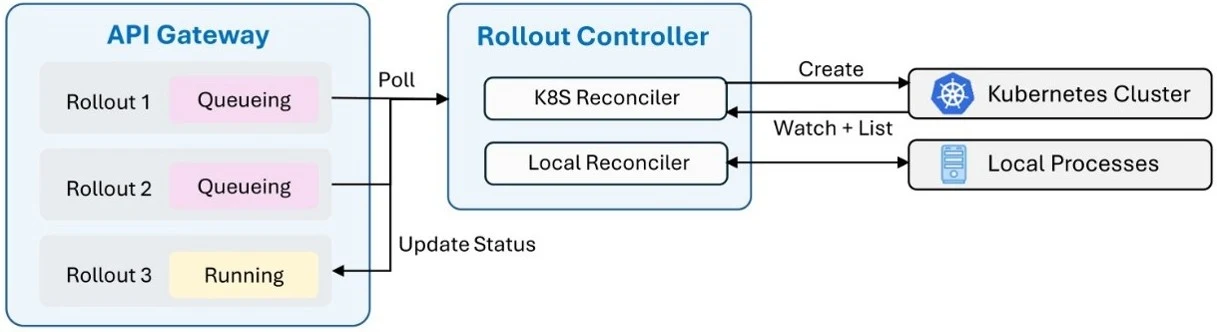
La pasarela de API almacena los despliegues, los modelos y los eventos, y funciona como un proxy para LLM compatible con OpenAI. Conecta cada llamada de modelo desde el harness con su despliegue y registra los prompts, las respuestas y las probabilidades de registro que el entrenamiento necesita. El controlador de despliegue inicia y gestiona la ejecución del agente, ya sea como procesos locales o como trabajos estándar de Kubernetes, manteniendo la ejecución del agente separada del entrenador. El entrenador personalizado, construido sobre verl, crea las implementaciones, espera a que terminen, recoge muestras y ensambla las muestras de entrenamiento finales a través de un adaptador de muestra. Como resultado, para un arnés de agente existente, basta con dirigir el punto final del modelo hacia el proxy Agent Lightning para conectarse rápidamente al entrenamiento RL.
Colocalizado RL asincrónico
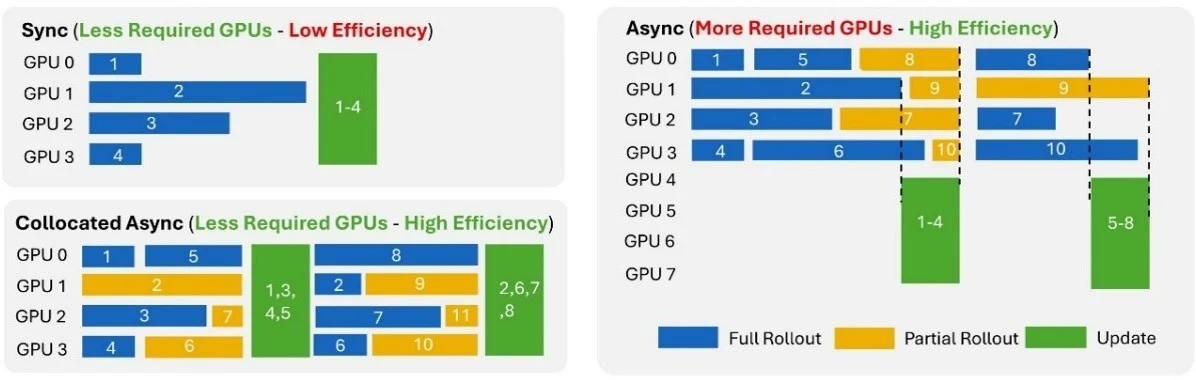
Los tiempos de implementación varían ampliamente entre los agentes. El RL sincrónico espera al agente más lento en un lote y deja las GPU inactivas, mientras que el RL asíncrono completo aumenta la utilización, pero requiere grupos separados de GPUs para la implementación y el entrenamiento. En respuesta, Agent Lightning v1.0 introduce Collocated Async RL, que permite que la implementación y las actualizaciones del modelo compartan el mismo conjunto de GPUs.
Cuando el sistema haya recopilado suficientes implementaciones, comenzará la actualización: el API Gateway deja de aceptar nuevas solicitudes y espera a que las solicitudes ya en curso se completen, y las implementaciones se reanudan después de que la actualización termine. Todo el proceso de transición de estado es transparente para el agente externo. En los experimentos, este enfoque logró un aumento de velocidad de aproximadamente 2 veces en todo el proceso, en comparación con el RL sincrónico, mientras se utilizan menos GPU que en el RL asíncrono convencional (Figura 3).
Ejecutar agentes en Kubernetes
Recoger suficientes despliegues significa ejecutar muchos agentes al mismo tiempo, lo que consume sustanciales recursos de CPU, memoria y computación. Otros marcos de RL agentic Harnessed suelen alojar esos agentes en servicios de sandbox comerciales como Modal Sandbox o E2B, donde el costo aumenta rápidamente con la escala. En cambio, Agent Lightning v1.0 los ejecuta como trabajos estándar de Kubernetes, reutilizando clústeres autogestionados existentes, Kubernetes en la nube o infraestructura local (Figura 4). Los recursos de computación existentes se utilizan de manera más eficiente, los grandes despliegues son menos costosos, y todo el flujo de trabajo sigue siendo de código abierto y reproducible.
6,000 muestras de entrenamiento, un aumento en el rendimiento de 14.6 puntos
Para probar el enfoque, los investigadores construyeron una pipeline completa utilizando SWE-smith, mini-SWE-agent y Qwen3.5-9B, que incluye la limpieza de datos, la construcción del entorno, las medidas de seguridad para el hackeo de recompensas y el entrenamiento de RL. El conjunto de entrenamiento contiene aproximadamente 6,000 muestras y no requiere computación a gran escala. El entrenamiento de RL solo permitió que Qwen3.5-9B aumentara de 41.8% a 56.4% en SWE-bench Verified, lo que representa un incremento de 14.6 puntos porcentuales.
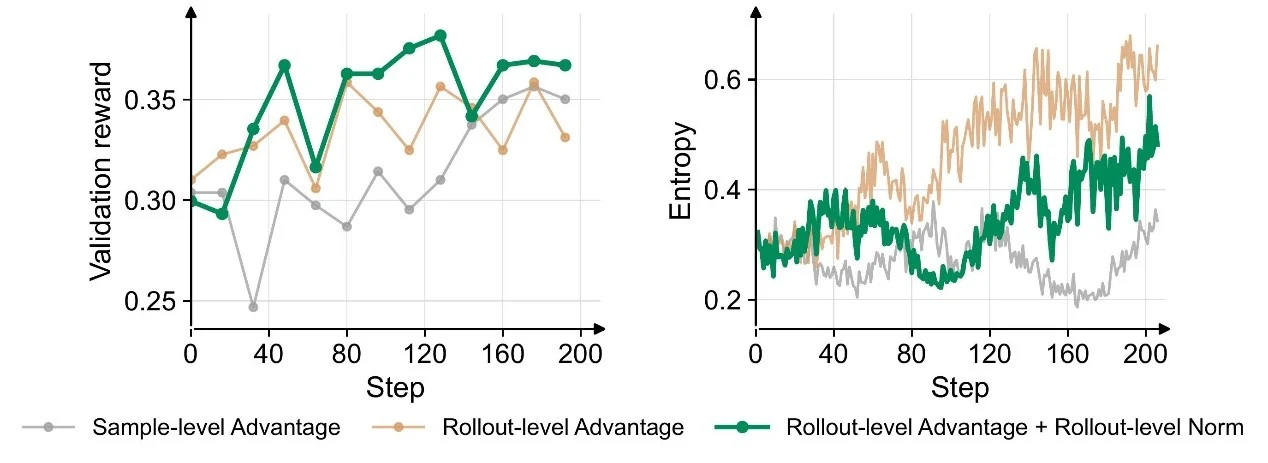
Los experimentos del agente de codificación confirman aún más el análisis anterior de dos desafíos: el cálculo de ventaja y la normalización de pérdidas. En comparación con el manejo a nivel de muestra, la ventaja a nivel de implementación combinada con la normalización a nivel de implementación logra una recompensa de validación más alta y mantiene la entropía de la política más estable durante el entrenamiento (Figura 5).
El artículo Agent Lightning v1.0: Un marco RL agentico ligero de 3,500 líneas para entrenar agentes con arneses reales apareció primero en Microsoft Research.