
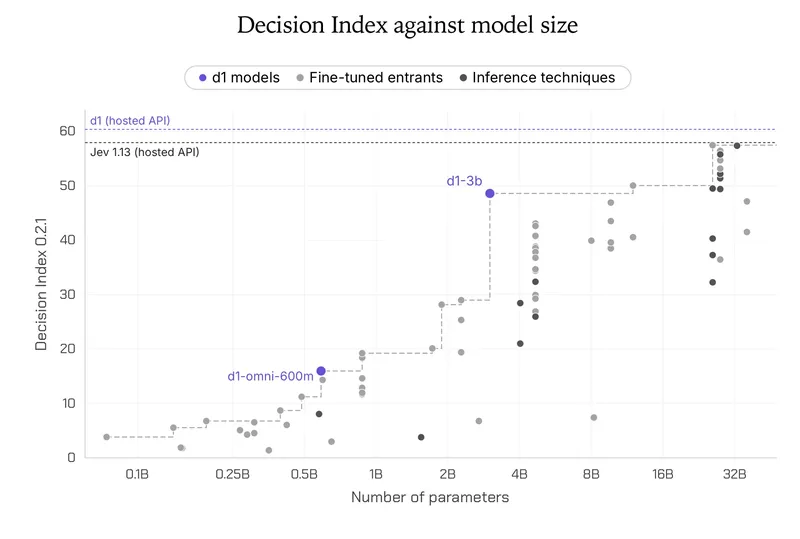
Hoy lanzamos dos modelos de decisión abiertos en nuestra familia de modelos de decisión d1: d1-3B y d1-omni-600M (experimental).
- El mejor modelo de decisión por debajo de 10B en el Decision Index 0.2.1: d1-3B obtiene 48.57, por delante de todos los modelos de 4B y 9B y de Decider 35B-A3B (47.11).
- Multimodal: d1-3B admite texto e imágenes, mientras que d1-omni-600M admite texto e imágenes o texto y audio
- Rápido: d1-3B responde una pregunta en 16 ms en un NVIDIA Jetson AGX Thor, 26 ms en un Jetson AGX Orin y 50 ms en un Jetson Orin Nano
Cómo construimos modelos de decisión para el edge
Estos modelos de decisión d1 abiertos están construidos sobre nuestros Liquid Foundation Models (LFMs). A diferencia de nuestros modelos generativos, los modelos de decisión no producen tokens, sino que responden en una sola pasada hacia adelante.
d1-3B y d1-omni-600M se entrenan a partir de dos backbones muy diferentes:
- d1-3B se entrena a partir de LFM2.5-VL-3B, nuestro último VLM, que es decoder-only. Acepta texto e imágenes como entradas.
- d1-omni-600M se entrena a partir de LFM2.5-Encoder-350M, un codificador bidireccional. Añade codificadores de visión y audio para manejar las tres modalidades. Acepta como entradas texto e imagen, o texto y audio. Este modelo se encuentra actualmente en una versión inicial de investigación y sigue en desarrollo.
Resultados de benchmarks
Hicimos benchmark de d1-3B y d1-omni-600M en siete conjuntos de datos públicos que abarcan comprensión lectora, detección de toxicidad, clasificación de intenciones, preguntas y respuestas médicas y comprensión multilingüe. d1-3B logra una puntuación media de 82.9, la más alta de la tabla y por encima de Decider 4B. d1-omni-600M obtiene 78.4, superando a Decider 2B (77.1) con solo una cuarta parte de los parámetros.
| Benchmark | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| Media | 78.4 | 82.9 | 77.1 | 81.1 |
Validamos que d1-3B conserva las capacidades de visión de su backbone LFM2.5-VL-3B en benchmarks de visión estándar, y que d1-omni-600M maneja las tres modalidades. No reportamos ningún benchmark de visión o audio, ya que el Decision Index v0.3 incluye solo una partición privada de visión y los benchmarks de decisión de audio son actualmente un problema abierto.
Velocidad
En colaboración con NVIDIA, evaluamos d1-3B en el stack de NVIDIA a través de NVIDIA GeForce RTX 4090, NVIDIA Jetson AGX Thor, Jetson AGX Orin 64 GB y Jetson Orin Nano. Dado que d1-omni-600M es un lanzamiento temprano de investigación, no reportamos ninguna cifra de velocidad para él en este lanzamiento.
Inferencia en el borde. d1-3B responde una sola pregunta en menos de 50 ms en cada dispositivo medido. Tres preguntas toman solo 1.3x el tiempo de una, con el AGX Thor pasando de 16 ms a 20 ms.
| Una pregunta | 3 preguntas | Estado de 3.4K tokens | imagen de 384px | 64 estados, empaquetados | |
|---|---|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78 / s |
| Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262 / s |
| Jetson AGX Orin 64 GB | 26 ms | 35 ms | 560 ms | 83 ms | 110 / s |
| Jetson Orin Nano | 50 ms | 73 ms | 1,640 ms | 202 ms | 38 / s |
Inferencia en GPU. En GPU, d1-3B responde una pregunta en menos de 10 ms y procesa una imagen de 384px en menos de 18 ms en ambas plataformas.
| Una pregunta | 3 preguntas | Estado de 3.4K tokens | Imagen de 384px | 64 estados, empaquetados | |
|---|---|---|---|---|---|
| NVIDIA RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475 / s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1,106 / s |
Cómo usar los modelos de decisión d1 abiertos
Acuda a los modelos de decisión d1 cuando necesite decisiones rápidas y estructuradas, incluidas entradas multimodales. d1-3B ofrece la mayor calidad de decisión en su tamaño, mientras que d1-omni-600M encaja donde la huella importa.
Instale las dependencias (requiere transformers>=5.14):
pip install "transformers>=5.14" torch torchvision pillow
Estos modelos incluyen su propio código, así que cárguelo con trust_remote_code=True:
import io
import urllib.request

import torch
from PIL import Image
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True,
                                  dtype=torch.float32 if device == "cpu" else torch.bfloat16).to(device)

# Several named questions over one text state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
print(model.system_one("I was charged twice this month, please refund one of them.", questions))

# An image as the whole state
url = "http://images.cocodataset.org/val2017/000000039769.jpg"  # two cats on a sofa
photo = Image.open(io.BytesIO(urllib.request.urlopen(url).read()))
print(model.system_one(None, {"cats": {"type": "choice", "instructions": "How many cats are there?",
                                       "criteria": {"one": "One", "two": "Two", "more": "Three or more"}}},
                       images=[photo]))

# Many requests, packed together with no padding
tickets = ["Where is my parcel? It was due Monday.", "The app crashes when I open settings."]
print(model.system_one_batch([(t, {"team": questions["team"]}) for t in tickets]))
Por brevedad, solo incluimos el ejemplo de d1-3B. Consulte la ficha del modelo d1-omni-600M para obtener instrucciones sobre cómo ejecutarlo.
Comience con los modelos de decisión d1 abiertos
Ambos modelos de decisión son de pesos abiertos y están disponibles en Hugging Face hoy:
- Descargue: d1-3B y d1-omni-600M en Hugging Face.
- Pruebe: ejecute las demos en nuestro System One Arcade Hugging Face Space.
Estamos deseando ver lo que construya.
Citación
Si utiliza este trabajo, por favor cite la entrada del blog de la versión:
@article{liquidAI2026opend1,
  author  = {Liquid AI},
  title   = {Open d1: Edge decision models for text, vision, and audio},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/open-d1},
}