
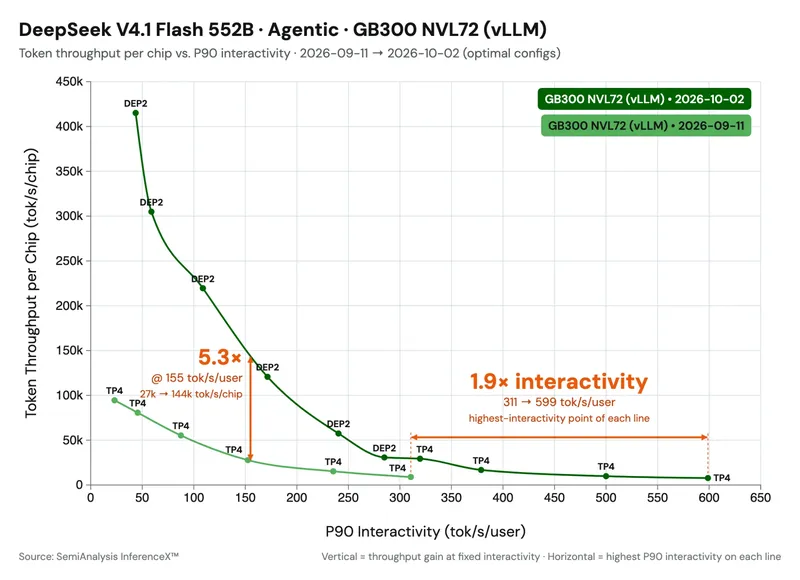
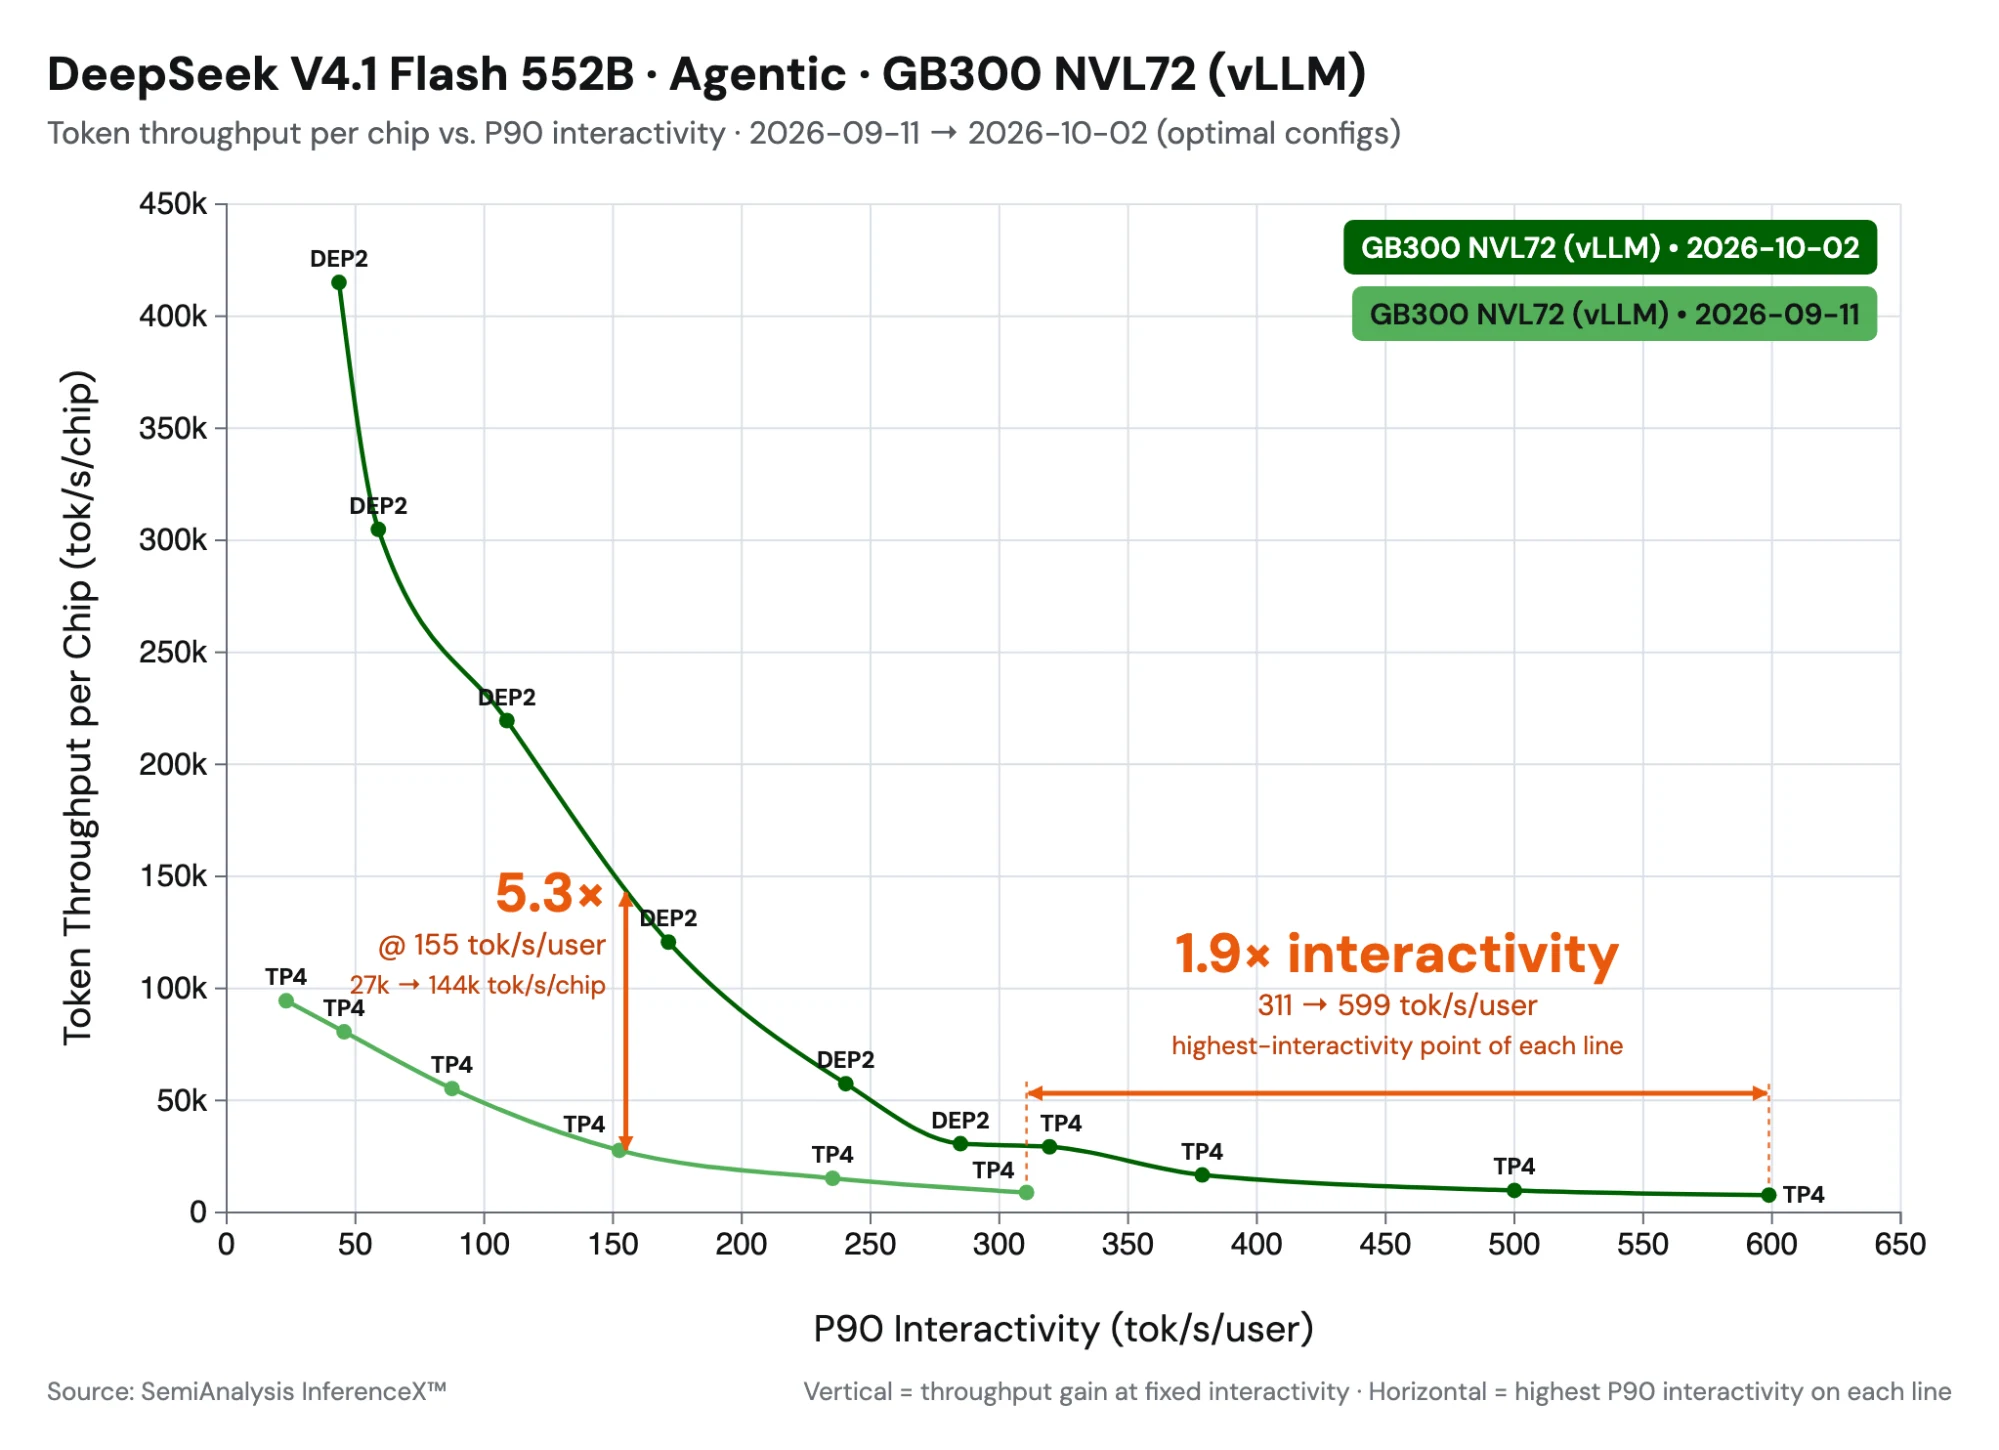
TL;DR: En las tres semanas posteriores al lanzamiento de DeepSeek-V4.1-Flash, Inferact y la comunidad de vLLM optimizaron el modelo, logrando una aceleración de 1.9× a baja concurrencia y una mejora de 5.3× en el rendimiento bajo una restricción de 150 TPS. La mejora de rendimiento proviene de:
-
Implementamos SWA bounded replay con CUDA graphs, logrando una reducción de ~30% en el TTFT.
-
Integramos los kernels recién lanzados por DeepSeek, incluidos MegaAttention, Mega-mHC, Mega-Gate y DeepSelect.
-
Fusionamos y paralelizamos agresivamente los kernels restantes, incluidos los flujos laterales de mHC, y fusionamos all-reduce con las operaciones previas y posteriores en un solo kernel.
DeepSeek V4.1 introduce una arquitectura altamente eficiente para tareas de servicio agéntico de largo horizonte: con su arquitectura encoder-decoder causal (CED), el modelo activa 16B de parámetros por token durante el decode pero solo 8B durante el prefill. El modelo también es extremadamente eficiente en memoria. Combina varias técnicas para reducir el tamaño del KV cache: Compressed Sparse Attention 2 (CSA2), FP4 KV cache y uso compartido de KV cache entre capas, llevando la huella global de KV a 890 bytes por token. Esta publicación muestra cómo combinamos estas optimizaciones a nivel de modelo de DeepSeek con optimizaciones de sistema del lado de vLLM para lograr 5× de rendimiento en el benchmark de servicio agéntico SemiAnalysis AgentX. Destacamos nuestras optimizaciones en dos categorías: SWA bounded replay y optimizaciones relacionadas con kernels.
SWA bounded replay
DeepSeek-V4.1-Flash mantiene dos tipos de KV caches. El KV global está comprimido, compartido entre capas y almacenado en FP4, a unos 890 bytes por token (informe de V4.1). El KV de ventana deslizante (SWA) está sin comprimir en FP8, cubriendo las últimas 128 posiciones en cada una de las 40 capas.
El KV de SWA crea dos costos:
-
El prefix caching debe almacenarlo en cada posible límite de acierto, costando más de 10× el almacenamiento del KV global.
-
El prefill ejecuta las capas 21–39 en cada token del prompt, aunque el decode solo lee sus últimas 128 posiciones.
Un enfoque directo es recomputar el KV de SWA en lugar de almacenarlo en caché. Sin embargo, la recomputación exacta es costosa, porque la ventana de 128 tokens de cada capa depende de posiciones anteriores en la capa inferior, por lo que reconstruirla a través de L capas significa reproducir aproximadamente L × 128 tokens.
DeepSeek V4.1 introduce SWA bounded replay, que intercambia exactitud por eficiencia. Vuelve a ejecutar solo los últimos 128 tokens y recorta la ventana SWA al inicio de la repetición. El resultado no es bit-exacto, pero DeepSeek informa una pérdida de calidad insignificante (detalles abajo). vLLM lo aplica en dos lugares, uno para cada costo.
Lado del encoder: reconstruir la ventana en un acierto de caché
Con la repetición del lado del encoder, vLLM almacena en caché solo el KV global y omite el KV de SWA. En un acierto de prefijo de longitud H, vuelve a ejecutar los tokens [H − 128, H) para reconstruir el KV de SWA, con ventanas recortadas en s = H − 128.
Lado del decoder: omitir la mayor parte del prefill del prompt
En la arquitectura CED de DeepSeek V4.1, la capa 20 calcula el KV global del decoder y las capas 21–39 lo reutilizan. Por lo tanto, vLLM ejecuta la capa 20 en cada token para producir ese KV global, y ejecuta las capas 21–39 solo en los últimos 128 tokens de cada solicitud. Para prompts largos, esto omite casi la mitad del modelo.
CUDA graphs para las capas recortadas
Después del recorte, las capas 21–39 hacen tan poco trabajo en la GPU que, ejecutadas de forma eager, la sobrecarga de lanzamiento de kernels domina y la GPU queda inactiva. Sus formas de entrada también difieren de las capas 0–20, por lo que las dos partes no pueden capturarse en un solo CUDA graph. El grafo PIECEWISE interrumpible de vLLM ya se interrumpe en el medio del modelo, lo que da una división natural: las capas 0–20 se capturan en el lote completo, y las capas 21–39 se capturan por separado en el lote recortado. Esto hace que los CUDA graphs sean utilizables para el prefill recortado, y permite que las capas 21–39 usen sus propios tamaños de captura para una mejor cobertura de grafos.
SWA bounded replay está activado por defecto para DeepSeek-V4.1 y se controla mediante --[no-]swa-bounded-replay.
Resultados de precisión y rendimiento
Aunque SWA bounded replay no es exacto, DeepSeek ha informado solo una pérdida de calidad insignificante. Lo confirmamos en vLLM en benchmarks que incluyen GSM8K y GPQA y observamos ninguna diferencia significativa de precisión (brechas dentro de aproximadamente 1.5 errores estándar).
En cuanto al rendimiento, el lado del encoder intercambia una ventana de prefill por acierto a cambio de espacio de caché, por lo que la aceleración proviene del lado del decoder. Medimos el TTFT de prefill de una sola solicitud en tres configuraciones: replay desactivado; replay activado sin CUDA graphs del decoder (las capas 21–39 se ejecutan de forma eager, y solo se recortan los pasos eager); y replay activado con CUDA graphs del decoder.
La repetición del decoder con CUDA graphs reduce el tiempo de cómputo de prefill en 30–40%. Los CUDA graphs importan más para los prompts cortos, donde los lanzamientos de kernels son el cuello de botella: sin ellos, la sobrecarga de lanzamiento supera el ahorro de GPU y la repetición es más lenta que la línea base (hasta +12% a 1K en DEP2). Para prompts largos, el trabajo de la GPU es lo suficientemente grande como para ocultar la sobrecarga de lanzamiento, por lo que la repetición eager ya captura la mayor parte de la ganancia y los CUDA graphs añaden unos puntos más.
Kernels
DeepSeek lanzó DeepSeek-V4.1-Flash junto con nuevos kernels en tres de sus repositorios. DeepSelect es una nueva biblioteca top-k para DeepSeek Sparse Attention. DeepGEMM añadió kernels de indexador disperso y varios kernels fusionados relacionados con GEMM. FlashMLA añadió soporte de NVFP4 KV cache y un kernel de atención fusionado, MegaAttention. Hemos integrado varios de estos kernels de código abierto en vLLM y seguimos el progreso en #57448.
Mega-mHC (#56962). Mega-mHC fusiona la cadena mHC en un solo kernel: el paso post, el paso delayed-pre y RMSNorm. Reemplaza una ruta fusionada existente en TileLang que la implementación de DeepGEMM ahora supera. El kernel es 1.14–1.51× más rápido que la versión TileLang en NVIDIA GB200.
Mega-Gate (#56266). Mega-Gate fusiona el router MoE (GEMM de gate, puntuación de expertos, sesgo y selección top-k) en un solo kernel. Anteriormente, estas operaciones se ejecutaban como un GEMM seguido de un kernel top-k separado, lo que costaba un lanzamiento adicional y un viaje de ida y vuelta por la memoria para las puntuaciones. Esta fusión produce aceleraciones de kernel de 1.18–1.31× en tamaños de lote medianos.
Solapamiento multistream de mHC (#57603). En V4.1, los coeficientes mHC se desplazan una subcapa, por lo que el GEMM de coeficientes de la siguiente costura lee solo flujos residuales que ya existen antes de que se ejecute la atención o el FFN. Ninguna de las partes necesita la salida de la otra hasta que el siguiente paso post/pre las combine. En tamaños de lote pequeños, vLLM ahora calcula los coeficientes del siguiente bloque mHC en un stream CUDA lateral, en paralelo con la atención y el FFN. Esto oculta trabajo que de otro modo quedaría en la ruta crítica del decodificado limitado por latencia. En el escenario TP4 de baja latencia, esto reduce la latencia en aproximadamente 4%.
Logits MQA dispersos (#56254). En V4.1, las capas indexadoras posteriores eligen su top-k de un conjunto fijo de 16K posiciones candidatas. Las implementaciones anteriores calculan la puntuación para todo el contexto y enmascaran todos los bloques no candidatos antes de puntuar. Los kernels dispersos de DeepGEMM puntúan solo los candidatos, por lo que el costo ya no crece con el contexto. Por capa en NVIDIA GB300, es 1.2× más rápido a 8K tokens y 14–23× más rápido a 512K. De extremo a extremo en 4× NVIDIA GB300, el decodificado mejora 3–6%. El prefill es 1.43× más rápido a 512K y 2× más rápido a 1M de contexto.
MegaAttention con KV comprimido NVFP4 (#56935). El kernel MegaAttention de FlashMLA realiza query RoPE, atención dispersa, inverse RoPE sobre la salida y la conversión a FP8 en un solo lanzamiento, escribiendo directamente en el búfer que lee la proyección de salida. Eso elimina los kernels separados y los viajes de ida y vuelta de memoria entre la atención y la siguiente capa. También lee un nuevo formato de KV comprimido NVFP4, que es 45% más pequeño que la caché KV FP8 anterior. MegaAttention también mejora la eficiencia del kernel en 1.45× mediante una fusión agresiva que elimina las escrituras en HBM entre operaciones.
Kernel fusionado WO-A de baja latencia (#58634). Para lotes de decodificado pequeños en Blackwell, fusionamos inverse RoPE, cuantización FP8, el GEMM de lote WO-A y la recuantización MXFP8 en un solo kernel CuTe-DSL, reduciendo la cadena previa a WO-B de tres kernels a uno. La idea clave es mantener las activaciones intermedias en el chip y canalizar el movimiento de datos con el cómputo, evitando lanzamientos adicionales de kernels y viajes de ida y vuelta a la memoria global que dominan en tamaños de lote pequeños. Esto mejora la ruta fusionada WO-A hasta en ~2.1× y ofrece hasta ~6–7% menos latencia entre tokens en baja concurrencia.
Engram. Las capas Engram de V4.1 buscan filas en dos grandes tablas FP8 indexadas por n-gramas de tokens con hash. Cada paso lee solo unas pocas filas, por lo que la ubicación de las tablas y la latencia de búsqueda importan más que el cómputo. Precargamos de forma asíncrona las búsquedas de Engram descargadas a la CPU, solapando el acceso a la memoria del host con el cómputo del decodificador para acelerar el decodificado de lotes pequeños (#56512). Las cabezas Engram se fragmentan con un esquema unificado TP/DP, y las réplicas DP colocadas en el mismo lugar comparten las mismas tablas del host, evitando copias redundantes y cualquier comunicación DP en la ruta de búsqueda (#57651). Para estas grandes tablas residentes en el host, también soportamos transparent huge pages (THP) para reducir la sobrecarga de fallos de página, ofreciendo kernels de búsqueda hasta 10× más rápidos para prefills (#56926). También añadimos optimizaciones para los casos que no tienen suficientes huge pages disponibles (#59327).
Rendimiento agéntico
Medimos el rendimiento con el benchmark SemiAnalysis AgentX como una carga de trabajo representativa de servicio agéntico (detallado en nuestra publicación anterior). Juntas, estas optimizaciones le dan a vLLM mejoras significativas de rendimiento sobre nuestra implementación del día 0. Como muestra la Figura 6, nuestro resultado de baja latencia mejora 1.9× sobre nuestro resultado del día 0, y el resultado de alto rendimiento mejora aproximadamente 5×.
Para el servicio de baja latencia, usamos TP4 con atención FlashInfer. El decodificado de lotes pequeños está mayormente limitado por el ancho de banda de memoria, por lo que fragmentar los pesos del modelo entre cuatro GPUs es una buena opción. También probamos MegaAttention, pero su principal ventaja está en configuraciones de mayor rendimiento donde la fusión tiene más espacio para ayudar. En TP4, ese beneficio era mucho menor, y FlashInfer resultó ser más rápido en nuestras ejecuciones.
Para un alto rendimiento, pasamos a DEP2, usando atención DP con expertos repartidos entre las GPU. Dado que V4.1 usa un latente KV compartido entre todas las cabezas, TP duplicaría la caché KV en las GPU. DP evita esta duplicación: cada GPU almacena KV solo para las solicitudes que atiende, y la afinidad de sesión preserva la localidad de la caché de prefijo entre turnos. MegaAttention reduce además la huella de KV por solicitud con NVFP4, reduciéndola casi a la mitad frente a FP8 y aumentando la concurrencia por GPU.
En particular, V4.1 es altamente eficiente en memoria y no necesita offloading de la caché KV durante todo el benchmark. Esperamos que el offloading de la caché KV empiece a ser útil a mayor concurrencia con desagregación P/D.
La reproducción acotada SWA, junto con optimizaciones de kernels en el lado del prefill, también mejoró enormemente el TTFT.
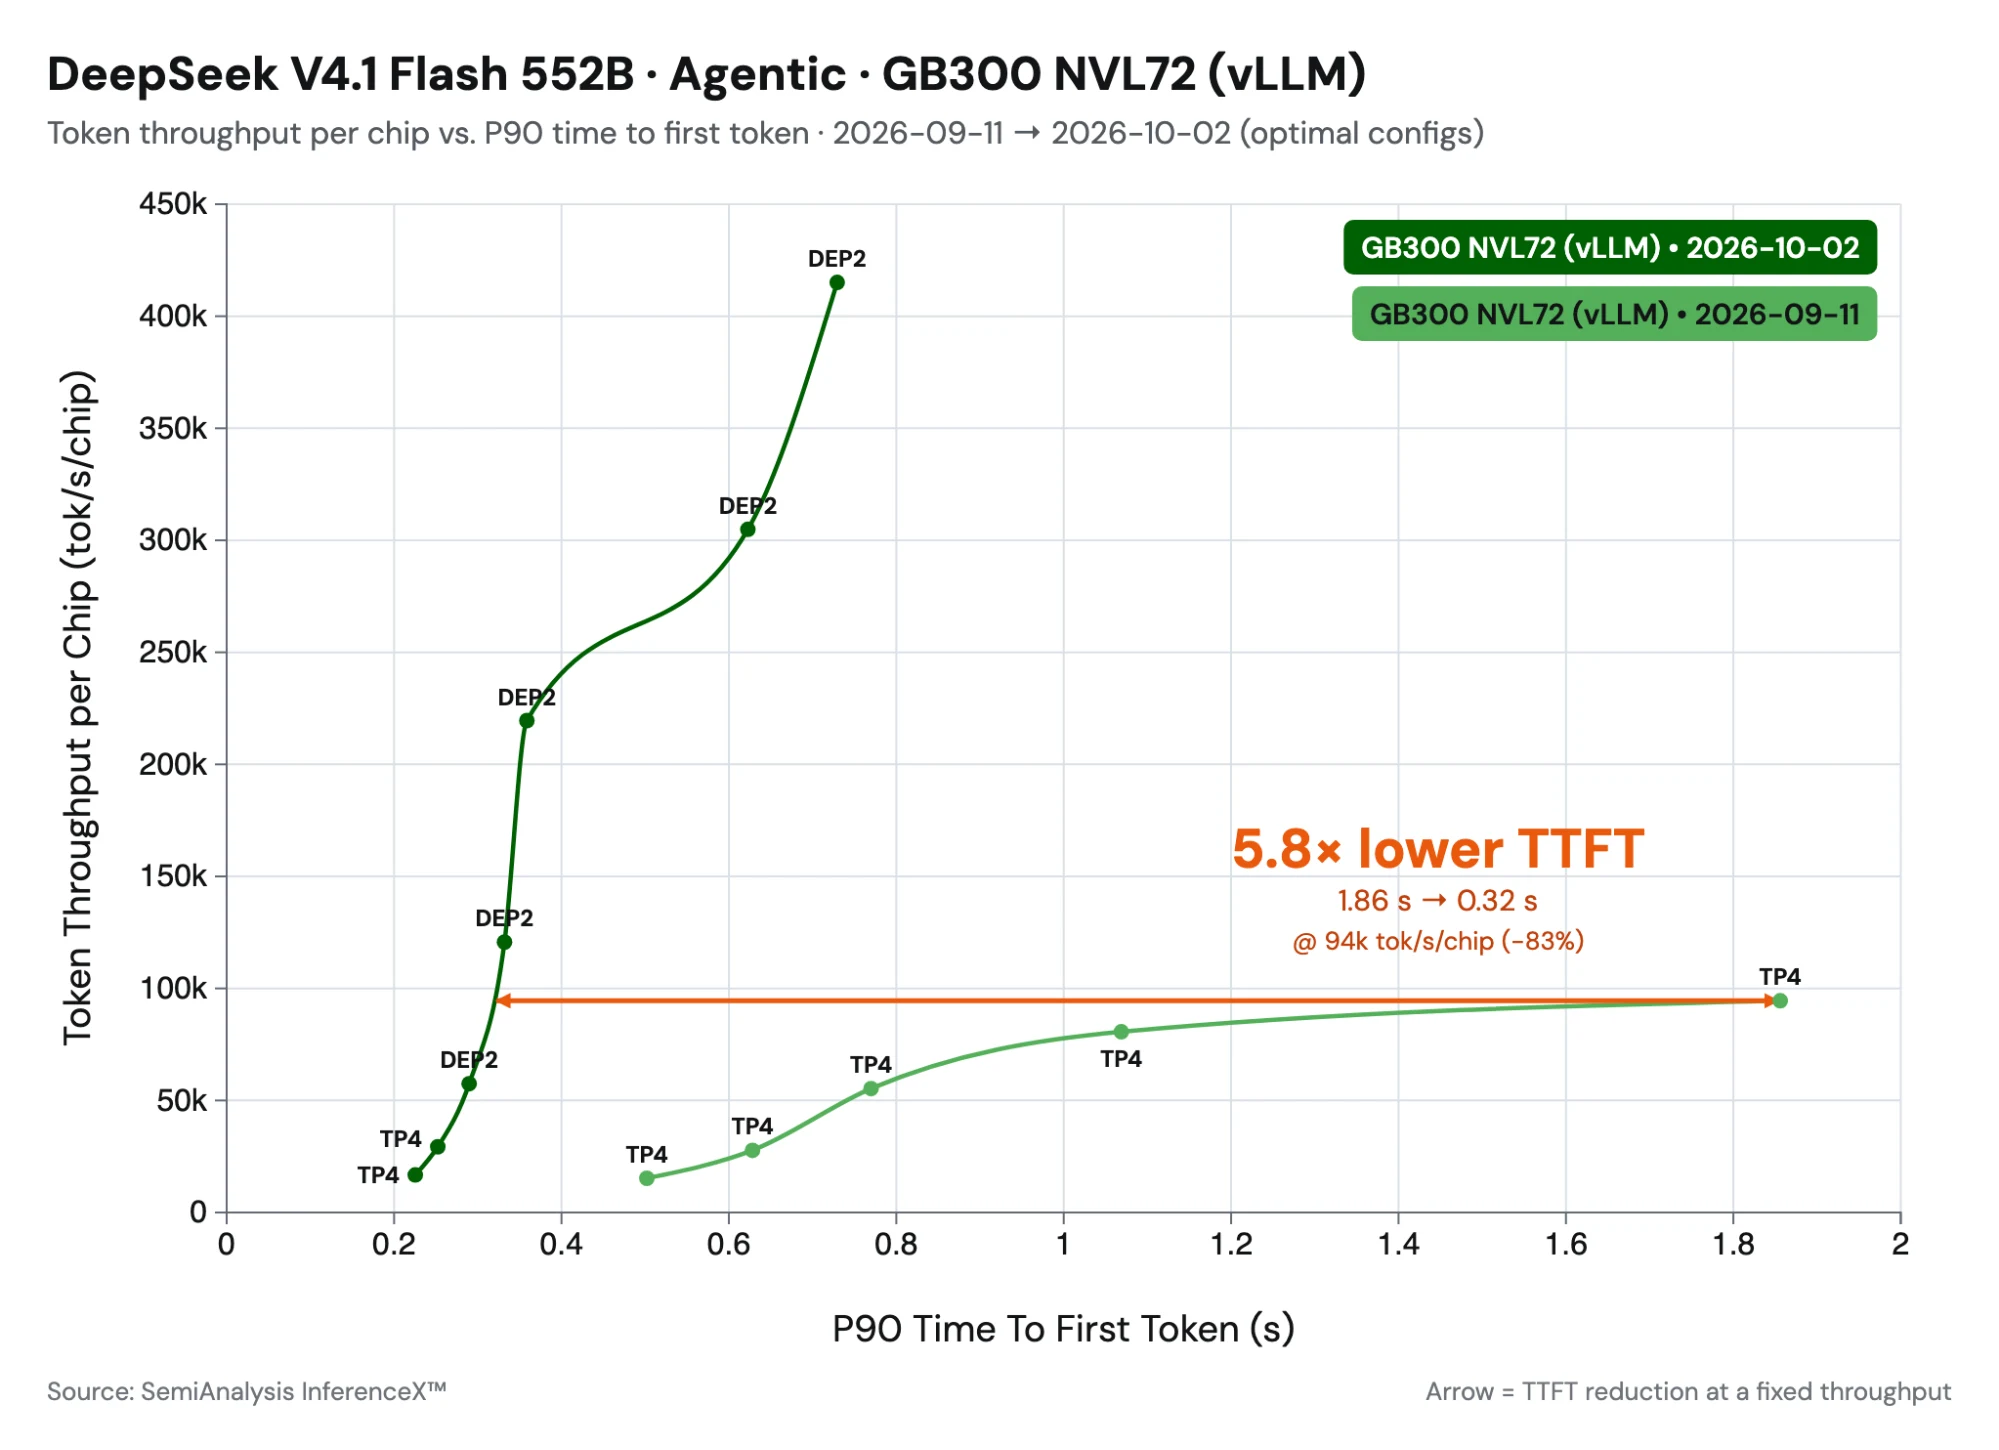
La Figura 7 muestra el compromiso optimizado entre TTFT y rendimiento. A un rendimiento de alrededor de 100K, el TTFT cae casi un 70% gracias a tres optimizaciones combinadas:
-
La reproducción acotada SWA permite que la mitad superior del modelo procese solo los últimos 128 tokens, reduciendo el cálculo de prefill aproximadamente a la mitad.
-
Los CUDA graphs mantienen la pequeña reproducción recortada rápida en la GPU en lugar de verse limitada por los lanzamientos de kernels de CPU, de modo que aprovechamos toda la aceleración.
-
Las mejoras en los kernels aceleran el cálculo del modelo.
Agradecimientos
Agradecemos a DeepSeek por hacer open source DeepSeek-V4.1-Flash y los kernels asociados, al equipo de Inferact por el arranque inicial del modelo y sus optimizaciones, a NVIDIA por su colaboración y apoyo, y a SemiAnalysis por el benchmark AgentX.