
IT之家 mensaje del 8 de octubre: en el evento celebrado en San Francisco, Estados Unidos, a las 10 a. m. del 7 de octubre, hora del Pacífico (la 1 a. m. del 8 de octubre, hora de Pekín), Microsoft anunció que GitHub Copilot admitirá la inferencia con modelos de IA locales antes de fin de mes.Los desarrolladores podrán cambiar de forma automática o manual entre modelos en la nube y modelos en el dispositivo.
GitHub Copilot es el asistente de programación con IA de Microsoft, que puede integrarse en herramientas como Visual Studio Code y la CLI, y genera sugerencias de autocompletado, explicaciones o refactorización según el contexto del código.
GitHub Copilot depende actualmente de modelos alojados en la nube, con un orquestador que enruta las solicitudes según rendimiento, coste y precisión. Microsoft planea ampliar este mecanismo a fin de mes para permitir que Copilot elija automáticamente entre modelos en la nube y modelos de IA locales, coordinando las tareas de inferencia en segundo plano.
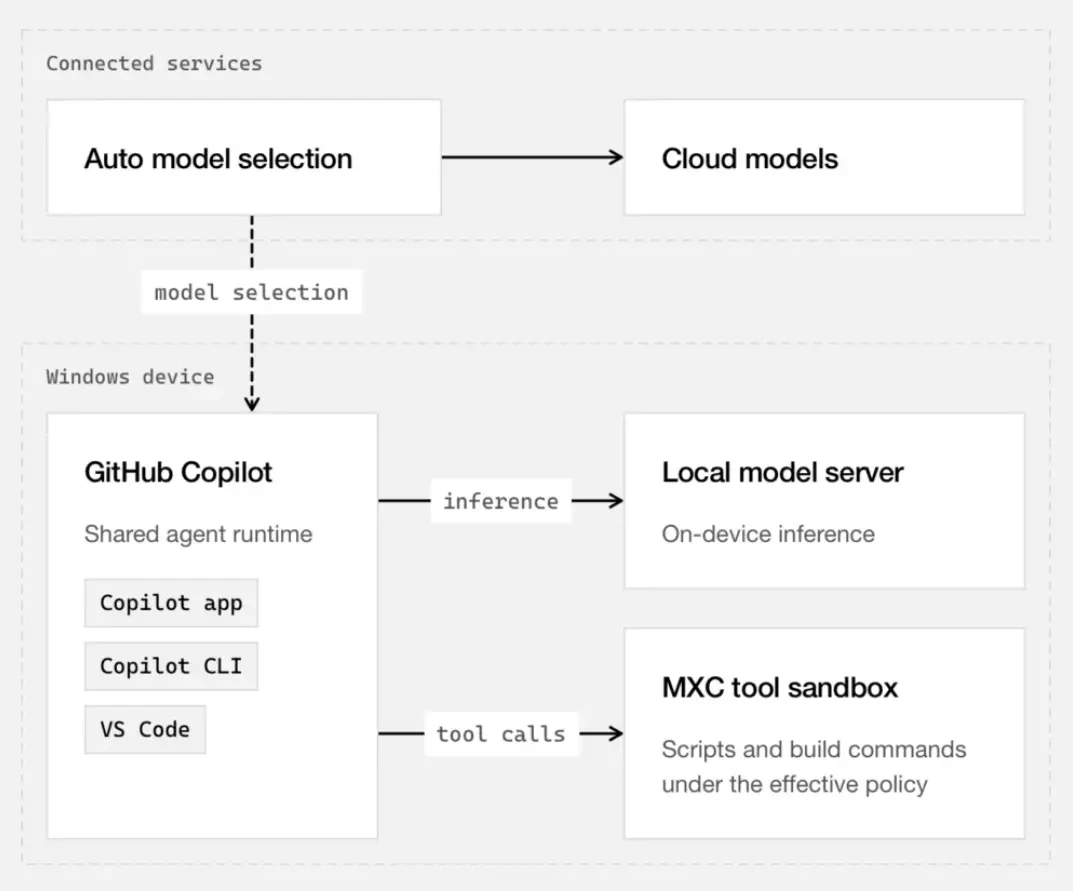
Microsoft ofrece a los usuarios de GitHub Copilot dos modos: orquestación automática o uso forzado del modelo del dispositivo. Los usuarios pueden configurar sus preferencias en GitHub Copilot CLI, la aplicación Copilot y Visual Studio Code.
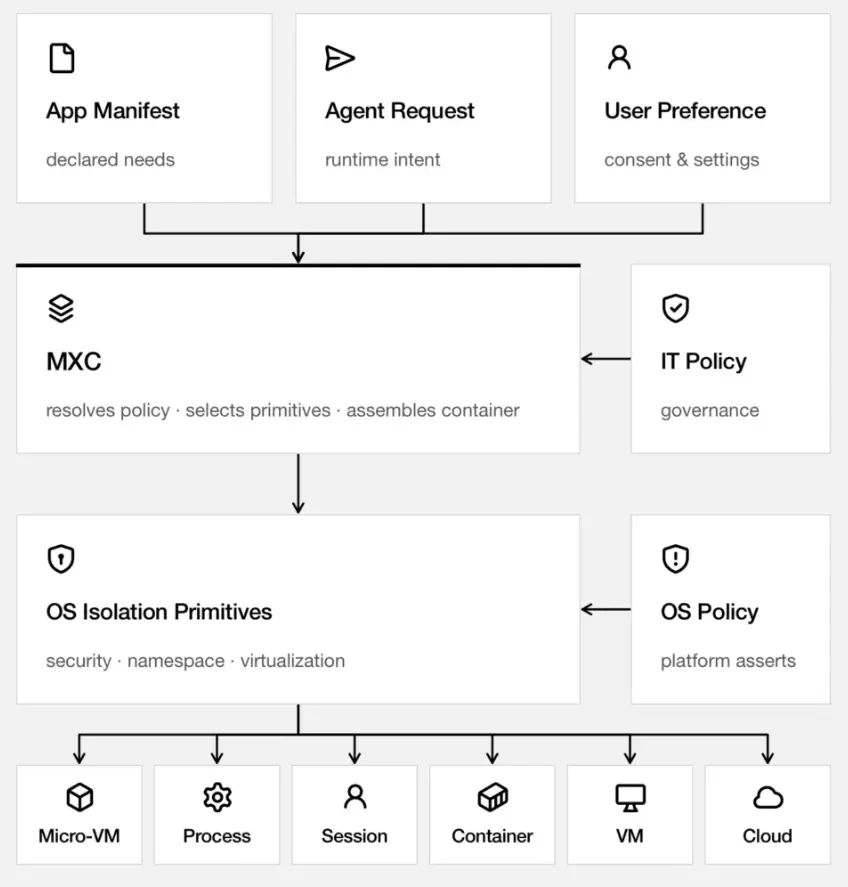
La selección de modelos locales admite especificar el proveedor, el modelo o el punto de conexión; los desarrolladores pueden elegir MAI Code 1.1 Flash mediante Windows ML, o conectarse a un punto de conexión local compatible con OpenAI y usar los modelos que este exponga.
Microsoft lanzó el modelo MAI Code 1.1 Flash de "mezcla de expertos", con 137.000 millones de parámetros totales y 6.800 millones de parámetros activos, que utiliza cuantización y decodificación especulativa para optimizar la velocidad de respuesta y el uso de memoria.
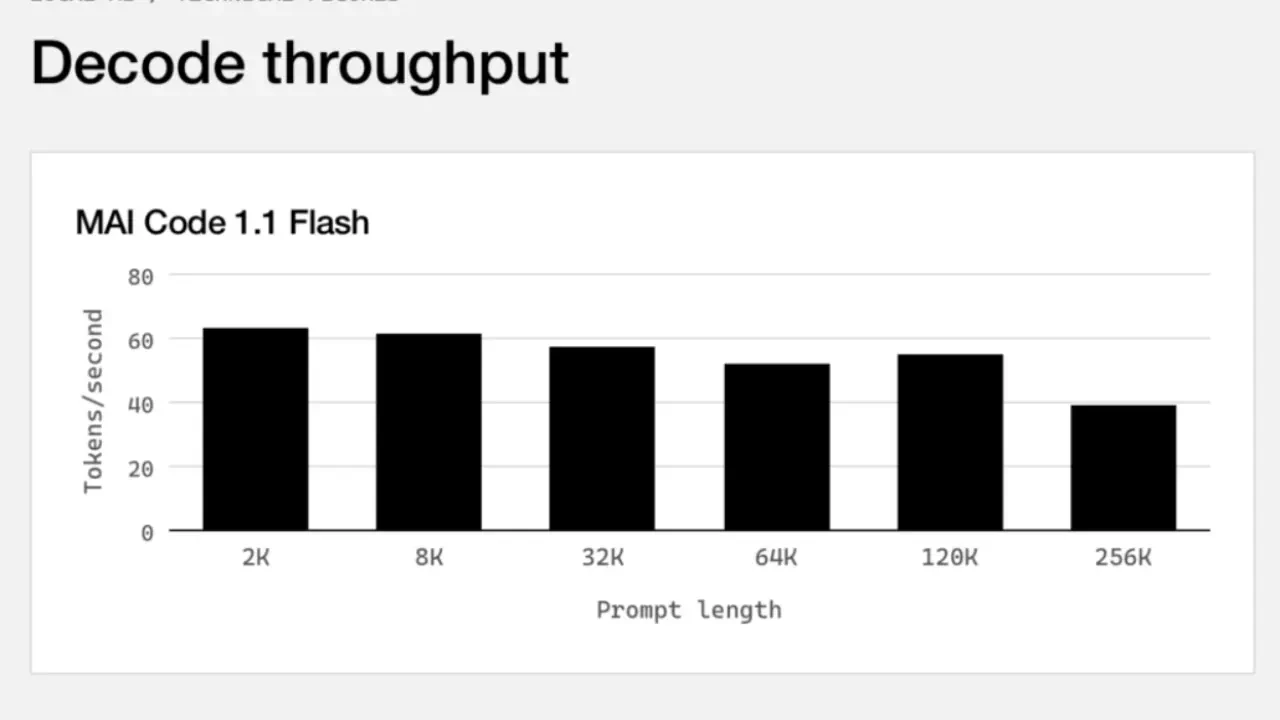
Las pruebas del modelo en el Surface Laptop Ultra muestran mejoras significativas en el pico de uso de memoria, la utilización de tokens y la velocidad de procesamiento en tareas complejas. Las pruebas de rendimiento de decodificación indican que, con longitudes de prompt de 2K a 256K tokens, el rendimiento oscila entre 40 y 63 tokens por segundo. IT之家 adjunta las imágenes correspondientes a continuación:
Especial sobre la presentación del Microsoft Surface Laptop Ultra