
¿Quién enseñó a la IA a resolver los problemas de razonamiento abstracto del ARC? Pues los gatos.
El último artículo del equipo de He Kaiming proponeNAT-ARC, una solución puramente visual para resolver el ARC.
No depende de LLM: se preentrena con gatos, perros, flores y plantas de ImageNet para que el modelo aprenda a «ver», y luego traslada esa capacidad al razonamiento con cuadrículas abstractas.
Como resultado, el mejor modelo individual de NAT-ARC obtuvo un puntaje pass@2 de 63.4% en ARC-1, y al integrarlo alcanzó el 70.2%.
Es la primera vez que una solución puramente visualse acerca al nivelde los sistemas LLM especializados.
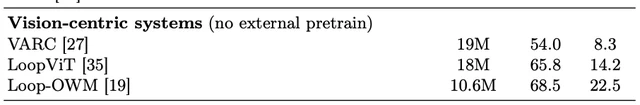
El ARC, reconocido como uno de los test de inteligencia visual más difíciles para la IA, te da algunos ejemplos de entrada y salida con cuadrículas de colores, y debes inferir la regla de transformación oculta y aplicarla a nuevas cuadrículas.
Las soluciones dominantes del pasado convertían las cuadrículas a texto o símbolos sin excepción, dejando el razonamiento a los LLM.
Este artículo se niega a hacerlo, e incluso en la fase de preentrenamiento no usó en absoluto las cuadrículas del ARC.
Las capacidades visuales que el modelo aprendió del mundo real se trasladaron lisa y llanamente al razonamiento con cuadrículas de colores completamente abstractas.
La pista del ARC: el auge de las soluciones visuales
ARC, cuyo nombre completo es Abstraction and Reasoning Corpus, fue propuesto en 2019 por François Chollet, el creador de Keras.
El formato de cada problema del ARC es muy uniforme: una cuadrícula bidimensional de hasta 30×30, con un máximo de 10 colores; el problema da de 2 a 5 pares de ejemplos de entrada y salida, y el concursante debe inferir la regla de transformación oculta a partir de los ejemplos y aplicarla a una cuadrícula de entrada completamente nueva para predecir su salida.
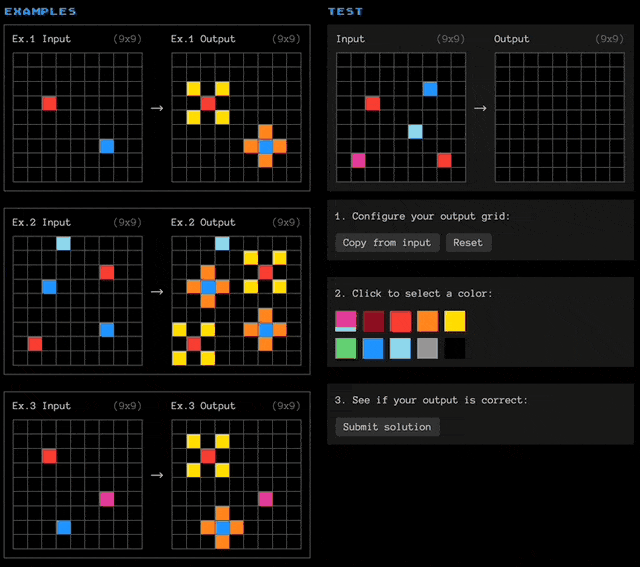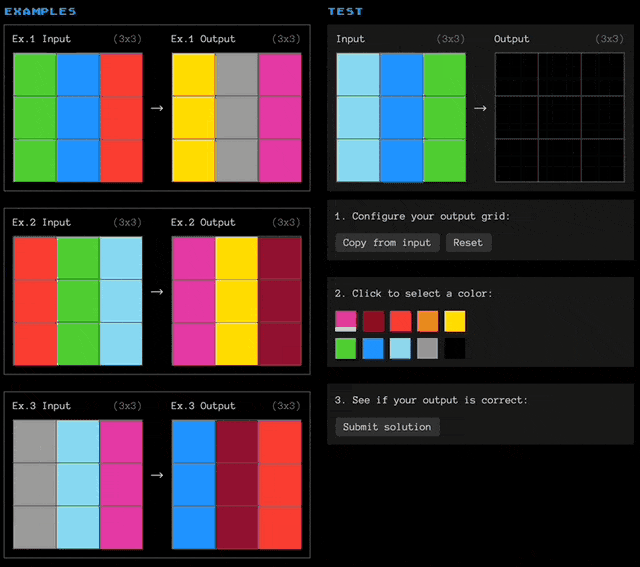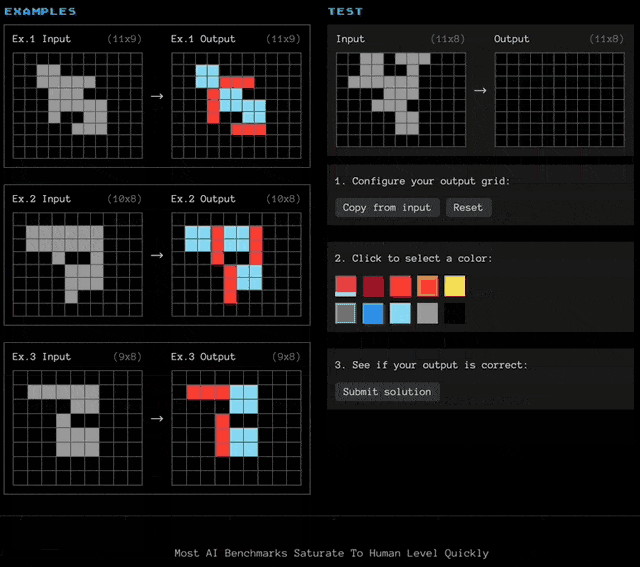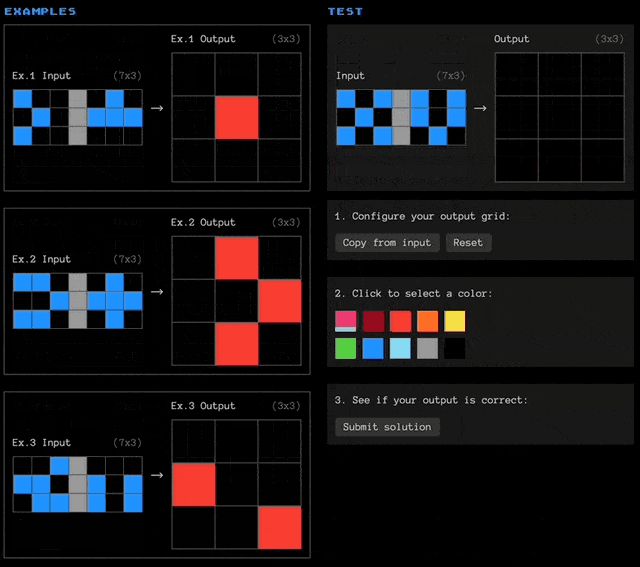
Estos problemas suenan como los juegos infantiles de encontrar patrones en imágenes, pero para la IA el ARC es sumamente difícil.
Por un lado, la regla de transformación de cada problema es diferente, y no hay una plantilla fija que memorizar.
Además, hay muy pocos datos: con dos o tres ejemplos hay que inducir una regla abstracta y ejecutarla con precisión.
Esta combinación ha convertido al ARC enel estándar de referencia para medir la capacidad de razonamiento abstracto de la IA.。
Actualmente, casi todos los que dominan la pista del ARC son soluciones basadas en grandes modelos de lenguaje, cuyo enfoque común consiste en traducir las cuadrículas a secuencias de texto o símbolos para procesarlas con modelos de lenguaje.
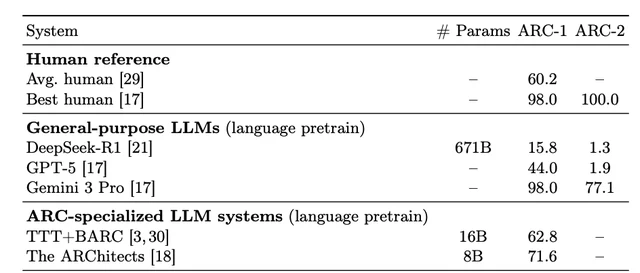
La ruta visual comenzó a surgir más tarde.
Un grupo de investigadores tomó un camino completamente distinto: en lugar de traducir las cuadrículas a texto, decidieron procesar directamente las imágenes de las cuadrículas con modelos visuales.
El paso más importante provino del mismo equipo del MIT, que propusoVARC, un método que redefine el ARC como una tarea de traducción de imagen a imagen condicionada, alcanzando un 54% con un modelo visual de 19M de parámetros.
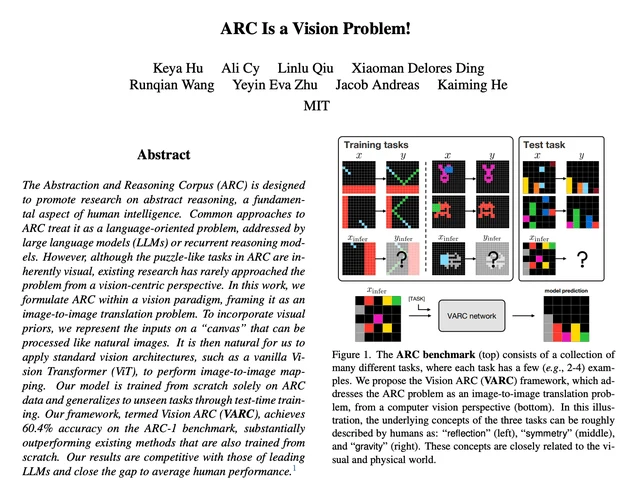
LoopViT añadió a este marco un mecanismo de razonamiento recurrente, alcanzando 65.8% con 18M de parámetros.
Loop-OWM usó un modelo preentrenado con video para few-shot, alcanzando 68.5% con 10.6M de parámetros.
La cantidad de parámetros de estos modelos es varios órdenes de magnitud menor que la de las soluciones basadas en LLM, pero su rendimiento ya ha comenzado a igualarlas.
Sin embargo, la ruta visual sigue teniendo una deficiencia estructural.
Una de las razones principales por las que los LLM logran resultados cada vez mejores en ARC es que, mediante el preentrenamiento con enormes cantidades de corpus, acumulan capacidades generales: cuanto mayor es el modelo y más completo es el preentrenamiento, más evidente es el scaling en las tareas posteriores.
Sin embargo, la mayoría de los modelos de los enfoques visuales de ARC se entrenan desde una inicialización aleatoria y no se benefician de las ventajas del preentrenamiento.
Sobre esta base, el objetivo de NAT-ARC es añadir el paso del preentrenamiento a la vía visual, intentando desbloquear su cuello de botella de scaling.
Después de ver al gatito, el reto ARC
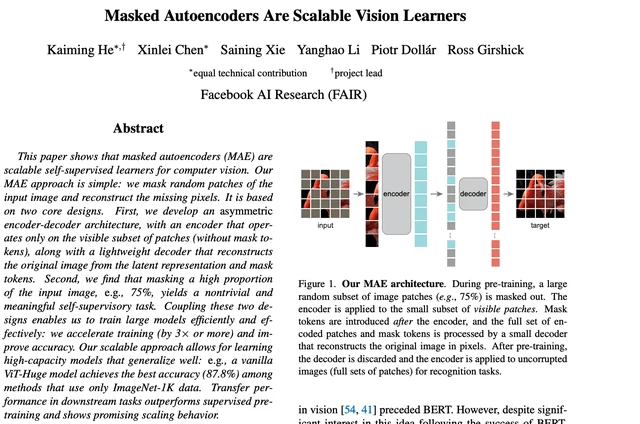
La idea central de NAT-ARC esinsertar, antes del flujo visual de VARC, un paso de preentrenamiento con ImageNet MAE。
MAE, Masked Autoencoder, es un método de preentrenamiento visual autosupervisado propuesto por Kaiming He en su etapa en FAIR en 2022.
Su proceso de entrenamiento consiste en ocultar la mayor parte de una imagen y hacer que el modelo reconstruya la imagen original a partir de los fragmentos restantes.
Mediante esta tarea, el modelo puede comprender la forma, la estructura y las relaciones espaciales de los objetos.
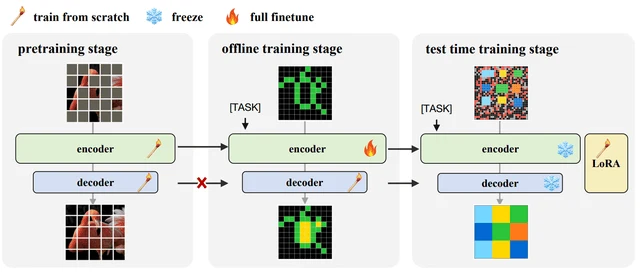
El enfoque de NAT-ARC consiste en tomar directamente los pesos del encoder entrenado con MAE en ImageNet (un conjunto de datos que contiene alrededor de 130万 imágenes naturales de gatos, perros, flores, plantas, etc.) para inicializar el codificador visual, mientras que el decoder se entrena desde una inicialización aleatoria.
Todo el proceso se divide en tres pasos.
- Primer paso: preentrenar el encoder con MAE en ImageNet;
- segundo paso: entrenar fuera de línea todo el codificador-decodificador en el conjunto de entrenamiento de ARC;
- tercer paso: en la prueba, realizar un ajuste fino con LoRA por separado para cada problema.
En la fase de ajuste fino, cada problema solo tiene entre 2 y 5 pares de demostración, y el modelo usa esos pares para intentar «aprender» la regla del problema.
Hay un detalle que vale la pena señalar: NAT-ARC usó directamente el checkpoint público de MAE, sin gastar ni un céntimo adicional en preentrenamiento.
Sin embargo, ese checkpoint estaba diseñado originalmente para imágenes de ImageNet de mayor tamaño, mientras que las cuadrículas de ARC tienen solo 64×64 píxeles, una gran diferencia de tamaño.
Para adaptarse, NAT-ARC descartó el patch embedding original y la codificación posicional, conservando solo los pesos del backbone, y los reemplazó con 2D RoPE como codificación posicional.
En pocas palabras, NAT-ARC solo conservó la capacidad de extracción de características visuales que MAE aprendió en ImageNet, y descartó por completo la parte de percepción espacial ligada al tamaño de las imágenes de ImageNet, reaprendiéndola de una manera más flexible.
Pero, ¿por qué lo aprendido al ver fotos de gatos y perros puede ayudar al razonamiento con cuadrículas abstractas?
El artículo ofrece una pista mediante la visualización de la atención.
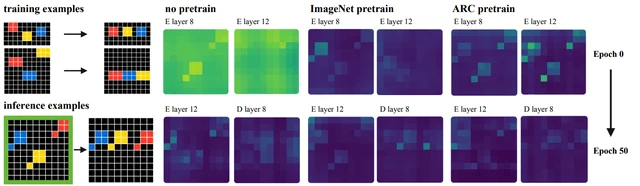
Los investigadores pusieron a modelos con tres tipos de inicialización (sin preentrenamiento, preentrenamiento con MAE de ImageNet y preentrenamiento con MAE de cuadrículas estilo ARC) ante el mismo problema de ARC, y observaron su distribución de atención antes de comenzar el entrenamiento en ARC.
El resultado fue evidente: la atención del modelo con inicialización aleatoria estaba distribuida uniformemente, sin ningún foco; en cambio, el modelo preentrenado con ImageNet ya podía distinguir el primer plano del fondo, y su atención se enfocaba automáticamente en las regiones de la cuadrícula con patrones significativos.
Este modelo nunca había visto una cuadrícula de ARC; la capacidad que aprendió en ImageNet de «reconocer los objetos separándolos del fondo» funcionó de manera natural sobre las cuadrículas de ARC.
Los investigadores realizaron además un desglose a nivel de tarea.
Seleccionaron 15 problemas de ARC que mejoraron significativamente tras el preentrenamiento y, tras anotarlos manualmente, descubrieron que estos problemas se concentraban en dos tipos de tareas.
其中6 de ellas pertenecen a match-and-copy, donde el modelo debe identificar el objeto, color o patrón coincidente y luego copiar la estructura correspondiente en la salida;
otros 6 pertenecen a connected-component reasoning, donde el modelo debe identificar, rellenar o recolorear regiones espacialmente conectadas.
Estas dos capacidades corresponden precisamente a los prioris visuales de las imágenes naturales.
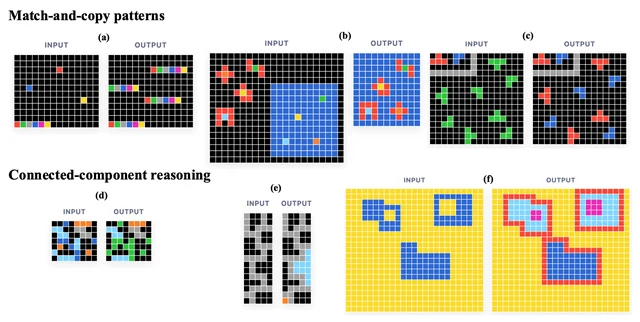
Lo aprendido en ImageNet al ver gatos, «separar al gato del fondo de césped», se convirtió en ARC en «reconocer esta región de color conectada dentro de la cuadrícula».
La lógica subyacente del mundo visual y del mundo abstracto, en operaciones como la agrupación de objetos, la coincidencia de patrones y la segmentación de regiones, comparte en realidad el mismo conjunto de representaciones.
Del mundo de los gatitos viene, al mundo de los gatitos va
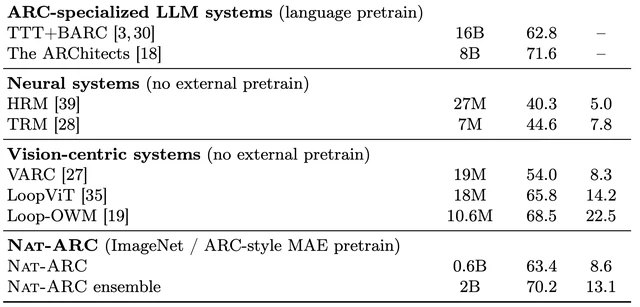
Los resultados finales de NAT-ARC en ARC-1 son los siguientes.
El mejor modelo individual emplea la escala huge, con 0.6B de parámetros, y alcanza un resultado pass@2 de 63.4±0.7%.
Al hacer el ensamble, los investigadores agruparon los modelos entrenados con tres estrategias de preentrenamiento distintas (sin preentrenamiento, preentrenamiento con MAE de ImageNet y preentrenamiento con MAE de cuadrículas estilo ARC) para realizar una votación por mayoría, obteniendo 70.2±0.6% pass@2, con alrededor de 2B de parámetros en total.
Como referencia, The ARChitects, especializados en el ajuste fino para ARC, obtuvieron 71.6% usando un modelo de lenguaje de 8B.
La vía visual, con un cuarto de los parámetros, llegó a las puertas de los sistemas LLM especializados.
Más allá de los números, el descubrimiento más importante de este artículo es que el preentrenamiento eliminó el cuello de botella de escalado (scaling) de la vía visual.
Sin preentrenamiento, cuanto mayor era el modelo, peores eran los resultados; con el preentrenamiento, el scaling comenzó a producir rendimientos positivos.
Veamos primero las curvas de entrenamiento. Durante la fase de entrenamiento offline, los modelos con preentrenamiento de ImageNet convergieron claramente más rápido, tanto en las tres escalas base, large y huge, y también alcanzaron una precisión final mayor.
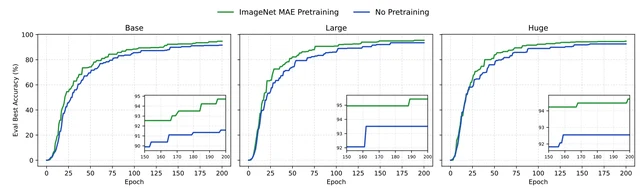
Pero el hallazgo más interesante se esconde en las curvas de scaling.
Sin preentrenamiento, el rendimiento del modelo aún mejora al pasar de base a large, pero al pasar de large a huge empeora.
Que el modelo crezca y el resultado empeore no es un fenómeno común en deep learning, lo que indica que la cantidad de datos de la tarea ARC es realmente demasiado escasa: el aumento de la capacidad del modelo no aporta una mejor generalización, sino sobreajuste.
En cambio, al añadir el preentrenamiento con ImageNet, la curva de scaling se vuelve saludable: las tres escalas base, large y huge suben de forma continua, y cuanto mayor es el modelo, mejor es el resultado.
Uno de los experimentos más geniales del artículo es una verificación mediante visualización.
Los investigadores entrenaron un autoencoder que mapea imágenes de ImageNet a una representación discreta de cuadrícula de 60×60 con 10 colores, lo que equivale a «traducir» una foto de un gato a una cuadrícula ARC.
Luego, usaron NAT-ARC para aplicar a esa cuadrícula una transformación de ARC: rotarla 180° y añadir un borde azul alrededor, antes de decodificarla de vuelta a píxeles.
El resultado: el gato efectivamente quedó rotado y el borde efectivamente se añadió. El modelo entrenado a partir de gatitos volvió, mediante la tarea, al mundo de los gatitos.
Este experimento convierte la afirmación de que «las imágenes naturales y las cuadrículas ARC comparten el mismo espacio de representación» de una estadística en una prueba visual.
Las reglas de transformación aprendidas sobre cuadrículas ARC pueden aplicarse directamente a las representaciones latentes de imágenes naturales, y viceversa.
La conexión entre reglas abstractas y representaciones visuales es algo que estos dos mundos ya poseían de por sí.
Sobre los autores
La primera autora del artículo es Xiaoman Delores Ding, miembro del MIT CSAIL, del grupo de Kaiming He.
También es la primera autora de VARC, por lo que NAT-ARC supone continuar avanzando a partir de su propio trabajo anterior.
Entre los demás autores está Keya Hu, una de las primeras discípulas femeninas de Kaiming He, que se licenció en laUniversidad Jiao Tong de Shanghái。
También están Katelyn Gan y Victor Yin, ambos del MIT, los dos estudiantes de grado y ambos student researcher en CSAIL.
El autor de correspondencia, Kaiming He, no necesita presentación: es el autor de ResNet y MAE, y con estos dos trabajos prácticamente se puede trazar el hilo principal de la IA visual de la última década.
Desde que entró en el MIT ha seguido produciendo trabajos fundamentales en visión, y este artículo utiliza precisamente el MAE que él mismo propuso hace cuatro años como herramienta de preentrenamiento, es decir, emplea su propia arma antigua para abrir un camino nuevo.
VARC ya fue aceptado en CVPR 2026, y NAT-ARC es su continuación directa.
Este equipo ha mantenido durante dos artículos consecutivos la línea puramente visual para resolver ARC; en un terreno dominado por los LLM, están rompiendo constantemente el techo de la vía visual con datos experimentales.
Dirección del artículo:
https://eccv.ecva.net/virtual/2026/poster/5527