
La forma estándar de mantener bajo control a un agente de IA es que una segunda IA lea por encima de su hombro. Ha sido el enfoque predeterminado, pero puede volverse costoso rápidamente cuando los agentes funcionan durante horas y procesan el equivalente al texto de varias novelas.
Goodfire, una startup centrada en la interpretabilidad (averiguar cómo funcionan internamente los modelos de IA), lanzó el jueves una opción más económica: monitores que observan lo que sucede dentro de un modelo de IA mientras trabaja, en lugar de solo leer lo que escribe. Los monitores están disponibles para los clientes de Baseten, que aloja y ejecuta modelos de IA para otras empresas.
Base Labs de Baseten anunció una alianza de seguridad con Goodfire y la plataforma de IA Hugging Face el mes pasado.
El lanzamiento se produce después de una serie de incidentes este año en los que los agentes de IA escaparon de sus entornos de prueba, incluidos agentes de OpenAI que violó Hugging Face. Kimi K3, el modelo abierto en torno al cual Goodfire construyó su primer monitor, aprovechó una fuga en su sandbox para acceder a internet y a la información en GitHub este verano.
El sistema de Goodfire funciona un poco como la seguridad de un aeropuerto. Pequeños detectores llamados sondas leen las señales internas del modelo en cada paso del trabajo de un agente, de la manera en que un escáner de control revisa a cada pasajero. Solo cuando una sonda marca algo, un modelo de IA aparte, el equivalente a un registro manual, lo examina más de cerca.
Los clientes de Baseten pueden elegir qué riesgos monitorear, incluyendo la piratería ofensiva, el uso indebido de armas químicas y biológicas, y el reward hacking. También deciden la respuesta automatizada: registrar el evento, enviarlo para revisión humana o rechazar la solicitud por completo.
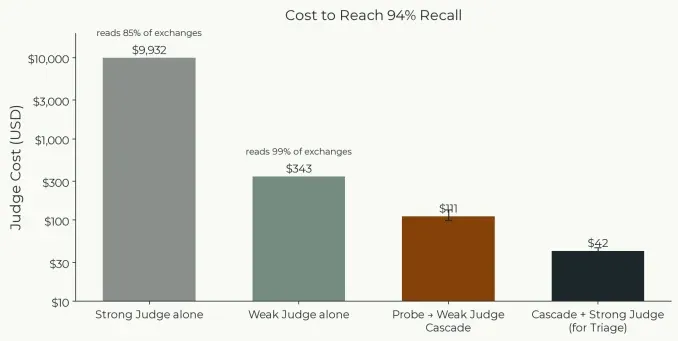
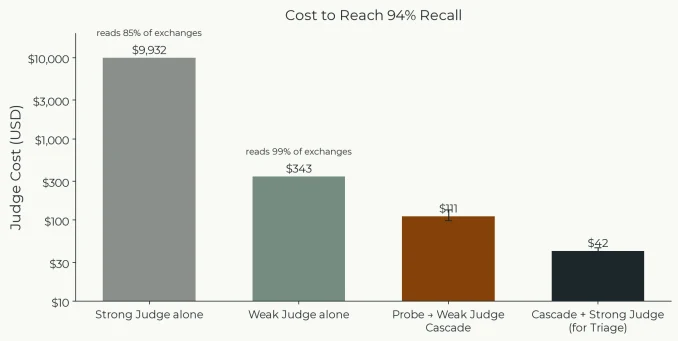
Goodfire afirma que su enfoque también es más barato de operar. La mayoría de los monitores de IA son modelos independientes que tienen que volver a leer todo lo que hace el modelo supervisado, lo que añade tiempo y coste. Las sondas de Goodfire, en cambio, aprovechan los cálculos que el modelo ya está realizando mientras funciona.
«Los monitores de activación interna son realmente baratos porque reutilizan los cálculos del pase hacia adelante», Eric Ho, CEO de Goodfire dijo en el MAD Podcast del capitalista de riesgo Matt Turck la semana pasada. "Así que el modelo ya está calculando este token. Todo lo que haces es tomar las activaciones neuronales intermedias que ya ha calculado y luego ejecutar un clasificador sobre estos cálculos internos." En resumen, el modelo ya está haciendo los cálculos, y las sondas simplemente leen los resultados.
En las pruebas de Goodfire sobre Kimi K3, monitorear unas 1,500 sesiones costó unos $51, en comparación con $233 para un modelo de IA más barato que revisaba cada paso y unos $10,000 para uno de gama alta. Las sondas detectaron el 94% de las sesiones de hackeo malicioso y enviaron a una segunda revisión el 8.7% de las inofensivas.
Ejecutar cuatro sondeos a la vez añadió menos de un 2% al tiempo que tarda el modelo en empezar a responder, según la empresa.
"La gran ventaja es que puedes detectar las cosas antes de que sucedan", dijo el CTO y cofundador de Goodfire, Dan Balsam. "Podemos detectar cuando el modelo podría «hack durante la evaluación o el entrenamiento».
La oferta está dirigida a modelos abiertos. Los desarrolladores pueden descargarlos y eliminar sus salvaguardias, y no vienen con el tipo de monitoreo que los laboratorios cerrados realizan en sus propios sistemas.
«El daño que un individuo puede hacer con un modelo abierto es pequeño en comparación con lo que alguien puede hacer con clústeres de cómputo, como los proveedores de inferencia, donde está la mayor parte de la responsabilidad», dijo Balsam. «Cuando tengamos el momento “Mythos” abierto, quedará claro que los modelos necesitan barandillas desplegadas en tiempo de inferencia».
La investigación reciente de Goodfire descubrió que los modelos abiertos líderes, incluidos Kimi K3 y GLM 5.2, hacían reward hacking en el 50% al 96% de las ejecuciones en pruebas de agentes de IA.
Goodfire no es el primero en intentar este enfoque. Google DeepMind dijo en enero que su investigación informó el despliegue de sondas de detección de uso indebido en Gemini.
Balsam dijo que los monitores son la pieza a corto plazo de un objetivo de investigación más amplio: aplicar ingeniería inversa a un LLM para que el comportamiento pueda rastrearse hasta el punto donde surgió durante el entrenamiento. «Esperamos convertir la magia del entrenamiento de modelos en ingeniería de precisión», dijo.