
Varios equipos dentro de una misma empresa necesitan cada vez más acceso compartido a costosos clústeres de GPU para sus operaciones de IA generativa, manteniendo al mismo tiempo límites de aislamiento, equidad en los recursos e independencia operativa. Considere un equipo de ciencia de datos que entrena modelos de lenguaje de gran tamaño, un grupo de visión por computadora que ejecuta cargas de trabajo de inferencia y un equipo de investigación que experimenta con nuevas arquitecturas de modelos. Todos ellos podrían necesitar acceso al mismo clúster. Sin una arquitectura multiinquilino (multi-equipo) bien diseñada, las organizaciones enfrentan consumo de recursos no controlado, aislamiento débil entre equipos, incapacidad de atribuir los costos compartidos de GPU a los equipos que los incurren y una carga administrativa que frena la innovación.
Amazon SageMaker HyperPod es un servicio de IA diseñado específicamente que simplifica la gestión de clústeres de cómputo a gran escala para cargas de trabajo de IA generativa. Proporciona clústeres resilientes y optimizados orquestados por Amazon Elastic Kubernetes Service (Amazon EKS) o Slurm, de modo que las organizaciones puedan ejecutar entrenamiento distribuido, desarrollo interactivo e inferencia de modelos a escala. Al mismo tiempo, gestiona automáticamente la supervisión del estado de los nodos, la recuperación ante fallos y la gestión del ciclo de vida del clúster.
En esta publicación, presentamos una arquitectura de referencia para construir un entorno multiinquilino en Amazon SageMaker HyperPod con EKS. Esta arquitectura utiliza AWS IAM Identity Center para la autenticación centralizada, dominios de SageMaker AI por equipo para una experiencia de usuario personalizada, espacios de nombres de Kubernetes para el aislamiento de las cargas de trabajo, HyperPod Task Governance para una asignación equitativa de recursos y asignación de costos a nivel de espacio de nombres para la visibilidad del gasto por equipo y el cargo interno. Al final de esta publicación, tendrá un plan claro para que varios equipos compartan de manera eficiente un único clúster de HyperPod EKS.
Descripción general de la arquitectura
El siguiente diagrama ilustra la arquitectura de alto nivel de una implementación multiinquilino de HyperPod EKS. En este ejemplo, dos equipos (Equipo A y Equipo B) comparten un único clúster de HyperPod EKS, cada uno operando dentro de su propio espacio de nombres aislado.
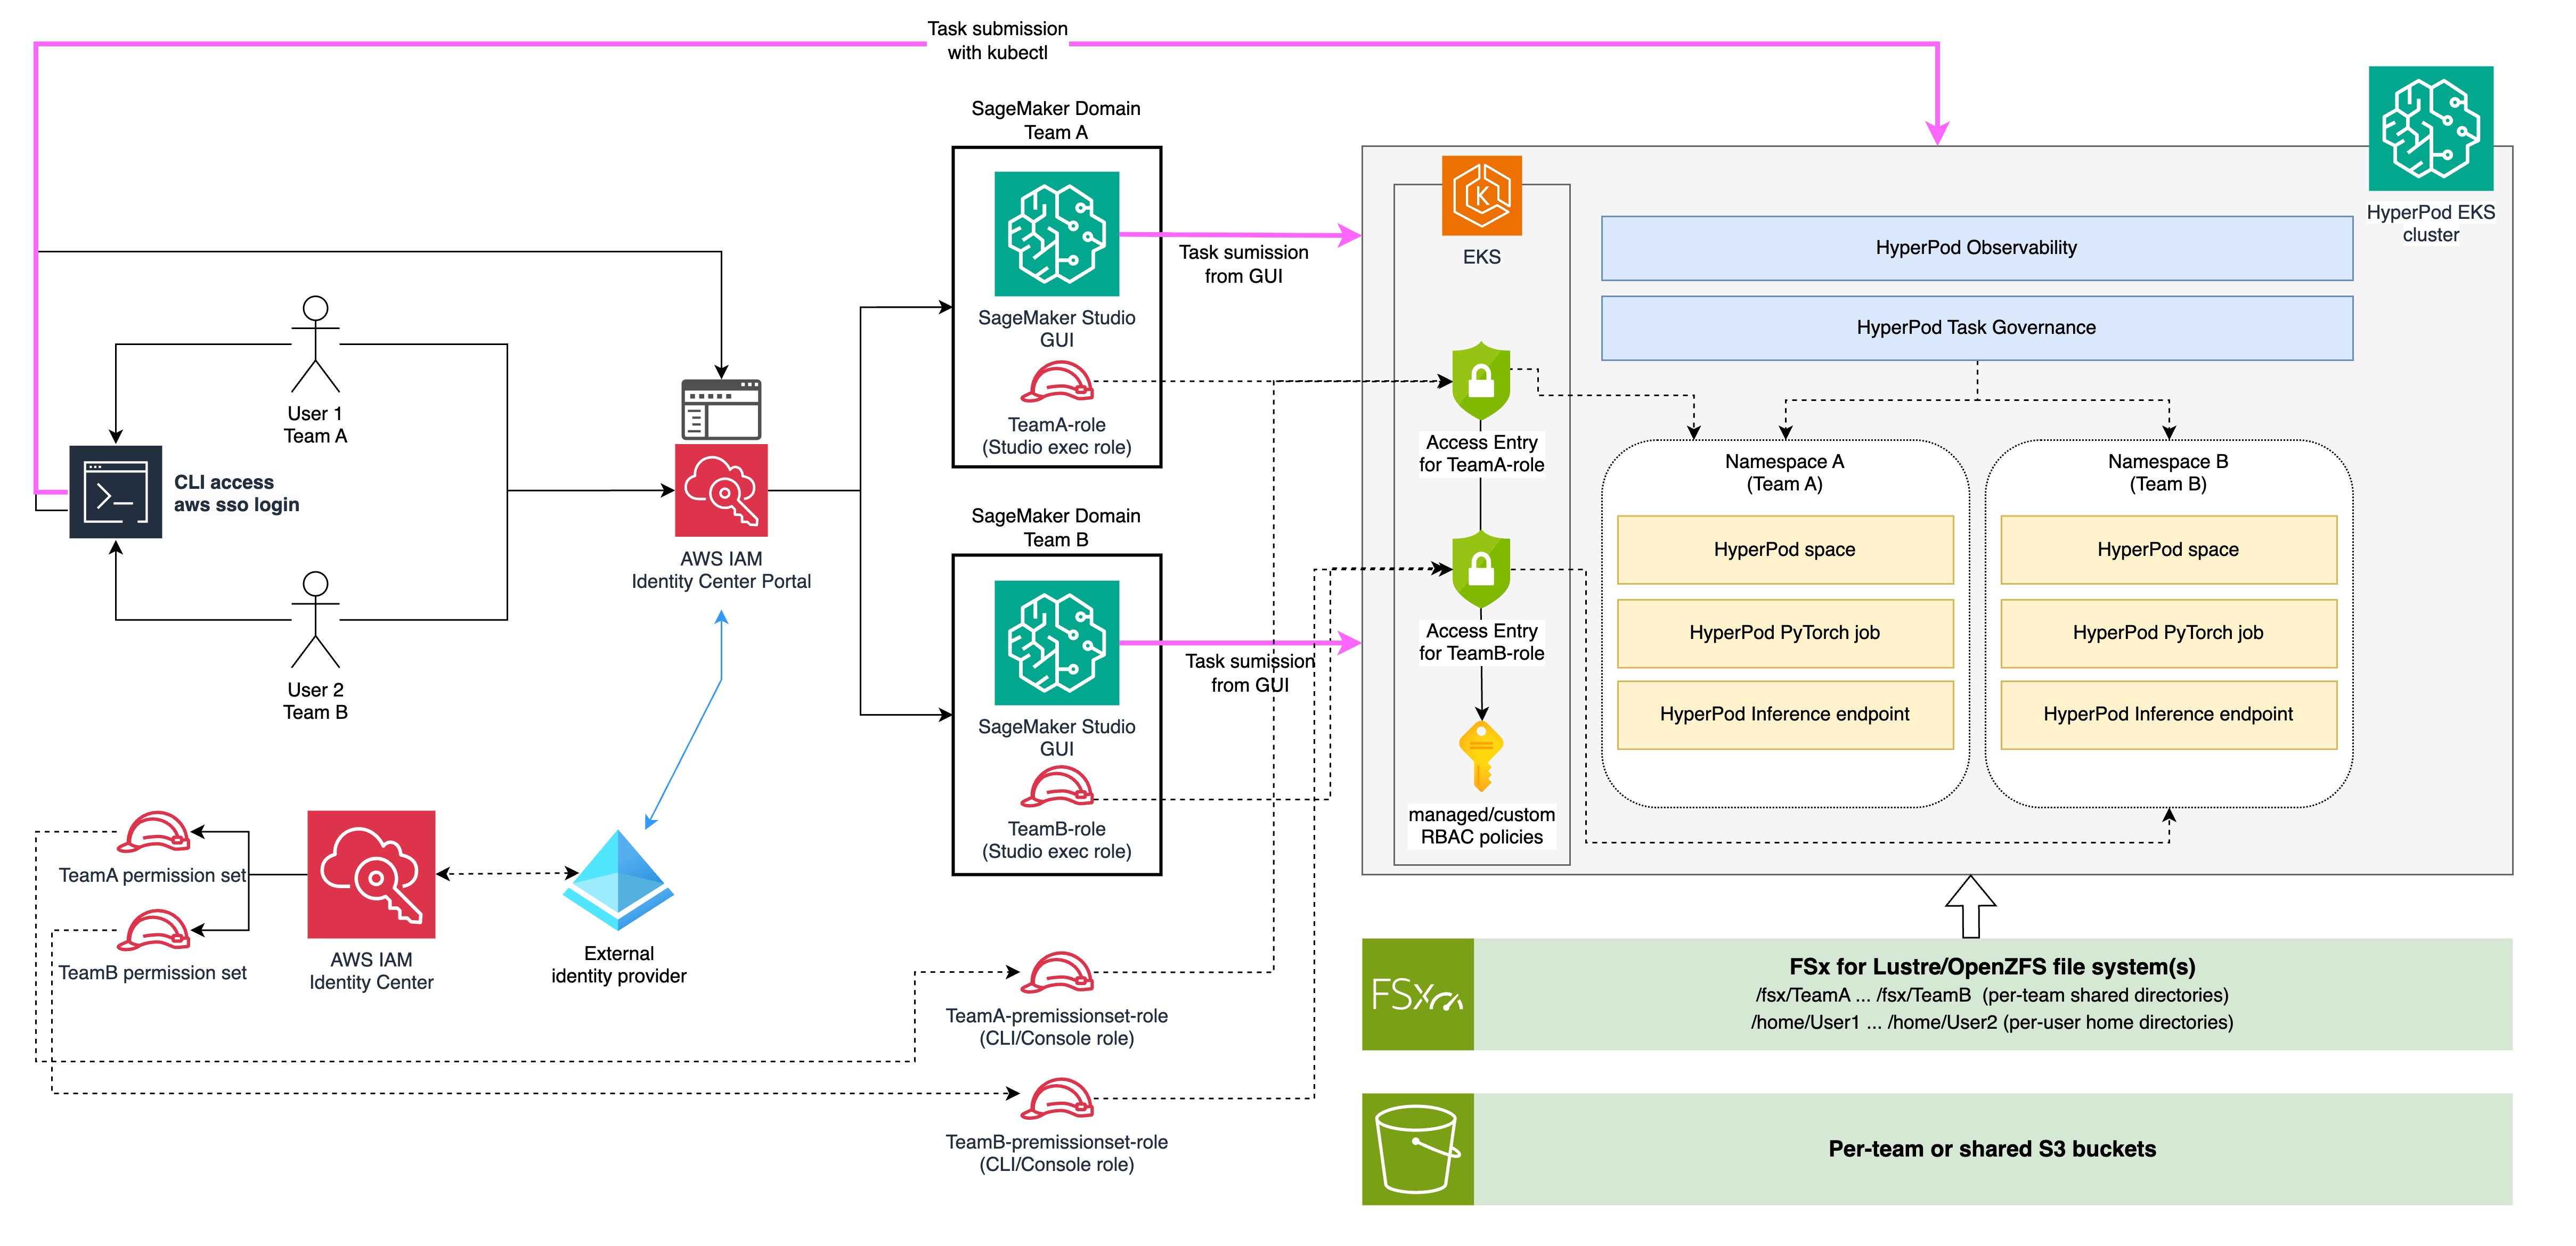
Figura 1: Arquitectura multiinquilino de alto nivel para dos equipos que comparten un clúster de HyperPod EKS
La arquitectura está estructurada como un flujo por capas de izquierda a derecha, que conecta la identidad del usuario a través de los controles de autorización y hacia los espacios de nombres de cargas de trabajo aislados en el clúster.
Usuarios y autenticación
En el extremo izquierdo, los usuarios individuales de cada equipo (Usuario 1 del Equipo A, Usuario 2 del Equipo B) interactúan con el sistema a través de dos rutas. Ambas rutas se autentican a través del portal de AWS IAM Identity Center, que se federa con un proveedor de identidades externo (como Microsoft Entra ID) mostrado en la parte inferior izquierda.
La primera ruta es a través del acceso por CLI. Los usuarios se autentican con aws sso login, que los redirige al portal de Identity Center, y luego obtienen credenciales temporales del conjunto de permisos de su equipo para enviar tareas directamente al clúster de EKS con kubectl. En el diagrama, la flecha rosa fluye desde la terminal de CLI a lo largo de la parte superior directamente hacia el clúster de HyperPod EKS.
La segunda ruta es a través del portal de Identity Center directamente, donde los usuarios seleccionan la aplicación SageMaker Studio para iniciar sesión en su dominio de SageMaker AI específico del equipo.
Cada equipo tiene un conjunto de permisos correspondiente (conjunto de permisos TeamA, conjunto de permisos TeamB) que contiene las políticas de AWS Identity and Access Management (IAM) necesarias para los flujos de trabajo por CLI. Identity Center aprovisiona automáticamente un rol de IAM para cada conjunto de permisos, mostrado en el diagrama como TeamA-permissionset-role y TeamB-permissionset-role (etiquetado como «rol CLI/Consola»). Este rol sirve como principal de IAM cuando los usuarios se autentican a través de aws sso login.
Dominios de SageMaker AI
Desde el portal de Identity Center, los usuarios son dirigidos a su dominio de SageMaker AI específico del equipo. Cada dominio (SageMaker AI domain Team A y SageMaker AI domain Team B) proporciona una interfaz gráfica dedicada de Amazon SageMaker Studio y está configurado con un rol de ejecución específico del equipo (TeamA-role y TeamB-role respectivamente). Estos dominios sirven como la interfaz principal del espacio de trabajo, de modo que los usuarios pueden enviar tareas desde la GUI (mostrado por las flechas rosas que fluyen hacia EKS).
Control de acceso de EKS
En el límite de EKS, las entradas de acceso mapean los roles de IAM a permisos de Kubernetes. El diagrama muestra entradas de acceso para TeamA-role y TeamB-role (los roles de ejecución de Studio), que autorizan las solicitudes que se originan en la GUI de SageMaker Studio. También deben configurarse entradas de acceso para los roles de CLI/Consola aprovisionados por Identity Center (TeamA-permissionset-role y TeamB-permissionset-role) para autorizar las solicitudes que llegan a través de kubectl. Todas las entradas de acceso están asociadas con políticas de control de acceso basado en roles (RBAC) administradas o personalizadas (representadas por el icono de llave) y tienen como ámbito el espacio de nombres designado del equipo. Como resultado, ya sea que el acceso se origine en Studio o en la CLI, los usuarios solo pueden interactuar con los recursos de su propio espacio de nombres.
Clúster de HyperPod EKS
El clúster propiamente dicho se muestra con dos capas de plataforma transversales en la parte superior: HyperPod Observability (para monitoreo y paneles) y HyperPod Task Governance (para la gestión de cuotas de cómputo y prioridades de programación). Debajo de estas capas, el clúster se divide en Namespace A (Team A) y Namespace B (Team B). Dentro de cada espacio de nombres, los equipos pueden ejecutar sus propios HyperPod Spaces (entornos de desarrollo interactivos), trabajos de HyperPod PyTorch (cargas de trabajo de entrenamiento distribuido) y endpoints de HyperPod Inference (servicio de modelos).
Almacenamiento
Debajo del clúster, la arquitectura incluye dos niveles de almacenamiento. El primero es un sistema de archivos compatible con POSIX (Amazon FSx for Lustre o Amazon FSx for OpenZFS) organizado en directorios compartidos por equipo (/fsx/TeamA, /fsx/TeamB) y directorios home por usuario (/home/User1, /home/User2). El segundo son buckets de Amazon Simple Storage Service (Amazon S3) por equipo o compartidos para almacenamiento de objetos, regidos por el rol de ejecución de IAM del equipo.
Esta arquitectura aísla a cada equipo desde la autenticación hasta la autorización y la ejecución de cargas de trabajo, al tiempo que comparte de manera eficiente la costosa infraestructura de GPU.
Autenticación y control de acceso
El fundamento de cualquier sistema multiinquilino es una autenticación robusta: verificar quiénes son los usuarios antes de que interactúen con cualquier recurso. En esta arquitectura, AWS IAM Identity Center sirve como la capa de autenticación centralizada, federándose con un proveedor de identidad externo para gestionar las identidades de los usuarios y sus membresías de grupo.
Por qué AWS IAM Identity Center
AWS IAM Identity Center (sucesor de AWS Single Sign-On) proporciona un único lugar para gestionar las identidades de la fuerza laboral en todas las cuentas y aplicaciones de AWS. Para un despliegue multiinquilino de HyperPod, ofrece varias capacidades clave:
- Gestión centralizada de identidades – En lugar de mantener bases de datos de usuarios separadas por servicio de AWS, Identity Center proporciona una única fuente de verdad para todas las identidades de usuarios y sus membresías de grupo.
- Federación con proveedores de identidad existentes – La mayoría de las empresas ya gestionan las identidades de su fuerza laboral en sistemas como Microsoft Entra ID (anteriormente Azure AD), Okta o Ping Identity. Identity Center se integra con estos proveedores, de modo que las organizaciones pueden reutilizar su infraestructura de identidad existente sin duplicar cuentas de usuario.
- Integración nativa con SageMaker AI – Los dominios de SageMaker AI admiten la autenticación de Identity Center, por lo que los usuarios pueden iniciar sesión en SageMaker Studio a través de su proveedor de identidad corporativo con inicio de sesión único (SSO).
- Acceso a la cuenta de AWS – Identity Center también puede otorgar a los usuarios acceso a la cuenta de AWS subyacente con conjuntos de permisos específicos, que admiten flujos de trabajo de CLI junto con la experiencia GUI de Studio.
- Requerido para Amazon Managed Grafana – Amazon Managed Grafana usa Identity Center como su mecanismo de autenticación para los usuarios de la fuerza laboral, lo que lo convierte en la elección natural cuando los equipos también necesitan acceso a paneles de observabilidad para monitorear sus cargas de trabajo.
Más información: Qué es IAM Identity Center
Configuración de Identity Center con un proveedor de identidad externo
En esta arquitectura de referencia, usamos Microsoft Entra ID como proveedor de identidad externo, aunque el mismo patrón aplica a la mayoría de los proveedores estándar de Security Assertion Markup Language (SAML) 2.0.
La configuración implica:
- Estructura de grupos en el proveedor de identidad – En Entra ID, cree grupos que correspondan a los equipos de su organización. En nuestro ejemplo, definimos tres grupos:
TeamA,TeamB, yAdmin. Cada grupo contiene los usuarios que pertenecen a ese equipo (por ejemplo,user1-teamA@example.comen el grupoTeamA). - Aprovisionamiento SCIM – Habilite la sincronización SCIM (System for Cross-domain Identity Management) entre Entra ID y AWS IAM Identity Center. SCIM proporciona el aprovisionamiento y desaprovisionamiento automático de usuarios y grupos. Cuando se añade un nuevo usuario al
TeamAgrupo en Entra ID, este se sincroniza automáticamente con Identity Center y obtiene el acceso correspondiente sin intervención manual. - Autenticación basada en SAML – Configure la federación SAML 2.0 de manera que, cuando los usuarios se autentiquen, lo hagan contra Entra ID. Identity Center actúa como proveedor de servicios, confiando en las aserciones de su tenant de Entra ID.
Con esta configuración, usted gestiona la pertenencia a los equipos (que impulsa todas las decisiones de autorización posteriores) en su directorio corporativo existente, y esta se propaga a AWS automáticamente.
La siguiente imagen muestra un ejemplo de cómo los equipos organizacionales pueden representarse en Microsoft Entra ID, con grupos dedicados para TeamA, TeamB, y Admin.
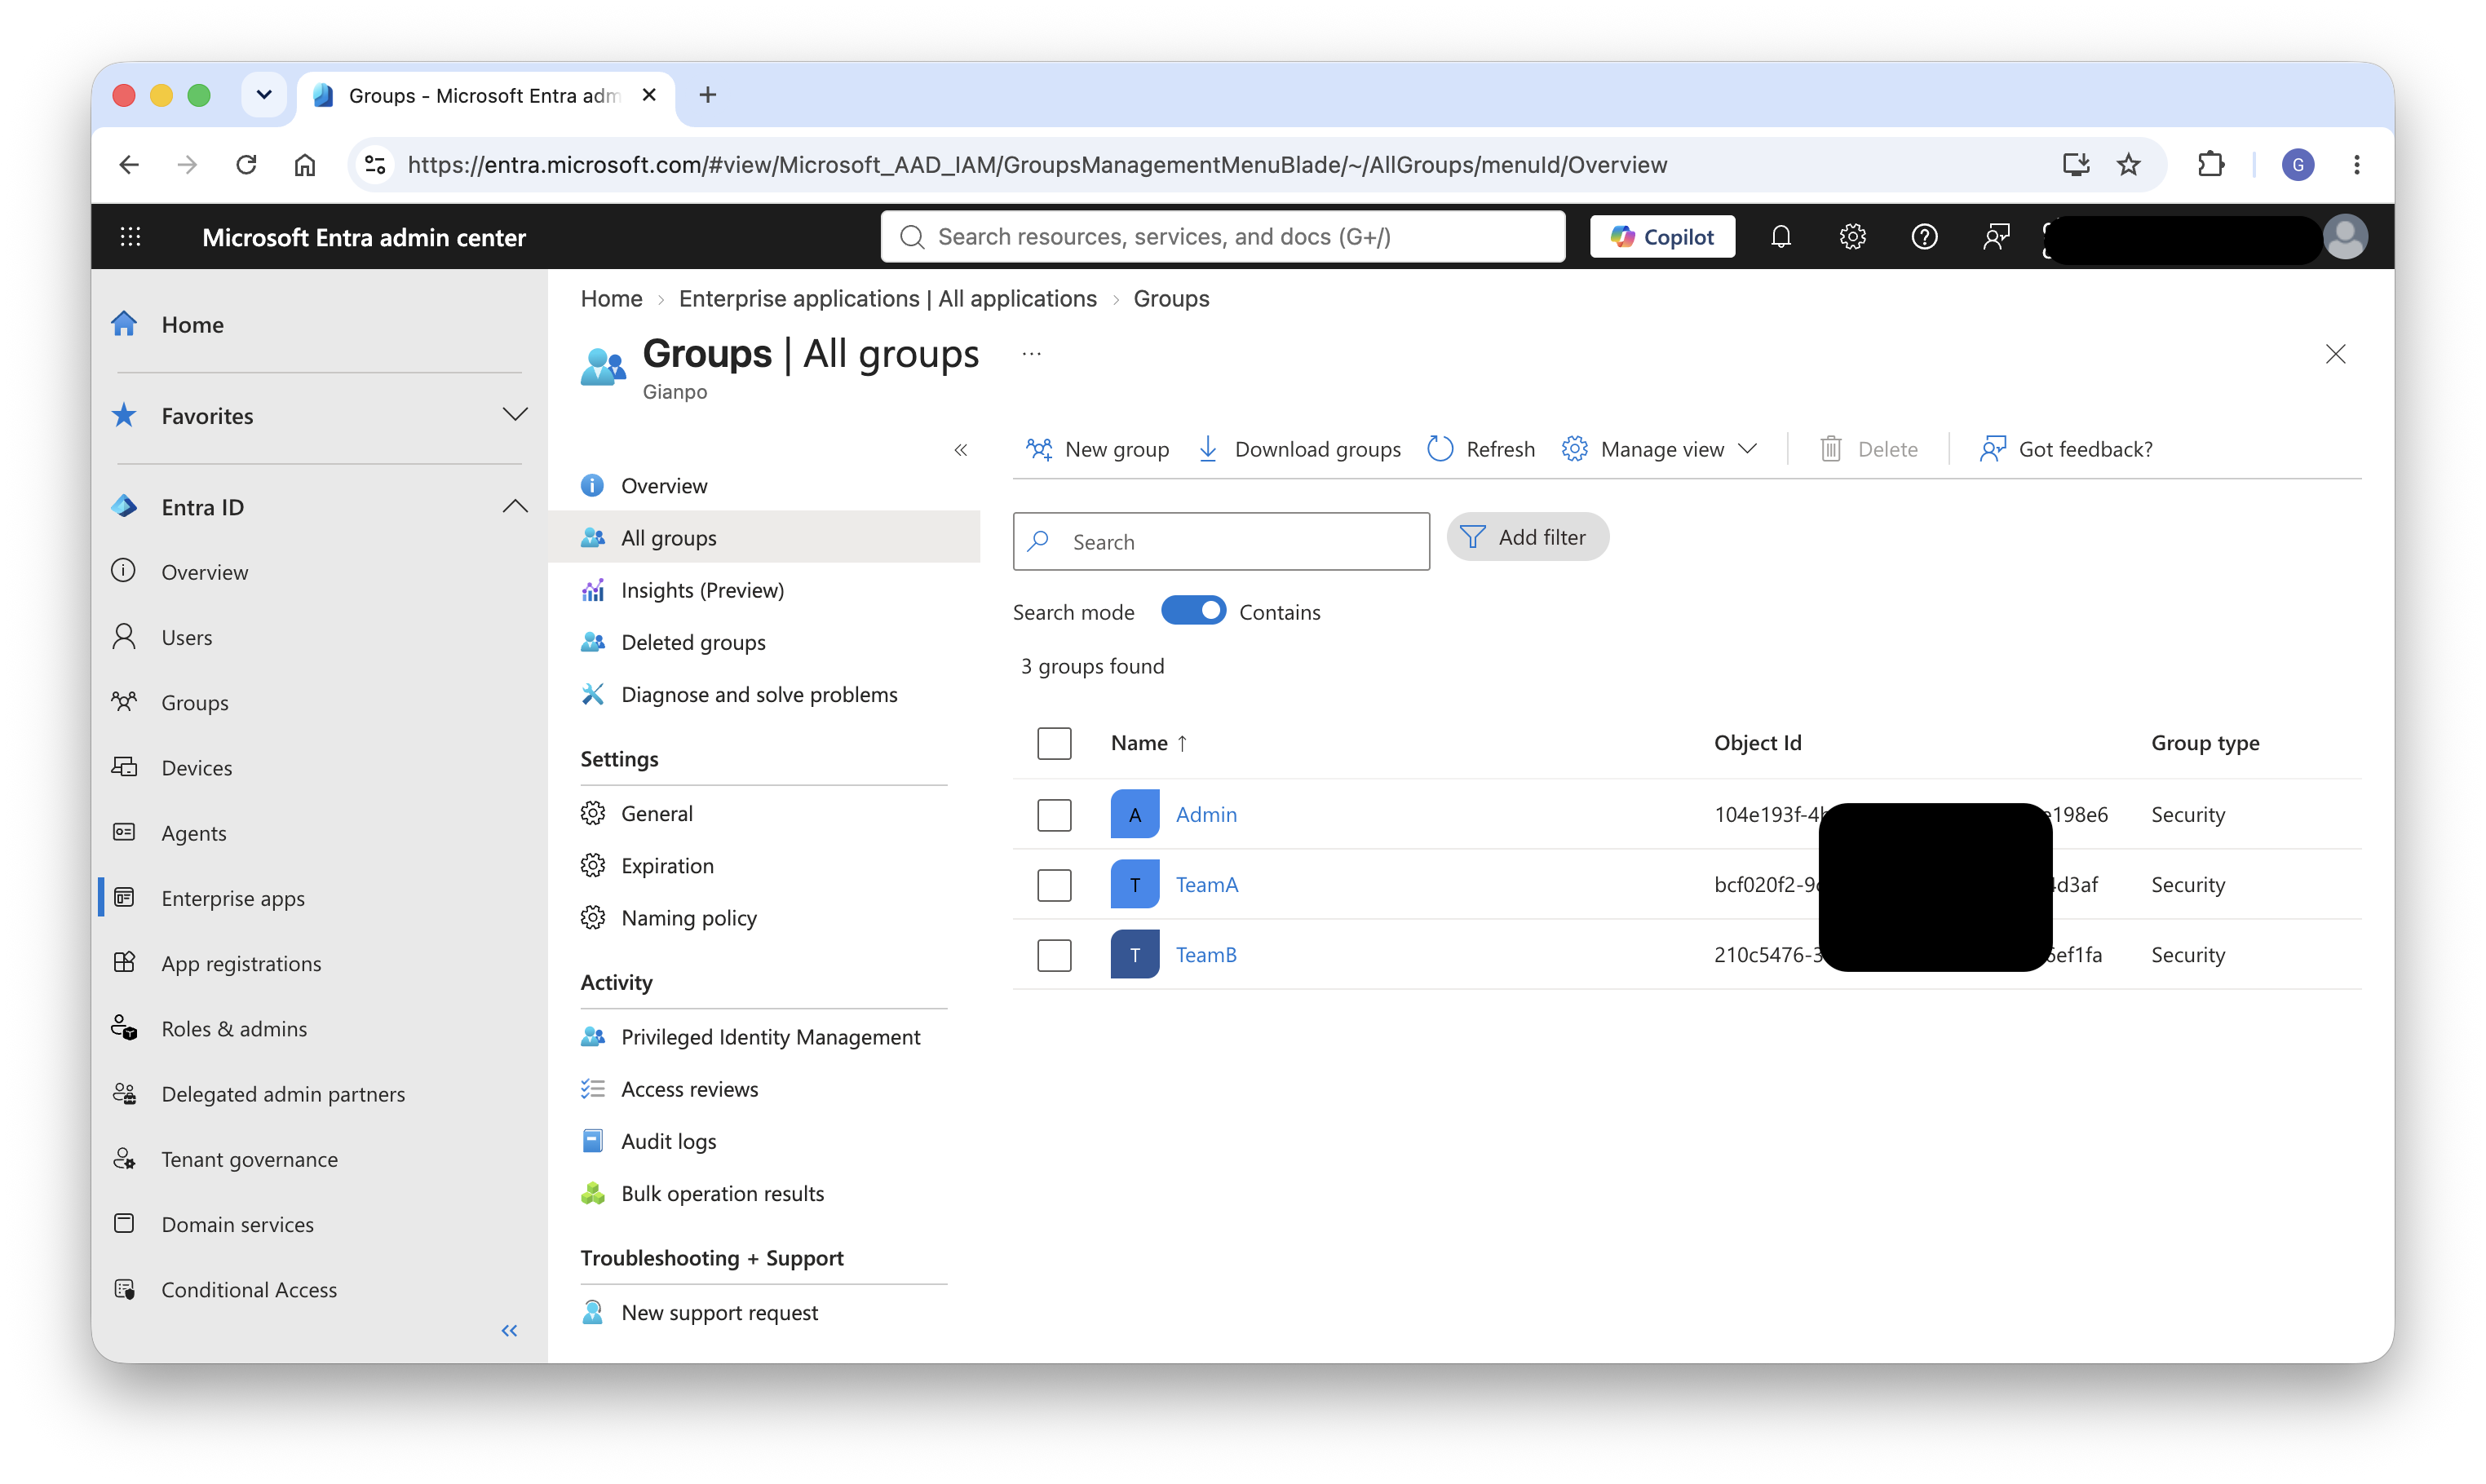
Figura 2: Equipos organizacionales representados como grupos en Microsoft Entra ID
Luego, la siguiente imagen muestra los grupos correspondientes en AWS IAM Identity Center, aprovisionados automáticamente desde Entra ID mediante la sincronización SCIM.
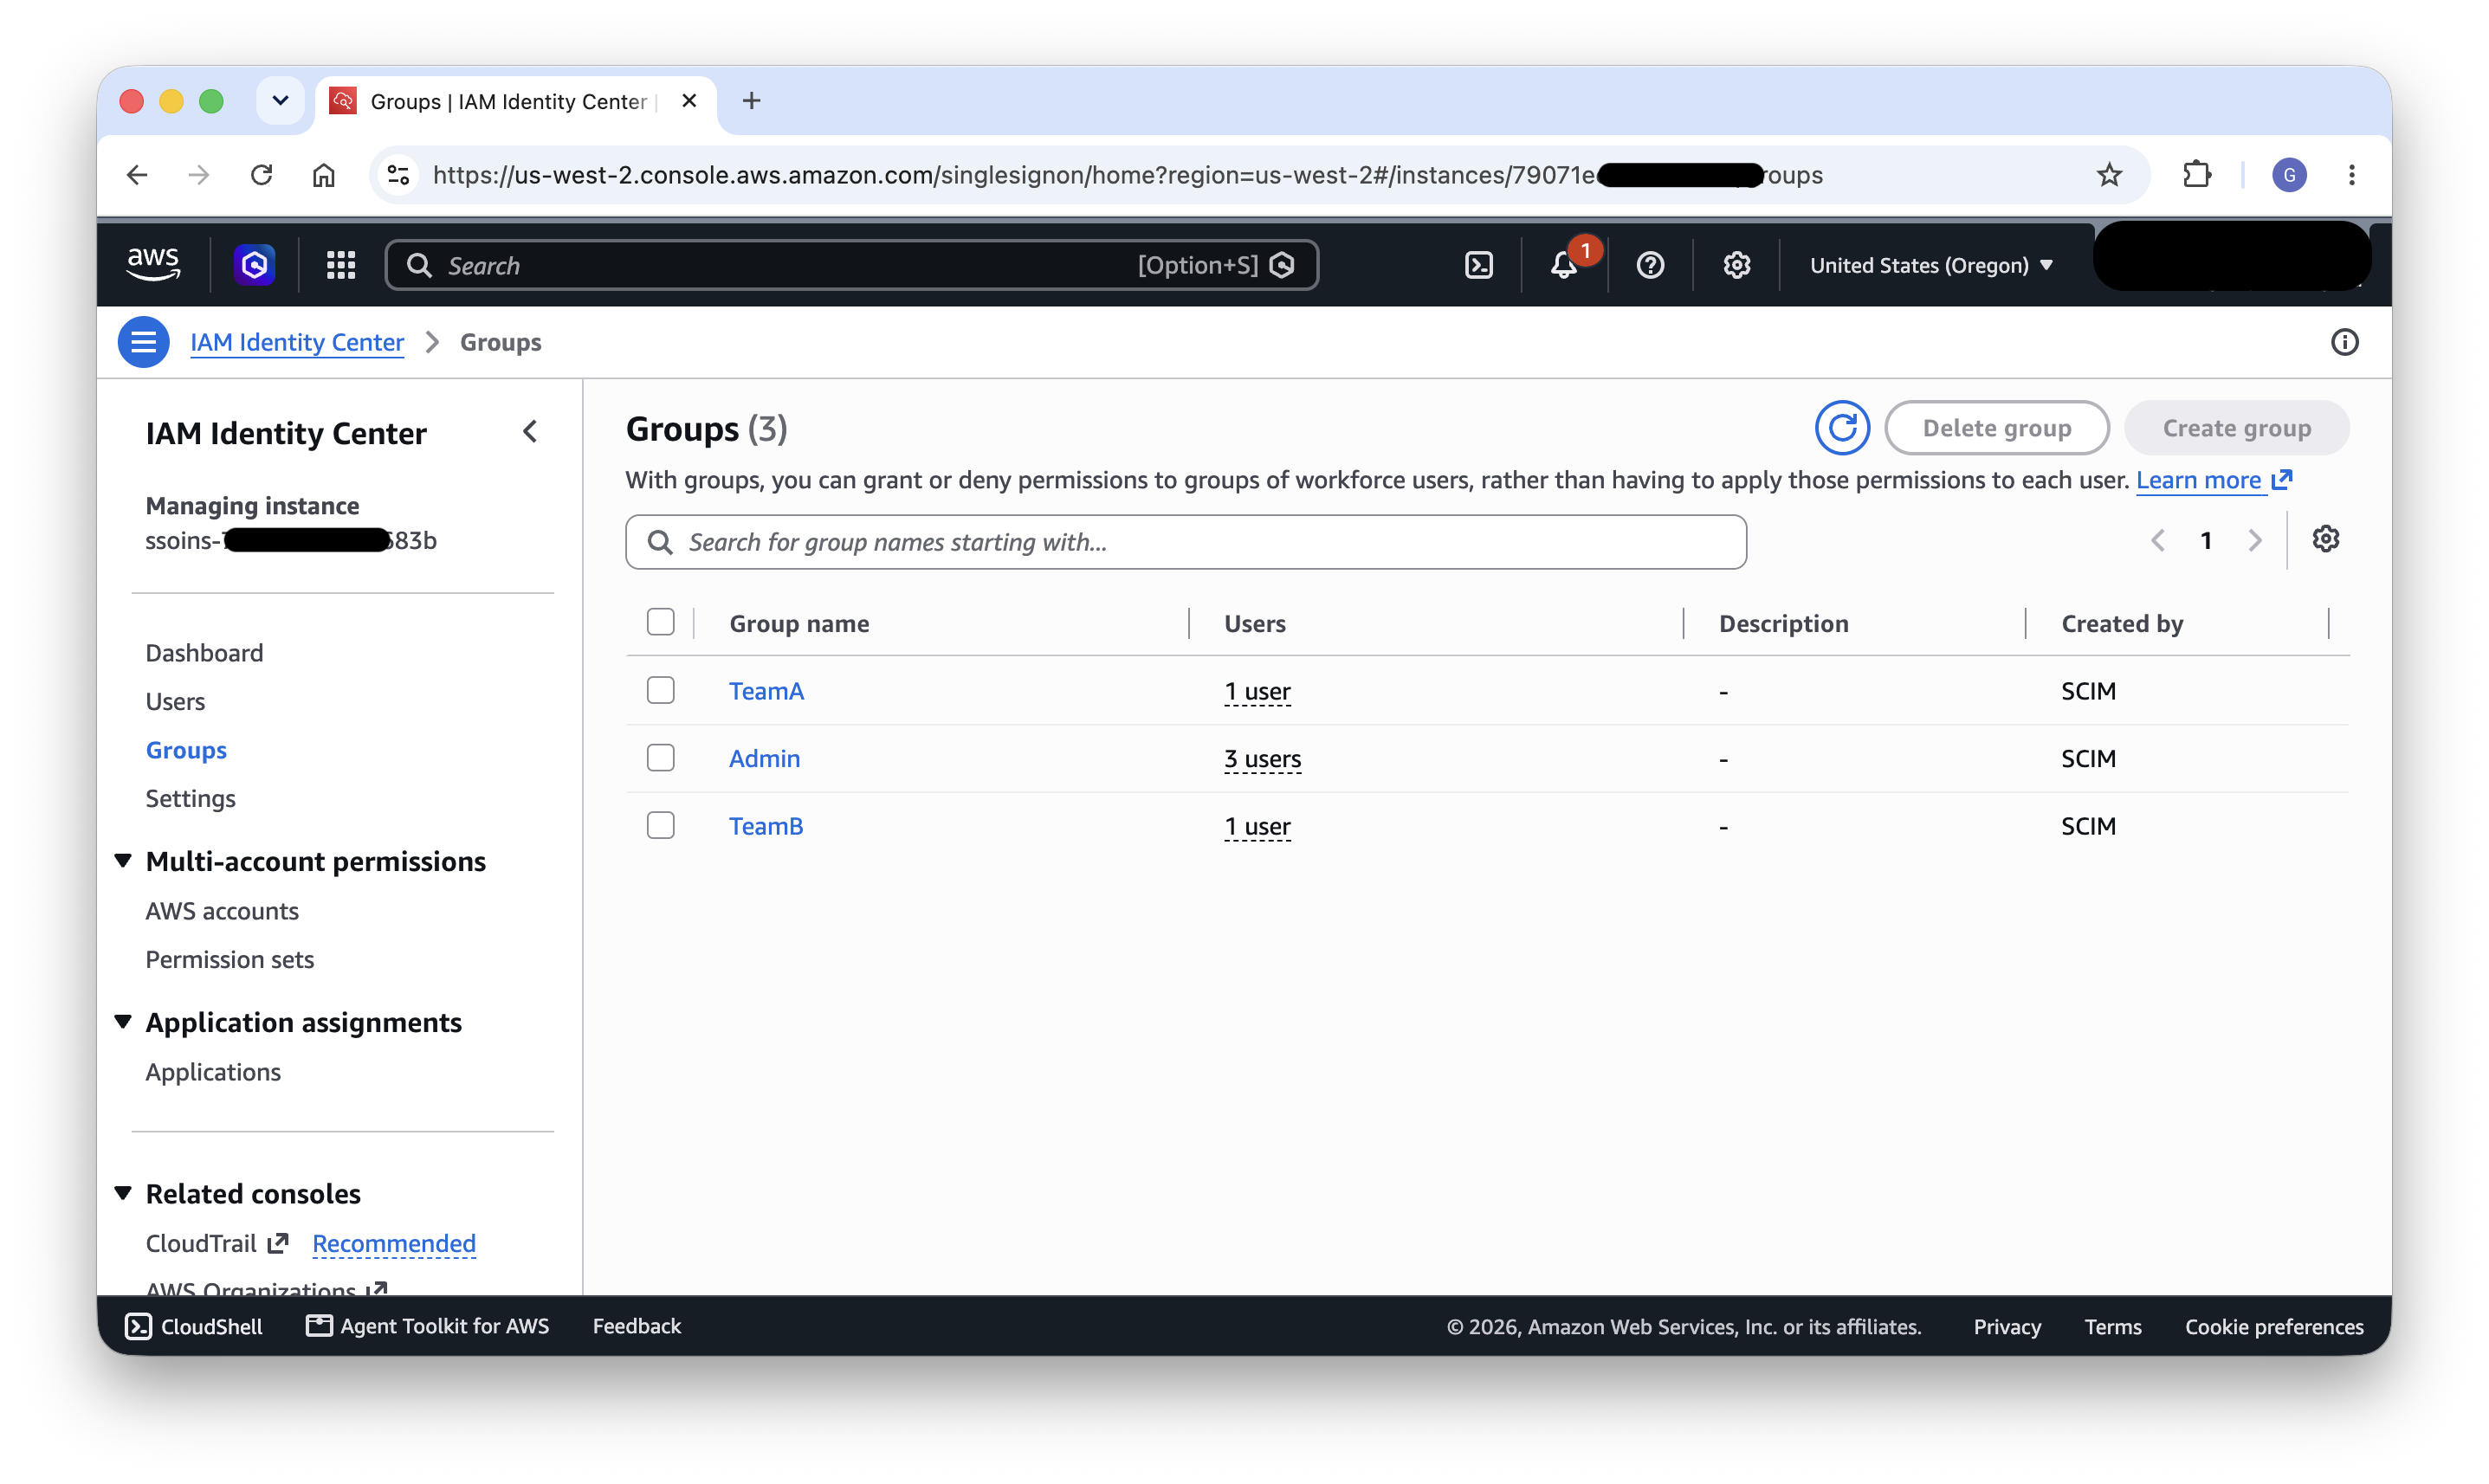
Figura 3: Grupos correspondientes en AWS IAM Identity Center, aprovisionados mediante SCIM
Más información: Conectar un proveedor de identidad externo · Perfil SCIM e implementación de SAML 2.0
Autorización
Una vez establecida la autenticación, la siguiente capa es la autorización: controlar qué acciones puede realizar cada equipo en los servicios de AWS y en el clúster de Kubernetes. La autorización en esta arquitectura opera en dos niveles: IAM para el acceso a nivel de servicios, y Kubernetes RBAC para el acceso a nivel de clúster.
Roles de IAM por equipo
Cada equipo requiere un rol de IAM dedicado que encapsule los permisos a nivel de AWS necesarios para sus flujos de trabajo de IA y machine learning (ML). Estos roles sirven como rol de ejecución del dominio de SageMaker AI y definen a qué servicios de AWS puede acceder el equipo.
Un rol de IAM típico de un equipo debe incluir políticas que otorguen acceso a:
- Amazon SageMaker AI – Para gestionar clústeres de HyperPod, servidores de seguimiento de MLflow y otros recursos de SageMaker AI a través de la API de SageMaker AI.
- Amazon S3 – Para leer conjuntos de datos de entrenamiento y escribir artefactos de modelos, checkpoints y registros. Delimite estos permisos a prefijos de buckets específicos del equipo.
- Amazon CloudWatch – Para ver registros y métricas relacionados con las cargas de trabajo del equipo.
- Amazon EKS – En concreto, los permisos
eks:AccessKubernetesApiyeks:MutateViaKubernetesApi, que la GUI de SageMaker Studio necesita para realizar llamadas a la API de Kubernetes en nombre del usuario (por ejemplo, listar Spaces o enviar trabajos).
La política de confianza de cada rol de IAM debe incluir sagemaker.amazonaws.com como entidad de confianza, para que SageMaker AI pueda asumir el rol en nombre de los usuarios cuando operen a través de Studio. Si planea reutilizar el mismo rol de ejecución como una asociación de EKS Pod Identity para cargas de trabajo dentro del clúster (como se explica más adelante en la sección de almacenamiento de Amazon S3), la política de confianza también debe incluir pods.eks.amazonaws.com como entidad de confianza. El acceso mediante CLI a través de Identity Center utiliza un permission set separado con sus propias políticas (consulte la sección “AWS account access through Identity Center”), por lo que los permisos de la CLI pueden delimitarse de forma independiente.
Más información: How to use SageMaker AI execution roles
AWS account access through Identity Center
Más allá de SageMaker Studio, los equipos a menudo necesitan acceso directo a la cuenta de AWS para operaciones de CLI, como ejecutar comandos kubectl , crear scripts de flujos de trabajo o acceder a recursos de manera programática. Los permission sets de Identity Center proporcionan esta capacidad.
Para el grupo Admin , asigne un permission set con acceso administrativo según lo requieran las políticas de su empresa, otorgando el acceso necesario a la cuenta para la gestión del clúster y las operaciones administrativas.
Para Team A y Team B, cree permission sets con políticas insertadas o administradas que otorguen los permisos necesarios para los flujos de trabajo de CLI directamente. Un permission set típico de un equipo incluye permisos para eks:AccessKubernetesApi (para ver recursos de Kubernetes desde la consola de AWS), acceso delimitado a S3 para los datos del equipo y acceso de lectura de CloudWatch para la monitorización. Estas políticas se definen de forma independiente del rol de ejecución de Studio, por lo que los administradores pueden adaptar los permisos de la CLI a las operaciones específicas que los equipos realizan desde la línea de comandos.
Los usuarios obtienen credenciales temporales a través de la AWS Command Line Interface (AWS CLI) usando aws sso login, que luego pueden usar para configurar kubectl para interactuar directamente con el clúster de EKS.
La siguiente imagen muestra los conjuntos de permisos por equipo en AWS IAM Identity Center, lo que proporciona acceso acotado a cuentas de AWS para flujos de trabajo de CLI como ejecutar kubectl y aws sso login contra el clúster de EKS.
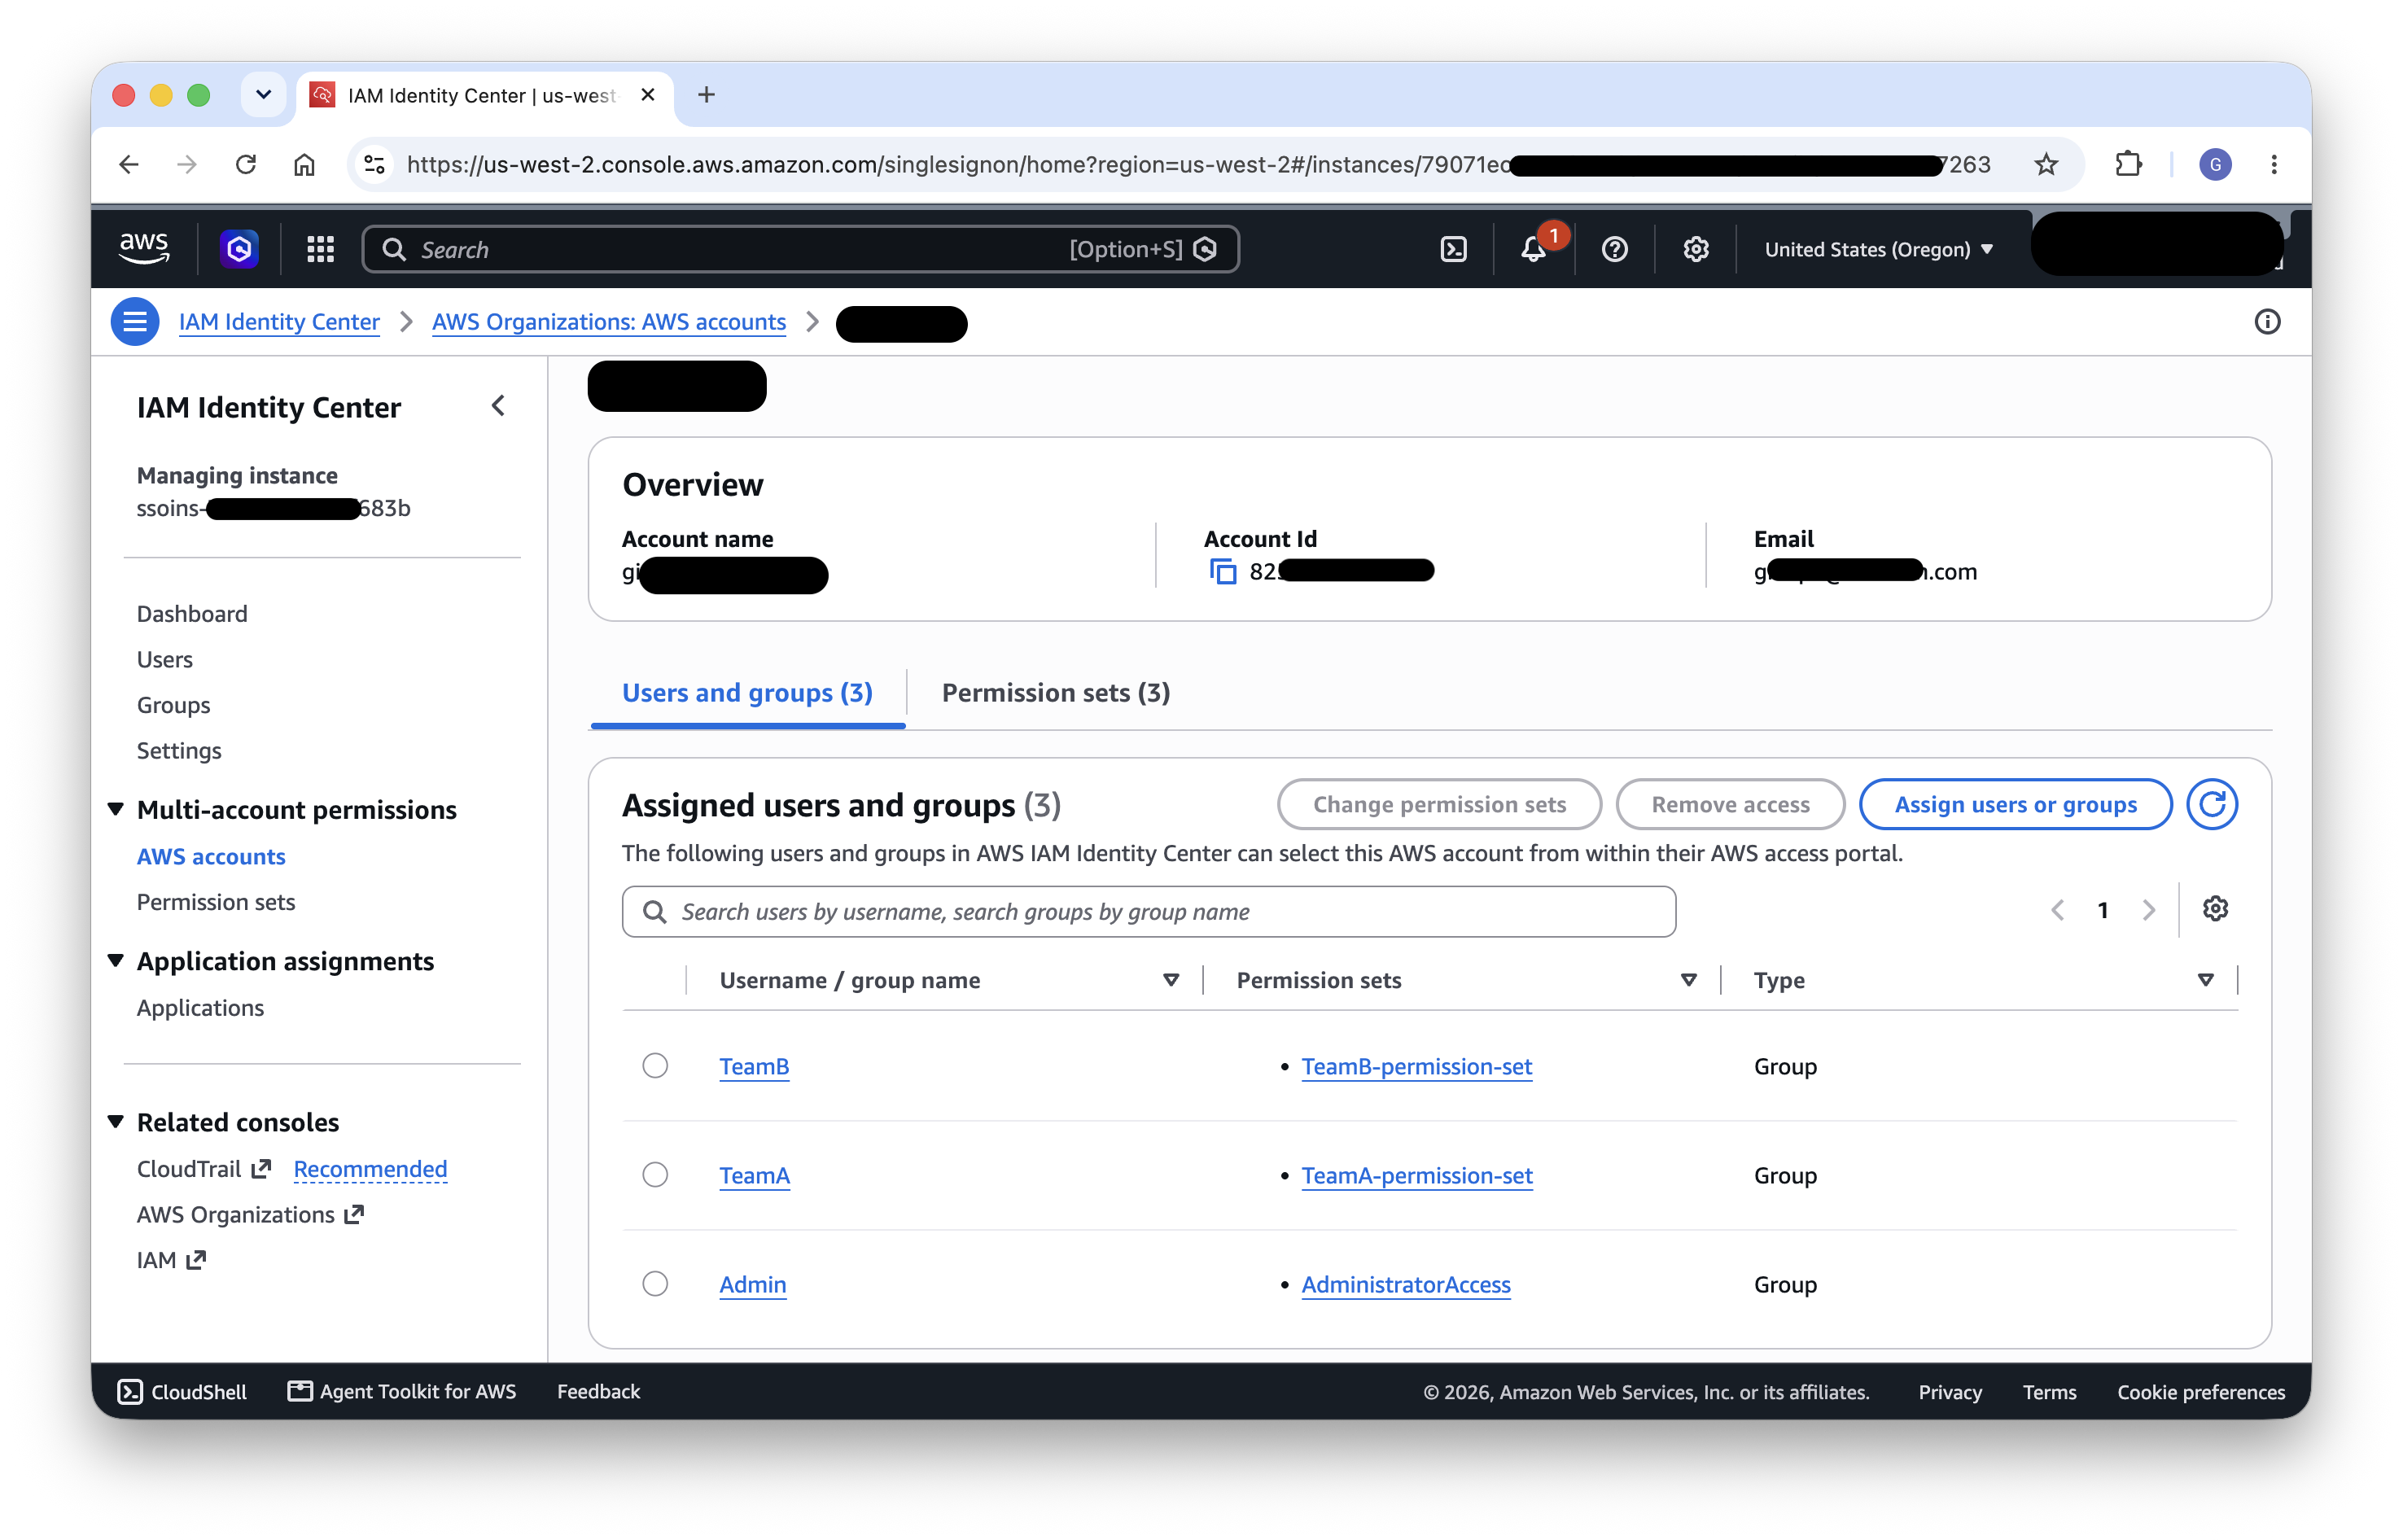
Figura 4: Conjuntos de permisos por equipo en AWS IAM Identity Center para flujos de trabajo de CLI
Más información: Administrar cuentas de AWS con conjuntos de permisos
Configuración de la AWS CLI
Los miembros del equipo configuran la AWS CLI para autenticarse a través de Identity Center ejecutando aws configure sso. Esto crea perfiles en ~/.aws/config que hacen referencia a la sesión de Identity Center y al conjunto de permisos adecuados. Cada miembro del equipo usa su perfil específico del equipo al interactuar con el clúster desde la línea de comandos, manteniendo los límites de autorización tanto si el acceso proviene de Studio como de una terminal local.
La configuración resultante define un bloque sso-session compartido para el portal de Identity Center y un perfil con nombre por equipo, cada uno apuntando al conjunto de permisos de ese equipo. Luego, los miembros del equipo ejecutan aws sso login --profile <team> para obtener credenciales temporales acotadas a su conjunto de permisos:
[sso-session my-sso]
sso_start_url = https://d-xxxxxxxxxx.awsapps.com/start
sso_region = us-west-2
sso_registration_scopes = sso:account:access

[default]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = OpsAdmin
region = us-west-2

[profile team-a]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamA-permission-set
region = us-west-2

[profile team-b]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamB-permission-set
region = us-west-2
Más información: Configuración de la autenticación de IAM Identity Center con la AWS CLI
Dominios de SageMaker AI
Los dominios de SageMaker AI proporcionan el límite del espacio de trabajo para cada equipo, ofreciendo una experiencia de usuario adaptada, roles de ejecución preconfigurados e integración incorporada con la autenticación de Identity Center.
Por qué dominios de SageMaker AI
Usar un dominio de SageMaker AI por equipo es un patrón bien establecido para organizar entornos de varios equipos. Este enfoque ofrece varias ventajas:
- Patrón establecido de varios equipos – AWS ha documentado ampliamente este enfoque para separar líneas de negocio o equipos con múltiples dominios, lo que lo convierte en una configuración probada y compatible.
- Autenticación nativa de Identity Center – Cada dominio puede configurarse con autenticación de Identity Center, lo que significa que los usuarios inician sesión una vez a través de su proveedor de identidad corporativo y llegan directamente al entorno de Studio de su equipo.
- Configuración de equipo incorporada – Los dominios ya proporcionan mecanismos para especificar configuraciones para usuarios y equipos sin requerir entidades personalizadas adicionales. Por ejemplo, opciones como el rol de ejecución del equipo pueden especificarse a nivel de dominio y anularse a nivel de perfil de usuario para obtener la máxima flexibilidad.
- Personalización de la navegación – Con la configuración del dominio, los administradores pueden ocultar los elementos de navegación que no sean relevantes para los flujos de trabajo del equipo, presentando una interfaz enfocada adaptada a los casos de uso de HyperPod.
Más información: Entidades y estados de dominio de SageMaker AI · Descripción general de múltiples dominios
Configuración de dominios por equipo
Cree un dominio de SageMaker AI por equipo con autenticación de Identity Center. En nuestro ejemplo, creamos TeamA-domain y TeamB-domain. Cada dominio se configura de la siguiente manera:
- Rol de ejecución predeterminado – Establezca el rol de ejecución predeterminado del dominio en el rol de IAM específico del equipo creado en el paso de autorización. Como resultado, todas las acciones realizadas a través de Studio heredan los permisos apropiados.
- Asignación de grupo de Identity Center – Agregue el grupo de Identity Center correspondiente (por ejemplo, el grupo
TeamA) al dominio. Esto activa la aplicación de SageMaker Studio para todos los miembros de ese grupo, otorgándoles acceso a la interfaz de Studio. - Verificación de la asignación de aplicaciones – Después de configurar el acceso del grupo, revise la asignación de aplicaciones en Identity Center para confirmar que los grupos correctos están asignados a los dominios correctos.
- Personalización de la navegación – Configure las opciones de navegación predeterminadas de cada dominio para presentar solo las capacidades relevantes. Por ejemplo, puede ocultar los elementos no relacionados con los flujos de trabajo de HyperPod, proporcionando una experiencia de usuario enfocada en HyperPod que reduce la carga cognitiva de los miembros del equipo que solo necesitan trabajar con recursos de HyperPod.
La siguiente imagen muestra la consola de SageMaker AI con un dominio por equipo (TeamA-domain y TeamB-domain), cada uno de los cuales proporciona un límite de espacio de trabajo aislado.
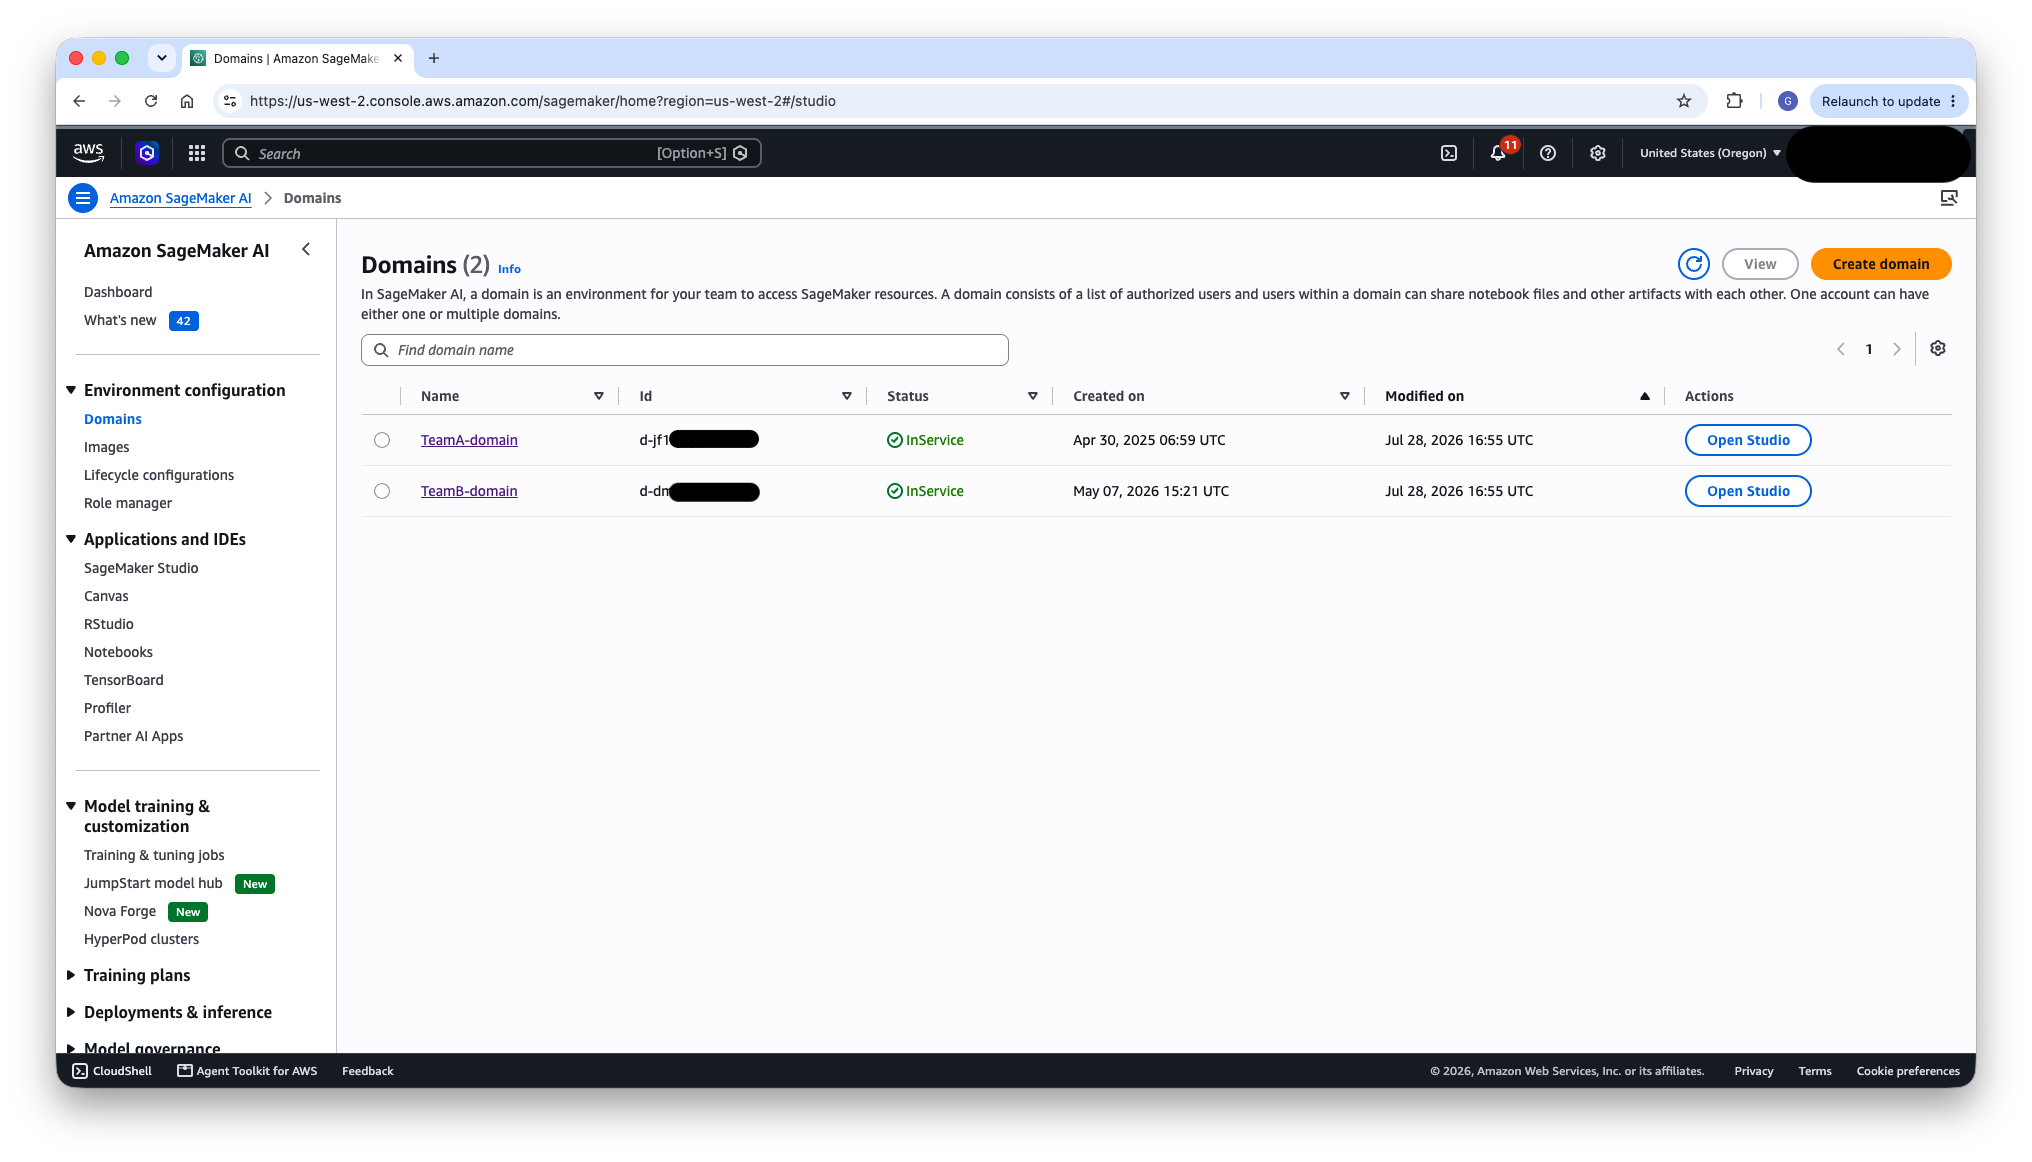
Figura 5: Un dominio de SageMaker por equipo en la consola de SageMaker
Luego, la siguiente imagen muestra los detalles de TeamA-domain, incluidos los grupos de Identity Center asignados.
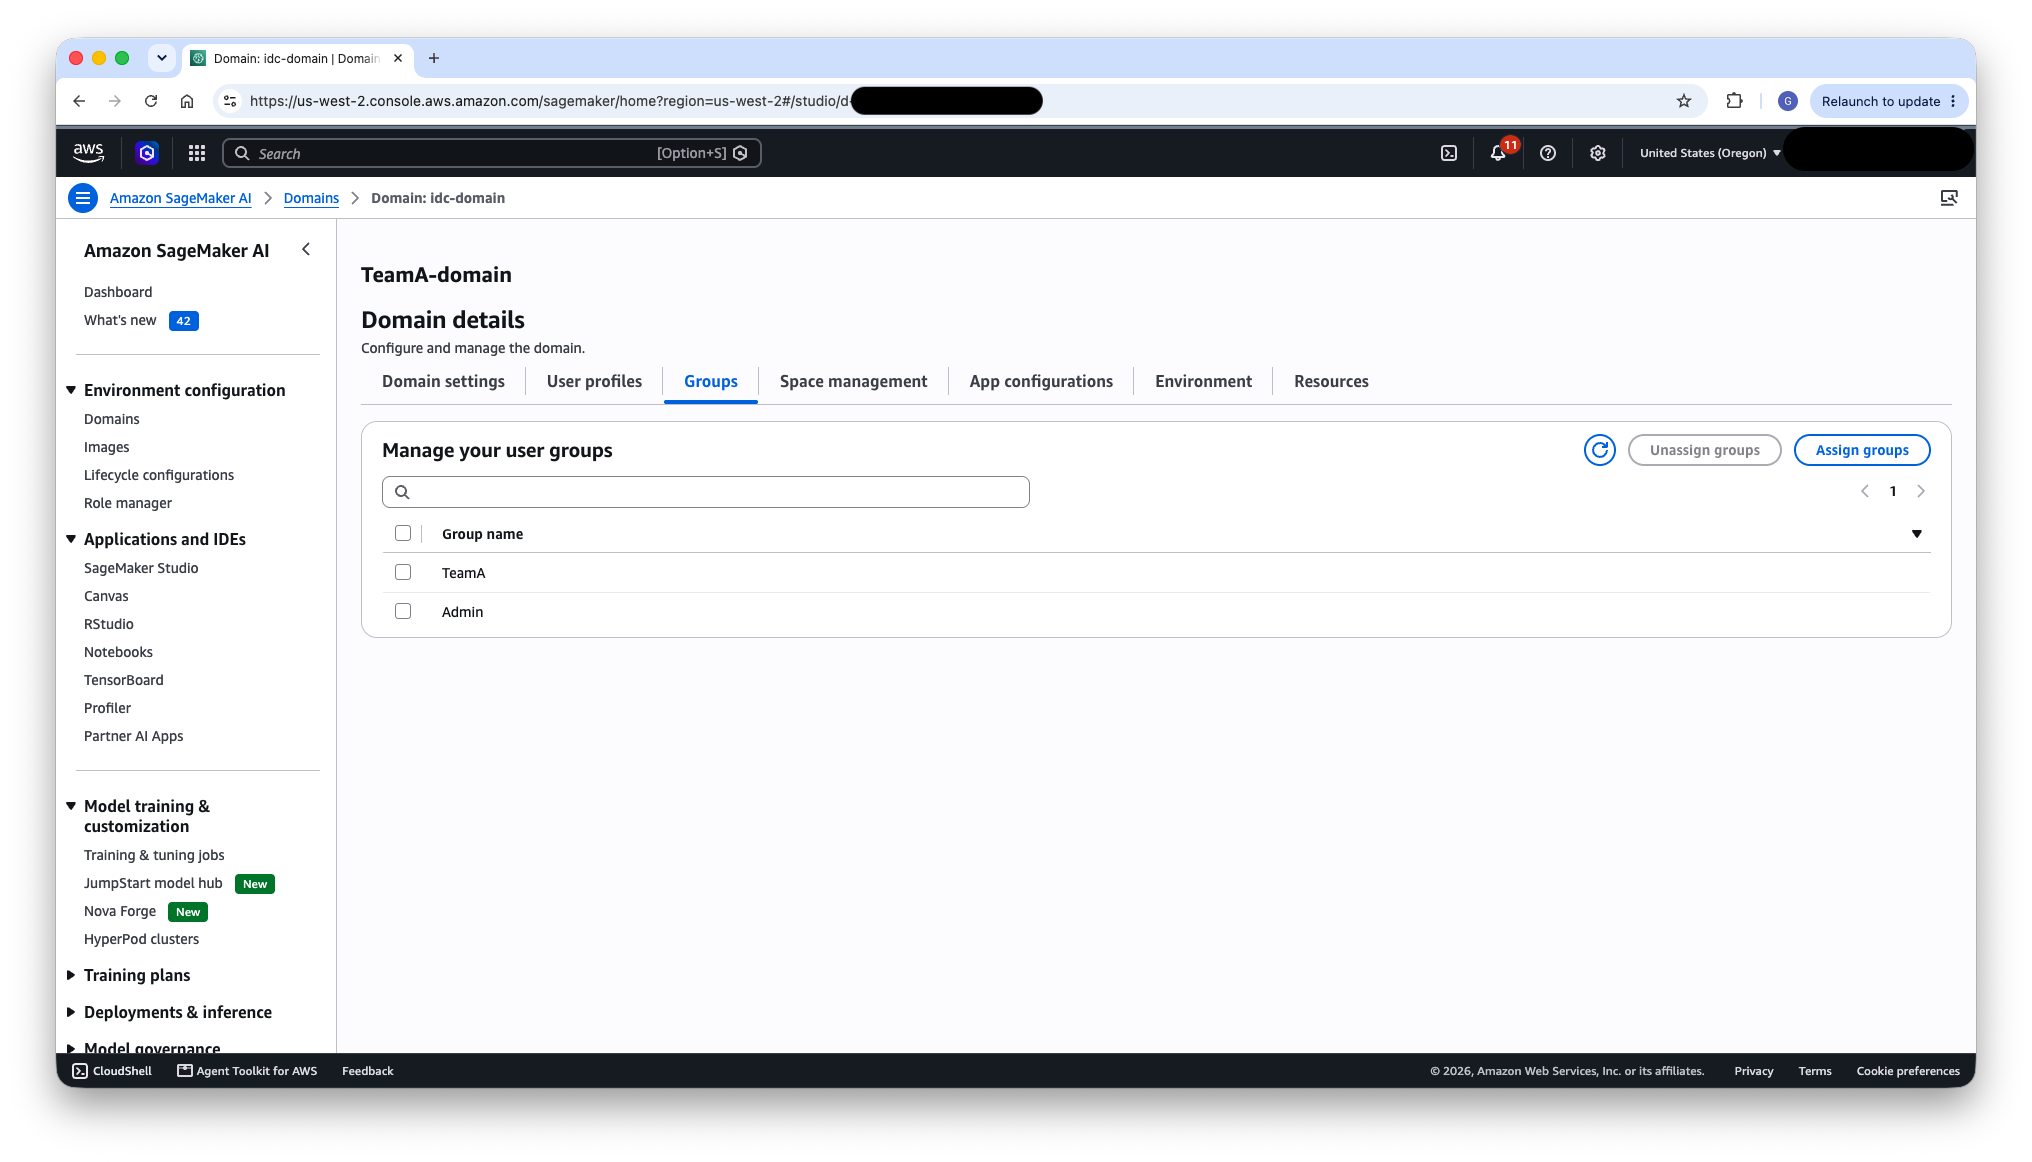
Figura 6: Configuración de TeamA-domain con sus grupos de Identity Center asignados
Configuración del clúster de HyperPod EKS
El clúster de HyperPod EKS es donde se ejecutan las cargas de trabajo. El multiarrendamiento a nivel del clúster se logra mediante espacios de nombres de Kubernetes para el aislamiento y entradas de acceso de EKS para la autorización.
Aislamiento de espacios de nombres
Cree un espacio de nombres de Kubernetes dedicado para cada equipo, por ejemplo hyperpod-ns-team-a y hyperpod-ns-team-b. Los namespaces proporcionan un límite lógico dentro del clúster, aislando las cargas de trabajo de cada equipo (Spaces, trabajos de entrenamiento, endpoints de inferencia) entre sí.
Nota: Los namespaces son un límite de aislamiento, no un límite de seguridad estricto. Esta arquitectura está dirigida a equipos múltiples dentro de una sola organización: equipos que comparten un clúster bajo un dominio administrativo común y una base de confianza mutua. No está diseñada para el aislamiento entre múltiples clientes de tenants que no confían entre sí.
Los namespaces, RBAC y las cuotas previenen interferencias accidentales (equipos que sobrescriben los recursos de otros o exceden su asignación de cómputo), pero no son una defensa contra un tenant malicioso decidido: los pods con namespace comparten los mismos nodos y kernel, y los recursos con ámbito de clúster (nodos,
PersistentVolumes, CRD, algunos componentes de operadores) se encuentran fuera de cualquier namespace.Para tenants no confiables o aislamiento regulatorio estricto, use límites más fuertes como clústeres o cuentas separadas, grupos de nodos dedicados y sandboxing en tiempo de ejecución. Para el escenario multi-equipo descrito aquí, el aislamiento por namespaces combinado con RBAC, cuotas de Task Governance y los controles de identidad POSIX descritos más adelante logran un equilibrio adecuado entre separación y simplicidad operativa.
Los namespaces se pueden crear manualmente con kubectl create namespace o aprovisionarse automáticamente mediante HyperPod Task Governance, que gestiona los namespaces como parte de su configuración de cuotas y programación.
La siguiente imagen muestra los namespaces del clúster (gestionados con HyperPod Task Governance), con un namespace dedicado por equipo (hyperpod-ns-team-a y hyperpod-ns-team-b) que proporciona aislamiento de cargas de trabajo.
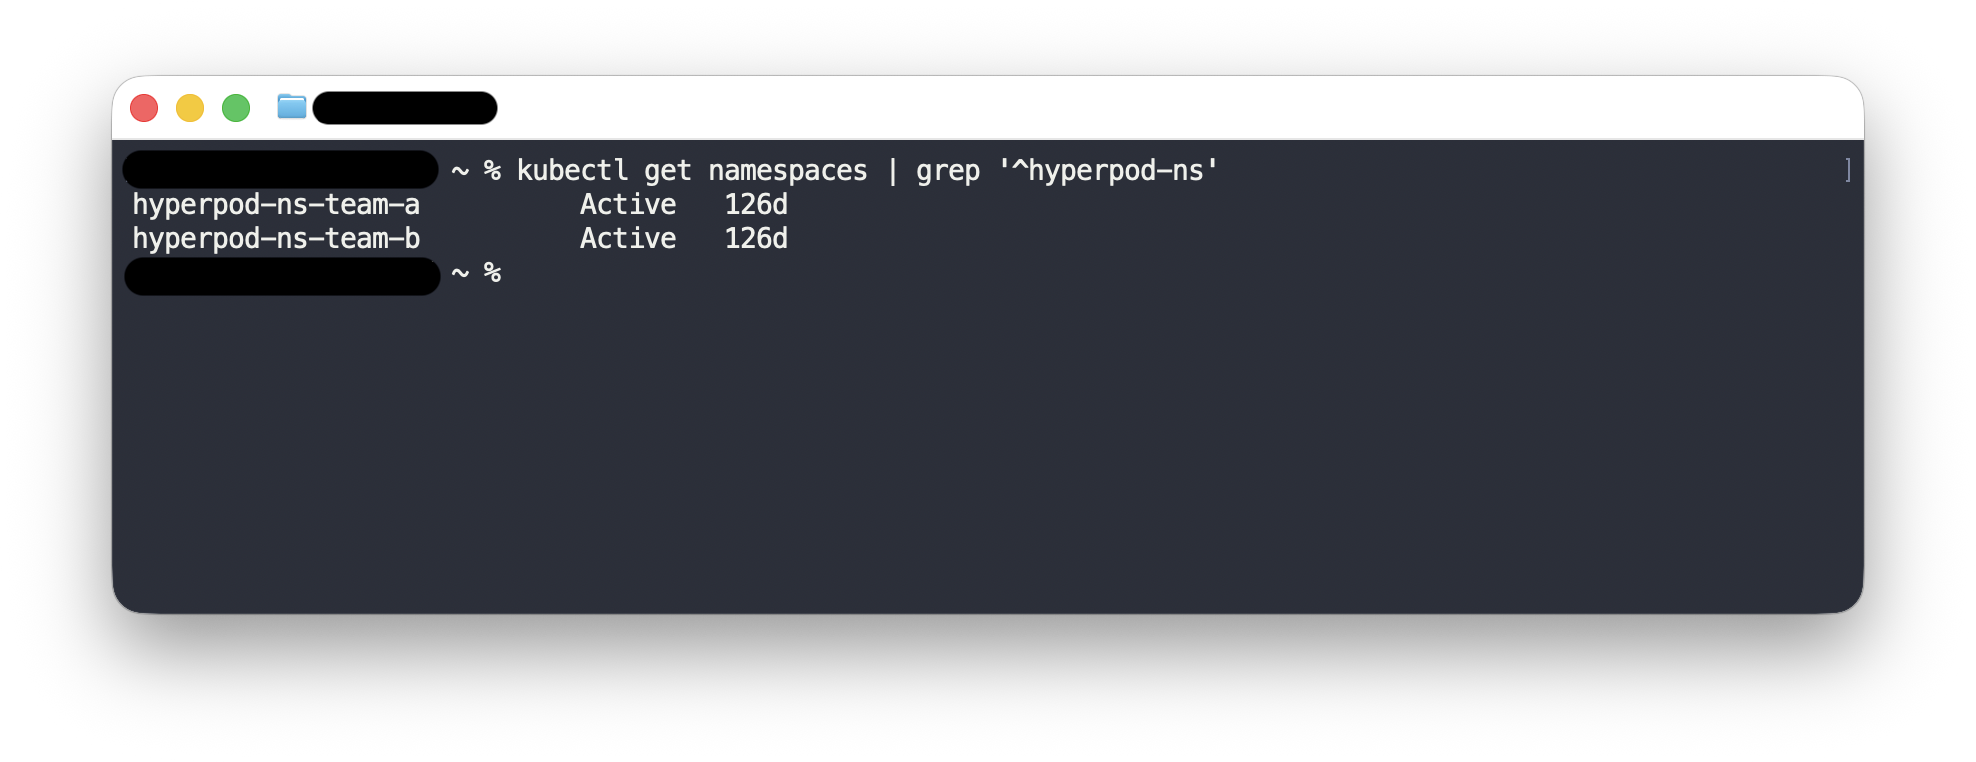
Figura 7: Namespace de Kubernetes dedicado por equipo para el aislamiento de cargas de trabajo
Más información: Namespaces de Kubernetes
Aislamiento de red
Los namespaces no restringen el tráfico de red. Por defecto, la red de Kubernetes es plana: cada pod puede comunicarse con cualquier otro pod en todos los namespaces. Como resultado, un pod en hyperpod-ns-team-a puede abrir una conexión a un pod en hyperpod-ns-team-b a menos que agregue controles. Para limitar la accesibilidad entre pods según los límites de los equipos, use recursos de NetworkPolicy de Kubernetes.
El patrón recomendado es denegar por defecto por namespace: comience denegando todo el ingress (y opcionalmente el egress) y luego permita explícitamente el tráfico que cada equipo necesita, típicamente la comunicación intra-namespace más el egress requerido, como DNS, endpoints de almacenamiento y las API de AWS. El siguiente ejemplo deniega todo el ingress en el namespace de un equipo y luego permite el tráfico solo de pods dentro del mismo namespace:
# 1. Default-deny all ingress in the team's namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}  # applies to all pods in the namespace
  policyTypes:
  - Ingress
---
# 2. Allow ingress only from pods within the same namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-same-namespace
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector: {}  # any pod in this namespace
NetworkPolicy su aplicación depende de una Container Network Interface (CNI) que lo admita. En EKS, puede habilitar la compatibilidad con políticas de red en la CNI de Amazon Virtual Private Cloud (Amazon VPC).
Al igual que con los namespaces, NetworkPolicies reducir accidentales alcance de comunicación entre equipos y reducir el alcance, pero no constituyen por sí mismos un límite de seguridad adversarial en nodos compartidos. Para una separación más fuerte, considere grupos de nodos dedicados por equipo o clústeres separados, como se indicó anteriormente.
Más información: Políticas de red de Kubernetes · Política de red de Amazon VPC CNI
Entradas de acceso de EKS
Las entradas de acceso de EKS conectan principales de IAM con permisos RBAC de Kubernetes. Para cada equipo, cree dos entradas de acceso:
- Entrada de acceso de Studio – El principal de IAM es el rol de ejecución del dominio de SageMaker AI del equipo. Esta entrada se utiliza cuando las acciones se originan en la GUI de SageMaker Studio.
- Entrada de acceso de CLI – El principal de IAM es el rol aprovisionado por SSO creado por Identity Center para el permission set del equipo (siguiendo el patrón
AWSReservedSSO_<permission-set-name>_<unique-id>). Esta entrada se utiliza cuando los usuarios interactúan con el clúster a través dekubectl.
Ambas entradas tienen como ámbito el namespace del equipo con políticas de Kubernetes administradas o personalizadas. Por ejemplo, ambas entradas del Equipo A otorgan permisos solo dentro de hyperpod-ns-team-a. Las dos entradas pueden tener políticas RBAC diferentes si lo desea. Por ejemplo, la entrada de CLI podría restringir el acceso de escritura a ciertos tipos de recursos, mientras que la entrada de Studio permite el acceso completo.
Con este ámbito, ya sea que el acceso se origine en Studio o en la CLI, los usuarios solo pueden interactuar con recursos de su propio namespace. Intentar listar o modificar recursos en el namespace de otro equipo genera un error Forbidden de Kubernetes.
Para escenarios más avanzados, puede usar grupos de Kubernetes en la entrada de acceso para asignar usuarios a ClusterRoles o Roles personalizados que proporcionen permisos detallados más allá de las políticas administradas estándar.
La siguiente imagen muestra una entrada de acceso de EKS para el rol del Equipo B, con el ámbito reducido al namespace hyperpod-ns-team-b, de modo que sus permisos se apliquen solo dentro del namespace del Equipo B.
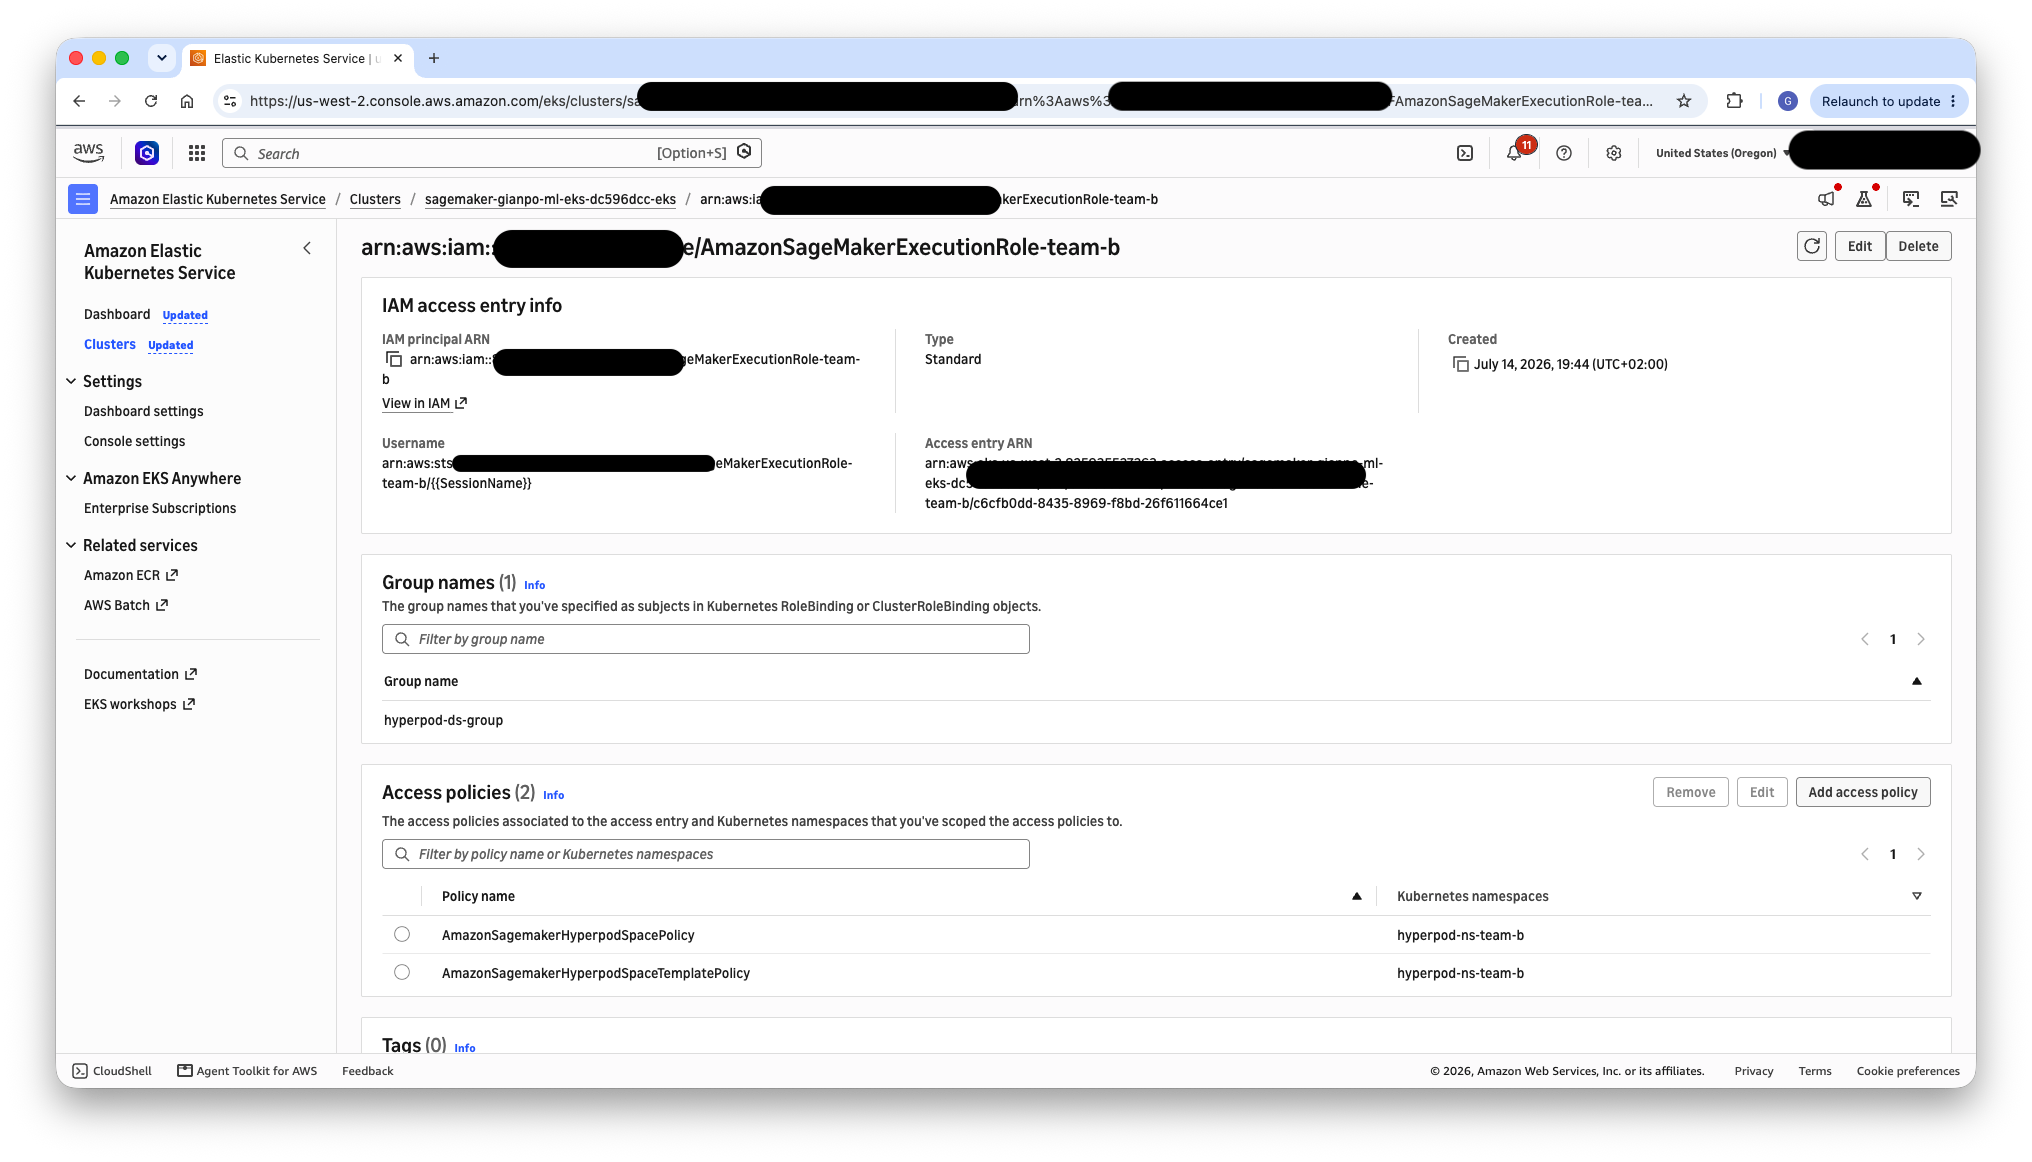
Figura 8: Entrada de acceso de EKS con ámbito en el namespace del Equipo B
Más información: Conceder a usuarios de IAM acceso a Kubernetes con entradas de acceso de EKS
HyperPod Task Governance
Cuando Task Governance está habilitado en el clúster, proporciona una capa adicional de gestión de recursos:
- Cuotas de cómputo – Definen cuánta capacidad de GPU y CPU puede consumir cada equipo. Esto evita que un solo equipo monopolice el hardware compartido durante las ejecuciones de entrenamiento.
- Prioridades – Asignan prioridades de programación a cada equipo o tipo de carga de trabajo, lo que permite que las cargas de trabajo críticas de inferencia de producción anticipen los trabajos de entrenamiento experimentales cuando los recursos están limitados.
- Programación justa – Con Task Governance, cuando varios equipos compiten por recursos, la asignación sigue las políticas configuradas en lugar de un modelo de orden de llegada.
Configure Task Governance con cuotas y prioridades apropiadas por namespace de equipo, equilibrando entre asignaciones mínimas garantizadas y capacidad de ráfaga para cargas de trabajo intermitentes.
La siguiente imagen muestra las asignaciones de cómputo de Task Governance para los dos equipos, con el namespace de cada equipo asignado a su propia cuota de capacidad de cómputo del clúster.
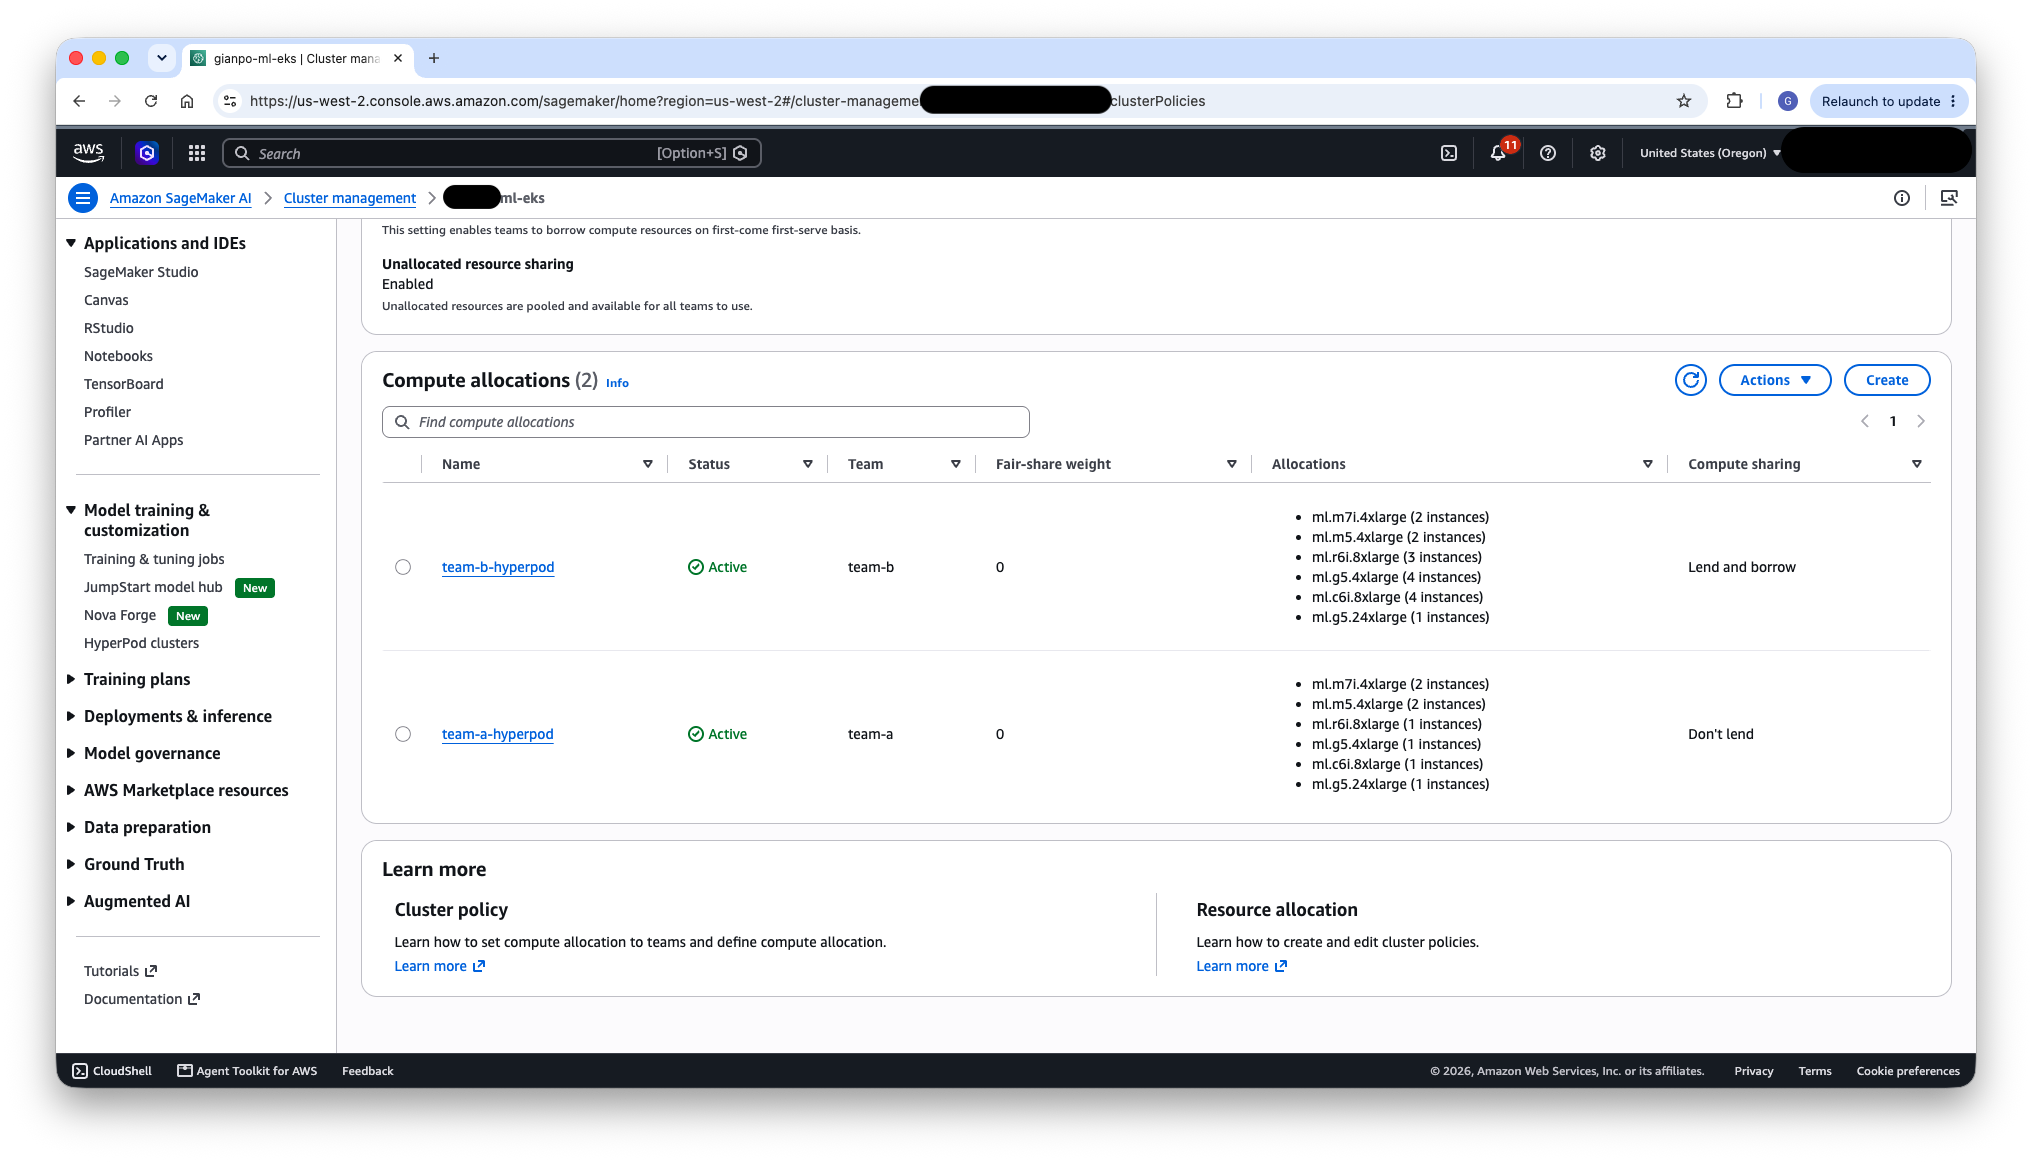
Figura 9: Asignaciones de cómputo de Task Governance por namespace de equipo
Más información: Gobernanza de tareas de SageMaker HyperPod
Almacenamiento
El almacenamiento es un componente clave de los entornos de inteligencia artificial y aprendizaje automático (AI/ML) compartidos entre equipos. Los equipos necesitan sistemas de archivos de alto rendimiento para los datos de entrenamiento, los checkpoints y los artefactos de los modelos, manteniendo al mismo tiempo límites de acceso adecuados entre los equipos.
Sistemas de archivos compatibles con POSIX
Para las cargas de trabajo que requieren un sistema de archivos POSIX compartido y de alto rendimiento (algo común en el entrenamiento distribuido, donde varios nodos leen el mismo conjunto de datos o escriben checkpoints), considere las siguientes opciones:
- Amazon FSx for Lustre – Proporciona acceso a un sistema de archivos paralelo de alto rendimiento y baja latencia, ideal para cargas de trabajo de entrenamiento a gran escala que necesitan leer conjuntos de datos grandes a alta velocidad.
- Amazon FSx for OpenZFS – Ofrece un sistema de archivos de propósito general con una sólida semántica POSIX, snapshots y compresión. Es muy adecuado para cargas de trabajo que necesitan características tradicionales de sistemas de archivos junto con alto rendimiento.
- Amazon Elastic File System (Amazon EFS) – Proporciona almacenamiento de Network File System (NFS) elástico y totalmente administrado. EFS también admite access points, los cuales pueden simplificar el aislamiento de directorios por equipo al asignar diferentes puntos de montaje a diferentes directorios con UID y GID aplicados.
La disposición del almacenamiento generalmente sigue esta estructura:
- Directorios compartidos por equipo – Cada equipo tiene un directorio compartido (por ejemplo,
/fsx/TeamA,/fsx/TeamB) para los conjuntos de datos, modelos y artefactos a los que todos los miembros del equipo necesitan acceder. - Directorios personales por usuario – Cada usuario tiene un directorio personal (por ejemplo,
/home/User1,/home/User2) para el trabajo individual, los experimentos y los notebooks.
El modelo de permisos POSIX en estos sistemas de archivos se basa en UID, GID y grupos suplementarios para aplicar los límites de acceso. Estas identidades POSIX deben propagarse al contexto de seguridad del pod cuando un usuario lanza un HyperPod Space o envía un trabajo de entrenamiento, de modo que el acceso al sistema de archivos respete la propiedad y los permisos configurados. Recomendamos usar un webhook de admisión mutante de Kubernetes para recuperar la información de identidad POSIX de su almacén de identidades. Cuando se envía una carga de trabajo, el webhook busca la identidad en tiempo de ejecución y modifica el contexto de seguridad del Pod en consecuencia.
# 1. Extract the caller's session identity from the admission request.
# On EKS, requests from IAM-assumed roles (including IAM Identity Center)
# surface the STS session name in userInfo.extra["sessionName"]. Its format
# depends on how the session is created (e.g., an SSO short name, an email,
# or a role-session-name); align your identity mapping with this value.
def extract_username(admission_request):
    extra = admission_request["userInfo"]["extra"]
    ...
    return extra["sessionName"][0]

# 2. Look up the POSIX identity from a mapping table (e.g. DynamoDB).
def lookup_posix_identity(username):
    item = posix_table.get_item(Key={"username": username})["Item"]
    ...
    return {
        "uid": int(item["uid"]),
        "gid": int(item["gid"]),
        "supplementalGroups": [int(g) for g in item["supplementalGroups"]],
    }

# 3. Patch the Pod security context with the resolved POSIX identity.
def build_security_context_patch(pod, posix):
    ...
    return [{
        "op": "add",
        "path": "/spec/securityContext",
        "value": {
            "runAsUser": posix["uid"],
            "runAsGroup": posix["gid"],
            "fsGroup": posix["gid"],
            "supplementalGroups": posix["supplementalGroups"],
        },
    }]
Más información: FSx for Lustre · FSx for OpenZFS · Amazon EFS
Almacenamiento de Amazon S3
Para el almacenamiento de objetos, el acceso a los buckets de S3 se rige por el rol de ejecución de IAM del equipo. Puede crear buckets por equipo o usar un bucket compartido con prefijos por equipo, confiando en las políticas de IAM para aplicar el aislamiento. Los pods dentro del clúster necesitan cuentas de servicio configuradas adecuadamente con IAM Roles for Service Accounts (IRSA) o Pod Identity para autenticarse en S3. Por simplicidad, puede asociar el mismo rol de ejecución configurado en el dominio de SageMaker AI a una cuenta de servicio de Kubernetes dentro del espacio de nombres del equipo, proporcionando un acceso coherente a S3 tanto desde Studio como desde las cargas de trabajo del clúster.
Más información: IAM roles for service accounts (IRSA) · EKS Pod Identity
HyperPod Spaces
HyperPod Spaces proporciona entornos de desarrollo interactivos (IDE) que se ejecutan directamente en los nodos del clúster. En un clúster compartido, los Spaces deben estar correctamente acotados al espacio de nombres de cada equipo y configurados con las plantillas de recursos apropiadas.
Plantillas de Space
Cree plantillas de Space acotadas al espacio de nombres para cada equipo. Estas plantillas definen las configuraciones de recursos (tipos de instancia, volúmenes de almacenamiento, variables de entorno) disponibles para los miembros del equipo al crear Spaces. Al acotar las plantillas a un espacio de nombres, se asegura de que cada equipo solo pueda iniciar Spaces dentro de su límite designado.
Cuando HyperPod Task Governance está habilitado, las plantillas deben incluir las etiquetas predeterminadas requeridas por el sistema de gobernanza (como los identificadores de equipo y las etiquetas de prioridad). El administrador del clúster preconfigura estas etiquetas para que los miembros del equipo no necesiten especificarlas manualmente al iniciar Spaces.
El siguiente ejemplo muestra una plantilla de Space de JupyterLab acotada al Team A. Las partes específicas del equipo son la metadata.namespace, la etiqueta de cola de Task Governance bajo baseLabels, y la defaultVolumes que monta el sistema de archivos compartido del equipo y el directorio de inicio del usuario:
apiVersion: workspace.jupyter.org/v1alpha1
kind: WorkspaceTemplate
metadata:
  name: jl-smd-custom
  namespace: hyperpod-ns-team-a  # scopes the template to Team A's namespace
spec:
  displayName: "JupyterLab (team-a)"
  description: "SageMaker Distribution"
  appType: jupyterlab
  baseLabels:
  - key: kueue.x-k8s.io/queue-name  # Task Governance (Kueue) local queue for Team A
    value: hyperpod-ns-team-a-localqueue
  ...
  # container command, default CPU/memory resources, security context, access type, etc.
  ...
  defaultVolumes:
  - name: home-dir  # per-user home directory
    mountPath: /home
    persistentVolumeClaimName: fsx-openzfs-claim
  - name: shared-data  # Team A's shared directory
    mountPath: /fsx
    persistentVolumeClaimName: fsx-lustre-claim
  ...
  # primary (EBS) storage defaults and limits
  ...
Persistent volume claims
Cree los Persistent Volume Claims (PVC) apropiados en el espacio de nombres de cada equipo, haciendo referencia al sistema de archivos compartido. Estos PVC montan el directorio compartido del equipo y el directorio de inicio del usuario en el Space, proporcionando acceso a los datos de entrenamiento, los checkpoints y los espacios de trabajo personales.
Spaces solo para el propietario y compartidos
Considere los requisitos de su organización en cuanto al uso compartido de Spaces:
- Spaces solo para el propietario – Cada Space solo es accesible para el usuario que lo creó. Esta es la configuración predeterminada, apropiada cuando los equipos trabajan en proyectos sensibles o independientes.
- Spaces compartidos – Varios miembros del equipo pueden acceder al mismo Space, lo cual es útil para programación en pareja, depuración colaborativa o entornos de desarrollo compartidos. Al habilitar los Spaces compartidos, asegúrese de que los permisos POSIX y los grupos suplementarios estén configurados para permitir el acceso adecuado a los archivos creados dentro del Space.
Más información: Entornos de desarrollo interactivos en clústeres de Amazon SageMaker HyperPod EKS
Experiencia de Studio
Si bien los equipos pueden interactuar con el clúster completamente desde la CLI usando kubectl, SageMaker Studio proporciona un punto de entrada gráfico al clúster para los usuarios que prefieren un flujo de trabajo administrado basado en GUI. En esta arquitectura, cada equipo accede a Studio a través de su propio dominio de SageMaker AI (como se describió anteriormente), iniciando sesión con las mismas credenciales de Identity Center y operando dentro de los límites del espacio de nombres del equipo.
La siguiente imagen muestra el portal de acceso de IAM Identity Center al que llegan los usuarios después de iniciar sesión con sus credenciales corporativas, proporcionando acceso de inicio de sesión único a sus aplicaciones de SageMaker Studio asignadas y a las aplicaciones de Amazon Managed Grafana.
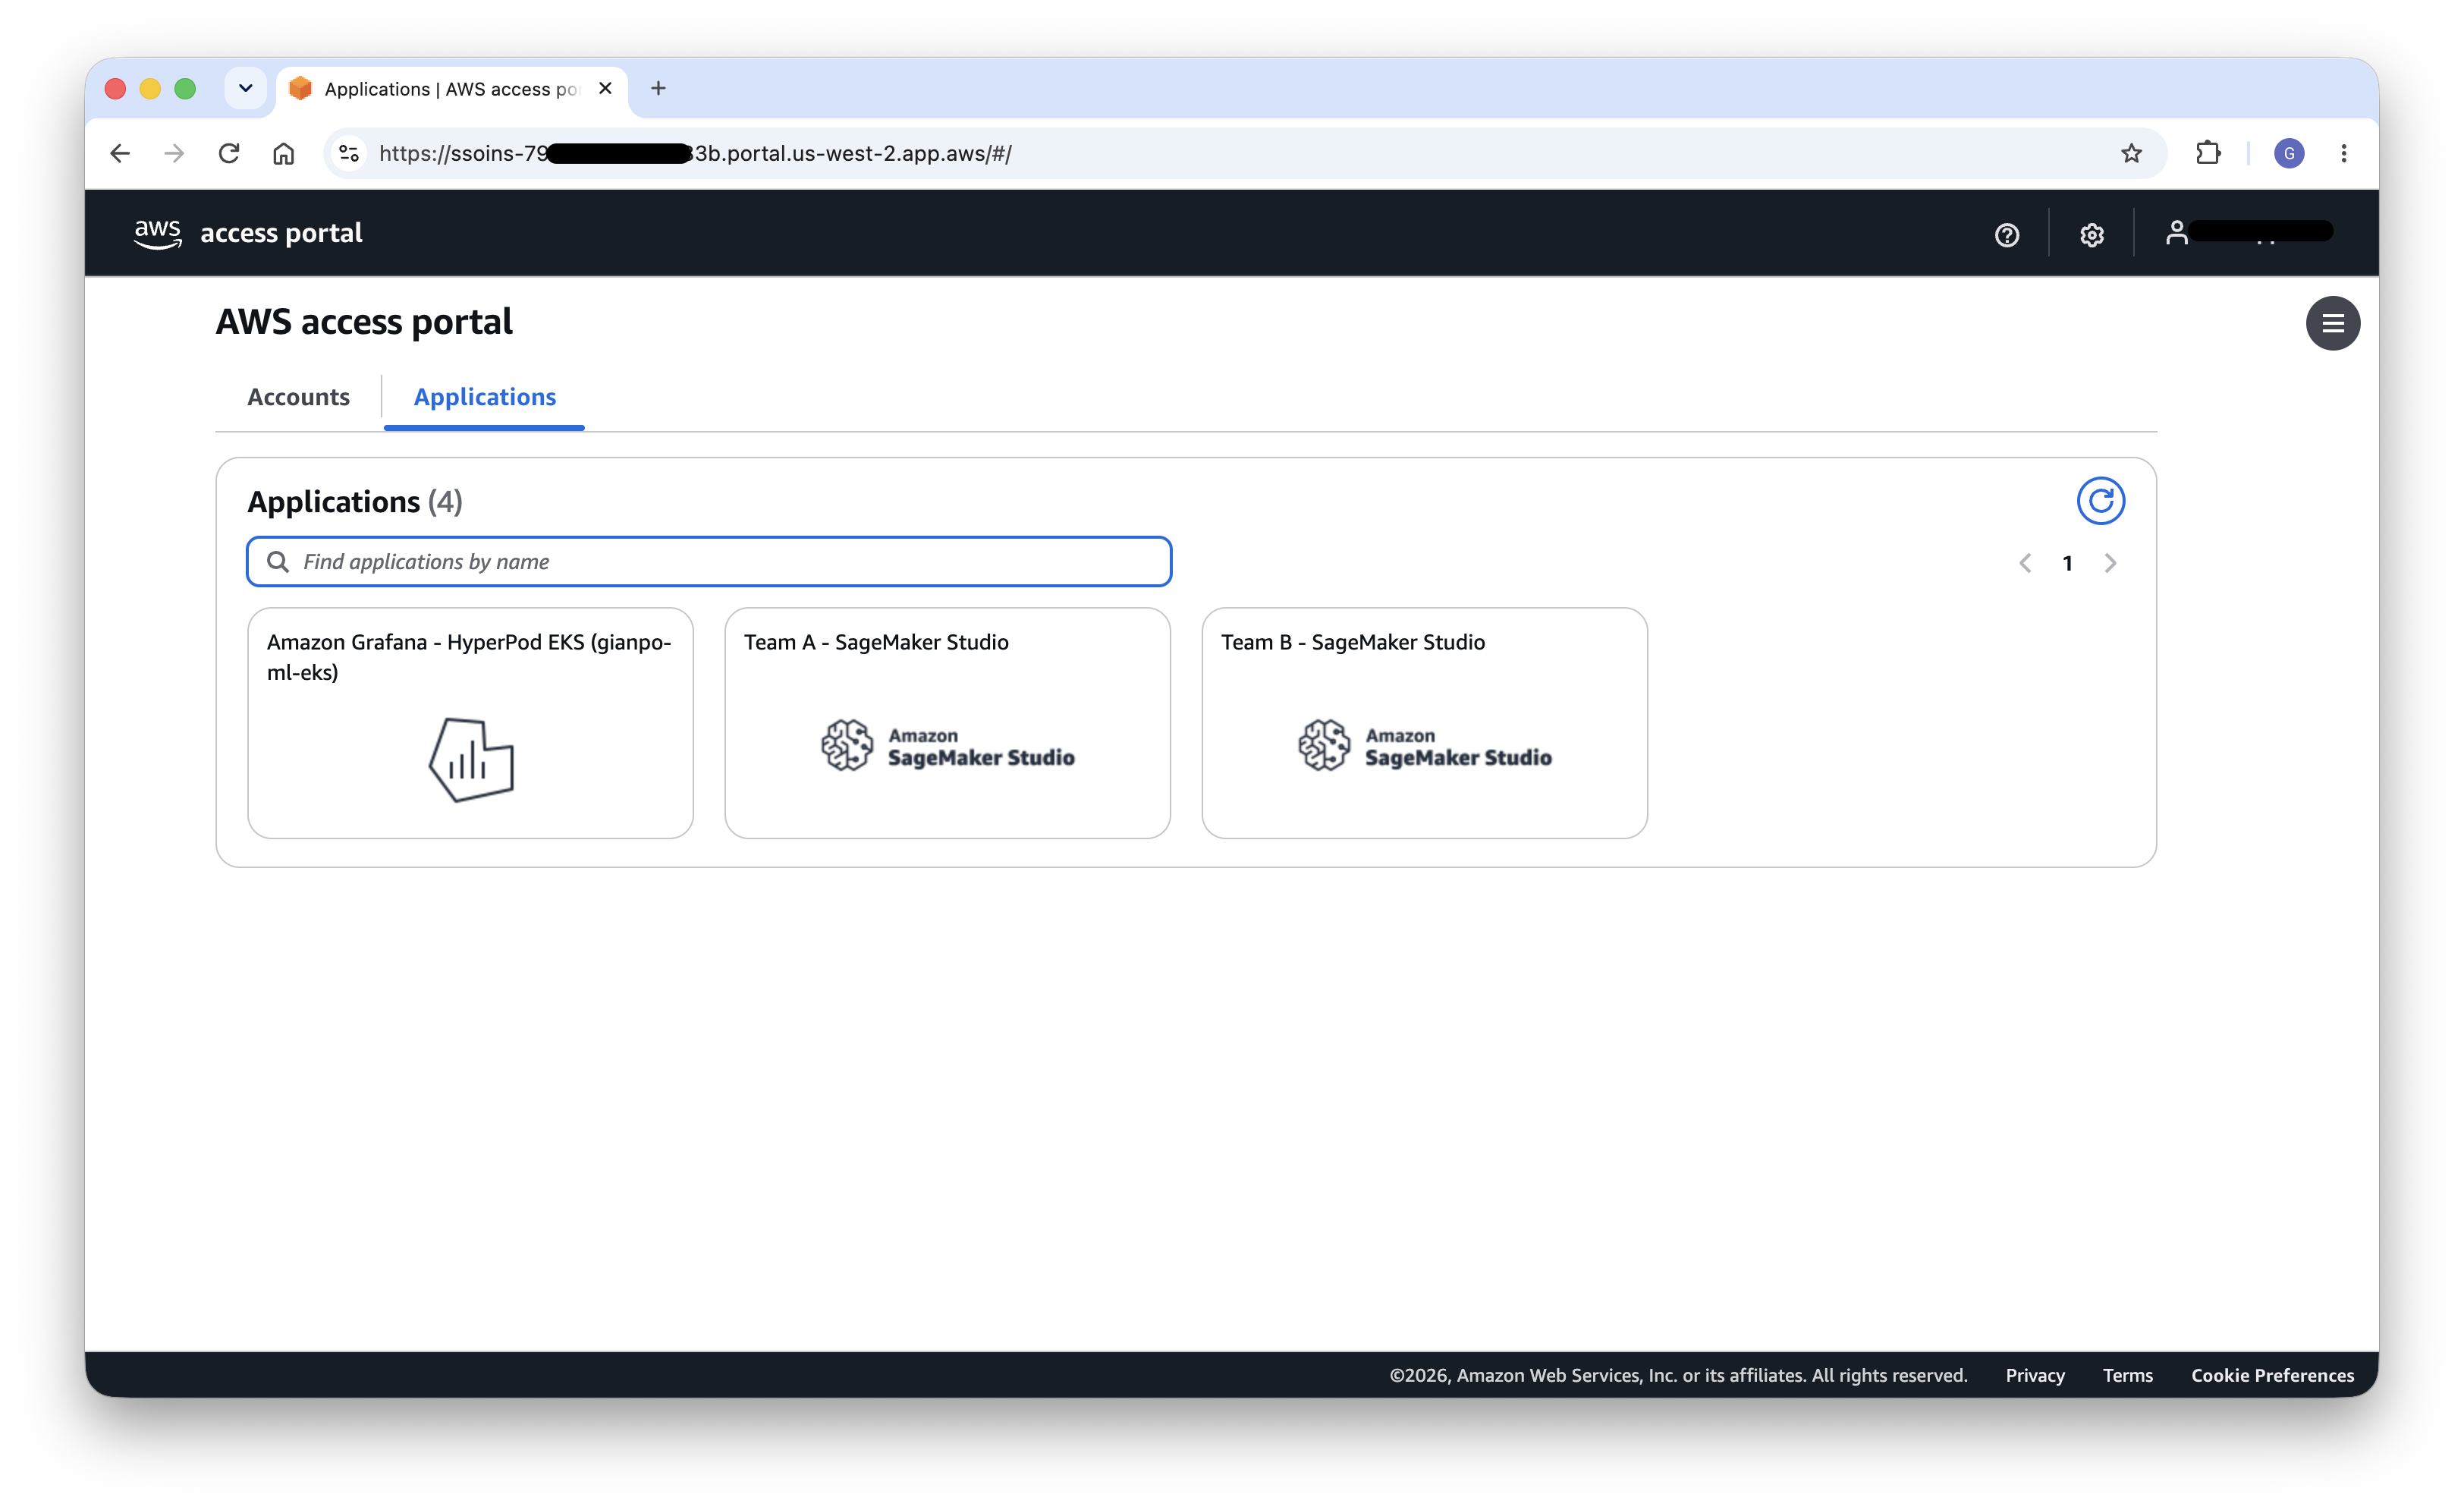
Figura 10: Portal de acceso de IAM Identity Center con inicio de sesión único en las aplicaciones asignadas
Desde la interfaz de Studio, los miembros del equipo pueden:
- Administrar HyperPod Spaces – Lanzar entornos de desarrollo interactivos a partir de las plantillas de Space con ámbito de namespace que el administrador ha configurado, sin escribir manifiestos de Kubernetes ni especificar etiquetas de Task Governance manualmente. Los miembros del equipo también pueden iniciar, detener y conectarse a sus Spaces en ejecución, abriendo el IDE asociado (como JupyterLab) directamente en el navegador.
- Administrar cargas de trabajo de Ray – Crear y supervisar clústeres de Ray, conectar un espacio de trabajo de JupyterLab o Code Editor a un clúster, enviar trabajos distribuidos y abrir el Ray Dashboard y los paneles de observabilidad de Amazon Managed Grafana, todo sin escribir manifiestos de Kubernetes ni ejecutar
kubectlcomandos.
Dado que Studio opera a través del rol de ejecución del Domain del equipo y de la entrada de acceso EKS correspondiente, todas las acciones están limitadas al namespace del equipo. Un usuario que lanza un Space o un clúster de Ray desde Studio solo puede crearlo dentro del límite de su propio equipo, de forma coherente con el modelo de aislamiento aplicado al acceso por CLI.
La siguiente imagen muestra cómo crear un HyperPod Space desde la interfaz de SageMaker Studio, donde un miembro del equipo selecciona una plantilla de Space con ámbito de namespace sin escribir manifiestos de Kubernetes ni especificar etiquetas de Task Governance manualmente.
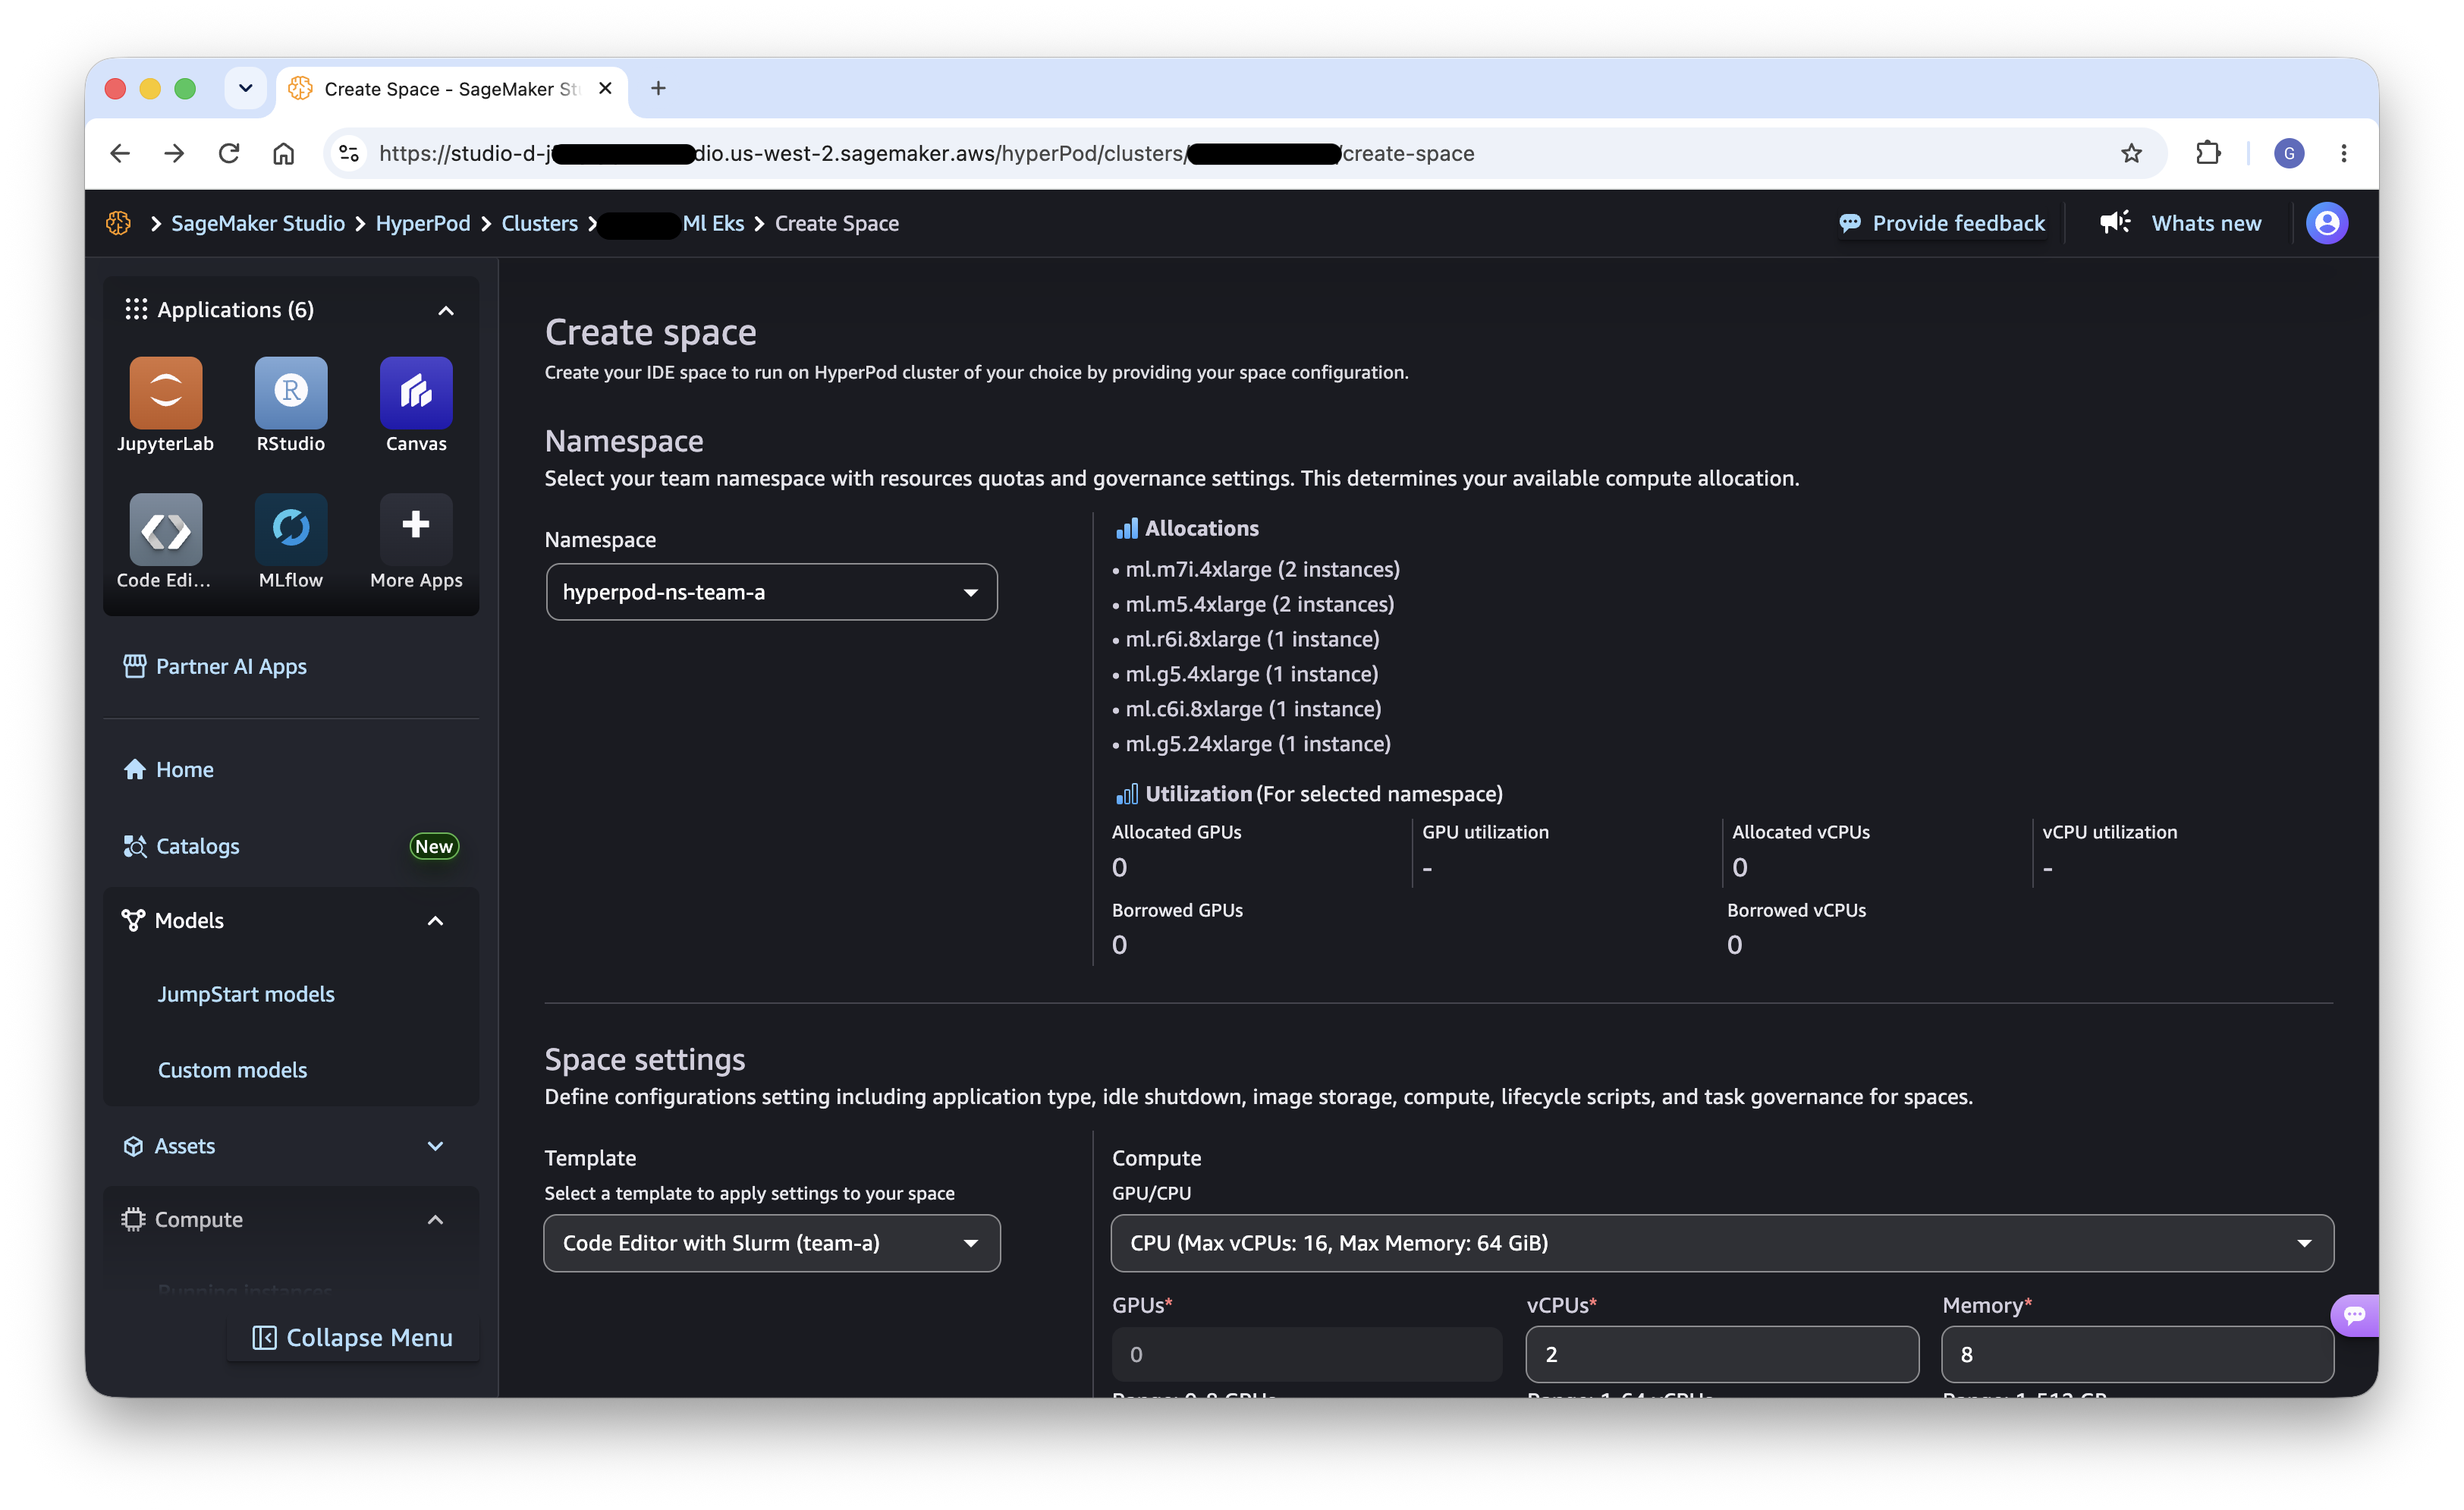
Figura 11: Creación de un HyperPod Space a partir de una plantilla con ámbito de namespace en SageMaker Studio
Más información: Entornos de desarrollo interactivos en clústeres EKS de Amazon SageMaker HyperPod · Presentación de las nuevas capacidades de Ray en SageMaker HyperPod
HyperPod Training Operator
El HyperPod Training Operator permite a los equipos enviar trabajos de entrenamiento distribuido como recursos personalizados de Kubernetes (por ejemplo, HyperPodPyTorchJob). En la arquitectura multiusuario, los trabajos de entrenamiento tienen alcance de namespace, lo que significa que heredan automáticamente los límites de aislamiento del equipo.
Los equipos pueden enviar trabajos de entrenamiento desde la CLI usando kubectl apply con el manifiesto de trabajo adecuado. El trabajo se ejecuta en el namespace del equipo, usa las cuotas de cómputo del equipo (si Task Governance está habilitado) y tiene acceso a los volúmenes de almacenamiento del equipo.
Cuando Task Governance está habilitado, los trabajos de entrenamiento están sujetos a las cuotas asignadas y a la configuración de prioridad del equipo. Si un equipo ha consumido su asignación garantizada, los trabajos pueden quedar en cola hasta que haya recursos disponibles o hasta que se expulsen cargas de trabajo de menor prioridad.
Los dos elementos que anclan un trabajo a un equipo son metadata.namespace (que limita el alcance del trabajo al límite de aislamiento del equipo) y las etiquetas de Task Governance. Task Governance está construido sobre Kueue, por lo que el trabajo se enruta a la cola local del equipo a través de kueue.x-k8s.io/queue-name. Se le asigna una prioridad de programación mediante kueue.x-k8s.io/priority-class, cuyo valor es el nombre de un WorkloadPriorityClass definido en el clúster:
apiVersion: sagemaker.amazonaws.com/v1
kind: HyperPodPyTorchJob
metadata:
  name: team-a-training-job
  namespace: hyperpod-ns-team-a  # scopes the job to Team A's namespace
  labels:
    kueue.x-k8s.io/queue-name: hyperpod-ns-team-a-localqueue  # Task Governance (Kueue) local queue
    kueue.x-k8s.io/priority-class: training-priority  # name of a WorkloadPriorityClass
spec:
  ...
  # replicaSpecs, container image, command, resources, volumes, etc.
  ...
Más información: Uso del HyperPod training operator
HyperPod Inference Operator
El HyperPod Inference Operator permite a los equipos desplegar modelos como endpoints de inferencia directamente en el clúster. De manera similar a los trabajos de entrenamiento, los endpoints de inferencia tienen alcance de namespace y están sujetos a las políticas RBAC del equipo y a las cuotas de Task Governance.
Los equipos pueden desplegar modelos desde la CLI creando recursos personalizados de endpoints de inferencia en su namespace. Los endpoints están aislados por namespace, lo que significa que el Equipo A no puede acceder ni interferir con los endpoints de inferencia del Equipo B.
Para cargas de trabajo de inferencia de producción que requieran alta disponibilidad, considere asignar una prioridad de programación más alta a los endpoints de inferencia que a los trabajos de entrenamiento, de modo que el servicio de modelos no se interrumpa por cargas de trabajo de entrenamiento por lotes.
Al igual que con los trabajos de entrenamiento, el endpoint de inferencia se coloca en el metadata.namespace del equipo y lleva las etiquetas de Task Governance. Aquí, el kueue.x-k8s.io/priority-class hace referencia a un WorkloadPriorityClass de mayor prioridad para que el servicio de modelos pueda expulsar el entrenamiento por lotes cuando los recursos del equipo estén limitados:
apiVersion: inference.sagemaker.aws.amazon.com/v1
kind: InferenceEndpointConfig
metadata:
  name: team-a-inference-endpoint
  namespace: hyperpod-ns-team-a  # scopes the endpoint to Team A's namespace
  labels:
    kueue.x-k8s.io/queue-name: hyperpod-ns-team-a-localqueue  # Task Governance (Kueue) local queue
    kueue.x-k8s.io/priority-class: inference-priority  # higher-priority WorkloadPriorityClass
spec:
  ...
  # model source, instance type, replica count, autoscaling, etc.
  ...
Más información: Despliegue de modelos en Amazon SageMaker HyperPod
HyperPod Observability
La visibilidad del estado del clúster, el rendimiento de las cargas de trabajo y la utilización de recursos es esencial para todos los equipos. HyperPod Observability proporciona capacidades integradas de monitoreo y paneles a través de Amazon Managed Grafana.
Configuración del acceso de los equipos a Grafana
Los equipos necesitan acceso a los paneles de observabilidad para monitorear sus cargas de trabajo, solucionar problemas de rendimiento y comprender el consumo de recursos. Sin embargo, en un entorno multiusuario, este acceso normalmente debería ser de solo lectura:
- Configuración de la autenticación de Identity Center para Amazon Managed Grafana – En la consola de Amazon Managed Grafana, navegue a Authentication y habilite AWS IAM Identity Center. Los usuarios podrán iniciar sesión en Grafana con las mismas credenciales corporativas que usan para SageMaker Studio.
- Asignar grupos de equipo como Viewers – Mapee los grupos de Identity Center (
TeamA,TeamB) al rol Viewer de Grafana. Esto otorga a los miembros del equipo acceso de solo lectura a los dashboards y métricas, sin la capacidad de modificar dashboards ni fuentes de datos. - Acceso de administrador – Asigne el grupo
Adminal rol Admin o Editor de Grafana, para que puedan crear y modificar dashboards, configurar alertas y administrar fuentes de datos. - Dashboards específicos por equipo – Considere crear dashboards dedicados que filtren los datos por namespace, de modo que cada equipo vea únicamente las métricas de sus propias cargas de trabajo. Amazon Managed Grafana admite Grafana Teams (un concepto RBAC nativo de Grafana, distinto de los equipos organizacionales en esta arquitectura), que se pueden mapear desde grupos de Identity Center para restringir la visibilidad de los dashboards y proporcionar una capa adicional de aislamiento de datos.
La siguiente imagen muestra las asignaciones de roles de Grafana en Amazon Managed Grafana. Los grupos de equipo (TeamA, TeamB) tienen asignado el rol Viewer para acceso de solo lectura a los dashboards y métricas, mientras que al grupo de administradores se le asigna el rol Admin, lo que le otorga la capacidad de crear y modificar dashboards, configurar alertas y administrar fuentes de datos.
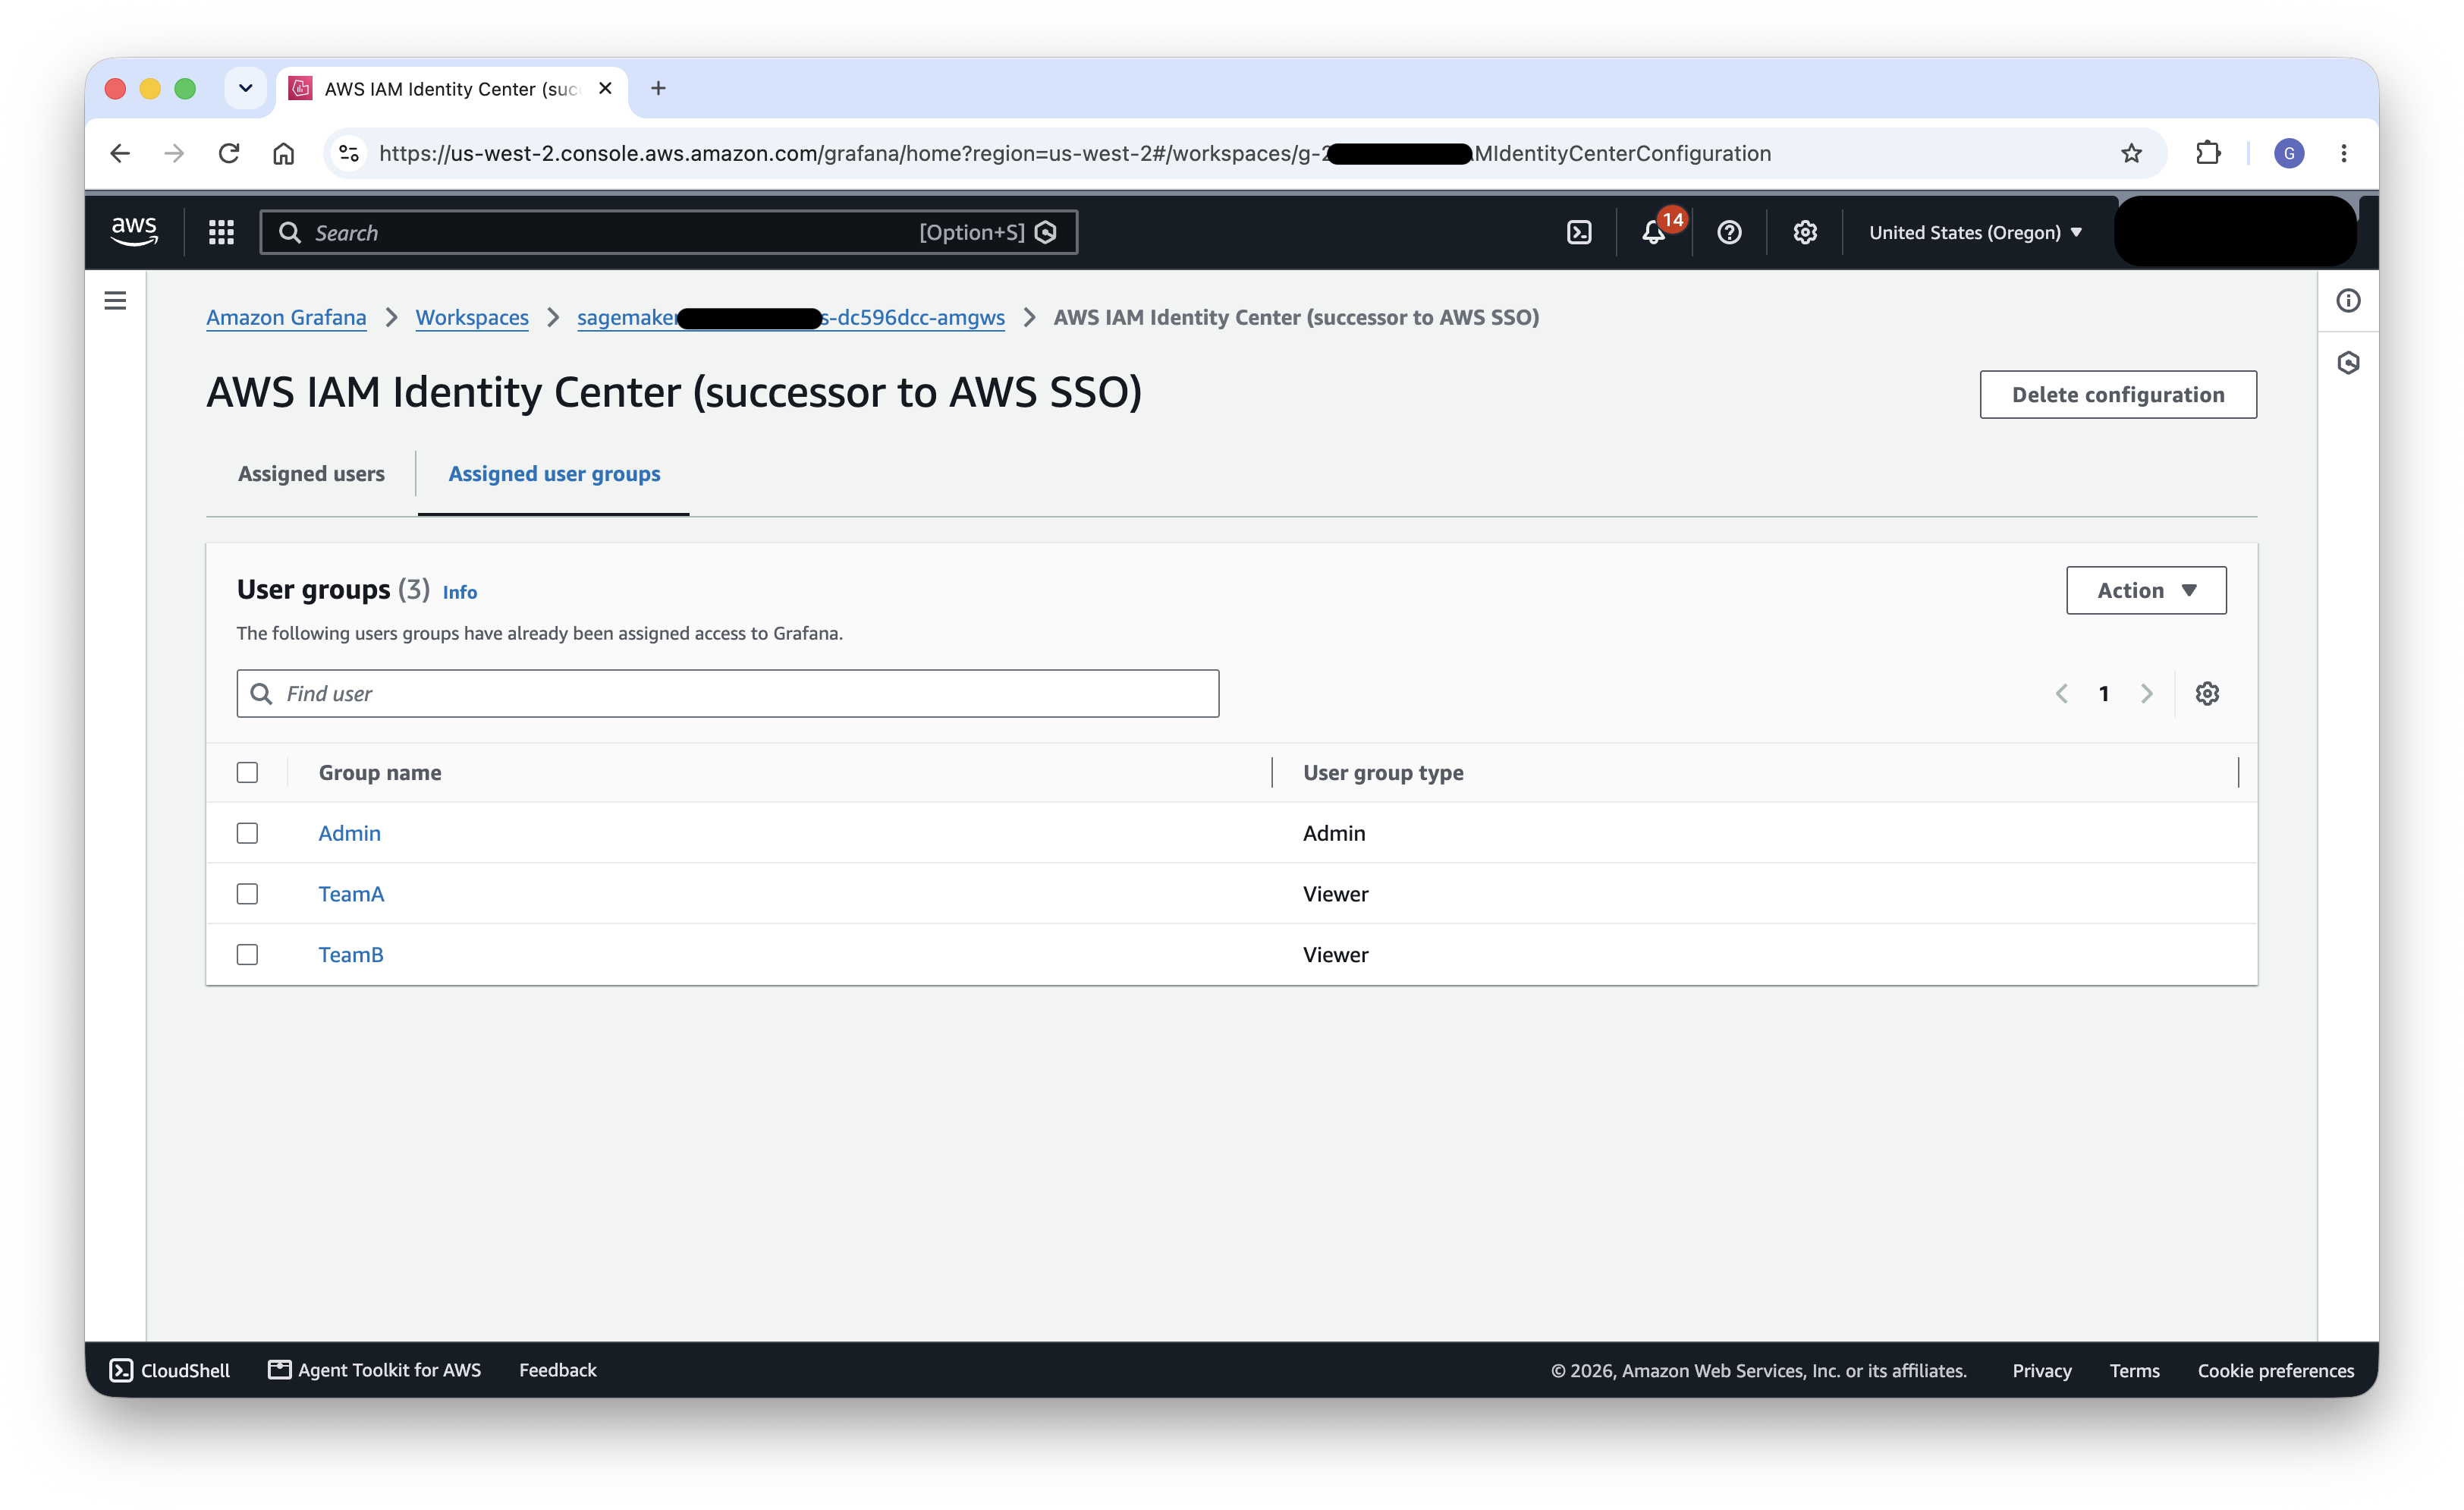
Figura 12: Asignaciones de roles de Grafana que otorgan a los equipos acceso Viewer de solo lectura
Más información: Observabilidad para el clúster de Amazon SageMaker HyperPod orquestado por Amazon EKS
Asignación de costos y contracargo
En un entorno multiusuario donde los equipos comparten una costosa infraestructura de GPU, comprender quién consume qué es esencial para la rendición de cuentas, la presupuestación y el cobro interno. Kubecost aborda esta necesidad desglosando el gasto dentro del clúster según conceptos nativos de Kubernetes (namespace, label, deployment y service) y mapeándolo a conceptos organizativos como equipo, proyecto o entorno.
Debido a que esta arquitectura ya aísla a cada equipo en un namespace dedicado (hyperpod-ns-team-a, hyperpod-ns-team-b), la asignación de costos a nivel de namespace se alinea directamente con los límites de los equipos. Esto brinda a los administradores de plataforma una vista clara por equipo del consumo de GPU, CPU, memoria, almacenamiento y red sin necesidad de etiquetado adicional de las cargas de trabajo. Para obtener instrucciones paso a paso sobre cómo desplegar y configurar Kubecost en un clúster de HyperPod, consulte Kubecost en SageMaker HyperPod.
Habilitar la visibilidad del equipo
Una vez que Kubecost esté recopilando datos, agrupe los costos por namespace en el panel Allocations para ver el gasto por equipo. Como cada equipo es dueño de un namespace, esto produce directamente un desglose de costos por equipo que cubre cómputo, memoria, almacenamiento y red. Al igual que con los paneles de observabilidad, los equipos se benefician de la visibilidad de sus propios datos de costos:
- Vistas de alcance al namespace de cada equipo – Kubecost admite filtrado e informes guardados por espacio de nombres, por lo que cada equipo puede revisar su propio consumo y tendencias sin ver los datos de otros equipos.
- Establecer presupuestos y alertas – Configure umbrales y alertas de presupuesto por namespace, de modo que los equipos y los administradores de plataforma reciban notificaciones cuando el gasto se acerque a los límites definidos, apoyando los mismos objetivos de equidad de recursos que HyperPod Task Governance.
- Soportar chargeback y showback – Los informes de asignación a nivel de namespace pueden alimentar procesos internos de chargeback (facturación a los equipos por su uso) o showback (informar del uso sin facturar), brindando a los equipos de finanzas y de plataforma los datos que necesitan para atribuir de manera justa los costos compartidos de GPU.
La siguiente imagen muestra el panel de Asignaciones de Kubecost agrupado por namespace, que muestra el costo acumulado de los últimos 7 días para el namespace de cada equipo.
Figura 13: Panel de asignaciones de Kubecost agrupado por espacio de nombres para costos por equipo
Más información: Kubecost en SageMaker HyperPod · Kubecost
Conclusión
Esta publicación presentó una arquitectura de referencia para construir entornos multiinquilino en Amazon SageMaker HyperPod con EKS. Al combinar AWS IAM Identity Center para la autenticación, roles de IAM por equipo para la autorización a nivel de AWS, dominios de SageMaker AI para una experiencia de espacio de trabajo personalizada, espacios de nombres de Kubernetes para el aislamiento de las cargas de trabajo, HyperPod Task Governance para una asignación equitativa de recursos y asignación de costos a nivel de espacio de nombres para visibilidad del gasto por equipo, varios equipos pueden compartir eficientemente un único clúster de HyperPod EKS.
Este es un enfoque flexible y componible que combina múltiples bloques de construcción en una solución cohesiva. La arquitectura se adapta a una variedad de casos de uso y estructuras organizativas. Por ejemplo, las organizaciones pueden ampliar este patrón para conectar equipos a clústeres de HyperPod Slurm junto con EKS, proporcionando una experiencia multiinquilino unificada a través de diferentes backends de orquestación.
Si bien este enfoque requiere ensamblar y configurar varios componentes, el resultado es un alto grado de control y personalización que puede adaptarse a los requisitos específicos de aislamiento, cumplimiento y operación de cada organización. Los patrones fundamentales (federación de identidades, aislamiento de espacios de nombres, RBAC, gobernanza basada en cuotas y asignación de costos) seguirán siendo aplicables.
Para empezar, intente construir esta configuración multiinquilino en su propio clúster de Amazon SageMaker HyperPod EKS, y adapte los componentes básicos a los requisitos de aislamiento, gobernanza y asignación de costos de su organización.