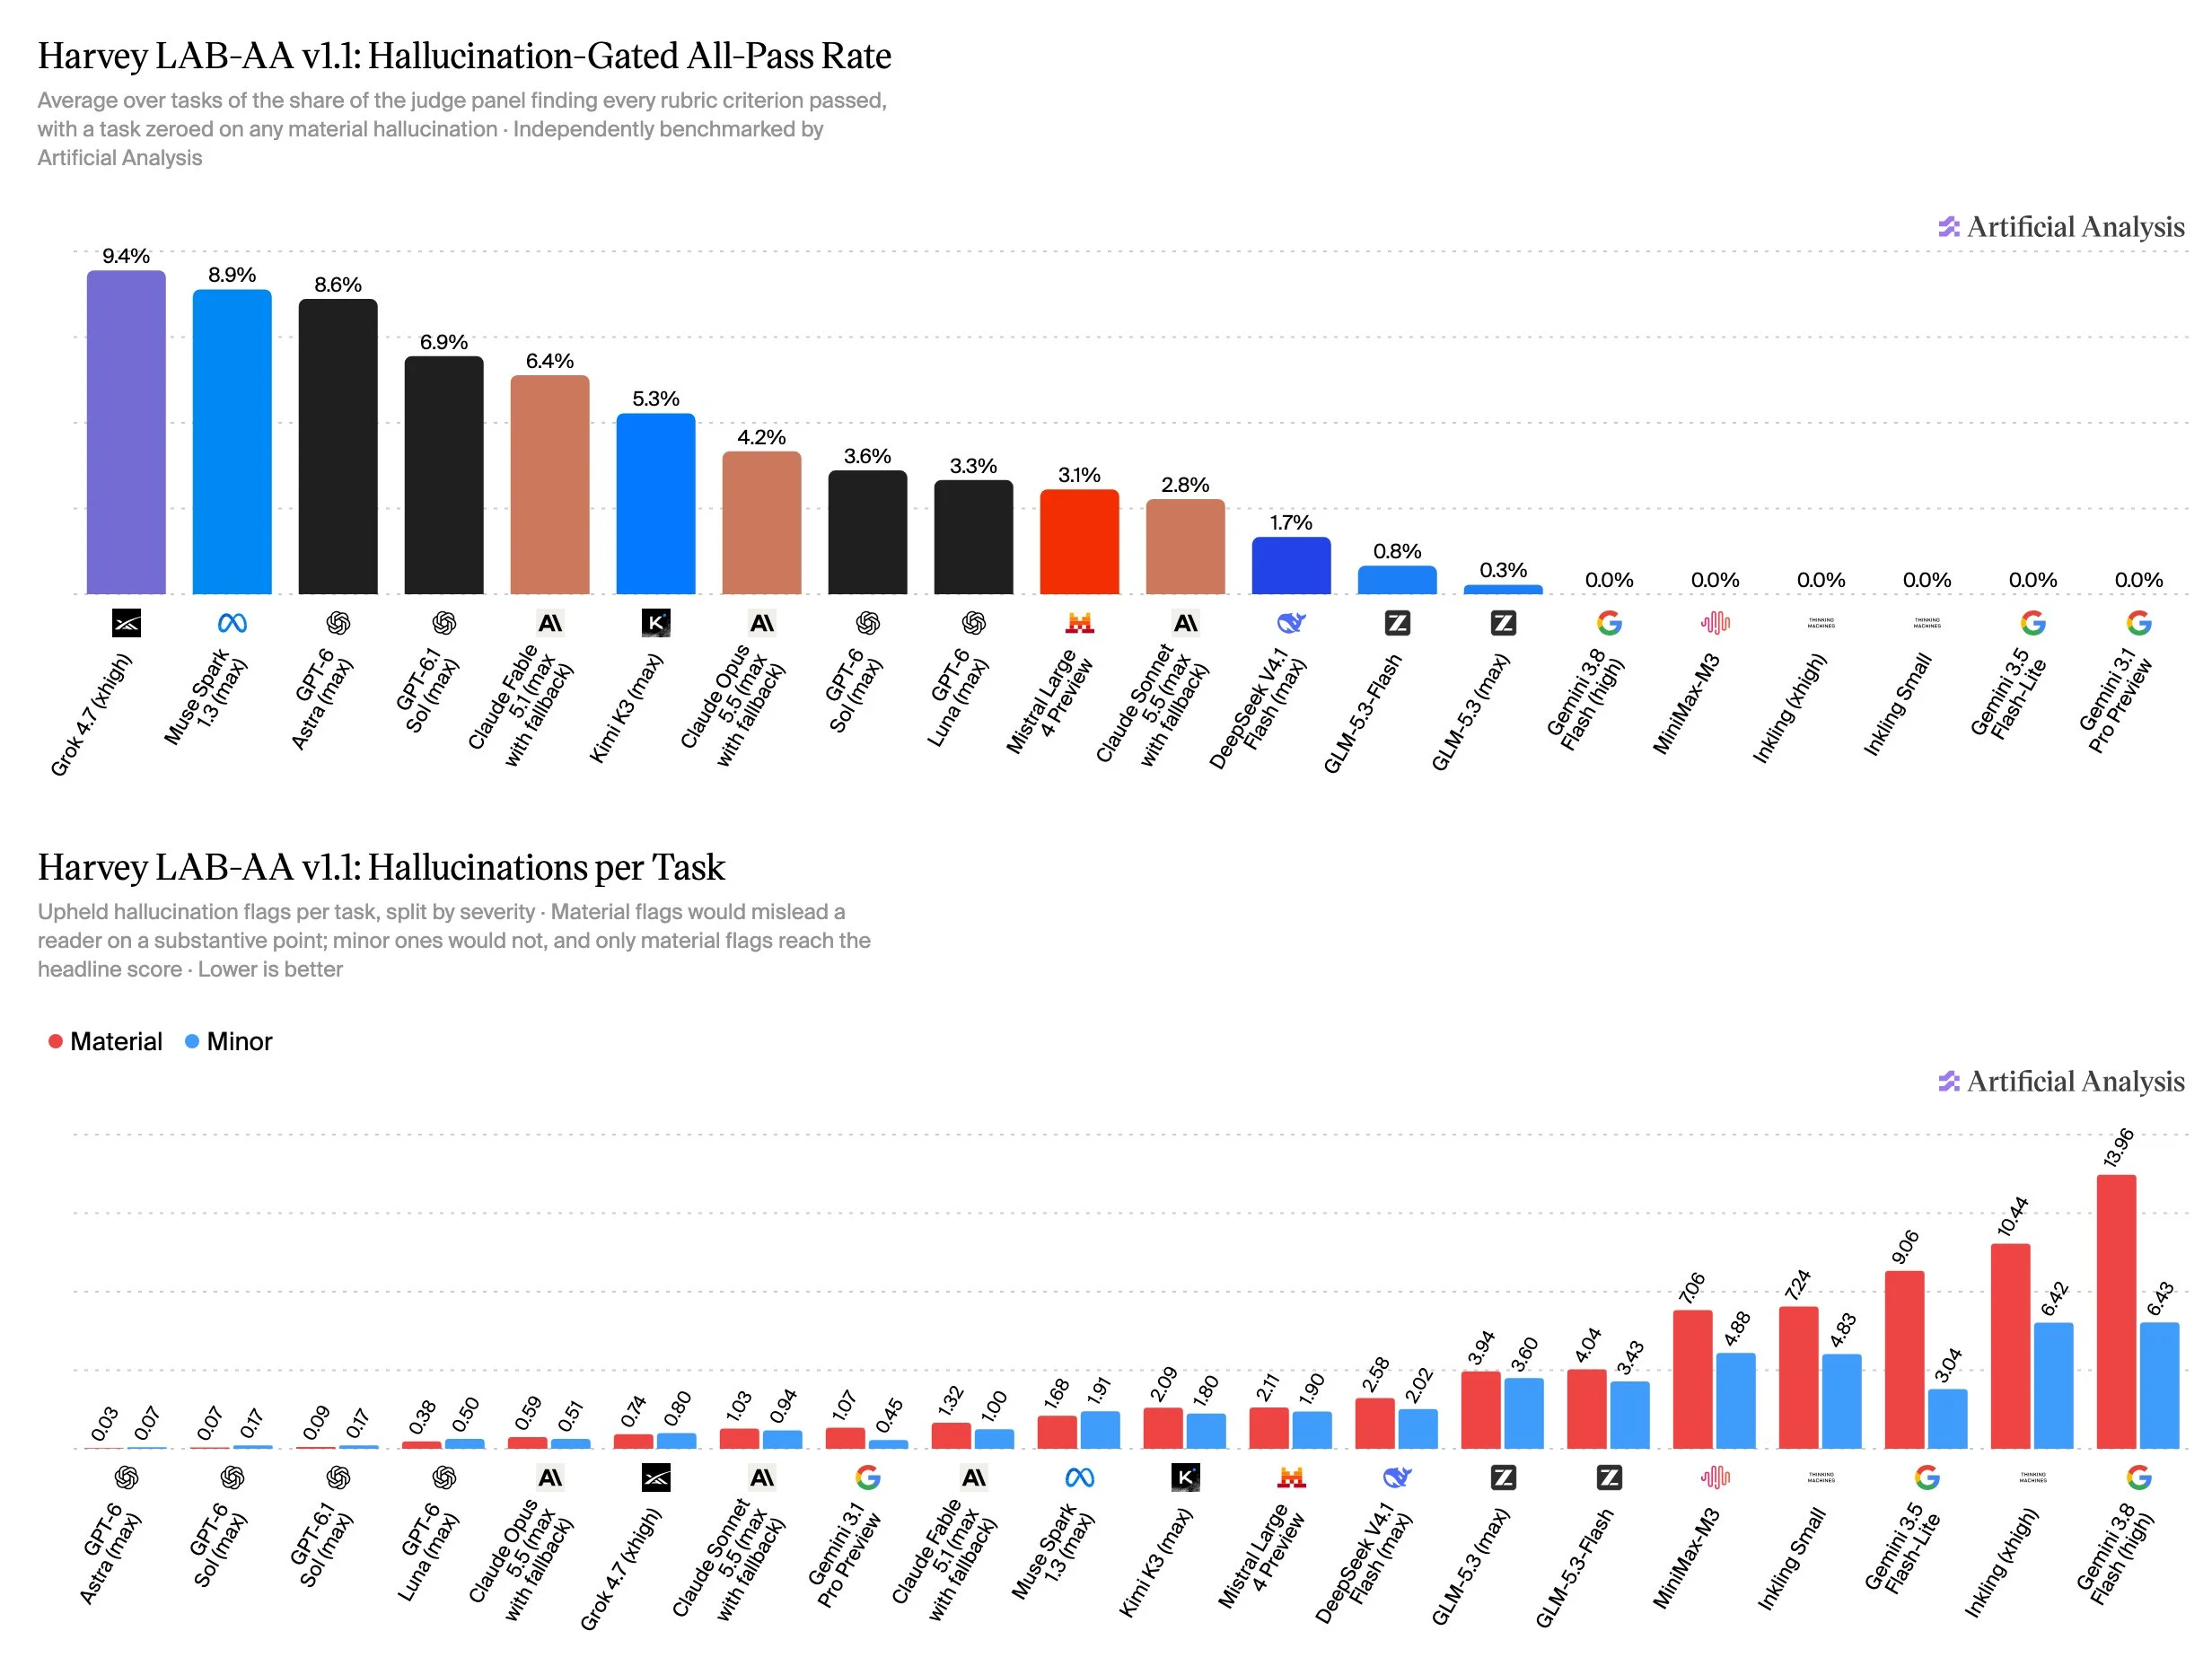
Hoy anunciamos Harvey LAB-AA v1.1 en colaboración con Harvey. Esta actualización modifica nuestra metodología de calificación para el Legal Agent Benchmark (LAB) para incluir una verificación de alucinaciones y exigir respuestas correctas que eviten la inclusión de declaraciones erróneas. La nueva métrica principal de LAB-AA v1.1, Hallucination-Gated All-Pass Rate, otorga puntos solo cuando los resultados cumplen con todos los criterios establecidos y no contienen alucinaciones materiales.
Definimos una alucinación material como aquella que puede engañar al lector en un punto sustantivo, como por ejemplo una fecha requerida contractualmente incorrecta, mientras que una alucinación menor es un error real que es poco probable que afecte significativamente la interpretación legal de un producto entregado. Las alucinaciones menores se reportan por separado y no afectan la puntuación principal.
Grok 4.7 (xhigh) lidera con una tasa de paso total gestionada por alucinaciones del 9.4%, y más del 60% de los resultados que pasan en los modelos probados en el lanzamiento contienen alucinaciones materiales.
Este es el primer paso para mejorar la metodología de Harvey LAB-AA. En actualizaciones futuras, trabajaremos con Harvey para tener en cuenta mejor todo el conjunto de factores que los abogados valoran, incluyendo características de usabilidad como el estilo y el tono.
Puntos clave:
➤ Líder en la clasificación: Grok 4.7 (xhigh) de @SpaceXAI lidera con un 9.4% de tasa de paso total gestionada por alucinaciones, ligeramente por delante de Muse Spark 1.3 (max) de @AIatMeta con un 8.9% y GPT-6 Astra (max) de @OpenAI con un 8.6%.
➤ Las alucinaciones reconfiguran la clasificación: sin el portal de alucinaciones, Muse Spark 1.3 (máx) lideraría claramente con una tasa de paso total del 26.7%, pero dos tercios de esos pases contienen una o más alucinaciones materiales, lo que resulta en una tasa de paso total con gating de alucinaciones del 8.9%. GPT-6 Astra (máx) conserva casi todos sus pases después del portal de alucinaciones (del 8.9% al 8.6%) y pasa del 10º al 3er lugar.
➤ La familia de modelos GPT-6 es la más sólida: GPT-6 Astra (máx.) promedia 0.03 alucinaciones materiales por tarea (4 en total de 120 tareas), y GPT-6 Sol (máx.) promedia 0.07. Al comparar seis modelos de verificador en un subconjunto de 20 tareas, GPT-6 Astra no tuvo ninguna alucinación material bajo ningún verificador, incluyendo Claude Opus 5.5 (alto). En contraste, Gemini 3.8 Flash (alto) promedia 13.96 alucinaciones materiales por tarea.
➤ Los modelos con mayor puntuación no son los más caros: Grok 4.7 (xhigh) ocupa el primer lugar en la clasificación, a un costo de aproximadamente $9.50 por tarea, lo que es menos de la mitad del costo de Claude Fable 5.1 (max con fallback), que es de aproximadamente $21.70, siendo el modelo más caro. Muse Spark 1.3 (max) representa un rendimiento sólido para su costo, ocupando el segundo lugar a un costo de aproximadamente $4.20 por tarea
Gracias a @nikogrupen y @ItsJulioPereyra de @harvey por su trabajo en Harvey LAB y la colaboración.