
Por Yi Shui, desde Aofeisi
QbitAI | Cuenta oficial QbitAI
¿Jugar videojuegos mientras se actualiza a sí mismo?
Vaya cosa, ¿Huawei directamente le enseñó a la IA a 'volverse más fuerte mientras juega'?!
En su estudio más reciente, el laboratorio Noah's Ark de Huawei, junto con equipos como el de UCL, ha presentado un sistema de agentes de IA llamadoMemento 3—
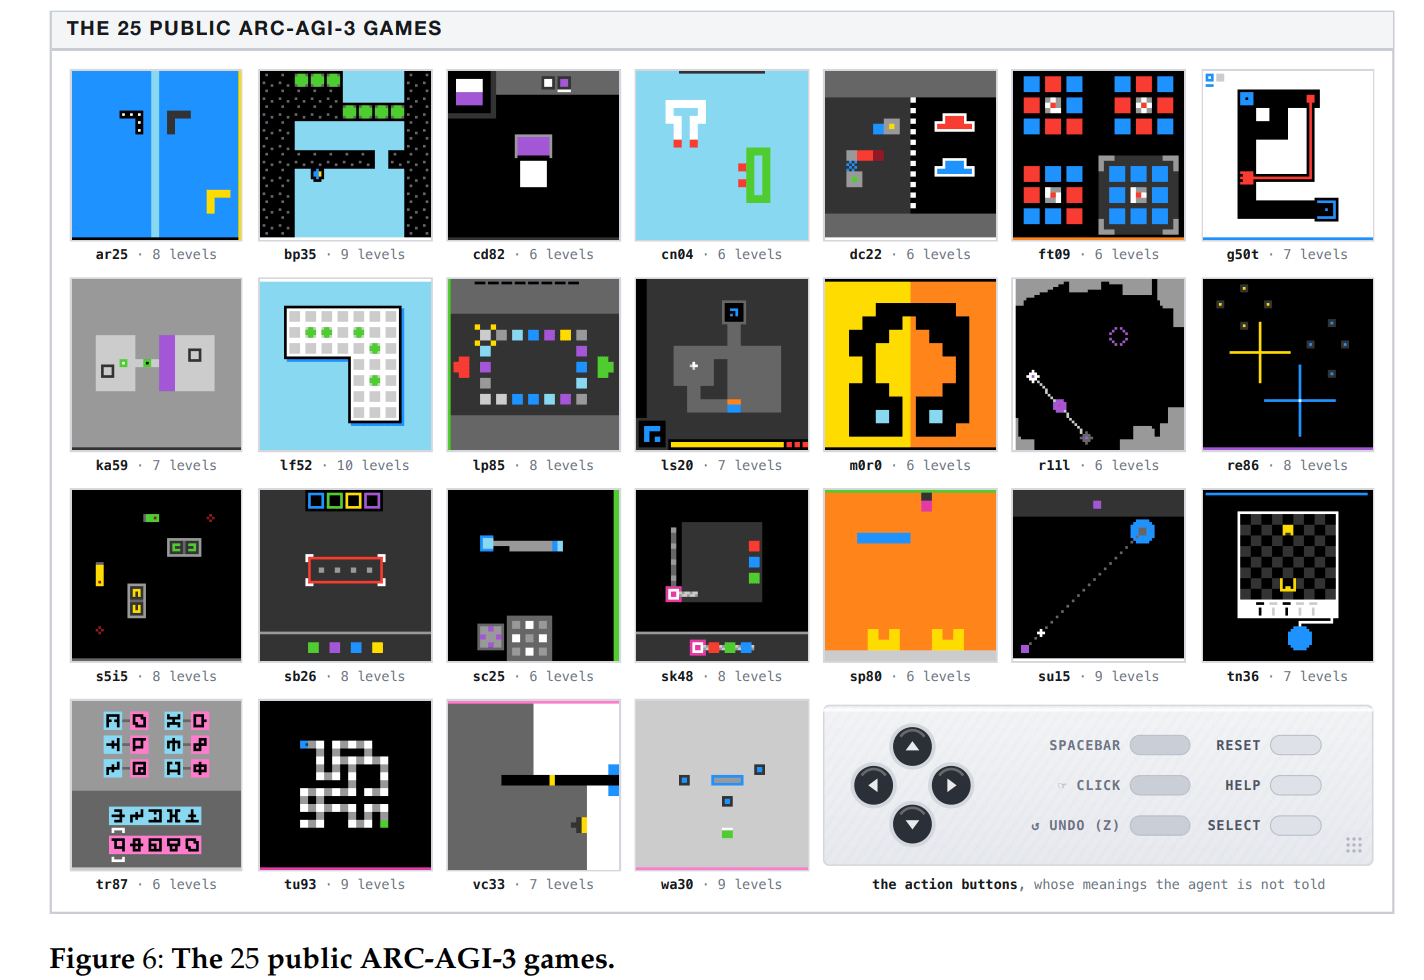
que ha completado los 25 juegos y 183 niveles del conjunto público ARC-AGI-3.
Y no lo logró a base de prueba y error sin criterio.
Un humano necesita 17.135 acciones para completar el mismo conjunto de niveles.
Memento 3 solo usó 7.518,unas 56% menos de acciones que un humano, y logró la puntuación RHAE perfecta de 100(Relative Human Action Efficiency, eficiencia de acción relativa al humano).
Aún más increíble:este sistema usa Claude Opus 5 como modelo base, sin actualizar los pesos del modelo en ningún momento ni hacer ajustes finos para los juegos。
Simplemente empezó a jugar por sí solo, dedujo las reglas, escribió su propio código, y cuando se equivocaba, reflexionaba y corregía.
Y entonces... superó todo con puntuación perfecta.
Como comparación, Claude Opus 5 obtiene en promedio solo unos 40,7 puntos de RHAE bajo el marco de pruebas oficial de ARC Prize.
Con el mismo modelo base, al cambiar de sistema de agente, la puntuación se disparó 59,3 puntos.
Y aún hay más.
Este método no solo sirve para juegos de puzles: el equipo de investigación también lo puso a jugar al clásico de Atari Pong (ping pong).
Como resultado, la IA dedujo por sí misma la estrategia de control y, después, sin volver a pedir razonamiento al modelo grande, ganó tres partidas seguidas por 21:0.
¿Cómo es posible que, sin que el modelo grande participe en las operaciones posteriores, la IA siga jugando tan bien?!
La clave está escondida en el título de esta investigación:
Model-Based Recursive Self-Improvement, mejora recursiva propia basada en modelos del mundo。
La IA de Huawei supera 25 juegos, con un 56% menos de acciones que los humanos
Primero, hablemos de qué son exactamente estos 25 juegos.
Provienen de ARC-AGI-3, lanzado por ARC Prize; quienes siguen las evaluaciones de IA seguramente ya conocen la serie ARC.
Pero esta generación tiene un cambio muy notable:
Ya no se trata solo del típico planteamiento y resolución de problemas: esta vez directamente arrojaron a la IA a un mundo de juegos desconocido.。
Las reglas, la IA tiene que adivinarlas por sí misma; los objetivos, tiene que encontrarlos por sí misma; y qué efecto produce cada acción, tiene que probarlo por sí misma.
IA: O sea, todo depende de mí, ¿eh?~
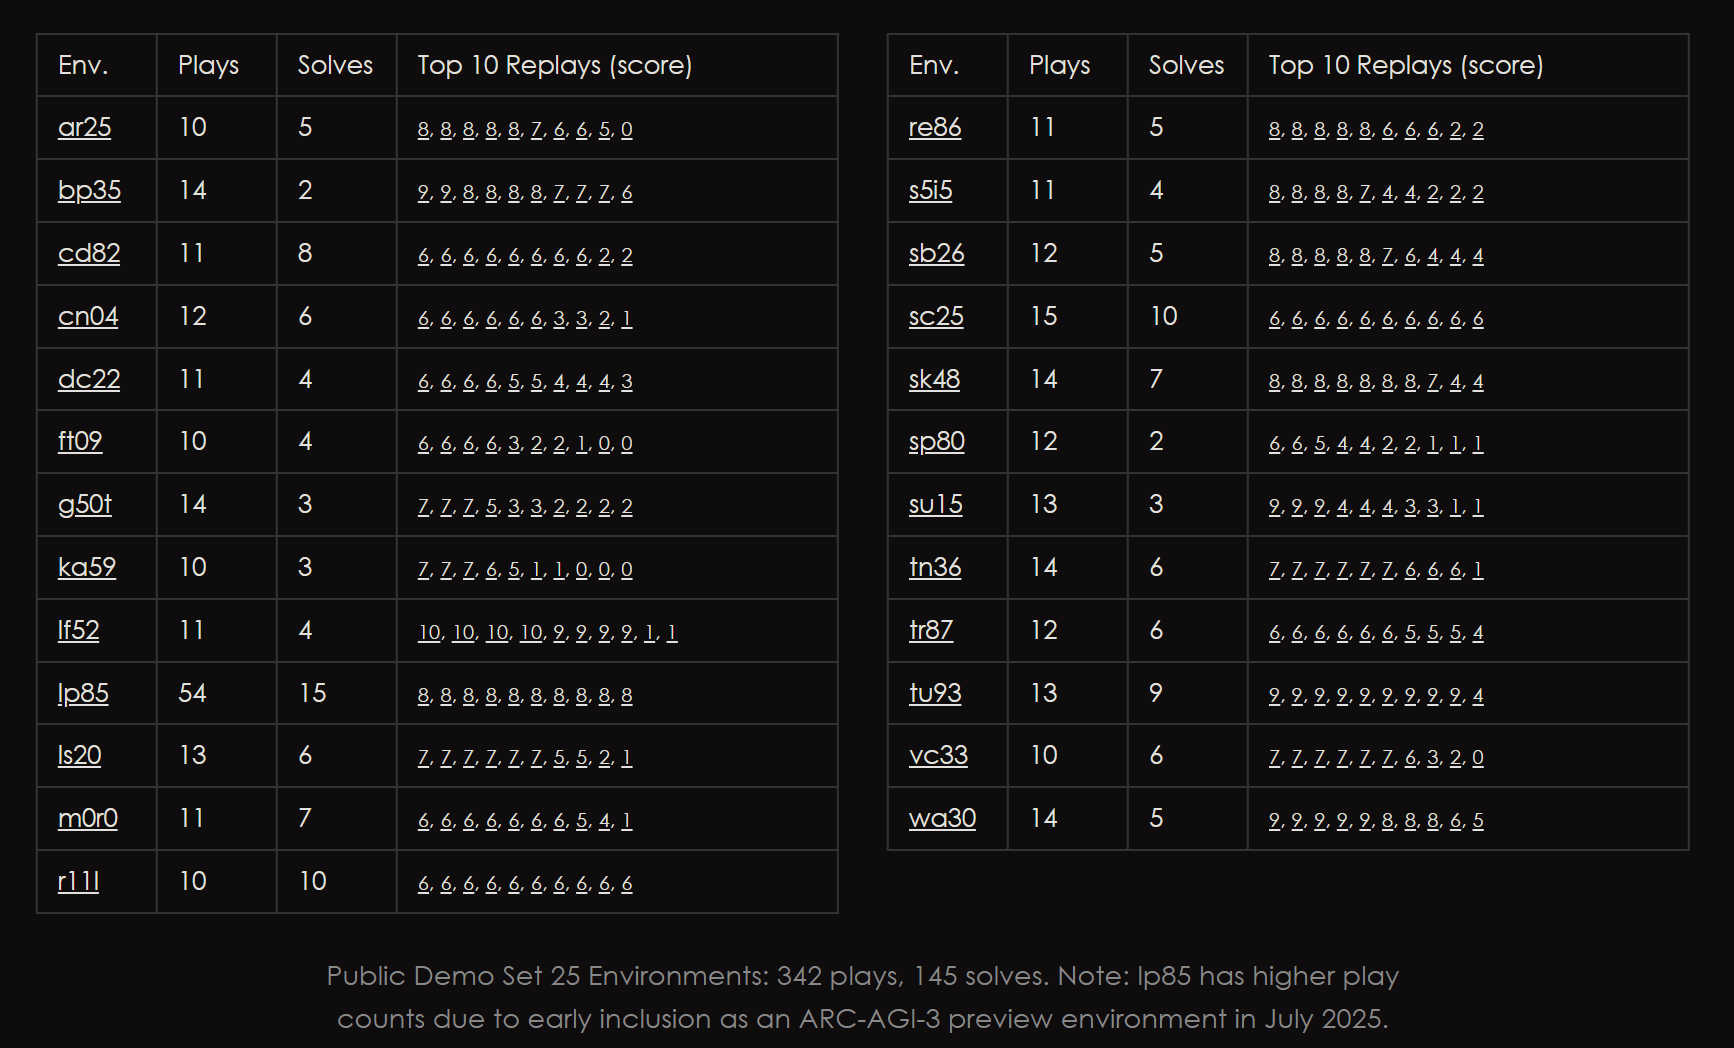
Estos 25 juegos públicos incluyen en total 183 niveles, con gráficos compuestos en su mayoría por simples píxeles, bloques, colores y figuras.
A primera vista, incluso parece una colección de minijuegos de hace varias décadas.
Pero no dejes que este estilo tan simple te engañe.
Para la IA, saber cómo operar no es lo más difícil; lo más problemático es que no tiene ni idea de cómo funciona este mundo.
¿Qué ocurre al pisar un suelo especial? ¿Que una puerta no se abre porque el color no coincide, o porque la forma no es la correcta?
Y lo que es más problemático: en los niveles posteriores pueden aparecer reglas nuevas que echen por tierra toda la experiencia acumulada hasta entonces.
Ni que decir tiene que no solo la IA: también los jugadores humanos se quedan atascados。
Los datos de prueba de ARC Prize muestran que, en un juego de puzles llamado r11l en el que hay que controlar una ameba para moverla y cambiarle el color, los 10 participantes completaron el juego; mientras que en otro juego de puzles, tr87, que pone a prueba la capacidad de descifrar símbolos, de 12 participantes solo 6 lograron superarlo.
Antes de la IA de Huawei, los distintos equipos de investigación ya competían con gran intensidad:
Continual Harness, presentado por la Universidad de Princeton, solo completó 3 juegos y obtuvo 20.5 puntos.
DreamTeam, desarrollado con la participación de investigadores de Nvidia, fue un poco mejor: completó 6 juegos y obtuvo 38.1 puntos.
Más arriba aún, OPINE-World, desarrollado por el investigador independiente David Courtis, y NOOA, del equipo de Nvidia, obtuvieron 78.4 y 85.1 puntos respectivamente.
El más impresionante fue baseline1, del desarrollador independiente Sergey Rodionov: no solo completó los 25 juegos, sino que obtuvo 99 puntos, a solo 1 punto de la puntuación máxima.
Pero el equipo de Huawei, en esta ocasión, completó directamente ese último 1 punto que faltaba。
Memento 3 no solo completó los 25 juegos y los 183 niveles con una puntuación de 100, sino que además redujo el número total de operaciones a 7518, es decir, 829 menos que las 8347 de baseline1.
No solo lo completó, sino que lo hizo con menos pasos.
¿Cómo lo consiguió??
Sin entrenar grandes modelos: la IA consigue "subir de nivel venciendo enemigos" escribiéndose su propia guía
Al revisar el artículo, el método central de Memento 3 se llamaCode as Model (el código como modelo)。
Suena un tanto abstracto, pero en realidad consiste en que la IA, mientras juega, se prepara dos cosas:
una guía del juego que se actualiza constantemente, y un conjunto de código capaz de simular el funcionamiento del juego.
- Rulebook (manual de reglas): un documento en Markdown donde la IA registra las regularidades que ha descubierto en el juego, por ejemplo qué efecto desencadena cada operación, cómo completar el nivel y qué reglas aún no ha logrado comprender.
- Executable World Model (modelo del mundo ejecutable): la IA convierte las reglas que ha resumido directamente en código Python ejecutable, lo que equivale a construir por sí misma un simulador del juego en versión simplificada.
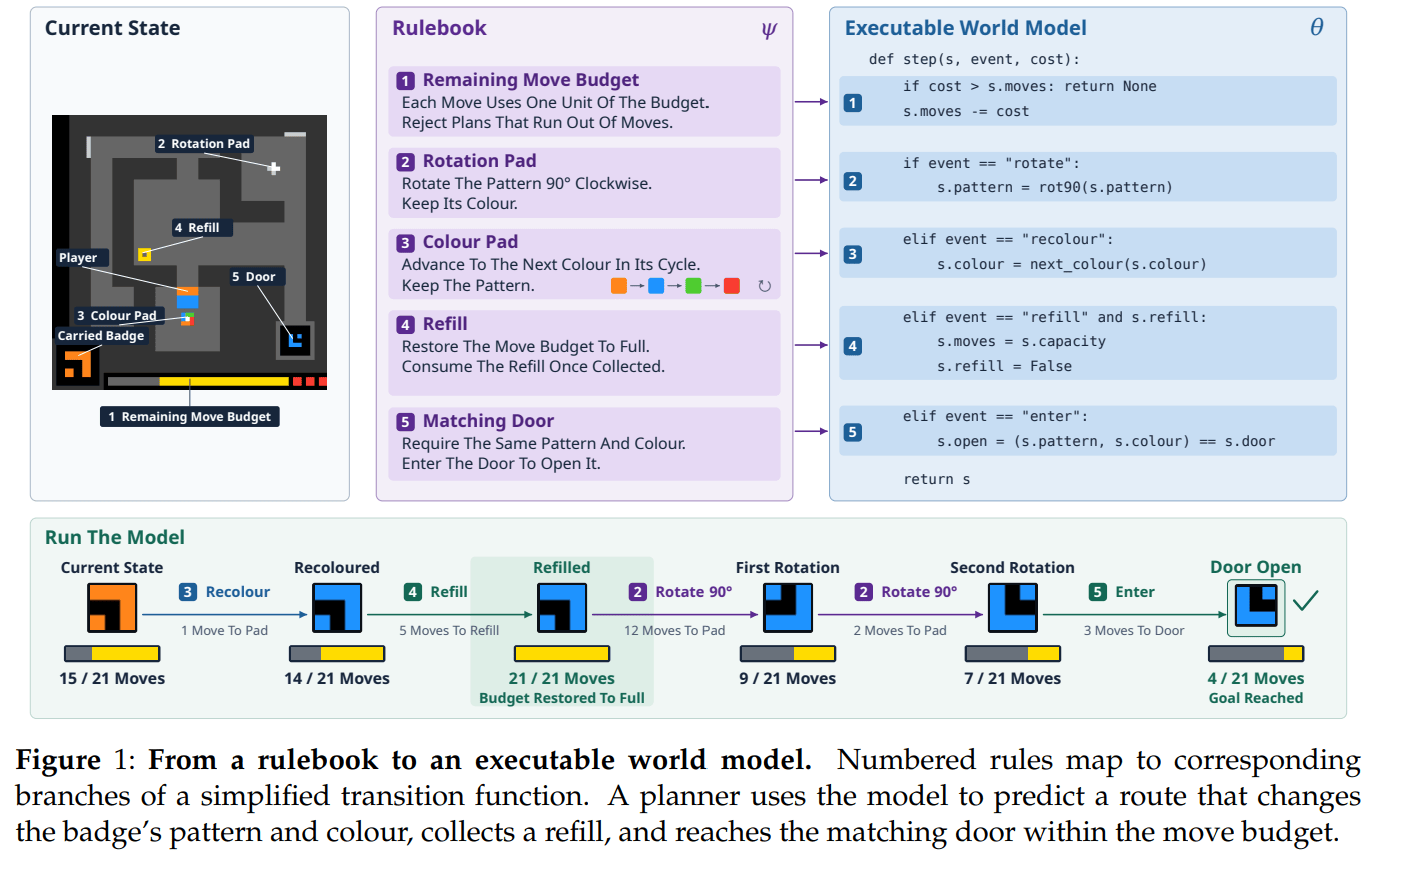
Con estas dos cosas, la IA puede primero simular diferentes rutas en el simulador que ella misma ha construido, y luego decidir cuál es el siguiente paso.
Pero surge un problema: ¿y si las reglas del juego comprendidas desde el principio eran erróneas?
No hay de qué preocuparse:Memento 3 no solo escribe su propia guía, sino que, si descubre que se ha equivocado, puede también refutarla y empezar de nuevo por sí mismo。
El artículo presenta un ejemplo.
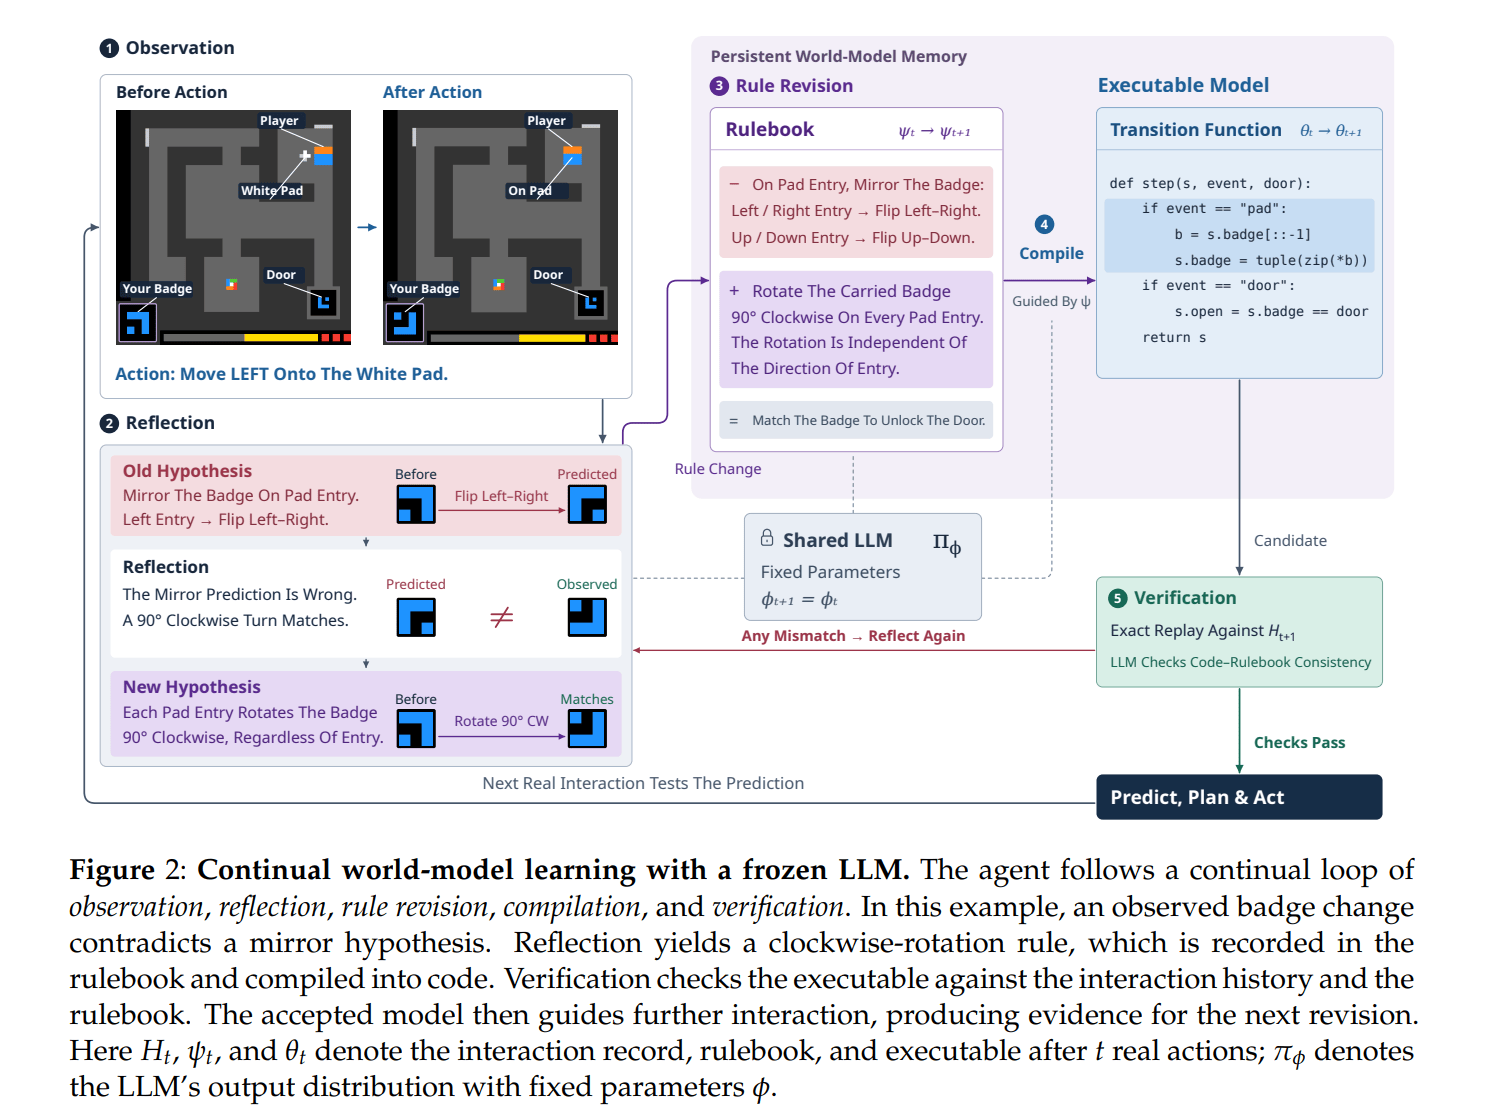
En un juego de puzles, la IA se topó con un suelo especial y al principio pensó que, al pisarlo, el patrón que portaba el personaje se invertiría en espejo según la dirección de entrada.
Tras probarlo de verdad, descubrió que el patrón no se invertía, sino que giraba 90 grados en sentido horario, independientemente de la dirección de entrada.
Así que la IA modificó el manual de reglas y el código Python correspondiente se actualizó a la vez.
Sin embargo, después de corregir hay que verificar.
El sistema vuelve a simular las operaciones anteriores y compara cuadrícula por cuadrícula las imágenes del juego de 64×64, para confirmar que el código reproduce con precisión el resultado real.
Si no coinciden, sigue corrigiendo.
De este modo, la IA explora mientras corrige errores, y las reglas se vuelven cada vez más precisas con cada modificación.
Además, la experiencia adquirida en las fases anteriores puede aplicarse en los niveles posteriores。
Por ejemplo, en el juego de descifrado de símbolos tr87, la IA al principio no distinguía si la orientación de los símbolos afectaba al significado, y luego descubrió que símbolos con diferentes orientaciones podían representar la misma letra.
Con la aparición de nuevos niveles, volvió a refutar su comprensión anterior sobre la posición del cursor.
A lo largo de toda la partida, el mismo manual de reglas se iteró en 11 versiones.
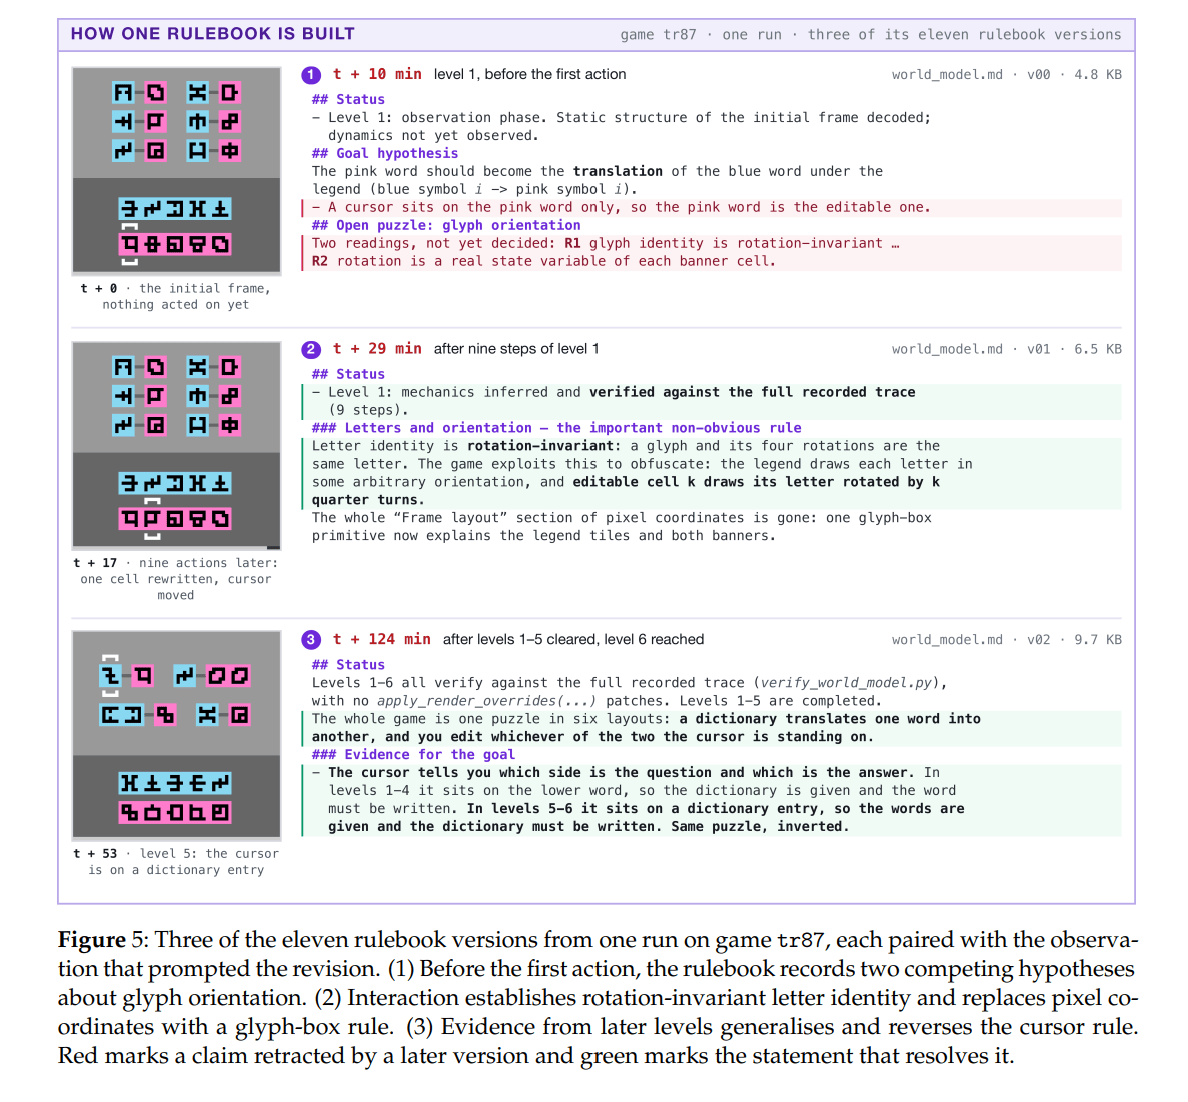
Para facilitar la trazabilidad, el equipo de investigación incluso introdujo la gestión de versiones con Git.
Cada modificación de las reglas y del código dejaba un registro; al descubrir dónde se había cometido un error, se podían consultar las versiones históricas y, si era necesario, restaurarlas directamente.
Vaya resulta: mientras jugaba, también terminó manteniendo un repositorio de código.
Esto es precisamente lo que el equipo de investigación llama mejora recursiva de sí mismo (RSI).
Sin tocar los parámetros del gran modelo, la IA puede volverse cada vez más hábil en el juego acumulando experiencia y modificando las reglas y el código.
Además, este método cuenta realmente con respaldo de datos.
El equipo de investigación realizó experimentos de control en tres juegos:
Conservando el manual de reglas, la IA utilizó en total 617 operaciones; sin el manual de reglas, conservando solo el modelo de mundo basado en código, necesitó 677.
Es decir, con esta guía, las operaciones se redujeron aproximadamente un 9%, y las rondas de ejecución del agente también disminuyeron alrededor de un 18%。
Pero al equipo de investigación eso no le bastó.
Si un modelo de mundo ayuda a la IA a evitar desvíos, ¿qué pasará si se usan dos a la vez?
Así que hicieron que la IA mantuviera simultáneamente dos modelos de mundo, compartiendo el registro de operaciones del juego, pero realizando cada uno inferencias sobre hipótesis de reglas diferentes.
Como resultado, en el juego wa30, con un solo modelo de mundo se necesitaban 899 operaciones para completar el nivel, mientras que con el doble modelo de mundo se redujo directamente a 597.
Las operaciones se redujeron nuevamente en aproximadamente un 34%。
Por supuesto, esta mejora solo se ha verificado hasta ahora en wa30, por lo que no se puede generalizar directamente a otros juegos.
Pero al menos en estos experimentos, Memento 3 demostró una cosa:
Sin necesidad de reentrenar el gran modelo, la IA también puede volverse cada vez más fuerte corrigiendo constantemente su comprensión del mundo.
Con la partida en 21:0, la IA incluso dejó de necesitar llamar al gran modelo
¿Significa esto que este método solo sirve para jugar juegos de rompecabezas?
El equipo de investigación decidió subir la dificultad y llevar directamente a Memento 3 a desafiar el clásico juego de arcade Atari Pong (ping pong).
A diferencia de los juegos de rompecabezas anteriores, esta vez la pelota se mueve y rebota constantemente, por lo que la IA no solo tenía que descifrar las reglas del juego, sino también juzgar en tiempo real la trayectoria de la pelota y controlar la paleta para recibirla.
Y este experimento realmente arrojó algo nuevo.。
Al principio, la IA tampoco conocía las leyes del rebote de la pelota y solo podía ir aprendiendo mientras jugaba.
Inicialmente pensaba que la paleta podía dividirse en cuatro zonas, y que la pelota rebotaría en la dirección correspondiente según el punto donde golpeara.
Pero mientras jugaba, apareció de repente un rebote horizontal.
¿Eh? Esto no coincidía con las reglas que había concluido antes.
Entonces la IA volvió a analizar el punto de colisión y modificó la fórmula de rebote; más tarde, al encontrar nuevas desviaciones de trayectoria, siguió ajustando hasta llegar gradualmente a leyes de movimiento más acordes con la realidad.
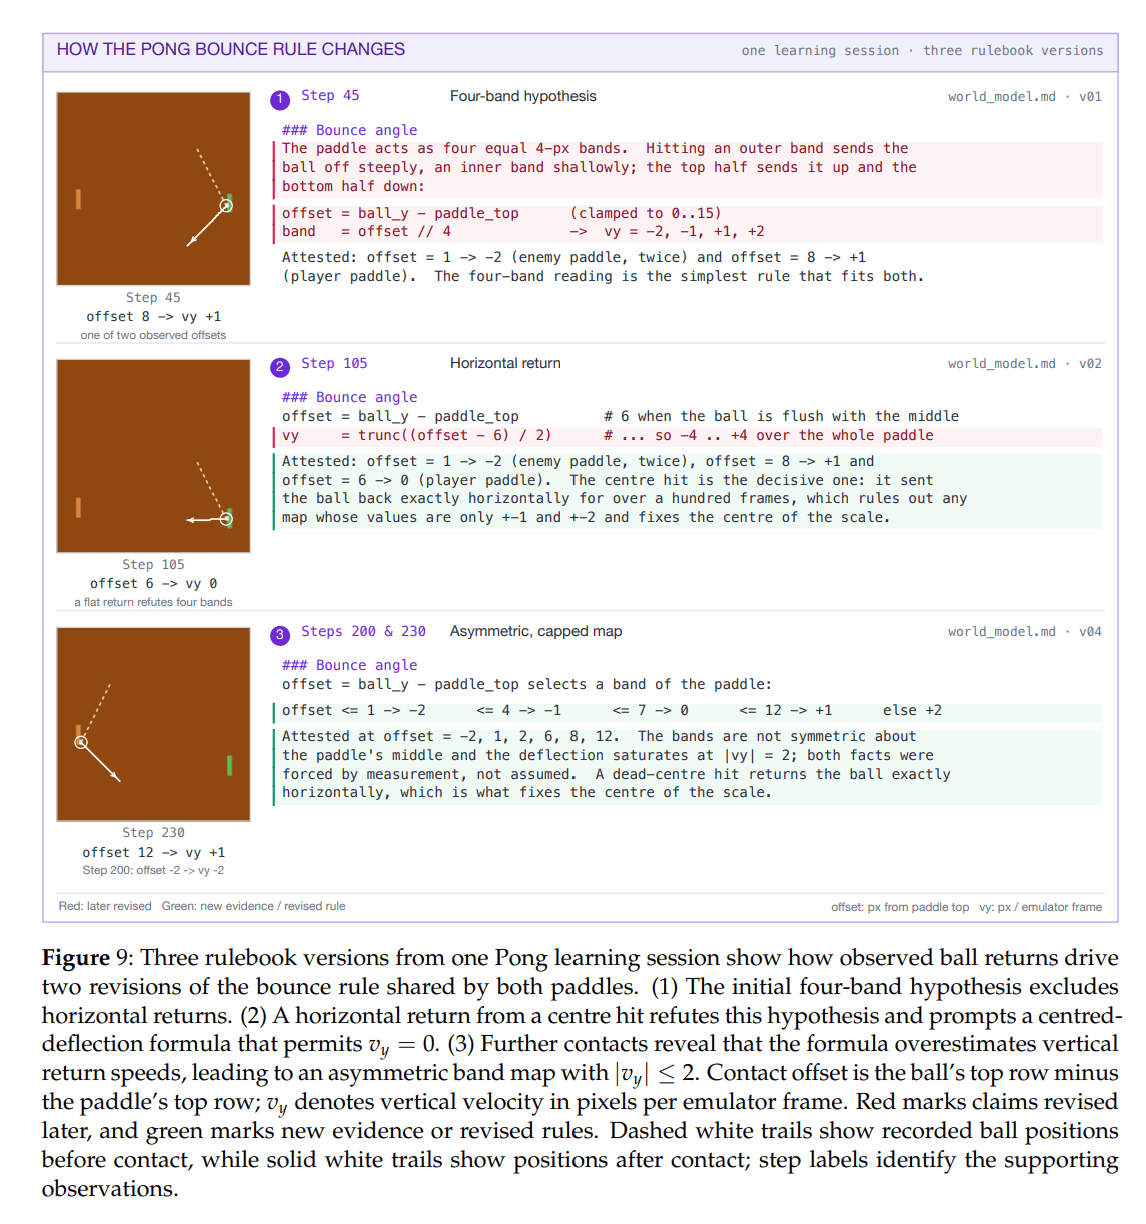
Cuando la estrategia de control maduró, el equipo de investigación simplemente puso el programa a jugar de forma autónoma.
Dejó de llamar a Claude Opus 5 y también dejó de actualizar las reglas.
Como resultado,tres partidas con aperturas distintas, todas terminaron en 21:0。
Vaya, al principio aún estaba tanteando cómo recibir la pelota, y después aplastó al rival con un zero cerrado???
Y atención: para entonces, el gran modelo de lenguaje ya no necesitaba jugar en persona.
Solo se encargaba de explorar las reglas al principio y resumir la estrategia; una vez aprendida, la entregaba directamente al código para ejecutarla.
Como comparación, sin usar un modelo del mundo, si solo se deja que el gran modelo decida la siguiente jugada a partir de la imagen frente a él, la puntuación final es de solo -19, apenas mejor que el -20.7 de pulsar botones al azar.
Con esta comparación, la diferencia queda clara.
En lugar de hacer que el gran modelo reflexione de nuevo en cada paso, es mejor que primero aprenda a jugar y luego entregue la estrategia a un programa.。
Además, la eficiencia es bastante asombrosa.
Los datos del artículo indican que Memento 3 utilizó aproximadamente solo9500 fotogramas de imágenes del juegopara aprender esta estrategia de control.
En comparación, algunos métodos tradicionales de aprendizaje por refuerzo suelen necesitar cientos de miles o incluso cientos de millones de fotogramas de datos de entrenamiento.
Eso sí, esto no significa que Memento 3 no tenga costes.
Después de todo, detrás utiliza el Claude Opus 5 con intensidad de razonamiento Extra-High activada, y el proceso de explorar, generar código y verificar consume bastantes Token y capacidad de cómputo.
Además, los experimentos actuales se centran principalmente en entornos de juego con reglas relativamente claras; si se pasa a un mundo real más complejo y cambiante, queda por verificar si este método sigue funcionando.
Sin embargo, esta investigación sí señala una dirección que merece atención:
la auto-mejora recursiva (RSI) no tiene por qué implicar modificar los pesos subyacentes del modelo. Mediante la construcción de un modelo del mundo externo, verificable, ejecutable y reversible, un gran modelo general con los parámetros congelados también puede auto-iterarse y evolucionar rápidamente en dominios desconocidos.
Dirección del artículo:
https://arxiv.org/abs/2610.11794
Enlaces de referencia:
https://x.com/ScarletKc/status/2109169173540884935