IT之家 Mensaje del 12 de octubre: Alibaba Qwen lanzó hoy oficialmente QwenGyre, un marco de aprendizaje por refuerzo en línea orientado a tareas de agentes de largo alcance.
Según la presentación oficial, cuando un agente asume trabajos complejos, una sola ejecución suele durar horas, con cientos de rondas de interacciones interdependientes entre el modelo y el entorno, procesando acumulativamente tokens a escala de millones. QwenGyre, mediante la programación elástica y el procesamiento de trayectorias,convierte este tipo de tareas de muy largo alcance en una fuente efectiva de entrenamiento,al tiempo que aporta mejoras en capacidad y eficiencia。
QwenGyre puede dividir la GPU en varias unidades de cómputo; cada vez que termina un lote de tareas, las unidades liberadas pasan al entrenamiento, como en un equipo de proyecto donde quien termina antes se une antes a la retrospectiva. Las tareas aún en curso no se ven perturbadas en absoluto: su progreso y estado se conservan en el lugar, e incluso la caché ya calculada se traslada en bloque, sin tener que empezar de cero. Las unidades recién liberadas se incorporan directamente al entrenamiento de la ronda actual; quien computa más rápido trabaja más, y al final las unidades centrales agregan los resultados para completar una actualización de parámetros.
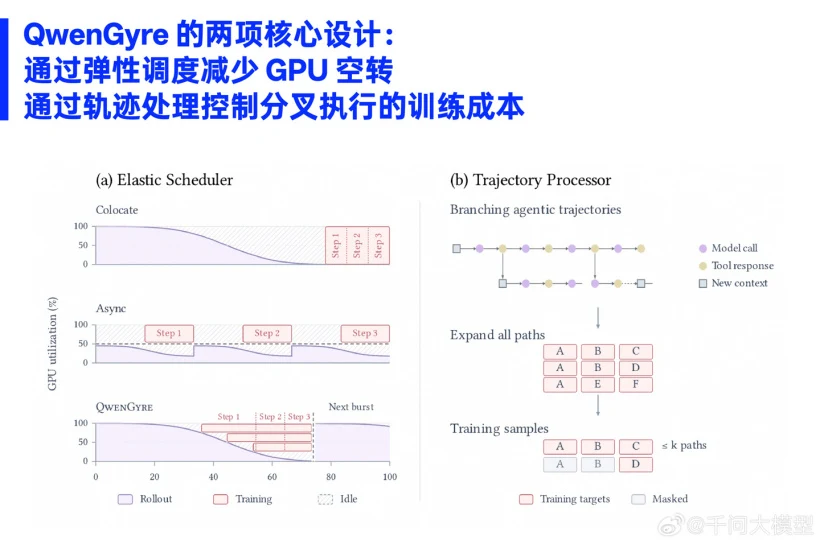
IT之家 señaló que QwenGyre puede registrar, mediante Token-in Token-out, el contexto real en el que se generó cada segmento de salida, organizándolo en un árbol de trayectorias según prefijos compartidos, y expandiendo como muestras de entrenamiento solo las rutas seleccionadas. Además, las tareas que exceden el tiempo de espera pero están parcialmente completadas también pueden ofrecer retroalimentación útil mediante Partial Scoring, sin desperdiciar ningún esfuerzo realizado.
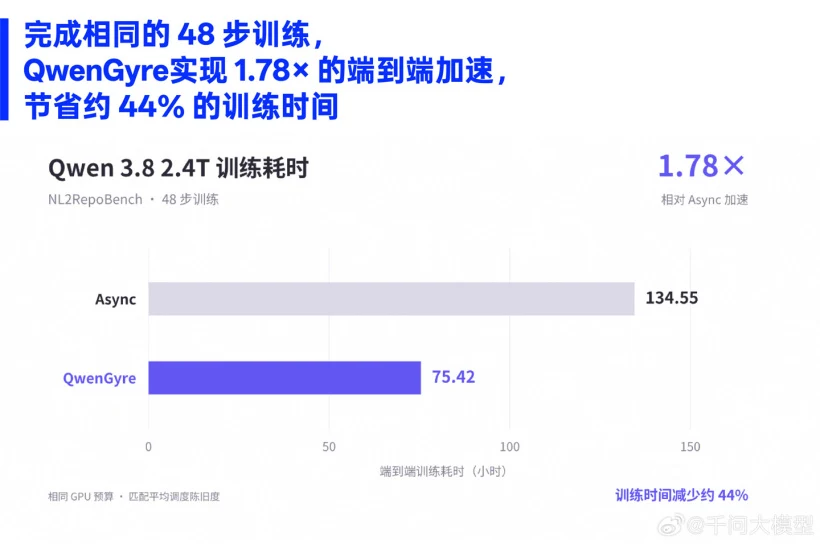
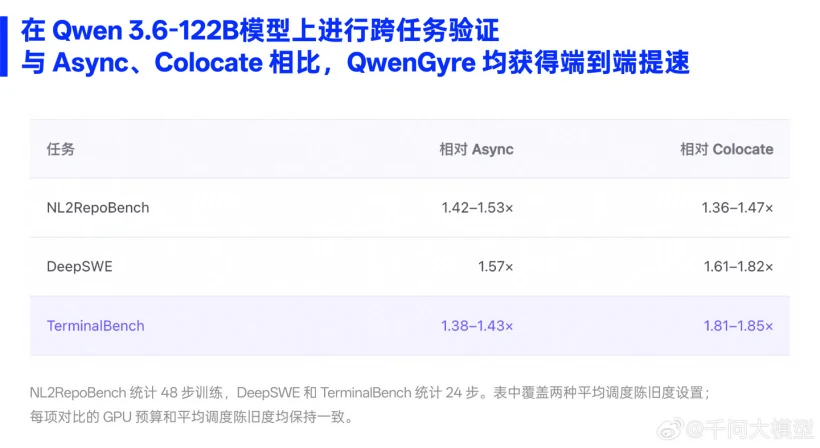
En cuanto a los resultados de pruebas, en el experimento de aprendizaje por refuerzo en línea NL2RepoBench, el equipo oficial entrenó con tareas de aproximadamente 700.000 tokens por rollout; tras 48 pasos de entrenamiento, la tasa de aprobación del modelo pasó del 52,5% al 58,5%. Con el mismo presupuesto de GPU, QwenGyre logra una aceleración de extremo a extremo de 1,78× respecto a Async, con puntuaciones de entrenamiento cercanas a las de Async y Colocate. En la validación entre tareas en Qwen3.6-122B, las tres clases de tareas —NL2RepoBench, DeepSWE y TerminalBench— obtuvieron aceleraciones de extremo a extremo.