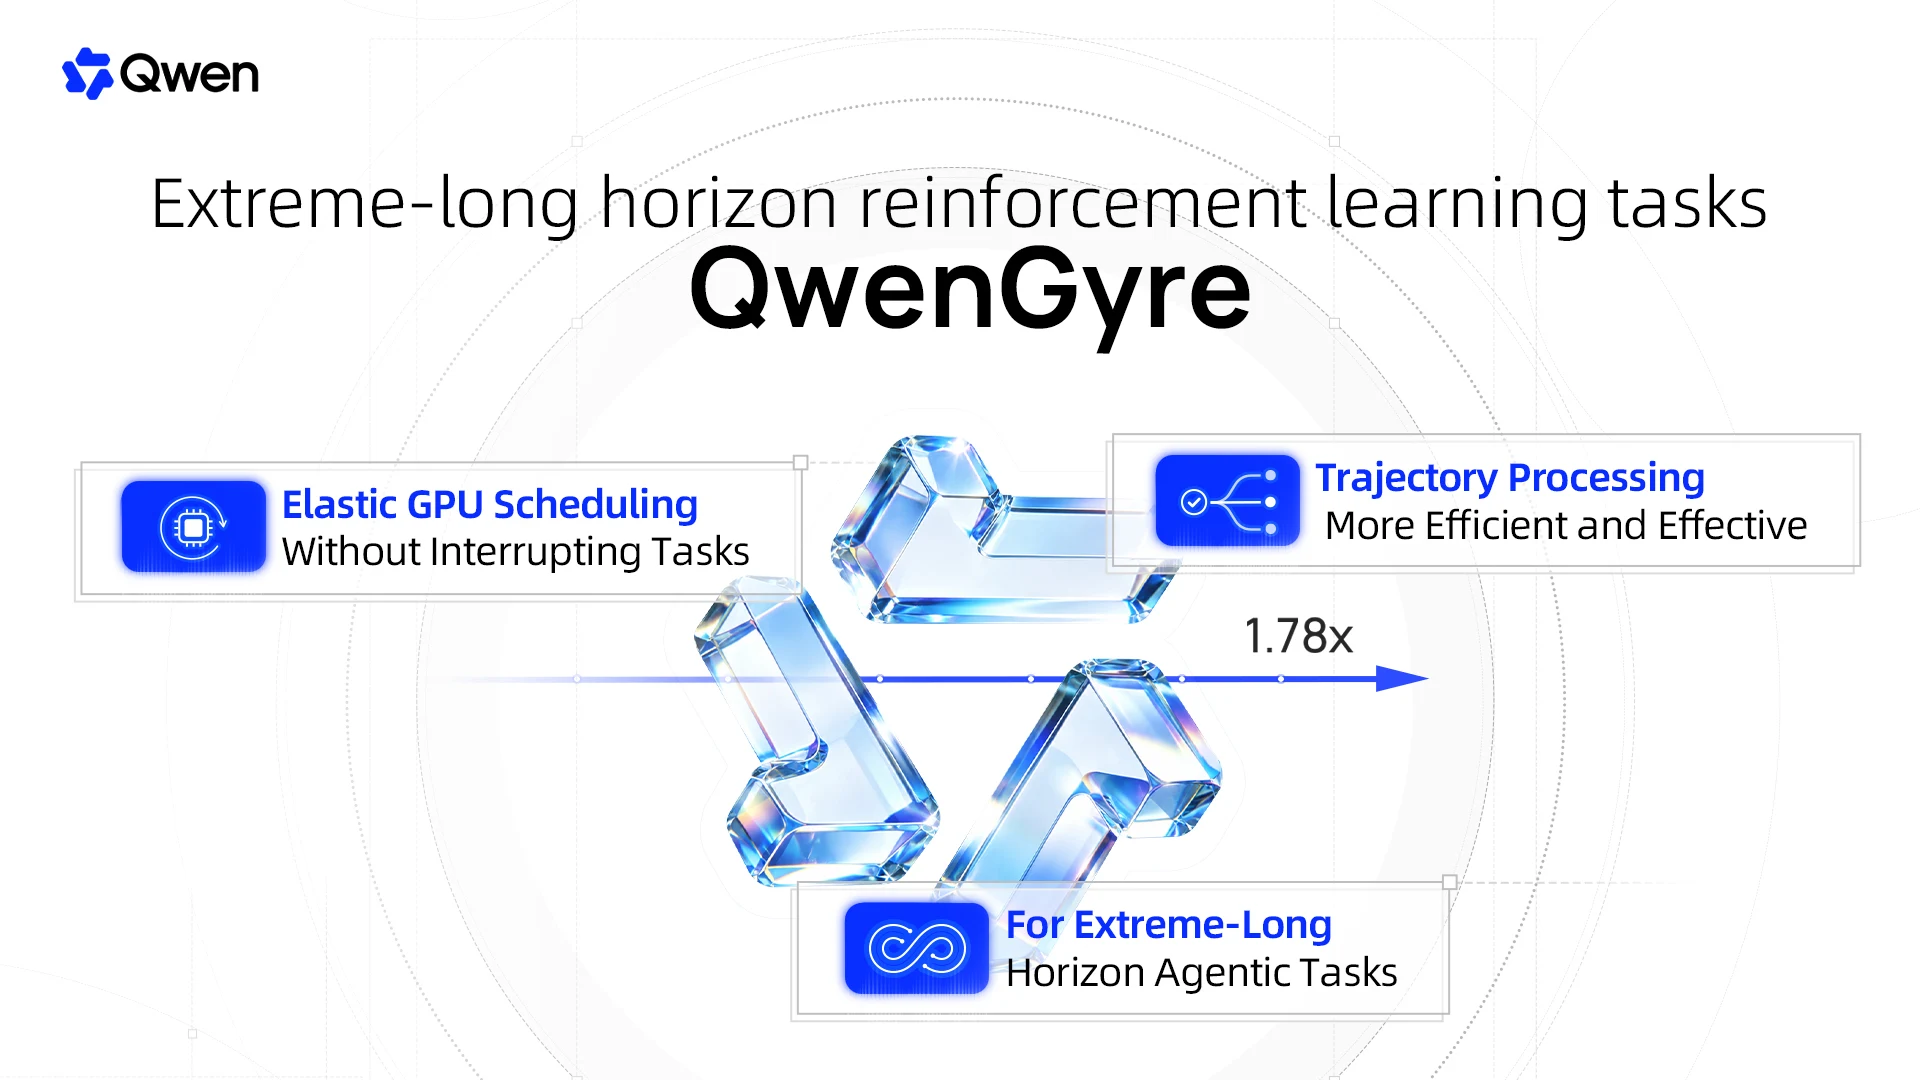
Presentamos QwenGyre, que lleva el RL elástico al entrenamiento de agentes de horizonte extremadamente largo (XLong). ✨
Se lanza con dos diseños principales: 🥳
- Agendador Elástico: reasigna GPUs entre el despliegue y el entrenamiento a medida que cambia la demanda; las ejecuciones en vivo no se interrumpen. Hasta un 1,85× de aceleración en comparación con Colocate, y un 1,78× en comparación con Async.
- Procesador de Trajectoires: convierte las ejecuciones ramificadas (compaction, sub-agentes, intentos de nuevo) en árboles de trajeto compartidos por prefijo, con muestras de entrenamiento limitadas y sin duplicaciones. El progreso parcial después del tiempo limite sigue siendo valorado.
Escalado a Qwen3.8-2.4T-A95B con ~700K tokens por lanzamiento, QwenGyre eleva NL2RepoBench de 52.5% a 58.5% en 48 pasos, reduciendo el tiempo de entrenamiento desde principio a fin en ~44% en comparación con Async.
🔗 Lea el artículo:
https://arxiv.org/abs/2609.33848