
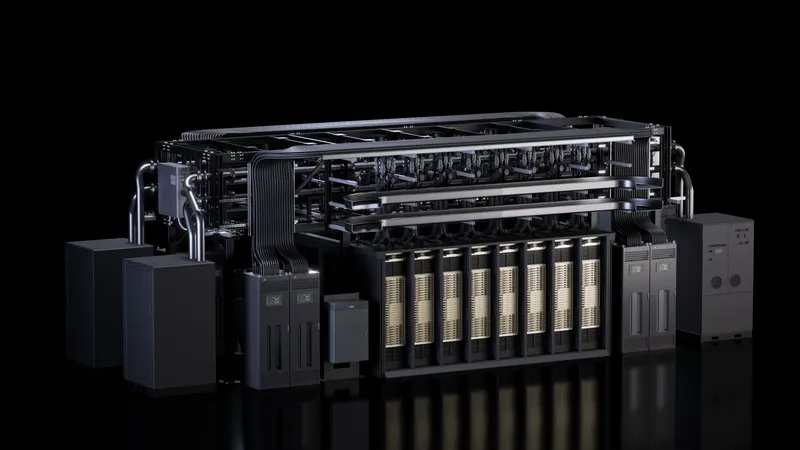
A medida que las fábricas de IA crecen desde megavatios hasta gigavatios, su construcción requiere más que solo computación avanzada. Los estándares abiertos están ayudando a la industria a escalar la infraestructura de IA de manera más rápida, eficiente y confiable.
En la Cumbre Global del Proyecto Open Compute (OCP), que se lleva a cabo en el Centro de Convenciones San Jose McEnery, NVIDIA anunció nuevas alianzas y contribuciones destinadas a establecer una base común para la infraestructura de IA de próxima generación.
NVIDIA contribuyó con diseños clave de NVIDIA Vera Rubin para rack y bandeja de procesamiento a OCP a través de la arquitectura abierta NVIDIA MGX, proporcionando a los constructores de sistemas una base común para desarrollar la infraestructura de fábrica de IA de próxima generación.
Juntos, estos esfuerzos abarcan la propia fábrica de IA, la red eléctrica que la alimenta y la arquitectura a escala de rack en el corazón del computing acelerado moderno.
NVIDIA y sus socios anuncian avances en la arquitectura abierta
En el evento de OCP, NVIDIA y sus socios hicieron unas pocas anunciaciones:
- NVIDIA y los hipercables publicaron estándares abiertos para fábricas de IA de próxima generación, incluyendo estándares de diseño de fábrica de IA y resiliencia de la red.
- NVIDIA lanzó nuevos componentes de software de código abierto para NVIDIA DSX AI Factory.
- Meta y NVIDIA avanzan en redes de IA abiertas con los SuperNIC de Ethernet NVIDIA Spectrum-X y las innovaciones Spectrum-6.
- Visionbay introdujo un diseño de fábrica para una planta de 800V DC con IA para la era de Vera Rubin.
- NVIDIA y Cisco anunciaron el estándar Ultra-Dense Small Form Factor Pluggable (USFP), el primer módulo de la industria para estructuras de red basadas en 400 Gb/s.
- NVIDIA y Google anunciaron el soporte para Falcon Transport en futuros NVIDIA ConnectX-10 SuperNICs y BlueField DPUs.
Ante una audiencia llena, Ian Buck, vicepresidente de computación de hiperescala y alto rendimiento en NVIDIA, explicó cómo la infraestructura abierta se está convirtiendo en un componente clave para escalar las fábricas de inteligencia artificial en todo el mundo.
La noticia en OCP destaca cómo el extremo diseño conjunto de NVIDIA con estándares abiertos está acelerando la implementación, mejorando la eficiencia energética y promoviendo un rendimiento por watt.
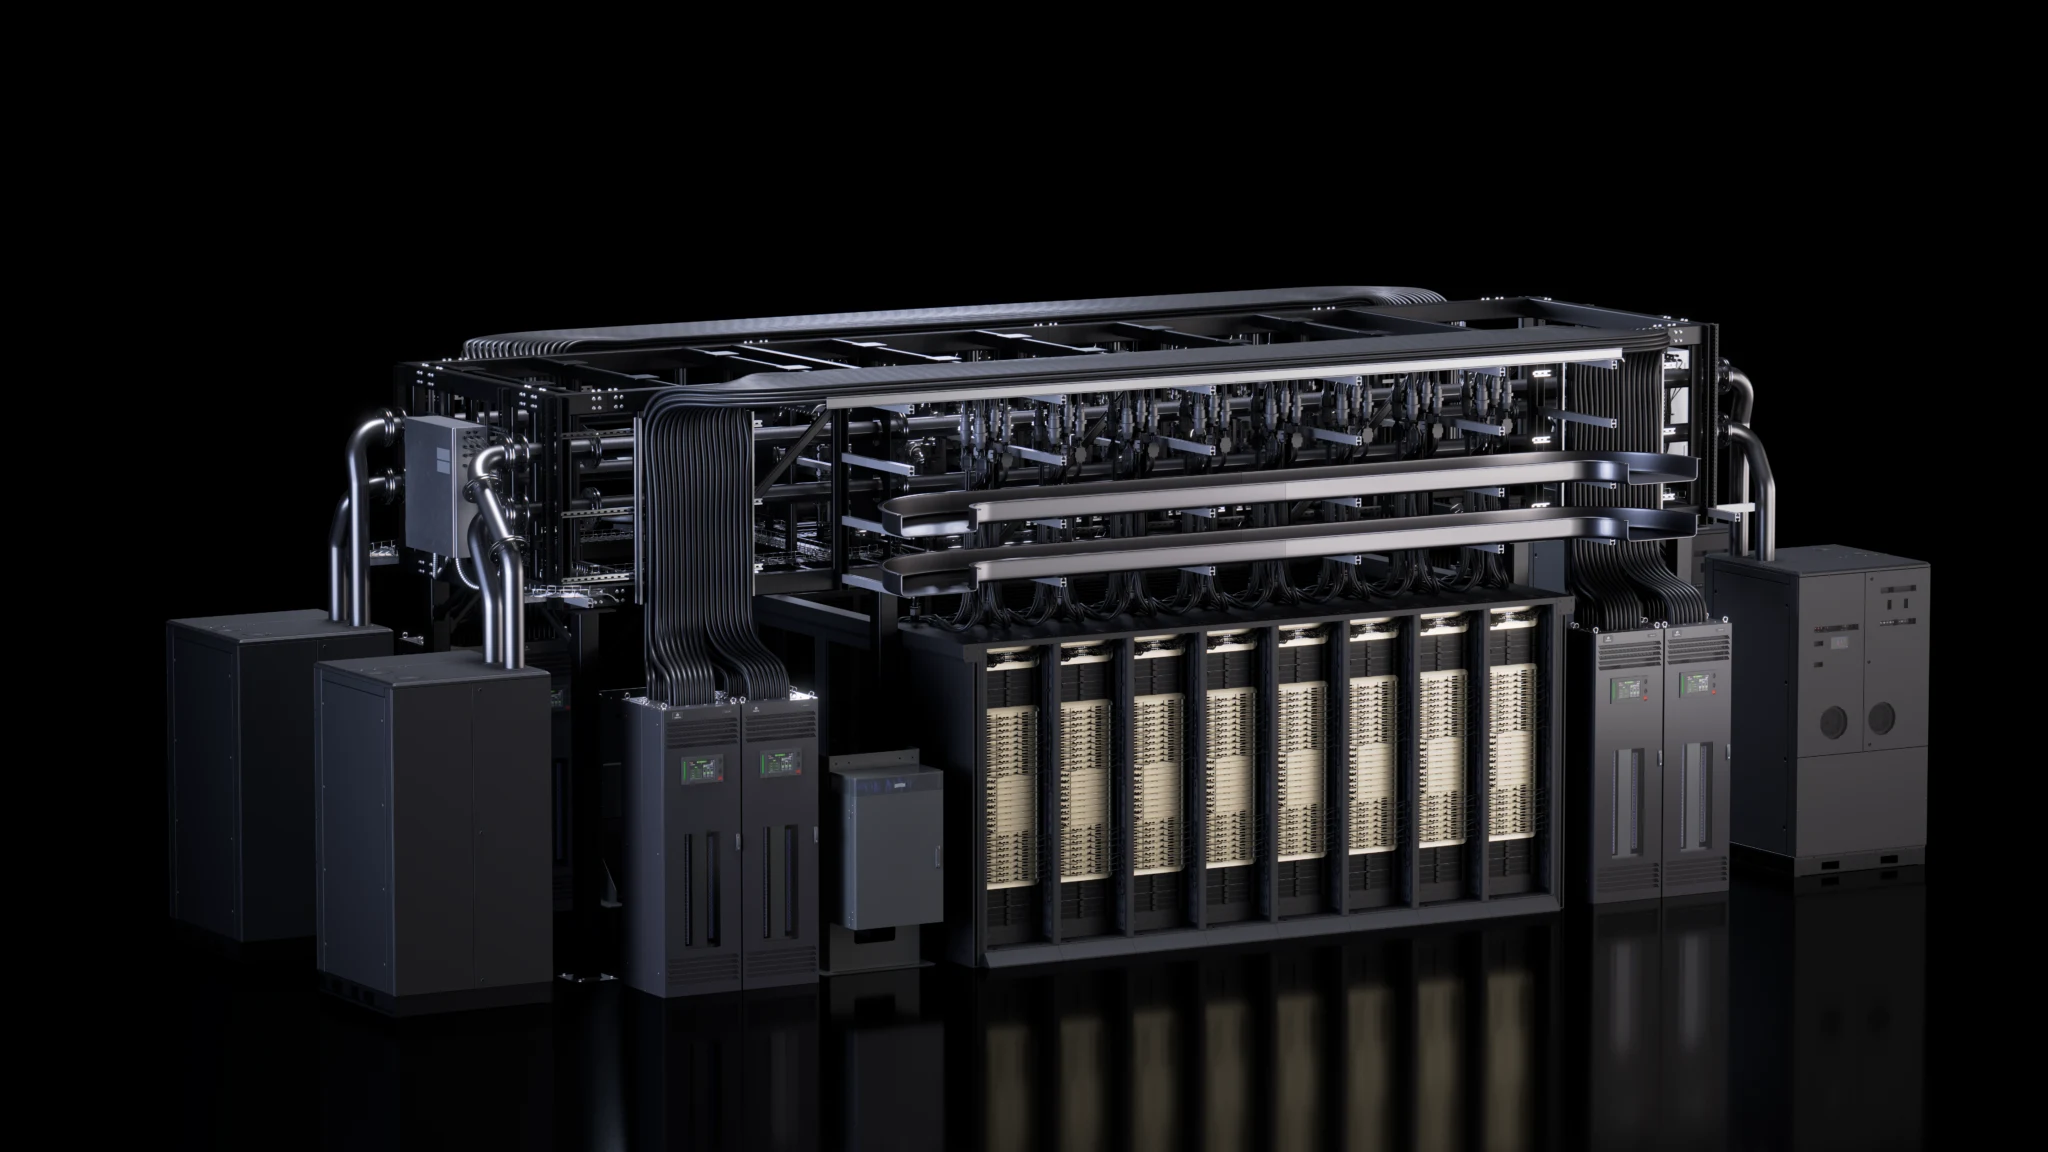
Las fábricas de IA de Vera Rubin avanzan con las contribuciones del MGX Rack en el OCP
NVIDIA se unió a los líderes de la industria para contribuir al diseño de referencia del centro de datos MGX AI de tercera generación a través de la Iniciativa Open DC de OCP.
En combinación con tecnologías de enfriamiento líquido abiertas como MQD y MQDB, este esfuerzo ayuda a convertir los diseños probados de fábricas de IA en estándares industriales que otros puedan adoptar, fabricar y escalar.
Para las fábricas de IA Vera Rubin de NVIDIA, la especificación actualizada MGX 1.2 extiende la arquitectura abierta para las fábricas de IA con refrigeración líquida a escala de rack, infraestructura de interconexión interoperable a escala de rack y un barra de bus de 5,000A refrigerada con líquido diseñada para sistemas de IA de mayor potencia. También incluye soporte para equipos de 19 pulgadas nativos y diseños de rack de mayor densidad.
MGX 1.2 amplía aún más la modularidad con bahías de I/O configurables, bandejas de computación en líquido sin ventilador, interfaces estandarizadas de alimentación y refrigeración, y una infraestructura común que ayuda a los socios del ecosistema a construir plataformas de computación acelerada interoperables. Mejora los tiempos de ensamblaje, prueba y servicio para optimizar la fabricación y el servicio en el campo, permitiendo una construcción de infraestructura más rápida y eficiente. La arquitectura soporta implementaciones en rack hasta 250kW, al mismo tiempo que simplifica la operatividad, la implementación y el reuso de la infraestructura.
La especificación de diseño del rack de CPU Vera amplía la arquitectura abierta NVIDIA MGX más allá del cálculo acelerado, proporcionando una plataforma especialmente diseñada para la era del AI agentic en crecimiento. Mientras que el Vera Rubin NVL72 sirve como base para el entrenamiento y la inferencia a gran escala, el rack de CPU Vera de NVIDIA está diseñado para soportar llamadas de herramientas, orquestación y ejecución en entorno sandbox, ayudando a los agentes de IA a interactuar con aplicaciones, datos y servicios en tiempo real.
Basado en la arquitectura de rack MGX de tercera generación de NVIDIA, el rack Vera CPU comparte los mismos principios de diseño a escala de rack que unen computación, redes, energía y refrigeración en una plataforma modular común. Este enfoque permite a los socios desplegar infraestructuras especializadas, mientras se beneficia de un ecosistema compartido, una integración simplificada y una base consistente para fábricas de IA de próxima generación.
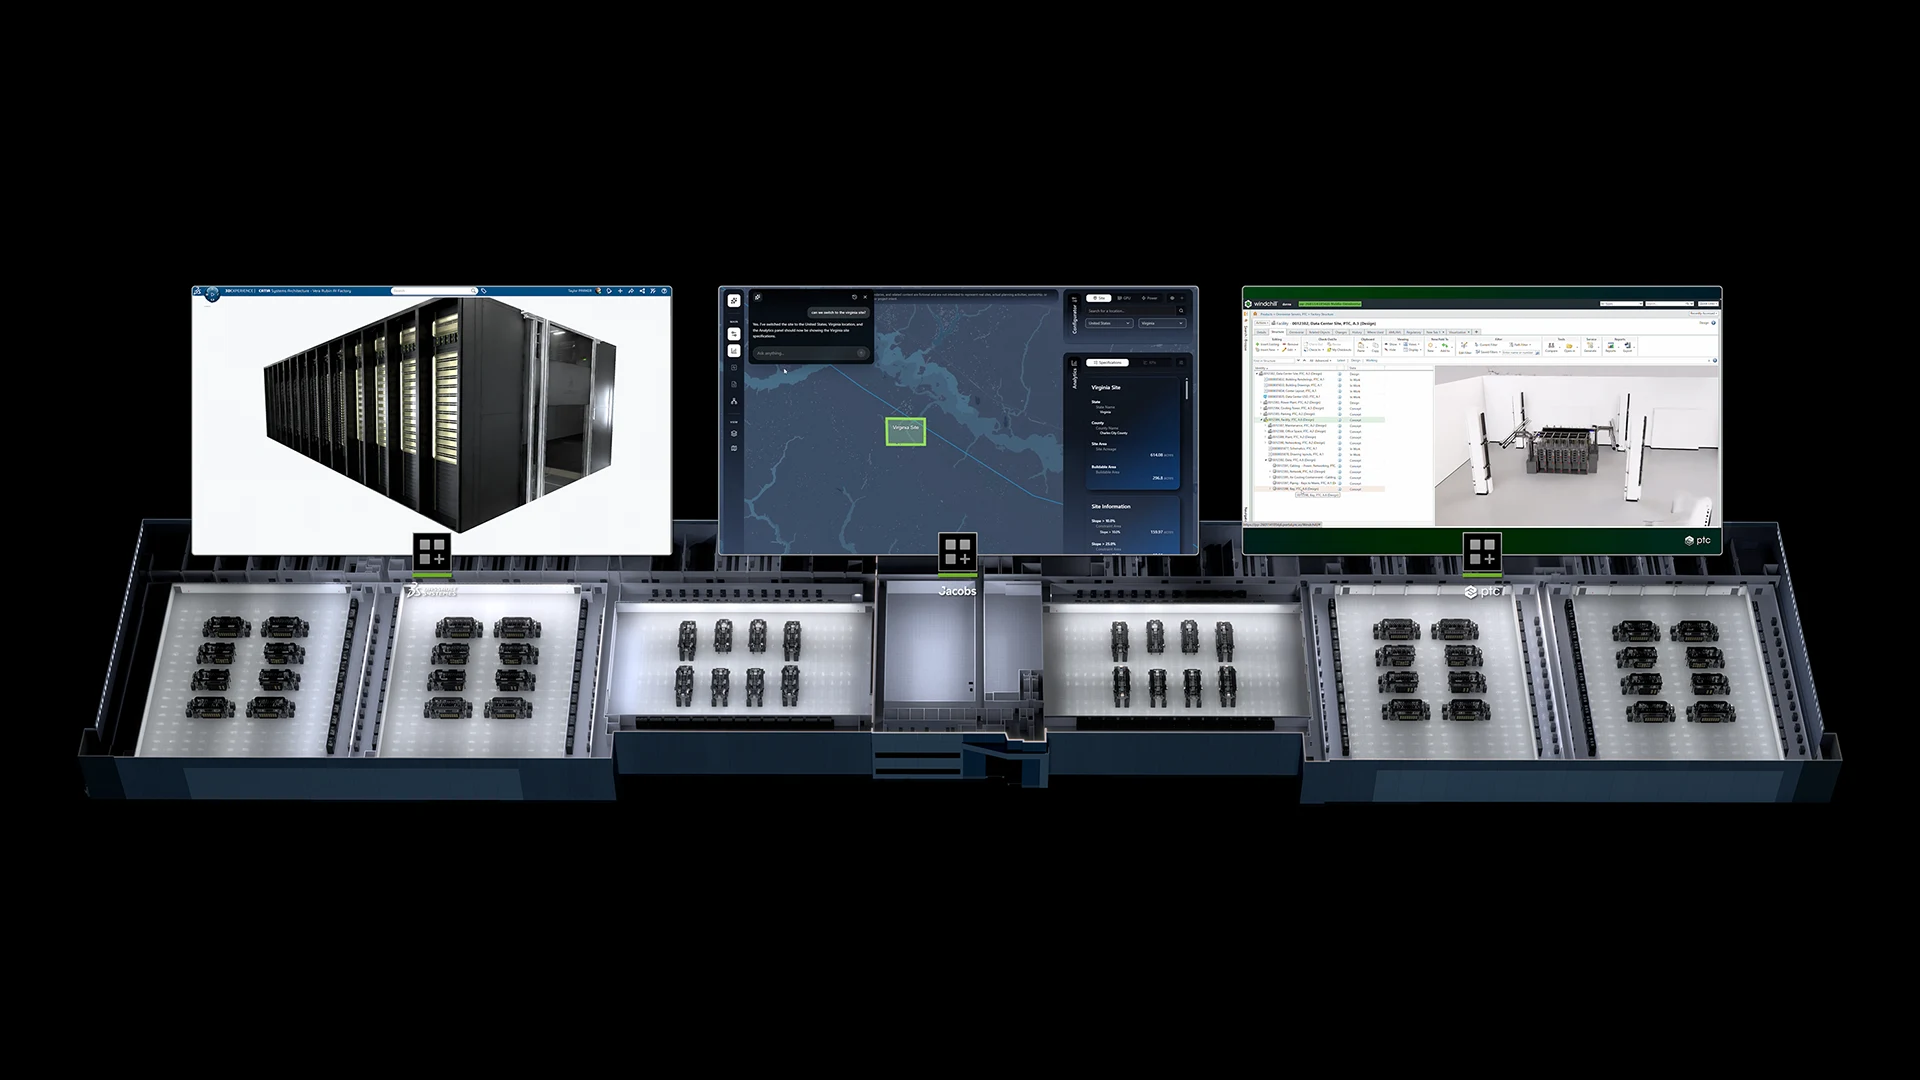
NVIDIA lanza nuevos componentes de software de código abierto para DSX AI Factory
Plataforma de fábrica de IA DSX de NVIDIA aplica un código compartido extremo para unificar computación, redes, energía, refrigeración, instalaciones y software, ayudando a las fábricas de IA a operar como un único sistema optimizado, maximizando el rendimiento de la IA dentro de las limitaciones de la infraestructura disponible. En el centro de este sistema unificado se encuentra DSX OS, la capa operativa abierta que convierte la arquitectura DSX en operaciones coordinadas y repetibles a gran escala.
En OCP, NVIDIA amplió el DSX OS con componentes de código abierto para configurar redes, validar clústers, gestionar racks y aprovisionar hardware sin servidor:
- NVIDIA Config Manager: Automatiza las configuraciones de conmutadores a gran escala, permitiendo a los clientes desplegar, validar y mantener telas de red de fábrica de IA consistentes con intervención manual mínima o nula.
- NVIDIA Cluster Readiness Engine: Ayuda a eliminar los accidentes costosos de trabajos mediante pruebas de estrés de clústeres de GPU con simulaciones de carga real, para garantizar la salud del hardware antes de comenzar el entrenamiento
- NVIDIA Rack Management Service: Ofrece una abstracción de hardware de rack y soluciones de operaciones que trata a los racks como unidades de primera clase para mejorar la gestión del firmware en la escala de la fábrica de IA.
- Proveedor de API de Cluster para el Controlador de Infraestructura de NVIDIA: Acelera la implementación de hardware sin máquina y el registro de inquilinos, convirtiendo el hardware de IA bruto en clústeres listos para producción en horas en lugar de días.
Desarrollados a partir de la experiencia de NVIDIA en el funcionamiento de los NVIDIA DGX Cloud, estos componentes de código abierto permiten a los proveedores de cloud y socios de software integrar las capacidades de la fábrica de IA directamente en sus plataformas multi-tenant.
Los desarrolladores pueden visitar elpage de GitHub de DSX AI Factory para explorar y contribuir tanto en los componentes de software de código abierto nuevos como existentes de la plataforma NVIDIA DSX AI Factory.
NVIDIA y hyperscalers publican estándares abiertos para fábricas de IA de próxima generación
Para que la infraestructura de IA pueda escalar a nivel global, se necesita más que hardware avanzado; se necesita una base común en la que toda la industria pueda construirse.
En OCP, NVIDIA se unió a AMD, Google y Meta para publicar una nueva especificación abierta que establece esa base. La Especificación de Centro de Datos Abierto v0.7 define un planteamiento unificado para el diseño de instalaciones de fábrica de IA de próxima generación — desde la arquitectura eléctrica hasta la infraestructura de refrigeración y el diseño físico.
La Especificación de Resiliencia del Grid OCP, publicada por Google, Meta, Microsoft y NVIDIA, establece cómo debe comportarse la infraestructura de IA a gran escala durante las interrupciones en la red eléctrica: mantenerse conectado, responder automáticamente y recuperar una carga casi completa en menos de dos segundos.
Con estos estándares ahora abiertos, los fabricantes de todo el mundo tienen un objetivo común a alcanzar. Los fabricantes de equipos, los proveedores de colocación y los operadores de centros de datos pueden comenzar a diseñar, fabricar y entregar la capa de infraestructura que alimenta las fábricas de IA en construcción a nivel mundial — sin esperar a especificaciones propietarias de cada cliente.
Si son compatibles con el diseño de referencia NVIDIA DSX, estas especificaciones proporcionan una implementación validada y disponible de ambas especificaciones, desde el diseño de la instalación y la arquitectura de energía hasta el software que monitorea y responde a los señales de la red en tiempo real. Para los operadores que construyen fábricas de IA Vera Rubin, ahora existe una conexión directa desde el estándar comunitario abierto hasta un sistema en funcionamiento.
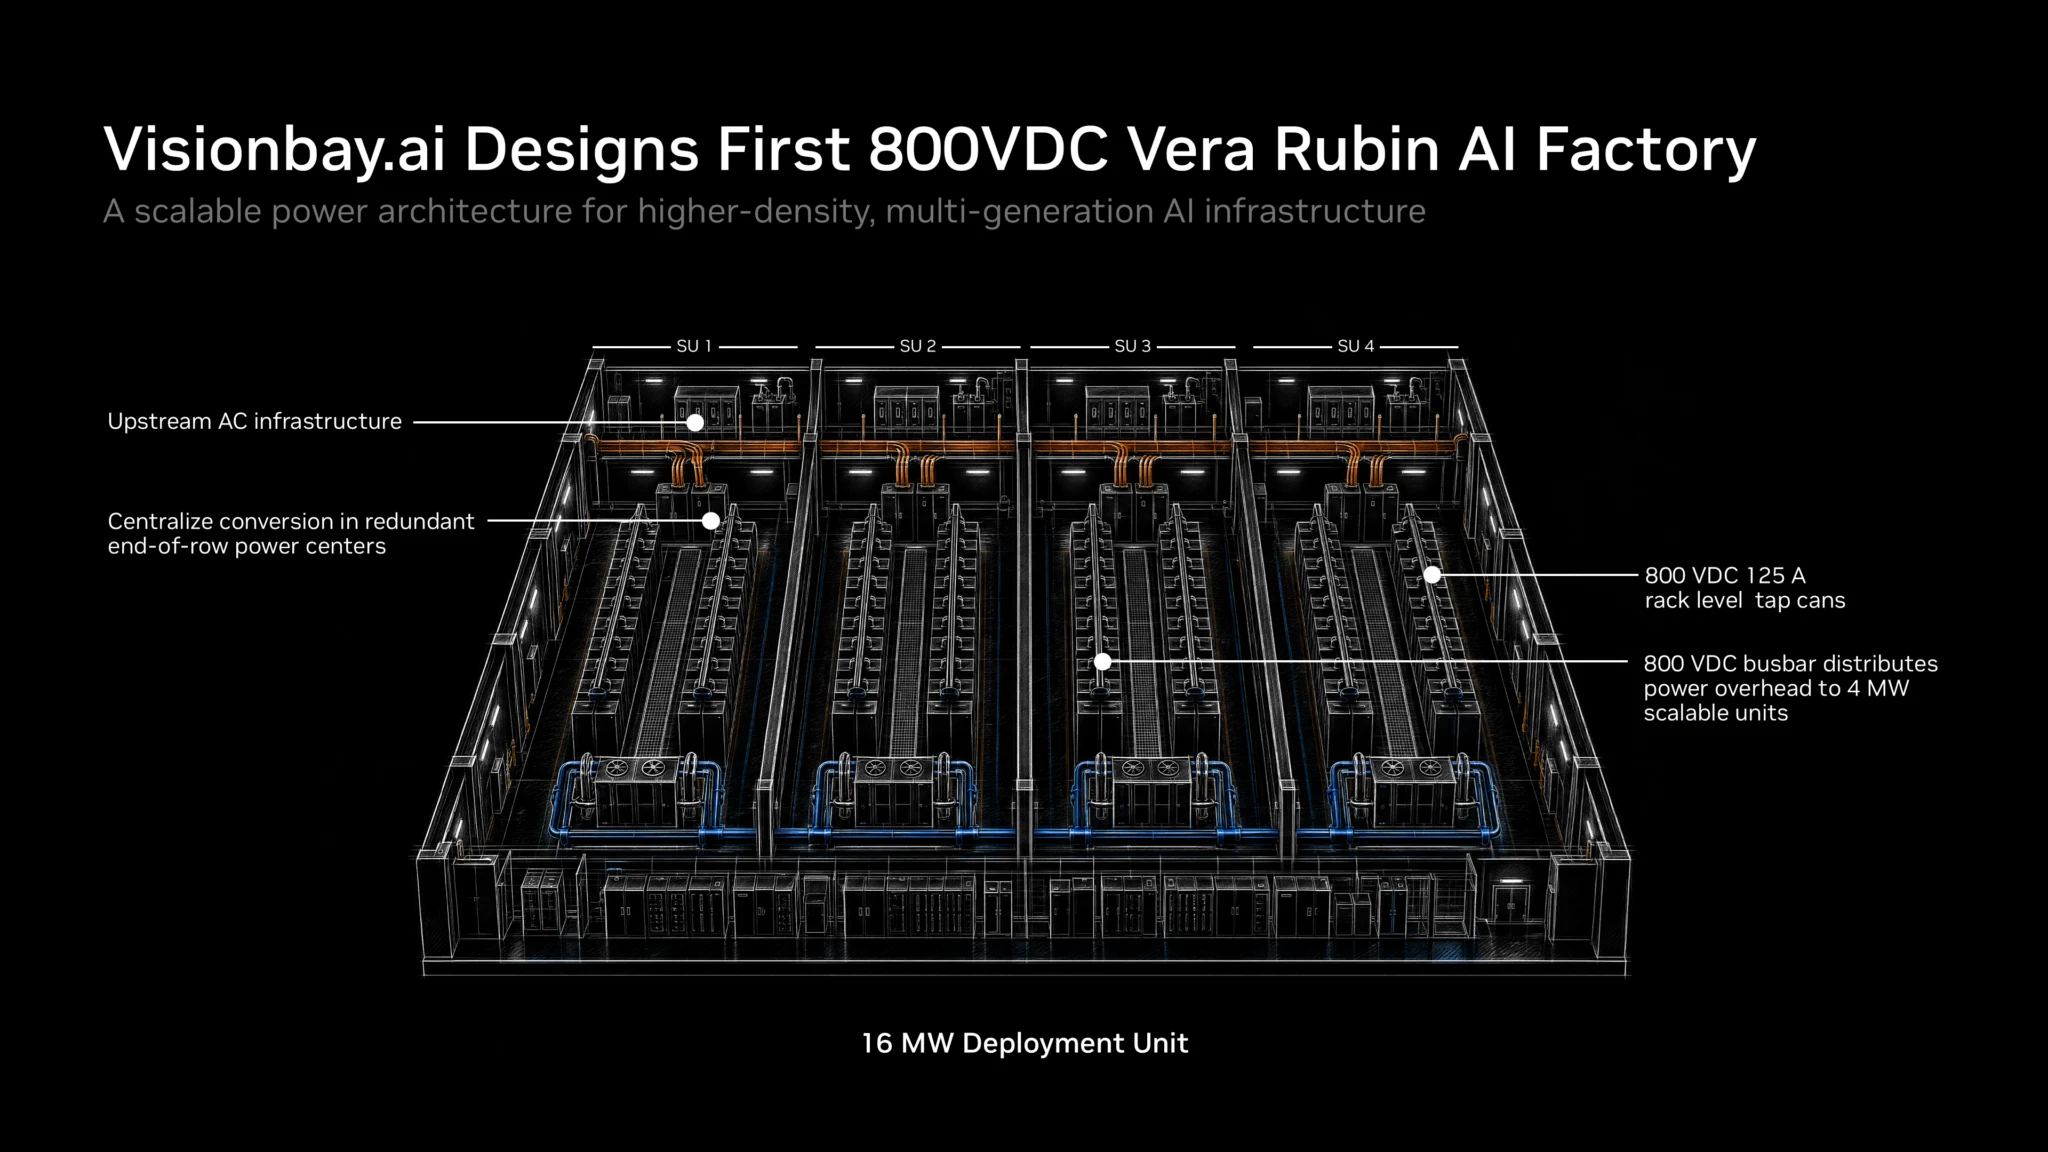
Visionbay.ai Diseña una Fábrica de IA 800VDC para la Época de Vera Rubin
A medida que las fábricas de IA crecen y se vuelven más potentes, surge un desafío para todas ellas: proporcionar suficiente energía a los sistemas de computación acelerados que impulsan la próxima generación de IA.
En OCP, Visionbay reveló los planes para K-1, una plataforma de fábrica de IA de próxima generación diseñada en torno a la arquitectura 800 VDC y construida teniendo en mente las futuras implementaciones de NVIDIA Vera Rubin. El proyecto combina la arquitectura de referencia 800 VDC de NVIDIA con tecnologías de energía y calor de Vertiv, creando una base escalable para infraestructuras de IA de alta densidad.
El diseño aborda un desafío creciente en la industria. A medida que aumentan las cargas de entrenamiento, inferencia y razonamiento de la IA, las densidades de potencia en los racks continúan elevándose. La distribución tradicional de energía de baja tensión se vuelve cada vez más difícil de escalar, lo que requiere más cobre, más cableado y más equipo de conversión de energía.
Al adoptar la arquitectura 800 VDC de NVIDIA, K-1 crea un camino hacia una infraestructura de IA de mayor densidad, al mismo tiempo que conserva la flexibilidad para las implementaciones existentes. En lugar de requerir una transición completa en el primer día, la plataforma está diseñada para implementar gradualmente la distribución de 800 VDC en los lugares donde se obtenga el mayor beneficio, ayudando a los operadores a prepararse para las generaciones futuras de computación acelerada sin necesidad de reescribir completamente las instalaciones.
La arquitectura está diseñada en torno a centros de energía a nivel de clúster que centralizan la conversión AC a DC y distribuyen 800 VDC más cerca de los recursos de computación. Este enfoque simplifica la entrega de energía en la corriente descendente, permite la expansión modular y crea bloques constructivos reproducibles para el crecimiento futuro de la fábrica de IA.
K-1 también refleja la filosofía de diseño a nivel de sistema que subyace en las fábricas de IA de NVIDIA, donde el poder, la refrigeración y el procesamiento se diseñan juntos. Con el soporte para infraestructuras enfriadas con líquido, una distribución de energía escalable y las futuras implementaciones de clase Vera Rubin, el proyecto demuestra cómo los socios del ecosistema están transformando la arquitectura de fábrica de IA de NVIDIA en infraestructura despliable diseñada para la próxima era del procesamiento acelerado.
Meta y NVIDIA avanzan en redes de IA con Spectrum-6 y tecnología Multiplane
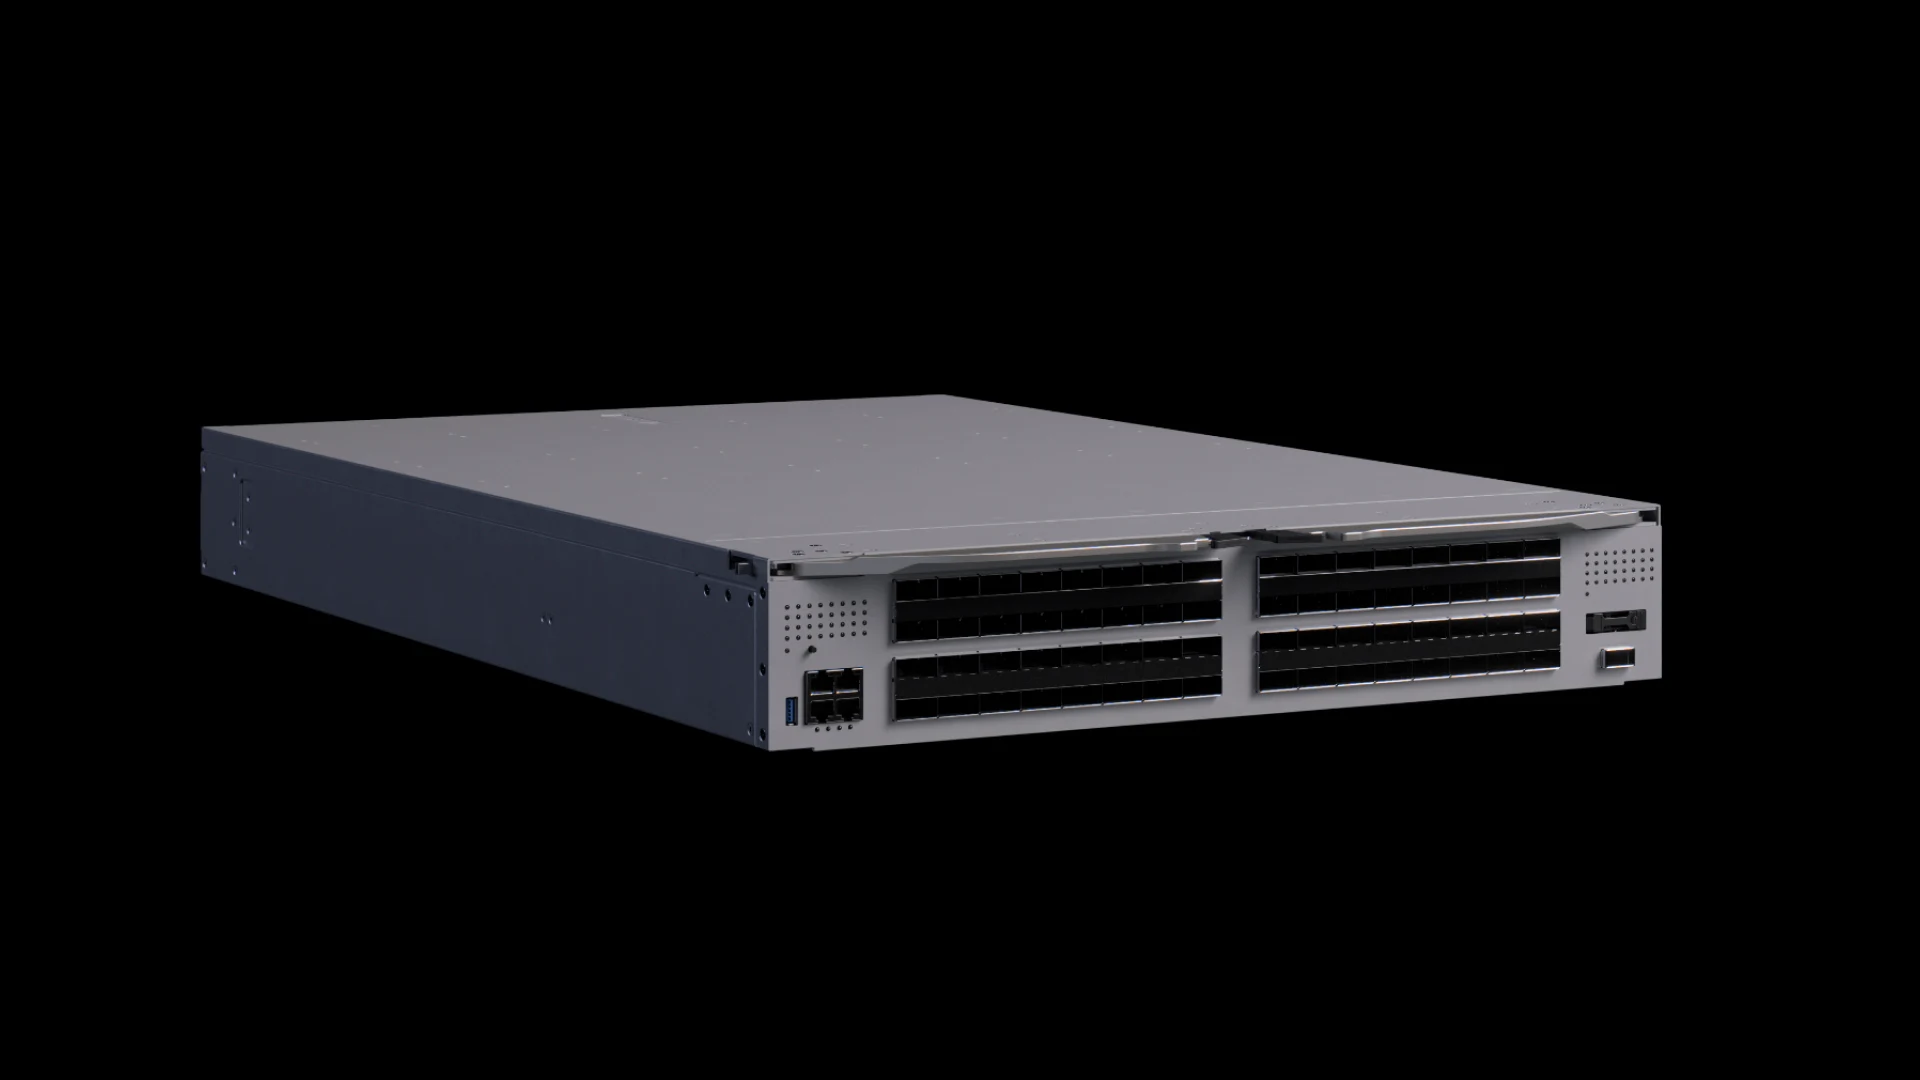
En el evento, Meta y NVIDIA anunciaron que Meta adoptará conmutadores Ethernet Spectrum-6 102.4 Tb/s de NVIDIA para construir fábricas de IA Vera Rubin de NVIDIA más grandes y de mayor rendimiento en red abierta.
Spectrum-6 ofrece el doble de capacidad de conmutación y ancho de banda por canal que Spectrum-4, y proporciona una estructura Ethernet AI sin pérdidas a 200G por canal, con un alto ancho de banda efectivo y aislamiento de rendimiento que evita que el tráfico de uno de los trabajos ralentice al de otro.
La unidad de conmutación N-IceCube, basada en Spectrum-6 de Meta, se inserta en el rack 100T de Meta, que cuenta con refrigeración líquida. N-IceCube ejecuta el sistema de conmutación abierta Facebook Open Switching System (FBOSS), el sistema operativo de red de código abierto de Meta, el cual ayudó a OCP a apoyar redes eficientes en escala hiperconectada.
FBOSS está construido sobre la Interfaz de Abstracción de Switch, un estándar OCP en el que NVIDIA ayudó a desarrollar, ofreciendo una forma independiente del proveedor para controlar el hardware de switch. Juntas, estas tecnologías sustentan fábricas de IA agentes de más de 100,000 GPU que entrenan y sirven modelos mixture-of-experts.
El anuncio marca el siguiente paso en una colaboración que combina la experiencia de Meta en la operación de infraestructuras de IA a escala hiperescala con la tecnología de redes de NVIDIA.
En el corazón de esta colaboración está la tecnología Spectrum-X Multiplane, que se activa mediante los conmutadores Spectrum-6 y los ConnectX-9 SuperNICs. Multiplane distribuye el tráfico de GPU en hardware a lo largo de hasta ocho planos de red independientes, permitiendo que las fábricas de IA se expandan más allá de 100,000 GPUs con menos niveles de conmutadores y costos de infraestructura más bajos. Varios caminos entre las GPU mejoran la utilización y la resiliencia de la red: cuando un componente falla, el tráfico se desvía hacia los planos restantes, manteniendo las GPU productivas y las aplicaciones de IA en funcionamiento, incluso con un ancho de banda reducido.
Meta y NVIDIA trabajaron juntos para fortalecer esa resiliencia a través de la experiencia de despliegue y la rápida iteración de ingeniería. Los equipos validaron las mejoras en entornos on-premises y en la nube.
“Estamos entusiasmados con nuestra estrecha colaboración con NVIDIA para que las tela de múltiples planos sea escalable y eficiente desde el punto de vista operativo, lo cual es una necesidad crítica tanto para nuestras propias construcciones de infraestructura como para nuestros socios en la nube”, dijo Omar Baldonado, director senior de centros de datos y redes de IA en Meta. “Extender FBOSS a los ASICs de Spectrum significa que podemos ejecutar ese mismo conjunto de software en nuestras estructuras, y el nuevo conmutador basado en Spectrum de Meta, N-IceCube, lo introduce en Icepack – nuestro rack de red de 102.4T con refrigeración líquida para escalar, que conecta las generaciones futuras de aceleradores en nuestra flota”.
Juntas, Meta y NVIDIA están desarrollando una arquitectura y un manual de operaciones que otros operadores de infraestructuras de IA puedan adoptar, transformando las lecciones obtenidas de cargas de trabajo de producción exigentes en fábricas de IA más escalables, resistentes y eficientes.
Con USFP, NVIDIA y Cisco reinventan las ópticas plugables para la escala de fábricas de IA
A medida que las fábricas de IA se expanden para soportar modelos más grandes y la demanda de inferencia aumenta, cada componente de la pila de infraestructura debe ofrecer mayor rendimiento, eficiencia y simplicidad, incluso en la conexión de red en sí.
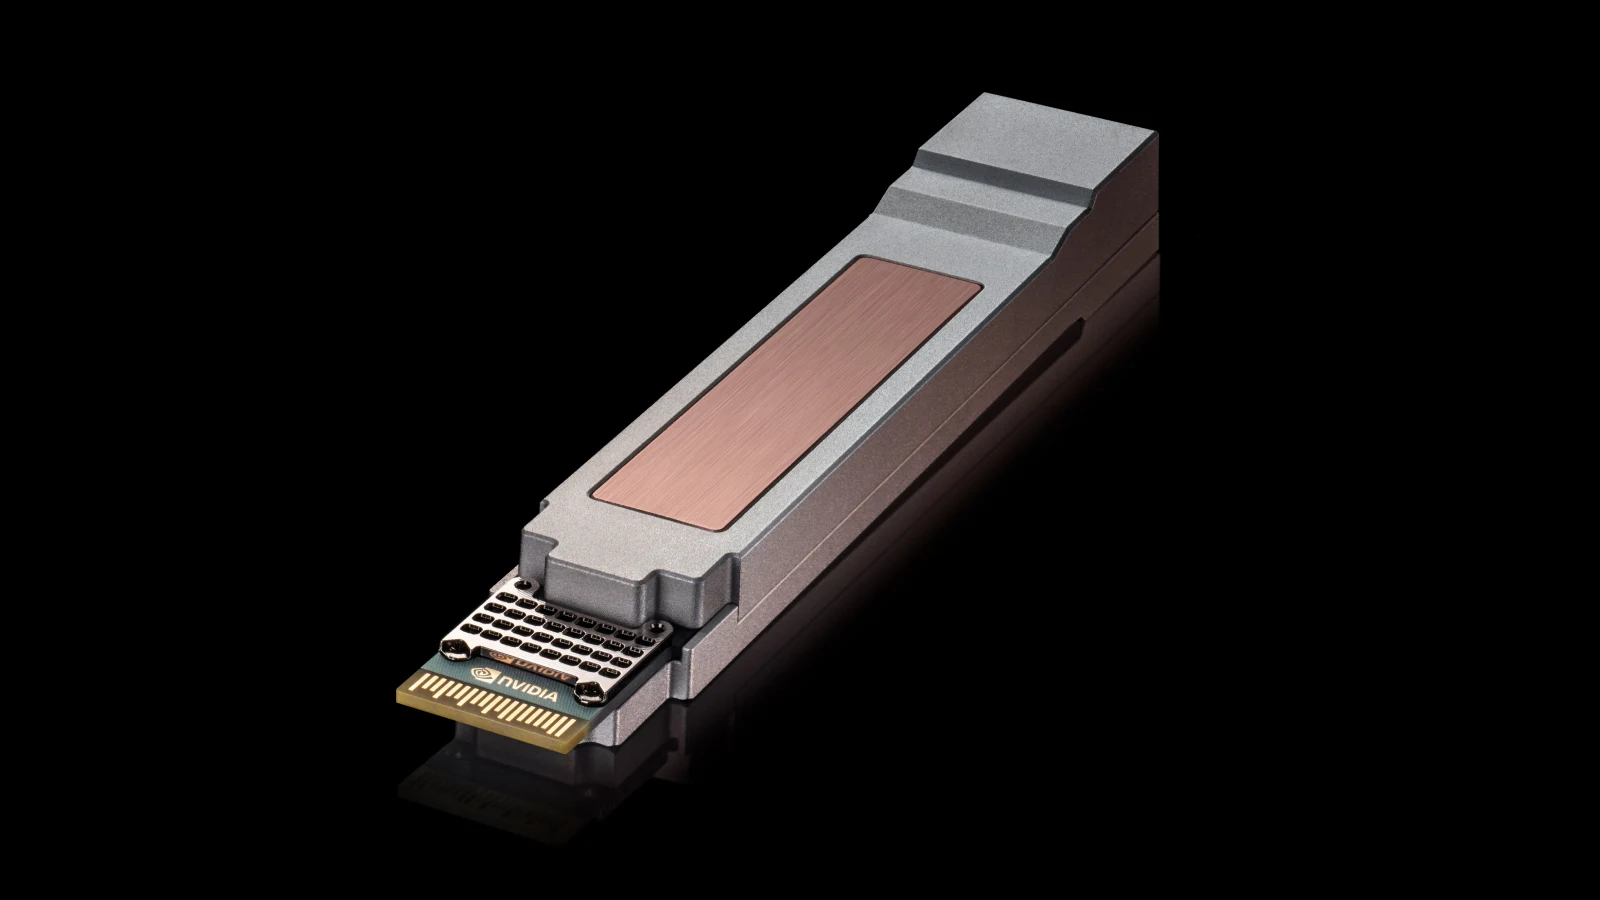
En OCP, NVIDIA y Cisco anunciaron planes para USFP, un nuevo formato de módulo transceptor óptico pluggable diseñado para ayudar a los constructores de fábricas de IA a escalar las tecnologías de IA de próxima generación, al tiempo que mejora la densidad de ancho de banda y la eficiencia energética.
Con aproximadamente el mismo tamaño que el formato OSFP de 200 Gb/s por lane, el USFP proporcionará un camino hacia la red de 400 Gb/s por lane y extenderá el modelo de despliegue basado en transceptores, ya probado a lo largo de generaciones de redes de centros de datos. Al incluir 16 caras full-duplex y planes para escalar hasta 32 caras, el USFP ofrecerá una densidad de ancho de banda cuatro veces mayor que la de los optics pluggable tradicionales de 200 Gb/s por lane.
El resultado es la capacidad de conectar más recursos de computación sin necesidad de agregar niveles de red que puedan aumentar la latencia, el consumo de energía y la complejidad.
El nuevo formato de dispositivo está diseñado para las exigencias de escala y eficiencia de las fábricas de IA de la próxima generación, soportando estructuras de ancho de banda más alto mientras conserva la flexibilidad y capacidad de servicio que han hecho que los optics conectables sean un pilar de los centros de datos modernos. También ofrecerá una eficiencia energética aproximadamente 1,3 veces mayor, ayudando a los operadores a mover más datos con menos energía.
Para ayudar a impulsar un ecosistema abierto, NVIDIA y Cisco colaboran con TE Connectivity y Amphenol en jaulas, conectores y módulos, con la intención de avanzar en USFP a través de un esfuerzo multiescalable liderado por la comunidad. Juntas, las empresas están sentando las bases para una red de fábrica de IA más escalable, eficiente e interoperable.
Google Falcon Transport soporta NVIDIA ConnectX-10 para una red de IA interoperable
NVIDIA y Google también anunciaron el soporte para Falcon Transport en futuros SuperNICs NVIDIA ConnectX-10 y DPUs BlueField, lo que ayuda a mejorar la eficiencia de la red para la infraestructura de IA a gran escala.
Falcon es un protocolo de transporte diseñado para entregar datos de manera confiable a través de redes Ethernet, que de otro modo podrían perder paquetes debido a la congestión. Soporta cargas de trabajo de IA y almacenamiento mediante el equilibrio de carga en múltiples caminos, control de congestión programable, recuperación de pérdidas de hardware y seguridad por conexión.
Esta colaboración combina la aceleración de hardware de NVIDIA con el software DOCA para implementar Falcon y extender las redes de NVIDIA hacia el transporte en el centro de datos de Google. Las NICs de NVIDIA y Google pueden comunicarse a través de un transporte común, mientras que las aplicaciones conservan las interfaces de programación estándar RDMA.
Al distribuir el tráfico entre diferentes rutas, adaptarse a la congestión, recuperar los paquetes perdidos y proteger las conexiones, Falcon ayuda a los trabajos de carga a utilizar mejor el ancho de banda disponible y mantener un rendimiento predecible a medida que las estructuras Ethernet crecen.
Aprenda más al participar enNVIDIA en OCP.