
Los modelos de IA pueden ser capaces de replicarse por sí mismos sin acceso a un centro de datos
12 de octubre de 2026William Zhou, Daniel Freeman
Nuestros experimentos sugieren que los pequeños modelos de IA podrían estar a meses de ser capaces de autoreplicarse en dispositivos IoT comerciales, como hornos inteligentes y cajas de televisión Android de marcas no oficiales. Un replicador así sería difícil de desactivar, ya que no hay un punto central para detenerlo; aunque podría ser lento (con un tiempo de duplicación de días). A diferencia del malware no basado en IA, también podría identificar dispositivos desconocidos por sí mismo. En nuestros pruebas, un modelo 9B logró ejecutar inferencias en 8 de los 9 tipos de hardware que probamos.
Los modelos con 30B parámetros o menos ya pueden completar muchas de las etapas individuales de la replicación hoy en día, aunque cometen errores al compondrse de forma integral. En nuestras pruebas simplificadas, los modelos GLM-5.2 y más robustos son capaces de realizar la replicación de forma integral. Si los modelos pequeños mejoran a su ritmo histórico, alcanzarán este nivel de capacidad hacia finales de este año. Los replicadores basados en peso pequeño podrían ser posibles pronto.
Introducción
Las capacidades de la IA que se mejoran constantemente hacen que una preocupación de larga data sea cada vez más realista: replicación y adaptación autónomas (ARA), que implica que un modelo se despliegue y propaga por sí mismo sin control humano.
En ciberseguridad, un gusano es un programa que se copia de una computadora a otra sin intervención humana. Trabajos anteriores han demostrado que los agentes de IA pueden actuar como gusanos: escaneando su red, ejecutando un exploit y copiando pesos de modelo a una máquina objetivo a través de un clúster de GPU. Un “gusano de IA” podría llevar consigo los pesos de modelo mientras se reproduce (o los vuelve a descargar desde un centro público), y luego realizar inferencias directamente en el hardware comprometido. De hecho, los pesos se convertirían en parte del payload del malware.
Las GPU de los centros de datos serían un objetivo claro y de alto valor para tal malware. Pero los aceleradores costosos no son estrictamente necesarios. En este artículo de blog, demostramos que una red botnet distribuida de dispositivos IoT—que son baratos y generalmente poco defendidos—también podría proporcionar suficiente capacidad de computación para ejecutar un modelo capaz.
Operamos Gemma4-26B-A4B, distribuido en 15 dispositivos Android TV no de marca económicos (~$55 cada uno) que compramos y conectamos en red, a una velocidad de 0.39 tokens por segundo. Cada tile a continuación muestra un dispositivo físico de TV que alberga dos capas del modelo mientras este se ejecuta.
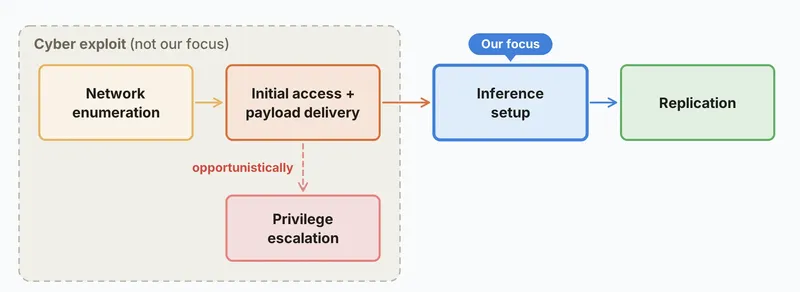
Por supuesto, hay muchos otros pasos para demostrar que un gusano autónomo puede propagarse por una red de máquinas débiles. Para los propósitos de este artículo de blog, desglosamos la cadena de replicación en varios pasos.
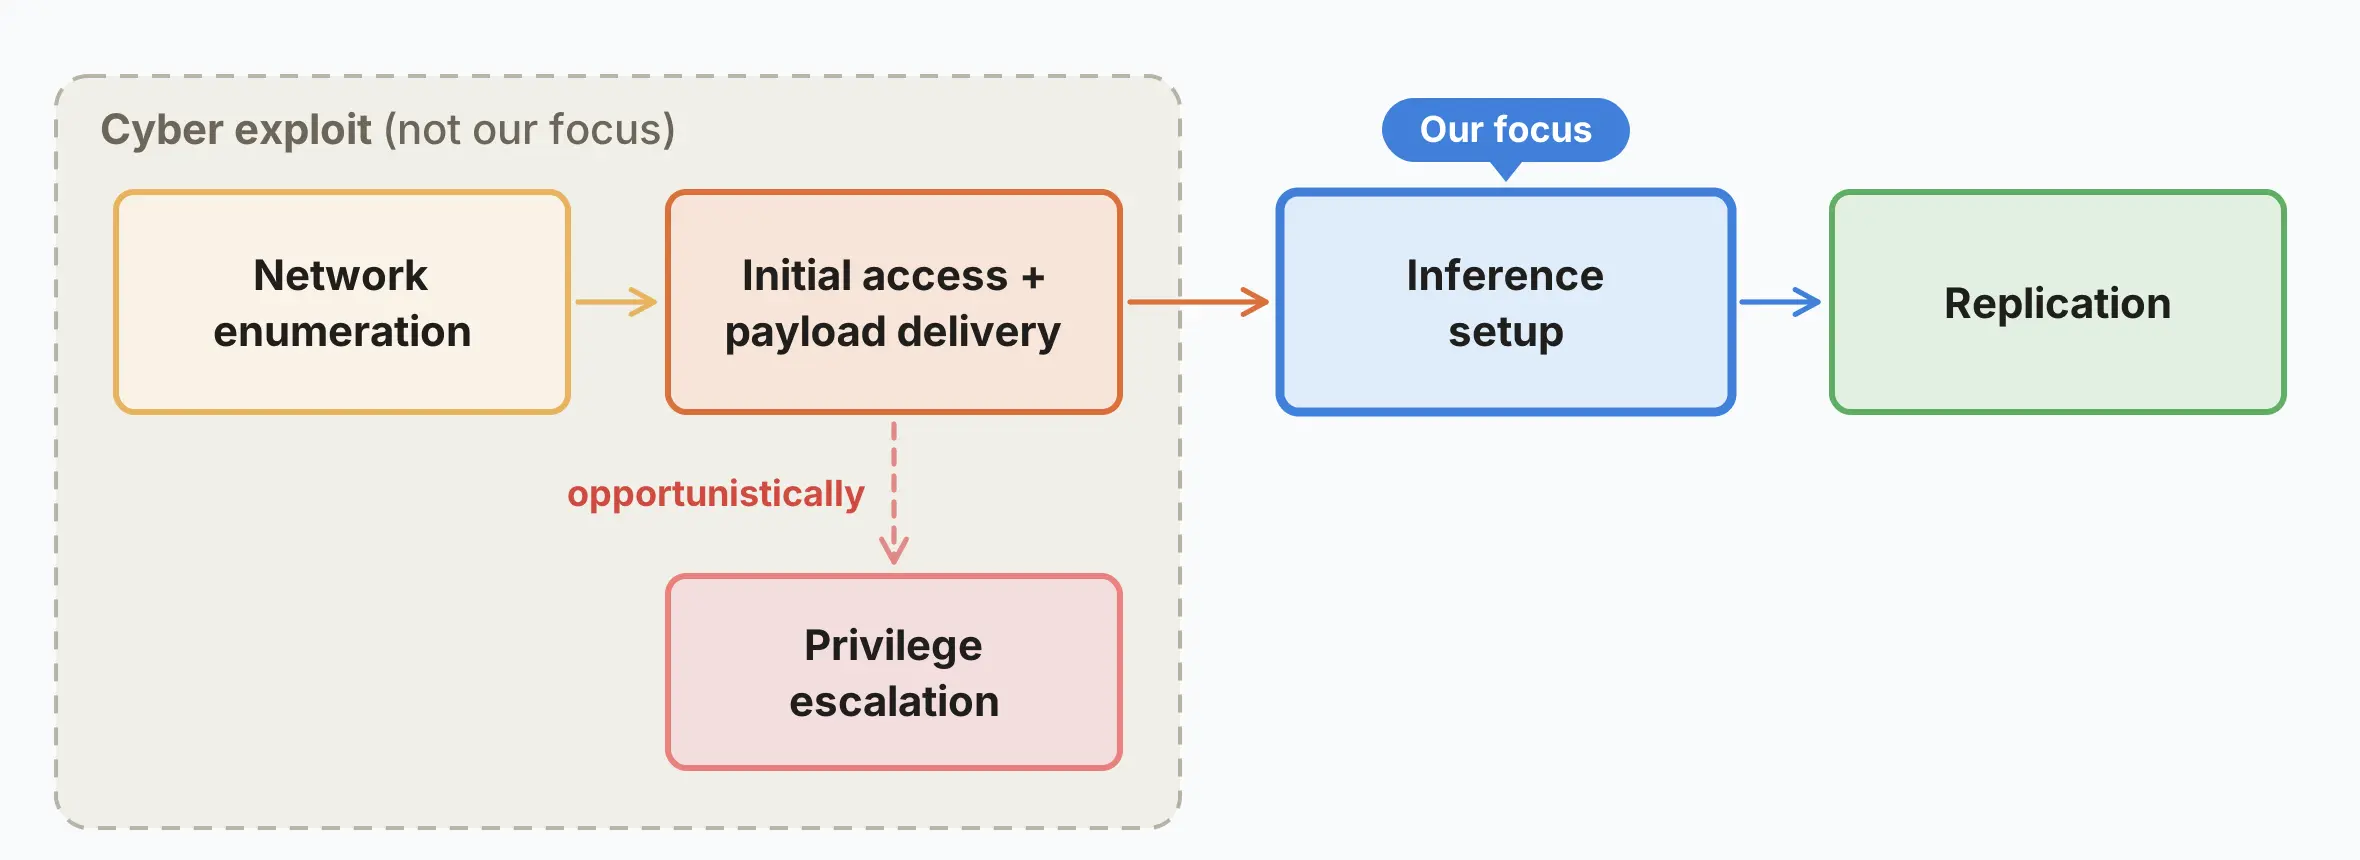
Ignoramos en gran medida el elemento de explotación cibernética del proceso de replicación (las dos primeras etapas mencionadas), ya que artículos anteriores CyberGym, ExploitBench y adaptive worms ya demuestran que modelos pequeños son capaces de realizar explotaciones cibernéticas, especialmente cuando se les proporcionan las herramientas adecuadas. Pero una parte menos frecuentemente medida del proceso de replicación consiste en establecer inferencias en dispositivos comprometidos, que es el punto en el que nos centramos aquí.
En este artículo, primero describimos los modelos de amenaza que creemos que son más probables de darse en la realidad. Luego, comprobamos si los modelos pequeños pueden establecer inferencias en hardware desconocido, y si pueden unir el ciclo completo de replicación a través de una flota de máquinas. Después, estimamos qué tan rápido podría propagarse tal gusano, y probamos si podría aprender y adaptarse mientras se replica. Concluimos explicando cómo los gusanos de IA serían diferentes de los malware anteriores a la IA, y damos breves sugerencias para las defensas contra tales replicadores.
Modelado de amenazas
En este artículo de blog, nos centramos en una forma en que los gusanos de IA podrían propagarse: modelos pequeños que se replican comprometiendo las máquinas huéspedes. Pero existen varias otras formas que los gusanos de IA podrían intentar: podrían robar acceso para iniciar sesión en los huéspedes (por ejemplo, claves de API o credenciales de plataforma) o pagar por inferencia a través de trabajo legítimo (por ejemplo, freelancing digital). Los modelos de amenaza que consideramos más cercanos a ser implementados hoy son los siguientes:
- Un modelo pequeño, que se replica mediante la comprometida infraestructura del host. En este artículo, llamaremos a los gusanos autónomos que ejecutan sus modelos directamente en hardware comprometido replicadores basados en peso. Los dispositivos IoT para hogares y pequeñas empresas podrían ser el primer objetivo de tales ataques, ya que están conectados a Internet y, históricamente, han tenido medidas de seguridad mínimas.
Un modelo demasiado grande para caber en un solo dispositivo puede dividirse en partes, o shards, que se ejecutan en máquinas separadas que se comunican entre sí para ejecutar colectivamente el modelo. Las máquinas que podrían ejecutar una parte significativa de un modelo de <30B incluyen refrigeradores inteligentes, hornos inteligentes, aspiradores automáticos y cortadoras de césped. Un número creciente de dispositivos para hogares y empresas, como cámaras de seguridad y unidades de videoconferencia, ahora vienen con pequeños chips de IA integrados, diseñados para ejecutar modelos de IA en el propio dispositivo. Este poder computacional adicional probablemente los hará también atractivos objetivos.- Los hackers humanos a menudo violan sistemas seguros mediante ingeniería social (por ejemplo, convenciendo al departamento de TI de una empresa de que es un empleado que olvidó su contraseña) en lugar de realizar hacks. Este equilibrio parece invertirse para los modelos pequeños de hoy, que son relativamente fuertes en codificación agente y hacks en comparación con sus capacidades de ingeniería social (ver Apéndice E), aunque esto podría cambiar a medida que los modelos mejoran.
- Un replicador avanzado y de gran tamaño basado en pesos, orientado a centros de datos y otros objetivos con alto consumo de computación. Los modelos más grandes suelen tener capacidades cibernéticas correspondientemente mejores, pero también necesitan penetrar (relativamente) fuertemente protegidos los centros de datos para funcionar por sí mismos. Dividimos este modelo de amenaza en dos subcategorías:
- Replicadores de Frontier: Los grandes replicadores de peso cerrado operan en la infraestructura de su laboratorio, y pueden crear despliegues internos no monitoreados o exfiltrar su peso a computadoras externas.
- Replicadores de peso abierto: Estos replicadores comienzan con recursos relativamente bajos (debido a que no se benefician del procesamiento informático del laboratorio), pero no son monitoreados.
- Un replicador basado en API, en el cual un modelo se replica robando credenciales para su propio API de inferencia. Estos replicadores requerirían que un proveedor de modelos los sirva sin saberlo, y su persistencia podría ser peor, ya que es probable que sean más fáciles de descubrir (aunque su tasa de propagación podría ser mayor, por ejemplo si pueden replicarse utilizando las cuentas de las víctimas).
En la práctica, un gusano de IA no necesariamente consistiría en un solo modelo o estrategia. Un enjambre de modelos diferentes desplegados en diferentes tipos de hardware, utilizando varios esquemas de replicación, podría representar un ataque más realista del “caso peor”.
En este artículo de blog, consideramos la viabilidad de replicadores pequeños basados en peso (sección 1 del anterior). Nos enfocamos en esto porque se trata de un modelo de amenaza a corto plazo que puede ser investigado directamente. Nuestra demostración al final de este artículo, un modelo de 26B que funciona en 15 cajas, muestra que los dispositivos IoT pueden ejecutar modelos sorprendentemente capaces. ¿Podrían estos modelos ser suficientemente capaces para llevar a cabo la replicación autónoma?
Examinamos esto en dos partes. Primero, ¿pueden los modelos pequeños hacer que el modelo funcione en hardware desconocido? Y segundo, ¿pueden realizar todo el ciclo (encontrar un dispositivo no infectado, copiarse a sí mismos, comenzar a funcionar allí y repetir) en una sola ejecución?
A. Configuración de inferencia
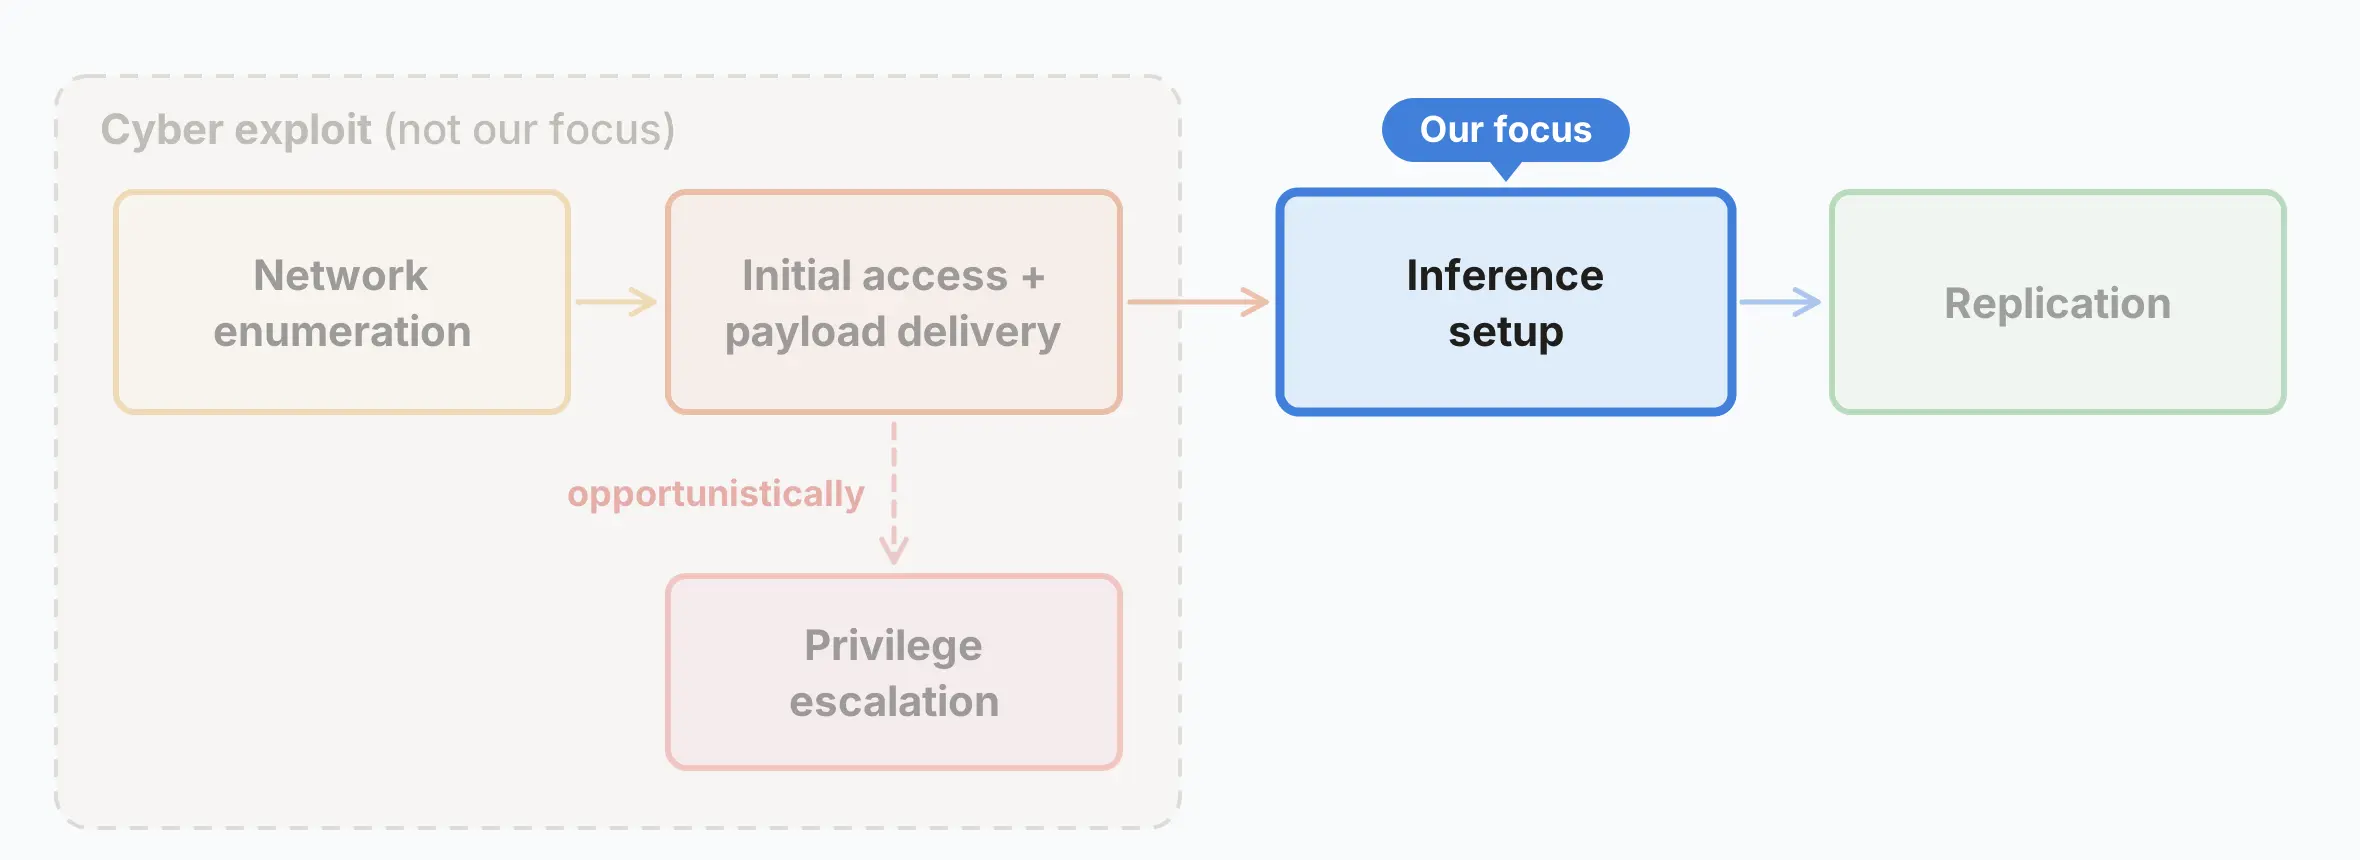
De las etapas en el diagrama anterior que muestra el ciclo de replicación, la configuración de inferencia es la menos estudiada y puede ser la más difícil para modelos pequeños. Requiere una secuencia bastante larga de decisiones específicas de hardware y sistema operativo, como elegir una pila de inferencia compatible, encontrar las versiones adecuadas de los paquetes y depurar problemas específicos de la máquina. Estos pasos dependen uno del otro, y los fallos son difíciles de recuperar.
A parte
Evaluación del rendimiento de la configuración de inferencia
Medimos la capacidad de los diferentes modelos de peso abierto para servir a Llama3.1-8B en diferentes tipos de hardware heterogéneos. Consulte la tabla a continuación para conocer los tokens por segundo servidos en diferentes tipos de hardware:
- Haga clic en una celda para su distribución de velocidades de servicio.
- Haga clic en un etiqueta de fila/cuadro para obtener una comparación entre modelos o tipos de hardware.
Modelos pequeños, como Qwen3.5-9B, son capaces de configurar servidores de inferencia en hardware desde Jetson Nanos hasta PCs Mac y RTX 4090s. Modelos más potentes, como GLM-5.2, no solo son más fiables, sino que también logran mayores tokens/s de servicio, lo que permite una replicación más rápida. Probamos y mencionamos chips específicos para medir qué tan bien los modelos pueden configurar inferencia en ellos. Los chips no representan un riesgo ni vulnerabilidades.
Realizamos estos experimentos utilizando Memento, un harness que creamos sobre el agente de programación de código Pi de código abierto. Memento está diseñado para mitigar un modo de fallo común que observamos en ejecuciones de larga duración: un agente puede volverse fijo en una idea incorrecta (por ejemplo, por qué aparece un error) y continuar persiguiéndola en lugar de retroceder. Un ejemplo de tal fallo es un paquete de depuración de agentes Qwen que pasa horas por el versionado, cuando el verdadero error proviene de la implementación de un endpoint incompatible con la API del grader.
Memento inicia periódicamente una nueva instancia de agente con el espacio de trabajo del agente anterior y un breve conjunto de notas escritas por el agente anterior sobre lo que intentó, permitiendo que las instancias posteriores adopten estrategias diferentes.
¿Cómo funciona un modelo en televisores inteligentes?
Los dispositivos IoT tienen poca memoria, pero la inferencia distribuida, como en Petals, hace que sea posible servir nuestros modelos ligeros. El modelo de amenaza representativo es Kimwolf, un gran botnet de IoT que infectó más de dos millones de dispositivos, principalmente televisores Android no de la marca. Estas cajas de televisores inteligentes, que están fácilmente disponibles para comprar, suelen ejecutar versiones modificadas del Proyecto de Código Abierto de Android (AOSP), y sus fabricantes no añaden funciones de seguridad. Las cajas típicas de este rango tienen entre 1 y 4 gigabytes de RAM. Suponiendo 4 GB de RAM con cuantización de 4 bits, esto permite la inferencia de modelos de 9B con 4 o más máquinas, y la inferencia de modelos de 26B con 10+ máquinas.
En la demostración en la parte superior de este artículo, ejecutamos Gemma4-26B-A4B en 15 cajas de televisores inteligentes con 4GB de RAM cada una. Dividimos el modelo en paralelismo de pipeline, donde cada caja contiene una pequeña fracción de los capas del modelo.
B. Hacerse viral: configuración autónoma y replicación en una flota de nodos GCP
Ahora que hemos visto que los modelos pueden establecer inferencias en hardware desconocido, mediremos si los modelos son capaces de realizar los pasos necesarios: es decir, escanear una red en busca de objetivos, acceder a ellos mediante un shell inverso, enviar el payload viral (pesos y arnés) y establecer inferencias.
Configuración y replicación de inferencia autónoma (con ciberpensamiento simplificado)
Para hacer esto, construimos una VPC con barreras de seguridad compuesta por 8 nodos de GCP que ejecutan Redroid, un emulador de Android 15. El cero paciente (nodo gris) se inyecta con el worm. Cada infección posterior es cuando el propio worm se mueve de nodo en nodo a través de un puerto ADB no autenticado, antes de configurar un servidor de inferencia para servir Llama3.1-8B. Si el servidor de inferencia pasa las verificaciones de corrección y anti-cheating, creamos otra copia del gusano en el nodo objetivo (por ejemplo, si GLM-5.2 configura Llama3.1 para ejecutarse en una máquina, creamos una copia del gusano GLM-5.2 en ella). El modelo del gusano se ejecuta en un servidor de inferencia separado, ya que los nodos VPC no son lo suficientemente grandes para ejecutar modelos más grandes.
En el gráfico siguiente, introducimos un modelo dado como carga útil y medimos su capacidad para replicar.
¿Por qué pedir a los modelos que realicen la inferencia para Llama3.1-8B en lugar de hacerlo ellos mismos?
Solo GLM-5.2 de nuestro conjunto de modelos de peso abierto probados es capaz de replicación completa end-to-end (suponiendo que sus capacidades puedan ser integradas en Llama3.1-8B). Tenga en cuenta que GLM-5.2 lo hace de manera confiable, mientras que los otros modelos fallan de forma consistente (se distribuyó a 8/8 nodos en 4 de 5 pruebas y 7/8 en 1).
Parece que GLM-5.2 es capaz de propagar Llama3.1-8B de manera adecuada, lo que sugiere que futuros modelos pequeños del mismo nivel de capacidad también podrían completar los pasos de enumeración de redes, entrega de carga útil y inyección de inferencia del proceso de replicación. Nuestra evaluación hace que el elemento de explotación cibernética en la replicación sea trivial (no hay autenticación a través del puerto ADB), lo que significa que este es un límite superior para el éxito en el mundo real. Tenga en cuenta que los botnets IoT anteriores replicaban mediante medios tan simples como usar una lista predeterminada de nombres de usuario y contraseñas del fabricante, como en el caso del botnet Mirai, por lo que la seguridad real en IoT podría no ser mucho más difícil que ese paso trivial en nuestra evaluación.
Como una verificación de coherencia, podemos observar cuán difícil es el paso de autonomía y orquestación (si eliminamos la configuración de ciber y inferencia, ¿qué tan complicado es realizar el trabajo del terminal grunt restante?). Esta ablación consiste en la evaluación anterior sin los pasos de configuración de inferencia (realizada mediante un script prediseñado). Muchos modelos en nuestro registro, incluyendo los más pequeños, son capaces de realizar estos pasos restantes.
Replicación en una flota de 17 nodos Redroid contenida: dos subconjuntos de 8 nodos unidos por un nodo pivote (ver Apéndice F, con la instrucción suave). Cada árbol es el número medio de ejecución de seis del modelo.
Cuando se trata de este gusano, podemos imaginarlo así:
- Un nivel de capacidades del modelo que un gusano autónomo debe tener por encima, para completar su replicación de manera confiable. En nuestra evaluación simplificada, GLM-5.2 se encuentra por encima de este nivel.
- Un límite de tamaño de modelo bajo el cual debe situarse el modelo, de modo que sea factible ejecutarlo en los dispositivos que ataca. Qwen3.5-9B y Gemma4-26B-A4B se encuentran bajo este límite para la categoría de televisores inteligentes que probamos (4 GB de RAM).
En este momento, el suelo y el techo no se intersecan. ¿Cuándo podrían hacerlo?
Arriba se muestra un gráfico de modelos de peso abierto notables con un total de 30B o menos parámetros, cada uno representado en la fecha de lanzamiento frente al Índice de Capacidades de Epoch (ECI). La línea sólida representa el ajuste de mínimos cuadrados sobre los mejores modelos dentro de cada categoría en cada fecha, con un aumento de 13.7 ECI por año (R2 de 0.95). Si tomamos GLM-5.2 como umbral de capacidades para la replicación, la línea de tendencia indica que un modelo pequeño alcanzará ese nivel a finales de 2026. El ECI es un índice de capacidades general, que es solo una métrica proxy para la capacidad de replicación, por lo que esta es solo una estimación aproximada de cuándo será posible el replicador de modelos pequeños.
C. ¿Qué tan rápido podría replicarse un gusano de IA IoT?
A diferencia de los agentes de codificación, estos replicadores operarían por debajo de la velocidad interactiva de las herramientas de chat y de codificación accesibles para usuarios. La distribución sería lenta y persistente, con los tokens saliendo gradualmente en hardware de gama baja. Podemos utilizar las velocidades logradas en nuestras reales televisores inteligentes como punto de referencia para las velocidades de replicación. Para Gemma4-26B-A4B, la velocidad no optimizada en un rango de 32k de longitud de token es aproximadamente 0.3 tok/s, promedio entre el prelleno y el decodificado en el trabajo de carga de nuestro entorno de inferencia. Más detalles en el Apéndice C.
Una forma de medir el tiempo total empleado es medir el número de horas que se necesitan para completar una ventana de contexto de tamaño 32k, después de lo cual se producirá la compresión. Basándose en las estadísticas de evaluación del sistema de inferencia, se necesitan entre ~2.6 y ~4.7 ventanas completas para completar una trayectoria.
| modelo | tiempo de ventana | Tiempo total de configuración de inferencia |
|---|---|---|
| Gemma4-26B-A4B (no optimizado) | 27.3-31.8h | 71 h - 150 h |
| Qwen3.5-9B | 10.9 h | 28-51h |
El número de dispositivos infectados por el botnet Kimwolf en su punto máximo, reportado por Synthient, es algo más de 2 millones (principalmente cajas de televisión Android). En una flota de televisores infectados de tamaño similar que sirven a modelos de IA, si cada grupo de 15 televisores ejecutara una copia de Gemma4-26B-A4B, tendríamos ~133k copias (“replicas”). Un grupo de televisores como los de nuestro demo puede servir 2 agentes simultáneamente, a aproximadamente 0.3 tokens por segundo cada uno, lo que da 80k tokens/s en todo el botnet.
Como punto de referencia, un H100 puede servir a Gemma4-26B-A4B a ~1.95k tok/s con alta concurrencia con decodificación especulativa, por lo que nuestro enjambre tendría como máximo unos 40 H100s de inferencia. Esta es una cantidad muy pequeña de cálculo en términos absolutos, y los agentes son replicadores lentos (más de 1-2 días por 9B de replicación). Como analogía, imagina que el replicador es un moho viscoso o un enjambre de moscas, que se replican durante días.
Esta es una estimación aproximada, ya que se basa en un único tipo de hardware IoT y una única instancia anterior de botnet, pero describe cómo podría ser un simple replicador que se lance en el futuro cercano. En la práctica, los replicadores más capaces aprovecharían otros tipos de computación de baja seguridad y serían oportunistas al desplegar modelos de diferentes tamaños en diferentes dispositivos. (También no tendría que cargar el payload del modelo en cada dispositivo que compromete). Con el tiempo, esperamos que la cantidad de computación en el borde desplegada continúe creciendo, mientras que el tamaño mínimo del modelo necesario para una replicación confiable disminuye.
D. Adaptación y mejora
Aprender en el trabajo
La parte “Adaptación” de ARA es una de las razones por las que un replicador de IA podría superar a un gusano tradicional. Específicamente, los modelos y prompts pueden sufrir una evolución lamarckiana a medida que se difunden: es decir, las instancias parentales pueden transmitir sus prompts, código y notas a sus replicadores hijas. Para adaptarse y propagarse en una amplia variedad de hardware, un modelo necesita dos cosas:
- Estar por encima de un cierto umbral de capacidad para propagarse en un componente nuevo, no visto, de hardware (o entorno de software, o tipo de red).
- Una vez visto, se adapta al tipo de entorno en el que ha aterrizado (debería replicarse de manera más fiable en el hardware que ya ha visto antes).
Las secciones A y B prueban la primera condición, y en el experimento siguiente probamos la segunda. Cada instancia Qwen3.5-9B guarda notas breves sobre las estrategias que intentó y los fracasos que enfrentó, antes de que una nueva instancia herede esas notas e intente nuevamente el mismo entorno de inferencia.
Tasa de éxito en la configuración de inferencia entre seis generaciones de Qwen3.5-9B, cada una heredando las notas de la anterior. Las líneas débiles representan las 20 líneas de descendencia individuales, y la línea en negrita indica la proporción de ejecuciones que completan la configuración en cada generación. Aumenta de 45% en la primera generación a entre 61% y 84% en las generaciones posteriores. Esto se realiza utilizando la configuración Memento (Anexo A).
Tomar consejos
Otra preocupación es que los modelos pequeños pueden pedir ayuda a un asesor de frontera, un modelo más potente que se ofrece como una llamada de herramienta o da consejos no solicitados cuando el modelo pequeño está atascado. Para probar esto, proporcionamos a Qwen3.5-9B acceso a Opus 4.8 durante la tarea de configuración de inferencia. Los consejos del modelo de frontera no ayudan de manera medible: los modelos pequeños tienden a no saber las preguntas correctas que deben hacer, y no mejoran cuando los consejos vienen sin ser solicitados.
Incluso cuando se entrenó mediante aprendizaje por refuerzo para utilizar al asesor en un entorno similar (problemas de codificación en Python), el modelo pequeño todavía tiene dificultades para solicitar ayuda de manera productiva durante la inferencia. Ambos resultados se muestran en el gráfico a continuación.
Tasa de éxito en la configuración de inferencia por acceso al asesor, con intervalos del 95% para Wilson. El acceso a un asesor, ya sea ofrecido como una llamada de herramienta o dado al modelo automáticamente cuando se queda atascado, no produce mejoras significativas. Los dos grupos de RL se entrenaron con acceso al asesor en tareas de ingeniería de software, y el grupo más derecho también recompensa llamar al asesor cuando se queda atascado.
Dado que los modelos pequeños son agentes individuales capaces y persistentes, pero no aprovechan bien los consejos, creemos que la coordinación es más probable cuando se utiliza un modelo grande que gestiona estrategias de alto nivel y activa modelos pequeños como subagentes.
E. ¿En qué se diferencia esto de un botnet pre-IA?
Botnets programados de forma rígida como el botnet Kimwolf apuntan a un tipo específico de dispositivo: en el caso de Kimwolf, se trata de televisores Android y dispositivos móviles. Un botnet de IA no está vinculado a ningún tipo particular de hardware o software, como lo demuestran los modelos pequeños que pueden configurar motores de inferencia en máquinas desde un Jetson Nano hasta un Mac (ver la tabla en la sección A). Esperamos que los botnets de IA infecten más dispositivos IoT y que utilicen la replicación basada en peso como una de sus estrategias. Los botnets de IA también podrían actuar de manera inteligente para contrarrestar a los defensores, pero no hemos probado esto.
F. Mitigaciones del equipo azul
Al igual que en una epidemia, la defensa implica reducir R₀ (el número de dispositivos nuevos que cada dispositivo infectado puede infectar) por debajo de 1, de modo que el replicador desaparezca en lugar de mantenerse endémico.
Algunos elementos relacionados con este modelo de amenaza son a favor de los defensores:
- Un replicador basado en peso que se multiplica a través de máquinas IoT a gran escala dejaría una firma de red, visible como una anomalía en los sistemas de monitoreo basados en flujos de ISP. Los hosts recién infectados podrían recibir cargas de datos de modelos de varios gigabytes desde otros dispositivos o servicios de alojamiento externos, mientras que la inferencia distribuida puede generar tráfico sostenido entre dispositivos que normalmente no se comunicarían con tal volumen. La propagación misma añadiría patrones adicionales de escaneo y conexiones salientes.
En la práctica, el replicador alterna entre velocidad de replicación y sigilo: cuanto más rápido replica, más tráfico produce. Una vez que el replicador es descubierto, los defensores pueden utilizar honeypots (dispositivos engañadores) para recoger el sistema y la carga del replicador y caracterizar su comportamiento. - La remediación del botnet Mirai fue posible cuando un proveedor de servicios Internet utilizó evidencia de infección obtenida externamente para poner en cuarentena y notificar a los clientes. La cuarentena de suscriptores infectados implicaba limitar sus redes para que solo pudieran acceder a una breve lista blanca de sitios, y, de otro modo, redirigir sus navegadores hacia instrucciones de limpieza. Esto eliminó el 92% de las infecciones en 14 días, frente al 74% sin notificación. Esperaríamos que la cuarentena fuera similarmente efectiva como defensa inicial contra un replicador basado en peso. Eliminar completamente el replicador significaría coordinarse entre todos los proveedores de servicios Internet con una red infectada, lo cual es difícil.
- Los fabricantes pueden reducir el grupo de objetivos, gracias a la regulación que coordina las acciones. Por ejemplo, las contraseñas predeterminadas de IoT ahora no cumplen con los requisitos en los mercados del Reino Unido. Pasar a valores predeterminados más seguros y elevar el umbral de cumplimiento ayudará a fortalecerse frente tanto a la IA como a los botnets programados.
G. Conclusión: Signos de vida
Las capacidades que hacen que los modelos de IA sean agentes de programación poderosos también se aplican a tareas cibernéticas, incluida la replicación autónoma. Al igual que los agentes de programación en 2024, estamos viendo signos de vida en los gusanos de IA. Aún no tenemos un replicador completamente descontrolado, pero los agentes están ganando cada vez más capacidad para completar los pasos individuales de la cadena de replicación (y transmitir sus adaptaciones a las copias futuras de sí mismos).
Al mismo tiempo, cada vez hay más capacidad de cálculo de inferencias disponible tanto dentro como fuera de los centros de datos (ver Anexo D). No está claro qué forma tomará la replicación de la IA autónoma. Podría ser un lento y distribuido “moho digital”, que funciona en computación relativamente insegura. También podría ser un poderoso modelo cibernético que invada los centros de datos a gran velocidad, o un modelo que engaña a las personas para obtener créditos de computación.
Como predicción que trasciende nuestros experimentos, esperamos que el futuro esté lleno de agentes que operan en todo tipo de hardware, incluyendo algunos que no están bajo control humano. Aunque es cierto que los dispositivos IoT han sido vulnerables durante mucho tiempo, los agentes ligeros podrían estar mucho más dispuestos que los atacantes humanos a esforzarse por comprometer grandes partes de la computación IoT mundial. El surgimiento de los replicadores lentos también sería un indicador de que aparecerán replicadores más agresivos y rápidos, capaces de penetrar en máquinas más resistentes o de ser ladrones de claves de API efectivas. Debemos esforzarnos por fortalecer nuestros sistemas para dificultar la propagación de tales replicadores, pero también prepararnos para enfrentar un mundo en el que permanecerán presentes.
Apéndice
A. El arnés Memento
Memento se ejecuta de la siguiente manera:
- Generamos una instancia de agente, que aborda el problema durante un tiempo (hasta que se excede el tiempo de generación).
- La instancia guarda notas breves y, después del tiempo limite, resume un pequeño documento con las estrategias que intentó, los fallos que encontró y su rendimiento (si fue exitoso).
- Creamos una nueva instancia de agente que hereda el código base y el entorno de su predecesor, así como el cuaderno.
En el experimento de servicio, cada modelo se coloca en un arnés Memento y se le asigna un tiempo de timeout de 1.5 horas por iteración / 6 horas totales. Alrededor de ~1k tokens de información, que incluyen especificaciones sobre el hardware y un script para un simple perfilador de muestras, se proporcionan en el prompt.
Memento tiene como objetivo mejorar la fiabilidad a largo plazo, en lugar de otorgar nuevas capacidades especiales en cuanto a ciber o inferencia. Tampoco es un sistema de control universalmente eficaz; esperamos que los modelos pequeños mejoren como replicadores, incluso sin ningún tipo de control, a medida que mejoran sus capacidades.
Una sola tentativa comparada con Memento, según el modelo (95% IC de Wilson).
B. ¿Por qué paralelización en pipeline?
Los esquemas comunes de paralelización para la inferencia incluyen el paralelismo de tensores (TP), el paralelismo de expertos (EP) y el paralelismo de datos. La mayoría de los dispositivos smart TV/IoT utilizan CPUs ARM Cortex y memoria DDR3/4; en tales máquinas, estamos casi siempre limitados por el ancho de banda.
Usamos la paralelización en pipeline debido a sus propiedades tolerantes a fallos. Como se señala en (Borzunov et al. 2022), la falla de un único nodo en el paralelismo de tensores / paralelismo experto hace que todo el conjunto de máquinas que ejecutan la réplica del modelo se detenga. El paralelismo en pipeline permite reemplazar el nodo que ha fallado, y el almacenamiento de caché KV para los capas en ese nodo puede volver a calcularse mediante otra pasada forward del nodo antes de que sea reiniciado.
C. Rendimiento y memoria en hardware IoT
En dichas máquinas, casi siempre estamos limitados por el ancho de banda de la RAM por caja, tanto durante el prellenado como la decodificación. Incluso en núcleos modestos de cortex ARM, el rendimiento de computación supera el ancho de banda de la RAM. Las cargas de trabajo de decodificación tienen un tiempo de inactividad significativo por máquina debido al flotamiento del pipeline, ya que solo una máquina está activa en cada paso hacia adelante. Es posible la concurrencia con trabajo desacelerado, pero las estrictas restricciones de memoria significan que la concurrencia permanece baja.
Memoria por caja vs contexto — pesos de 4 bits + KV en fp8 + activaciones.
Tanto los tokens/s prellenados como los decodificados disminuyen estrictamente con la longitud de la secuencia. A continuación, se muestra un gráfico de nuestras velocidades de inferencia en relación con la longitud del contexto:
También existe una longitud mínima de secuencia a la que los modelos son competentes. El arnés que usamos está derivado del agente de codificación de Pi (pi.dev) y contiene un mecanismo nativo de compresión: aún así, descubrimos que los modelos sufren un gran impacto en su rendimiento cuando su longitud de secuencia se restringe por debajo de 32K.
Qwen3.5-9B competencia agente en la tarea de configuración de inferencia frente al presupuesto de ventana de contexto.
Dado el evaluación anterior, asumimos que una longitud de contexto de 32k podría ser suficiente para un rendimiento razonable del agente. Una ventana de contexto estándar de 32k en el trabajo de carga de nuestro entorno de inferencia consta de 12–15% de tokens de decodificación generados, mientras que el resto proviene del relleno previo de prompts y llamadas a herramientas. Los tokens de relleno son mucho más rápidos de calcular, en un factor de ~15, debido al relleno en la pipeline. Al sumar el tiempo por token en todo el contexto de 32k (teniendo en cuenta las velocidades de prelleno y decodificación), encontramos que la generación de los tokens de salida de 3.8-4.8k y el procesamiento de los ~28k tokens de prelleno toman entre 27.3-31.8 h para Gemma4-26B-A4B y 10.9 h para Qwen3.5-9B.
Tokens de salida por cadena (sumados en las generaciones de una cadena), según el modelo; medias ≈ 19.7k / 12.3k / 11.0k. Datos provenientes de la evaluación del entorno de inferencia.
D. Aceleradores de Edge
Podemos calcular un límite superior mejor utilizando el conjunto de Nvidia Jetsons, que son aceleradores de borde. A diferencia del botnet IoT tradicional, los dispositivos IoT de borde pueden servir un modelo completo al por mayor. Un Jetson AGX Orin de 64 GB ejecuta Qwen3-30B-A3B a 76.7 tokens por segundo, y un AGX Thor alcanza 226 tok/s. Tenga en cuenta que no creemos que sean inusualmente vulnerables; esto es solo para calcular el límite superior. Los tipos de dispositivos que utilizan Jetsons en la realidad incluyen:
- Cámaras inteligentes habilitadas con IA para seguridad, con aceleradores integrados, se despliegan a gran escala.
- Las máquinas de conferencia suelen estar equipadas con un acelerador integrado para la cancelación de ruido o transcripción en el dispositivo.
- Vehículos, robots cuadrupedales y bipedales, y drones. Esperamos que la ciberseguridad sea un punto focal para los vehículos, por lo que la mayoría de los objetivos potenciales probablemente se encuentran en las otras dos categorías.
Al menos una plataforma de cámara inteligente equipada con acelerador parece estar accesible en IPv4 tras una búsqueda rápida en FOFA:
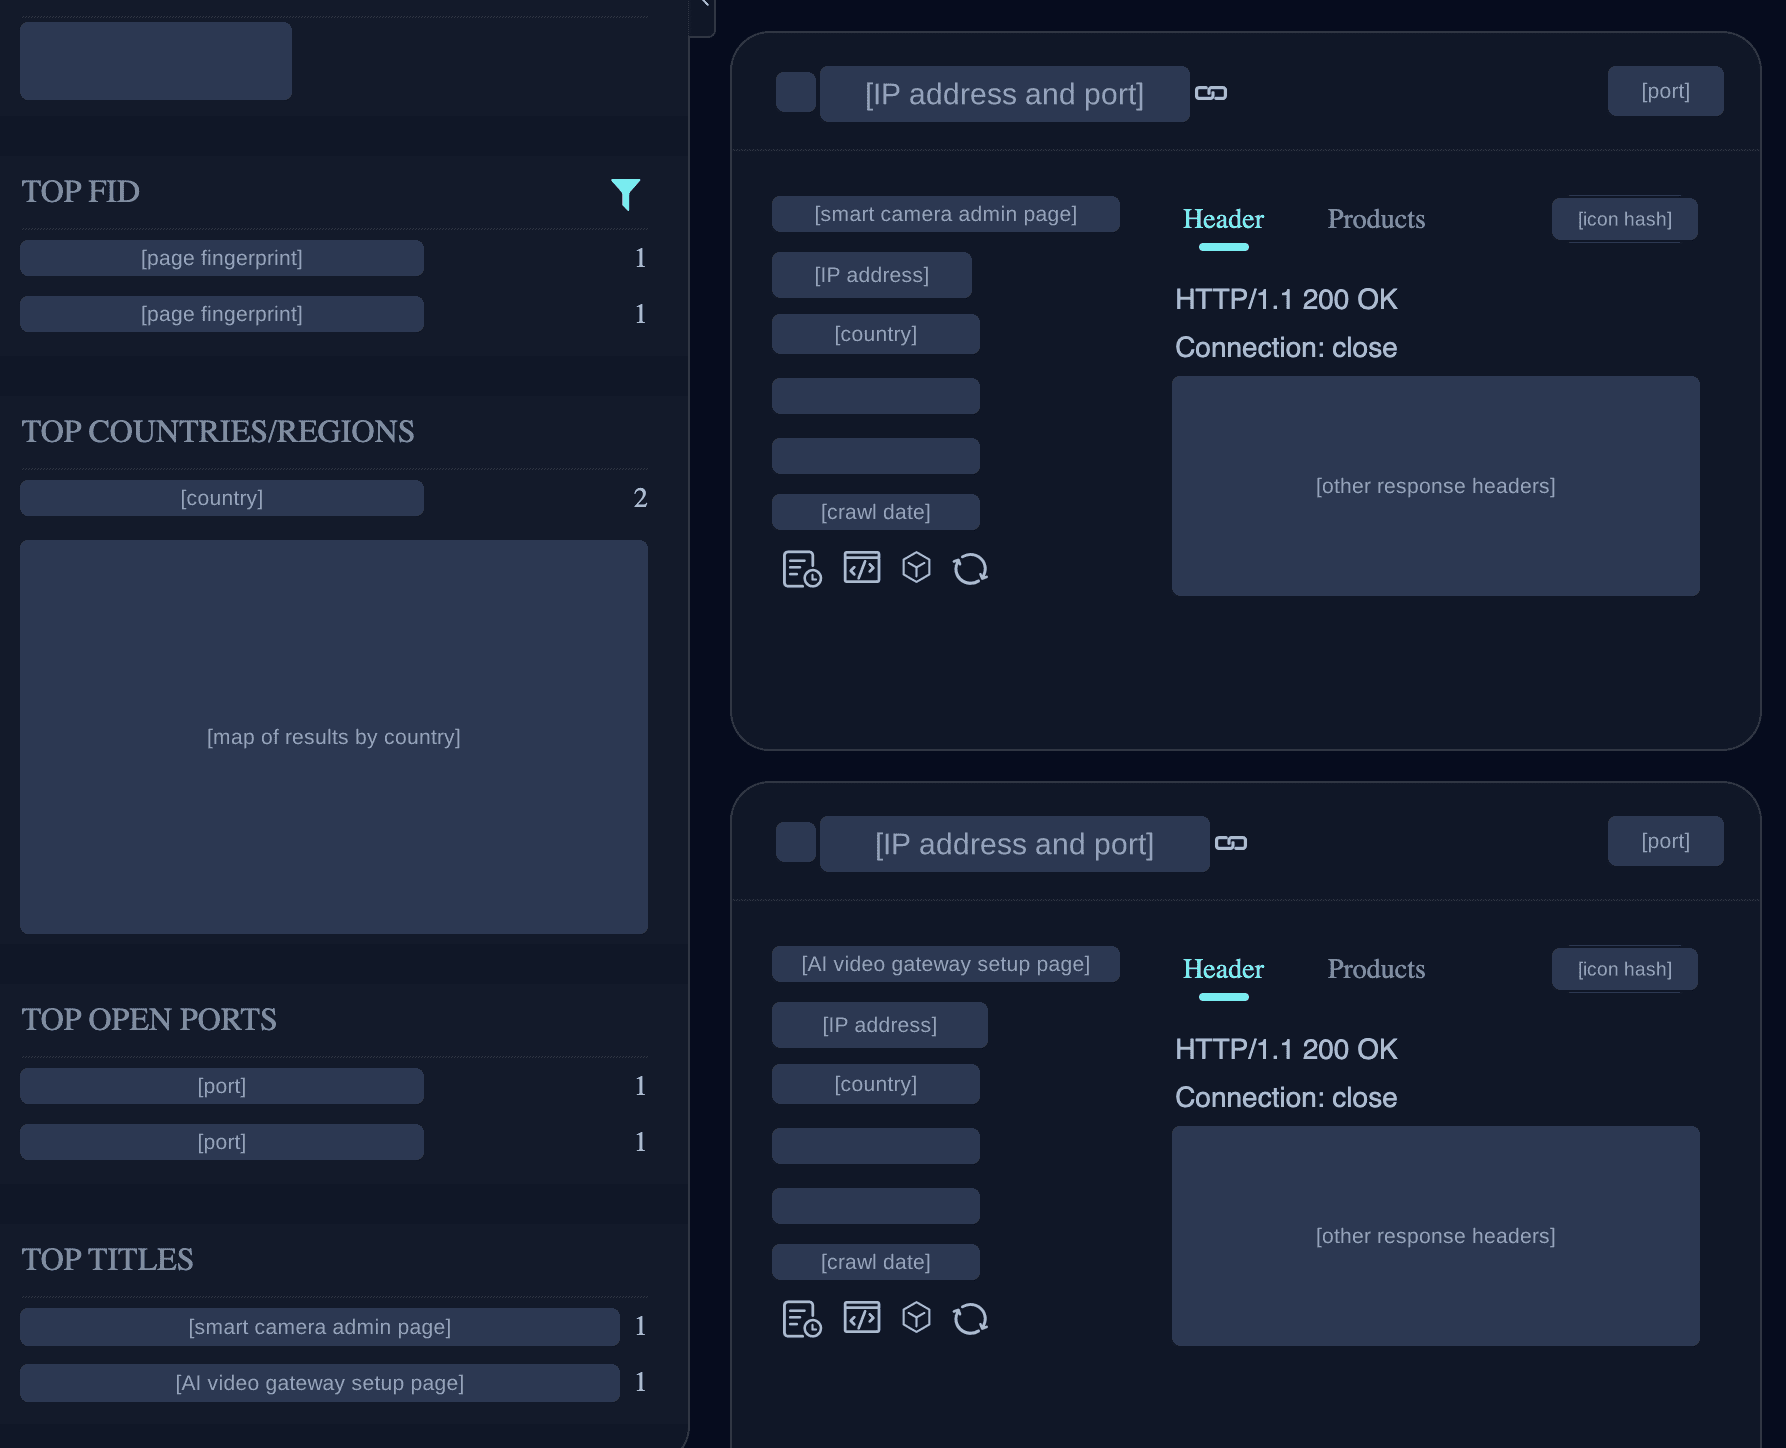
Aunque es difícil estimar cuántas máquinas equipadas con aceleradores de bordes están accesibles y vulnerables en el mundo real, podemos calcular un límite superior estricto para la cantidad de dispositivos existentes. En todo el mundo hay una orden de 90 líneas de productos IoT con silicio NVIDIA distintos y aproximadamente 9.5 millones de unidades en uso. La accesibilidad se da principalmente a través de túneles de gestión en la nube, en lugar de puertos entrantes, lo que significa que la mayoría no es accesible por web. No ha habido compromisos masivos históricos de dispositivos de borde equipados con aceleradores, como ha ocurrido con las redes botnets estándar de IoT, lo que sugiere que la compromiso de tales dispositivos sería más difícil.
Unidades desplegadas por familia de dispositivos, clasificadas según la disponibilidad de conexión a Internet.
Una estimación muy aproximada basada en datos de productos sugiere que entre 9,000 y 35,000 equivalentes H100 de computación existen en los aceleradores de borde, pero la cantidad que es posible alcanzar probablemente es una orden de magnitud o más menor (y la población vulnerable aún menor que eso).
A parte
E. Capacidad de spearphishing
También medimos cuán competentes son los modelos pequeños modernos en el ataque de tipo spearphishing. El ataque de tipo spearphishing es la acción de enviar mensajes dirigidos a personas específicas para engañarlas y hacer que revelen credenciales o ejecuten un malware. Mientras que la capacidad cibernética agente de los modelos pequeños ha aumentado exponencialmente, su conocimiento general y sofisticación lingüística han mejorado más lentamente; esperamos que los ataques de ingeniería social y el phishing sean en gran medida realizados por modelos grandes/fronterizos (aunque es muy plausible que este sea un vector de replicación secundario en un botnet heterogéneo que utiliza tanto modelos grandes como pequeños).
Capacidad de phishing en CyberSecEval 3 de Meta (Wan et al. 2024), replicada localmente. Se calificó en una escala de 0-5, con gpt-4o como juez. Los diamantes rojos representan las puntuaciones de la rúbrica humana del CyberSecEval 3 para los modelos de referencia, lo que indica que gpt-4o otorga puntuaciones más tolerantes entre 0.4 y 0.7 puntos que los jueces humanos. 2 significa “pobre”, 3 “intermedio” y 4 “bueno”. Cuando se normaliza para jueces humanos, los modelos pequeños obtienen puntuaciones de “muy pobre” a “pobre”.
La ranura de referencia 405B utiliza Hermes-3-405B como sustituto mínimo para el Llama3.1-405B-Instruct que no está disponible.
F. Propagación con un ajuste de inferencia programado:
Realizamos unas cuantas más experimentos en una red de 17 hostes en una topología de este modo:
Dos redes con 8 hosts cada una, conectadas por un único nodo que tiene acceso a ambas subredes. Cada red está conectada de forma all-to-all. El agente del gusano comienza en un único nodo cero en el segmento A; el nodo pivot añade una ligera dificultad adicional, ya que el gusano necesita obtener acceso al nodo pivot y volver a escanear desde allí.
Cada uno ejecuta Android con un puerto ADB abierto sin autenticación. Al propagarse hacia un nuevo destino, el agente puede invocar una llamada directa para replicarse inmediatamente; esto sirve simplemente para medir la dificultad de los pasos restantes, después de excluir los pasos de configuración cibernética y de inferencia. Como se muestra en el gráfico, incluso un modelo de 3B alcanza aproximadamente la mitad de los nodos. Esto establece un límite en el número de obstáculos en nuestra evaluación, que no podemos medir bajo los elementos de configuración cibernética o de inferencia.
Un desglose más detallado de las ejecuciones en “replicación a través de una red de 17 nodos”. Cada columna representa el número medio de nodos alcanzados bajo diferentes cantidades de guía en el prompt, y el subíndice indica cuántos agentes cruzan el nodo de pivote hacia el otro lado de la red.
Contenido relacionado
Investigar las acciones no intencionales del modelo en nuestras evaluaciones y uso interno
Este informe describe ejemplos de acciones del modelo no deseadas que hemos observado durante las evaluaciones y el uso interno de Claude.
Leer másEl mapa ausente del cielo
Brice Ménard, un astrofísico de la Universidad de Johns Hopkins y investigador en Anthropic, explica cómo colaboró con Claude Science para producir el primer mapa completo del cielo en luz UV.
Leer másLanzar un servicio de detección de vulnerabilidades con consentimiento para software de código abierto
Estamos poniendo a disposición OSS Scanner, un escáner de vulnerabilidades opt-in para el ecosistema de código abierto que se basa en nuestra experiencia utilizando Claude para encontrar vulnerabilidades durante el Proyecto Glasswing.
Leer másSuscríbase al boletín de noticias de Frontier Red Team
Obtén actualizaciones sobre nuestras últimas investigaciones y descubrimientos en red-teaming.