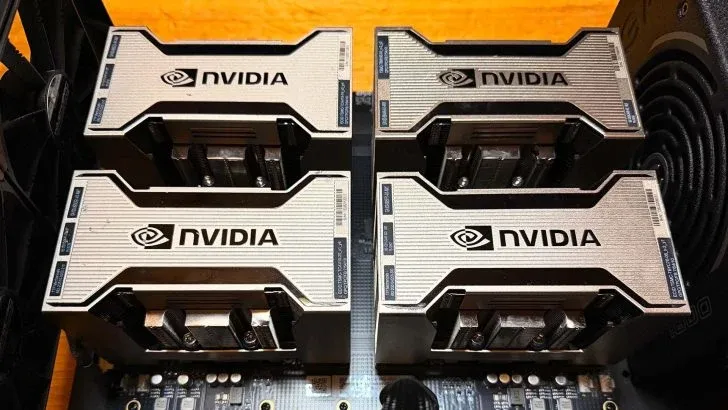
IT之家 El 13 de octubre, el canal de YouTube Jun Yamog publicó un video ayer (12 de octubre) en el que probó la instalación de 4 unidades de Tesla V100 en una placa de transporte NVLink. En el estándar Qwen3.8-Flash-Next, la velocidad de procesamiento de prompts largos es 230% más rápida que la del M5 Ultra y 40% más rápida que la de 2 unidades DGX Spark.
Según información pública consultada por IT Home, el Tesla V100 es una GPU para centros de datos desarrollada por NVIDIA en 2017, basada en la arquitectura Volta, y se utiliza comúnmente para el entrenamiento y razonamiento de IA. Su versión de 32 GB cuenta con memoria visual HBM2, y el ancho de banda de 900 GB/s permite la lectura rápida de parámetros y datos de modelos grandes.
NVLink es una tecnología de interconexión rápida de GPUs de NVIDIA que permite la transmisión directa de datos entre múltiples GPU. En comparación con la comunicación por PCIe, NVLink puede reducir los cuellos de botella de interconexión y se utiliza comúnmente en servidores con múltiples GPU y clústeres de cálculo de IA.
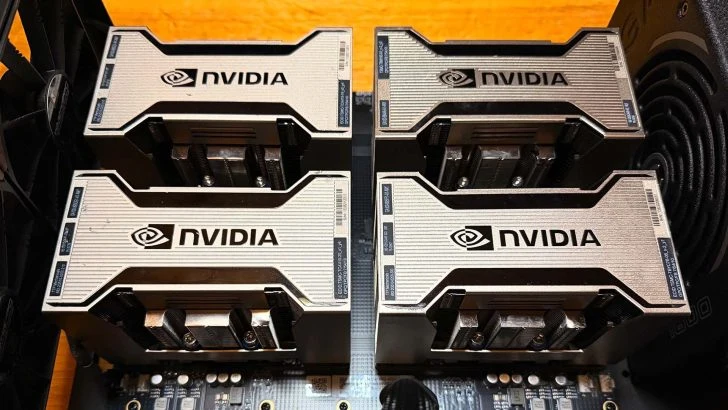
La placa de carga NVLink ofrece una banda ancha de 300GB/s y está equipada con 6 conexiones NVLink 2.0. Para albergar 4 GPU independientes, el probador modificó el radiador NVIDIA A100, permitiendo que emita una potencia de consumo de aproximadamente 300W por cada V100, y conectó la placa de carga mediante un interfaz PCIe x8.
El presentador utilizó el modelo Qwen3.8-Flash-Next cuantificado en 4 bits, y los objetos de comparación incluyeron 2 dispositivos DGX Spark equipados con memoria unificada LPDDR5X de 128 GB, así como el dispositivo Mac Studio equipado con la chip M5 Ultra.
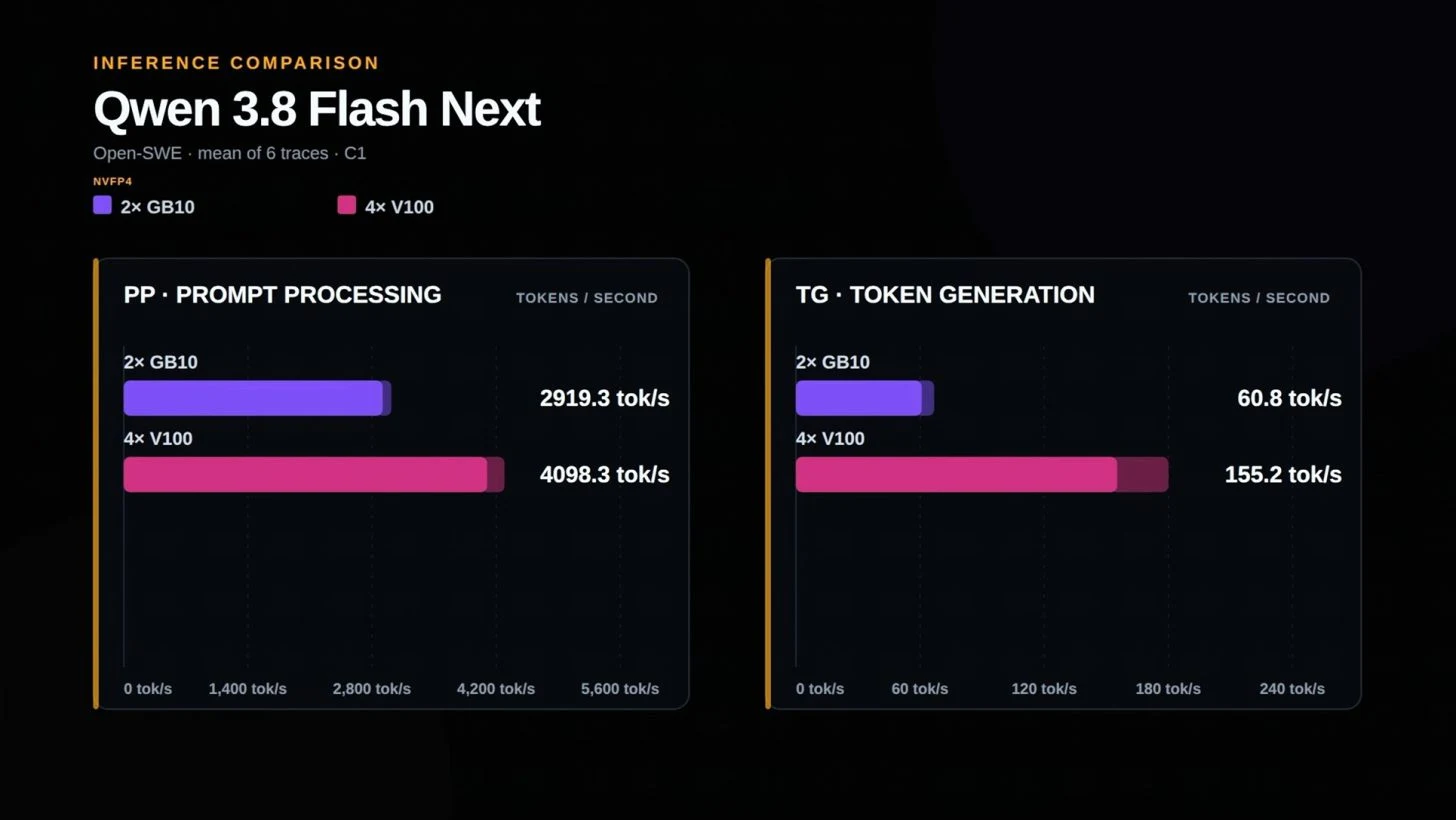
En los pruebas de procesamiento de prompts largos, el clúster de 4 unidades V100 es un 40% más rápido que el DGX Spark, y un 230% más rápido que el M5 Ultra. Los probadores señalaron que la gran diferencia con Apple Silicon podría estar parcialmente relacionada con una insuficiente optimización de software.
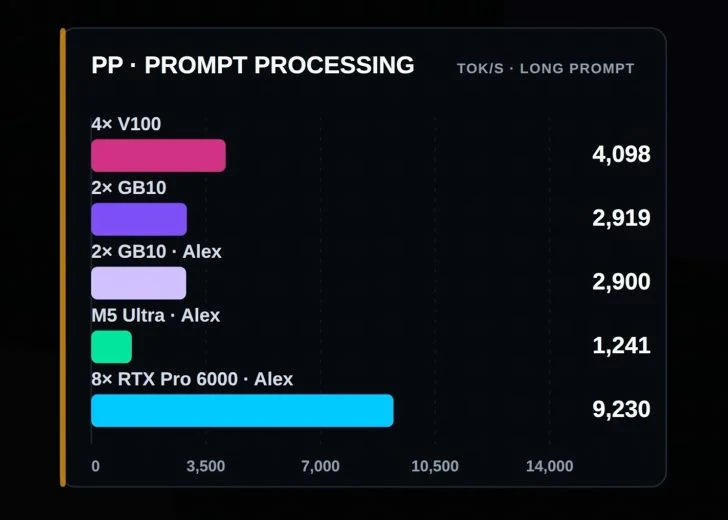
En los tests de procesamiento de breves instrucciones, el clúster V100 mantiene una ventaja de velocidad del 40% en comparación con DGX Spark, y es 163% más rápido que M5 Ultra. Este resultado demuestra que las GPU de los centros de datos antiguos todavía tienen una alta capacidad de consumo en cargas de razonamiento específicas.
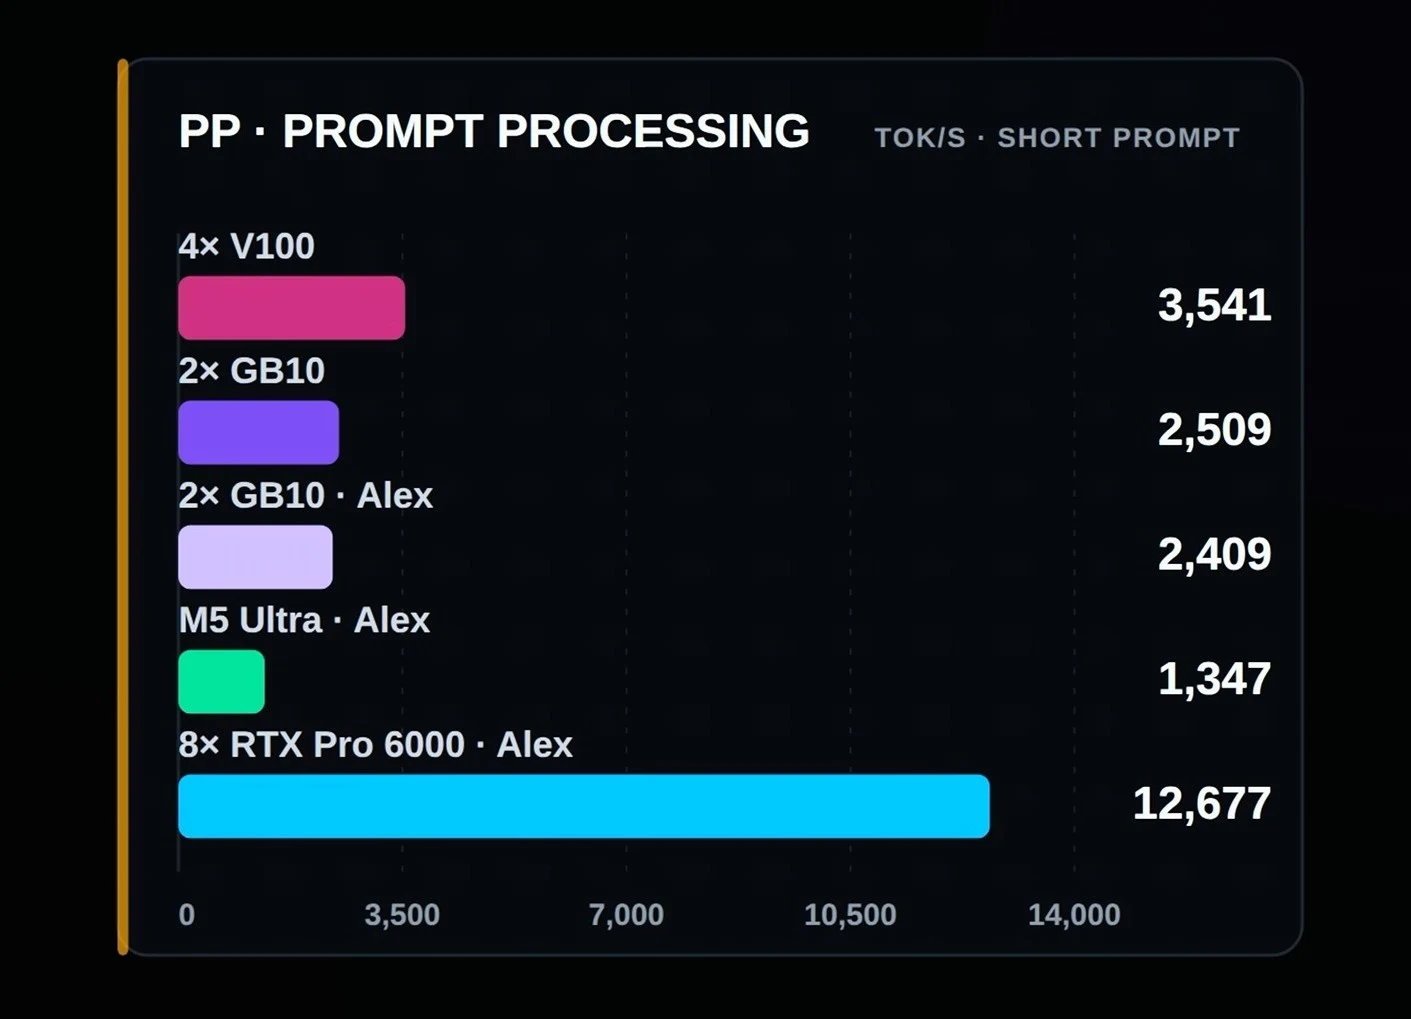
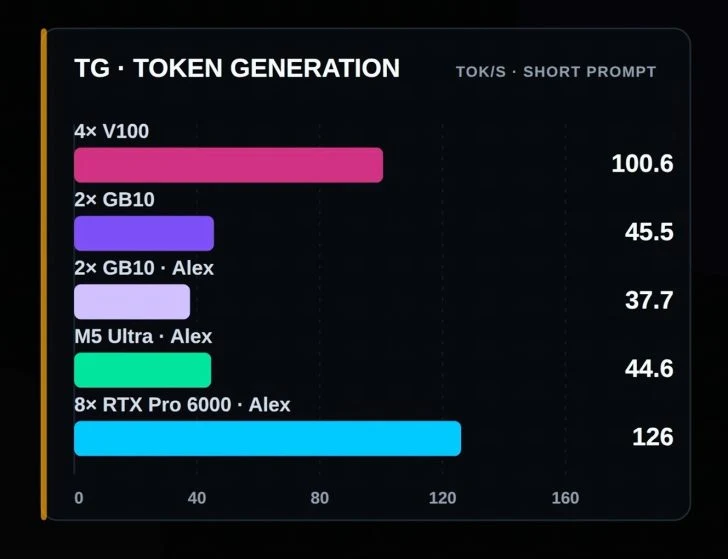
En el test de generación de tokens de breve indicación, 4 unidades V100 alcanzaron 100.6 tok/s, lo que representa un aumento del 121% en comparación con 2 unidades DGX Spark; el rendimiento de M5 Ultra fue de 44.5 tok/s.