
Conclusiones clave
- Construir agentes de larga duración requiere una gestión constante del contexto, y tomar esas decisiones con un LLM de frontera es lento y costoso. Los modelos de decodificación restringida (CDM) de ScaleDown los hacen más rápidos y baratos.
langchain-scaledownfacilita el uso de modelos ScaleDown en tu agente e incluye middleware para resumen, compresión de resultados de herramientas y extracción.- ScaleDown ahora es compatible en el LangSmith LLM Gateway, por lo que sus llamadas se rastrean y cuentan para su gasto y sus límites de frecuencia.
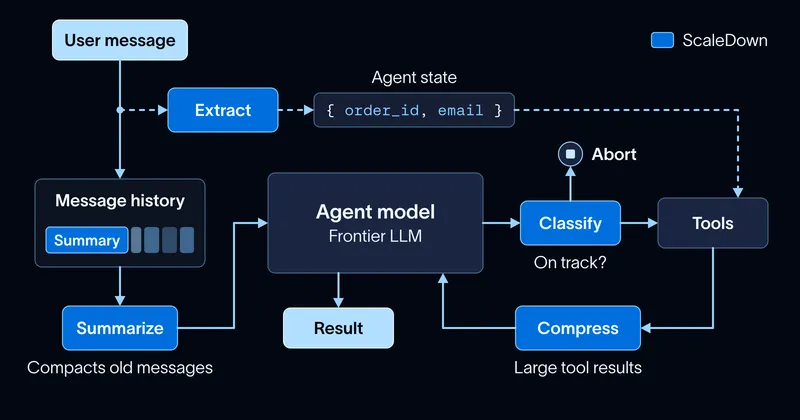
Construir agentes de larga duración se reduce al arte de la gestión del contexto: decidir qué información entra en la ventana de contexto, y cuándo. Eso significa resumir el historial antiguo, compactar los resultados grandes de las herramientas y extraer los datos correctos de entradas largas. Cada uno de esos pasos es una decisión. Históricamente los hemos tomado con LLMs, lo cual es lento y costoso al volumen que un agente de larga duración necesita.
Para tomar esas decisiones de forma más rápida y barata, ahora tenemos una langchain-scaledown integración y soporte en el LangSmith LLM Gateway para los modelos de decodificación restringida (CDMs) de ScaleDown. Mientras que un LLM de propósito general escribe cualquier cadena un token a la vez, un CDM está entrenado para una sola tarea y solo devuelve respuestas que esa tarea permite, como una etiqueta de tu lista o tramos del texto de entrada. Eso le permite ser mucho más pequeño, rápido y barato: ScaleDown informa que sus modelos son 200x más rápidos y 467x más baratos que los modelos frontera en estas tareas estrechas.
La integración incluye tres middlewares para LangChain y Deep Agents: uno resume el historial antiguo, uno comprime los resultados grandes de las herramientas y otro extrae datos estructurados de la conversación. En esta publicación, cubrimos qué son los modelos de ScaleDown y cómo usarlos para reducir el contexto de tu agente.
¿Qué modelos ofrece ScaleDown?
ScaleDown tiene cuatro modelos, cada uno entrenado para una sola tarea, por lo que cada uno puede ser mucho más eficiente que un LLM de propósito general:
- Summarize escribe un resumen breve de un texto largo.
- Compress reduce un bloque de contexto a las partes relevantes para una pregunta.
- Extract extrae los campos que describes de un texto, cada uno con una puntuación de confianza y su posición en la fuente.
- Classify evalúa el texto frente a etiquetas que tú defines y devuelve una probabilidad para cada una. Puedes decidir si se devuelve una razón en lenguaje natural que explique por qué se tomó la clasificación.
Cada modelo admite hasta 1M de tokens de entrada, así que un contrato completo, una página de política extensa o una hora de historial de agente caben en una sola llamada sin fragmentación. Además son multimodales: Extract, Summarize y Classify aceptan directamente imágenes y PDF escaneados además de texto no estructurado, de modo que una captura de pantalla o una factura escaneada funcionan como entrada.
En los propios benchmarks de ScaleDown, medidos contra el promedio de GPT-5.5, GPT-5.4 Mini y GPT-5.4 Nano en conjuntos de datos públicos, Summarize es 41 veces más barato y 2.7 veces más rápido, y Compress es 138 veces más barato y 1.8 veces más rápido, obteniendo al mismo tiempo una mayor precisión en ambos.
Si has usado un modelo de decisión como Jev, ScaleDown Classify te resultará familiar: ambos devuelven una respuesta tipificada con una probabilidad. Jev acepta solo texto, hasta 32K de tokens de estado por pregunta. Classify admite hasta 1M de tokens, imágenes incluidas, y añade una razón de una sola frase a cada decisión. Cuando un agente enruta un ticket o detiene una ejecución según una etiqueta, la razón te indica por qué, lo que facilita depurar el agente.
Resumen del historial de mensajes
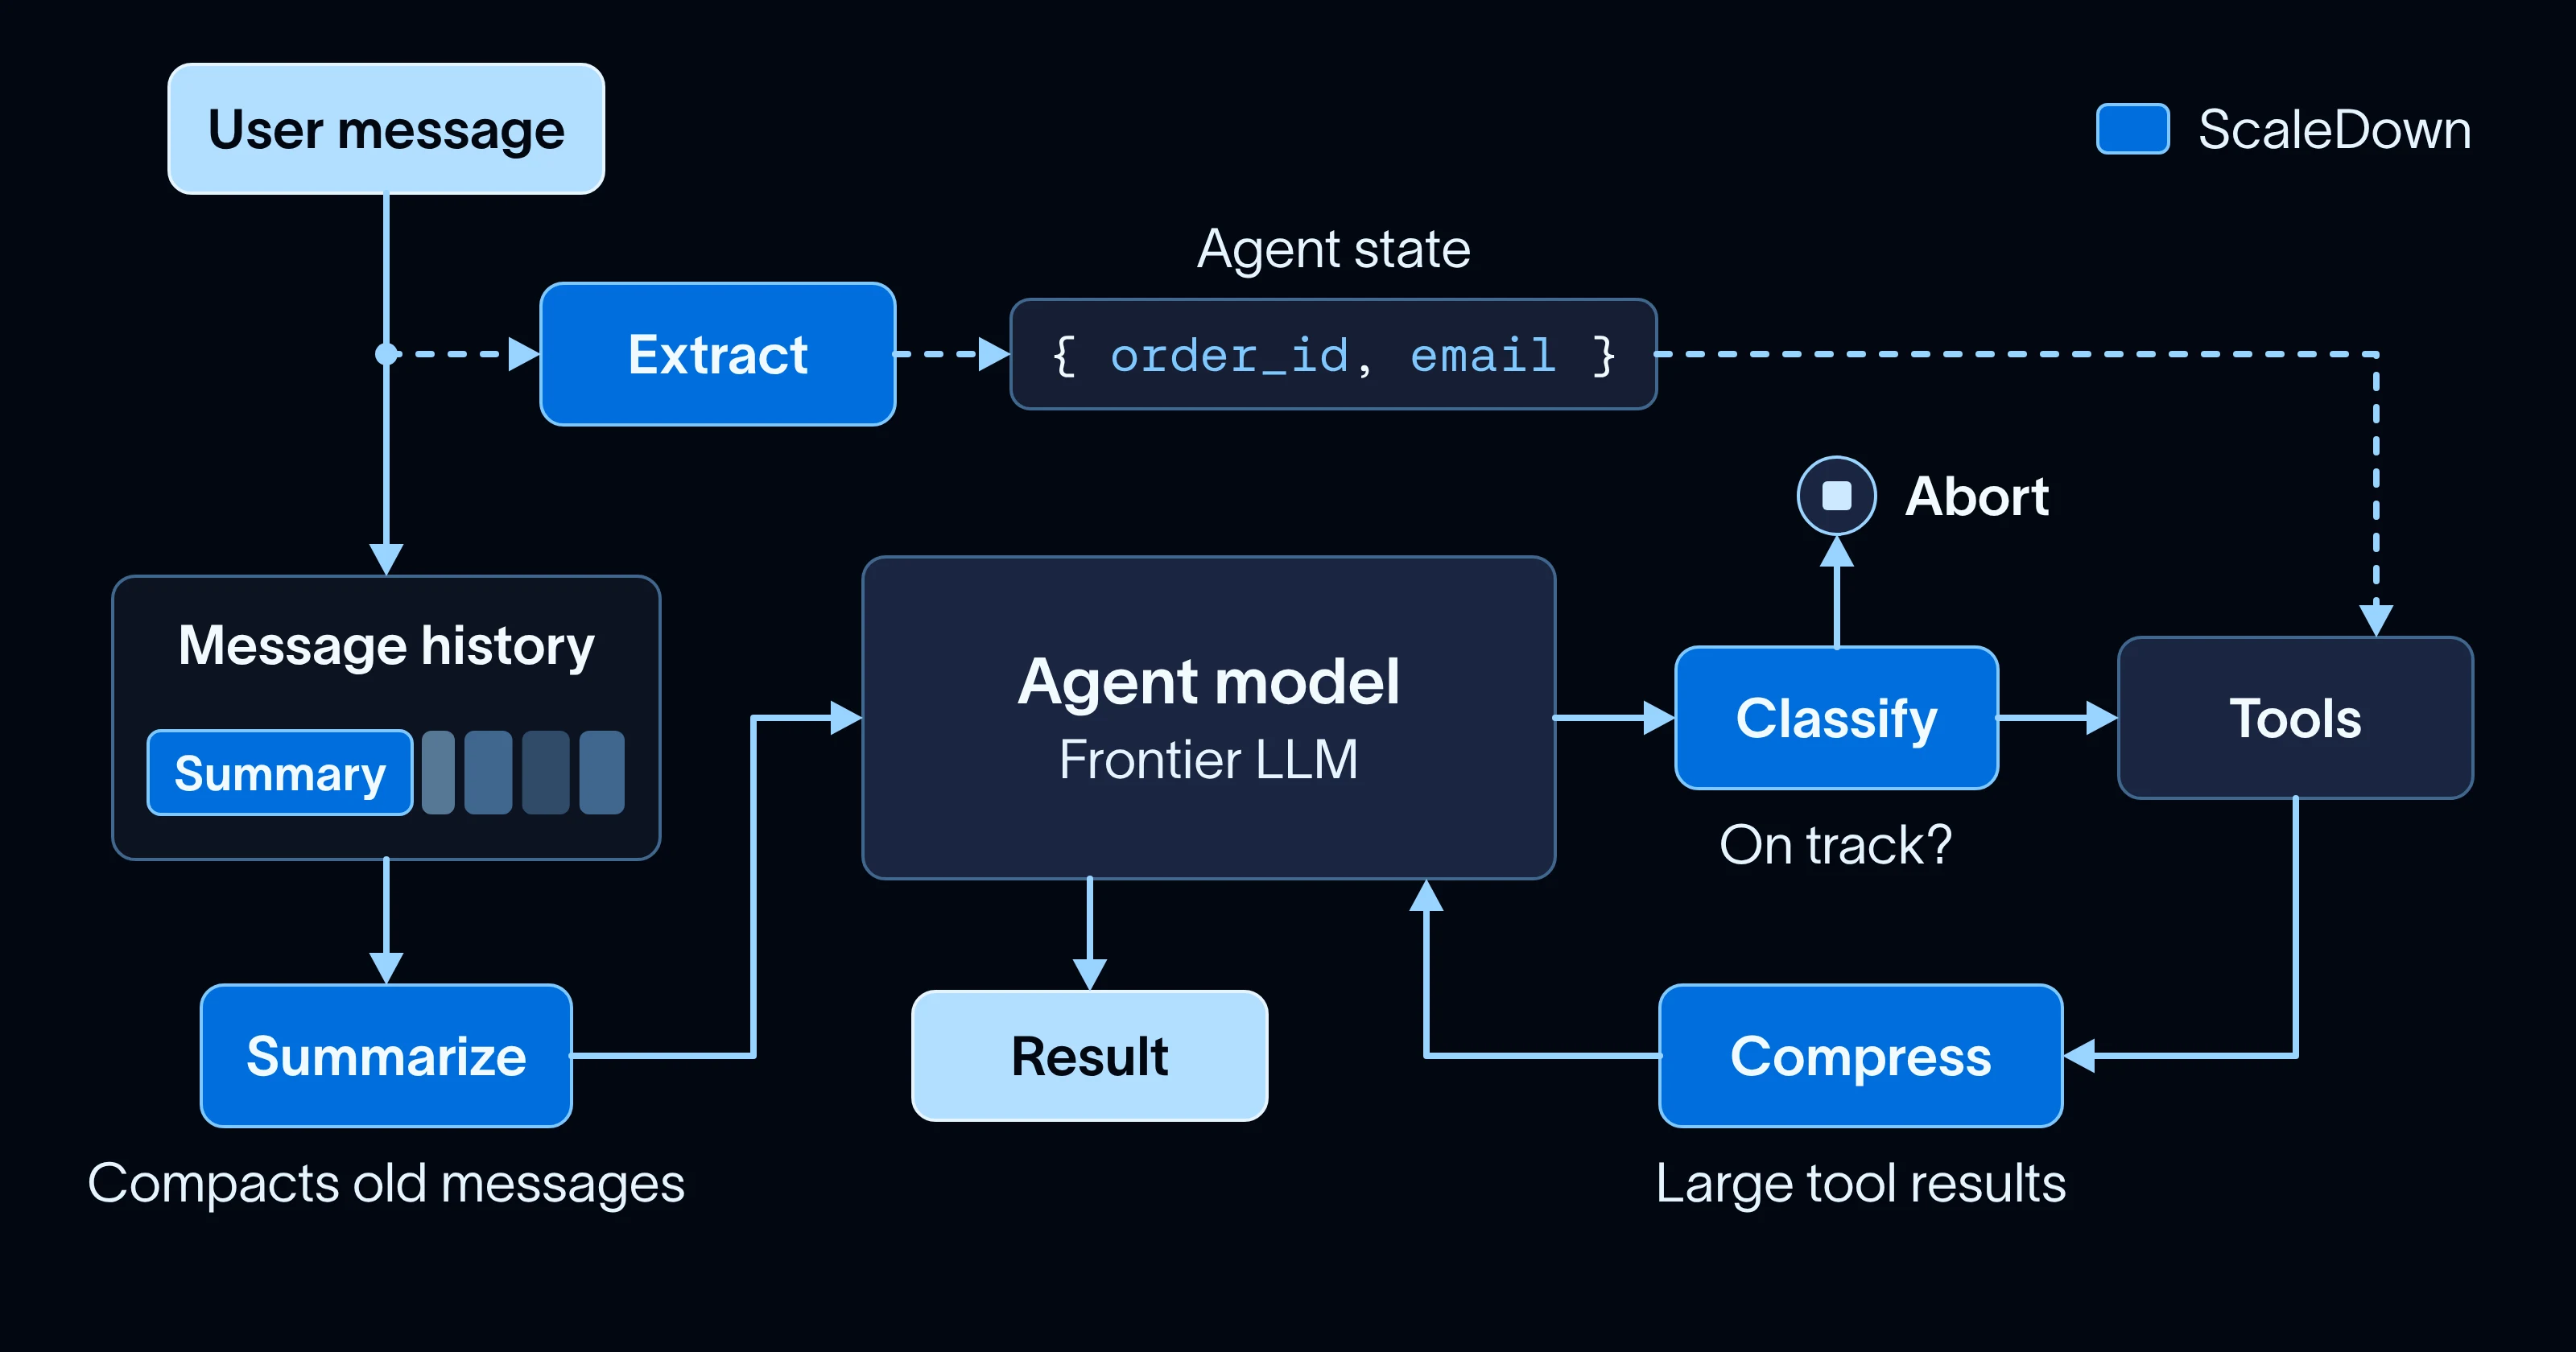
Los agentes de larga ejecución necesitan resumir porque su historial eventualmente supera la ventana de contexto. Un agente de programación que ha estado trabajando durante una hora tiene docenas de lecturas de archivos y salidas de herramientas en su historial, la mayoría de las cuales ya no necesita textualmente. Resumirlos con otra llamada a un modelo frontera añade coste y latencia cada vez que el historial se llena.
ScaledownSummarizationMiddleware reemplaza el middleware de resumenintegrado de Deep Agents. Acepta las mismas opciones de trigger y keep para decidir cuándo resumir y qué mensajes recientes conservar, y ScaleDown escribe el resumen:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
El agente conserva su propio modelo para planificar y escribir código. Solo el resumen pasa a ScaleDown, que por defecto devuelve las mismas secciones que el prompt de resumen de LangChain (intención, resumen, artefactos y próximos pasos). Si una llamada a ScaleDown falla, el middleware deja el historial como está y el agente sigue ejecutándose. El mismo middleware funciona con create_agent.
Comprimir resultados de herramientas
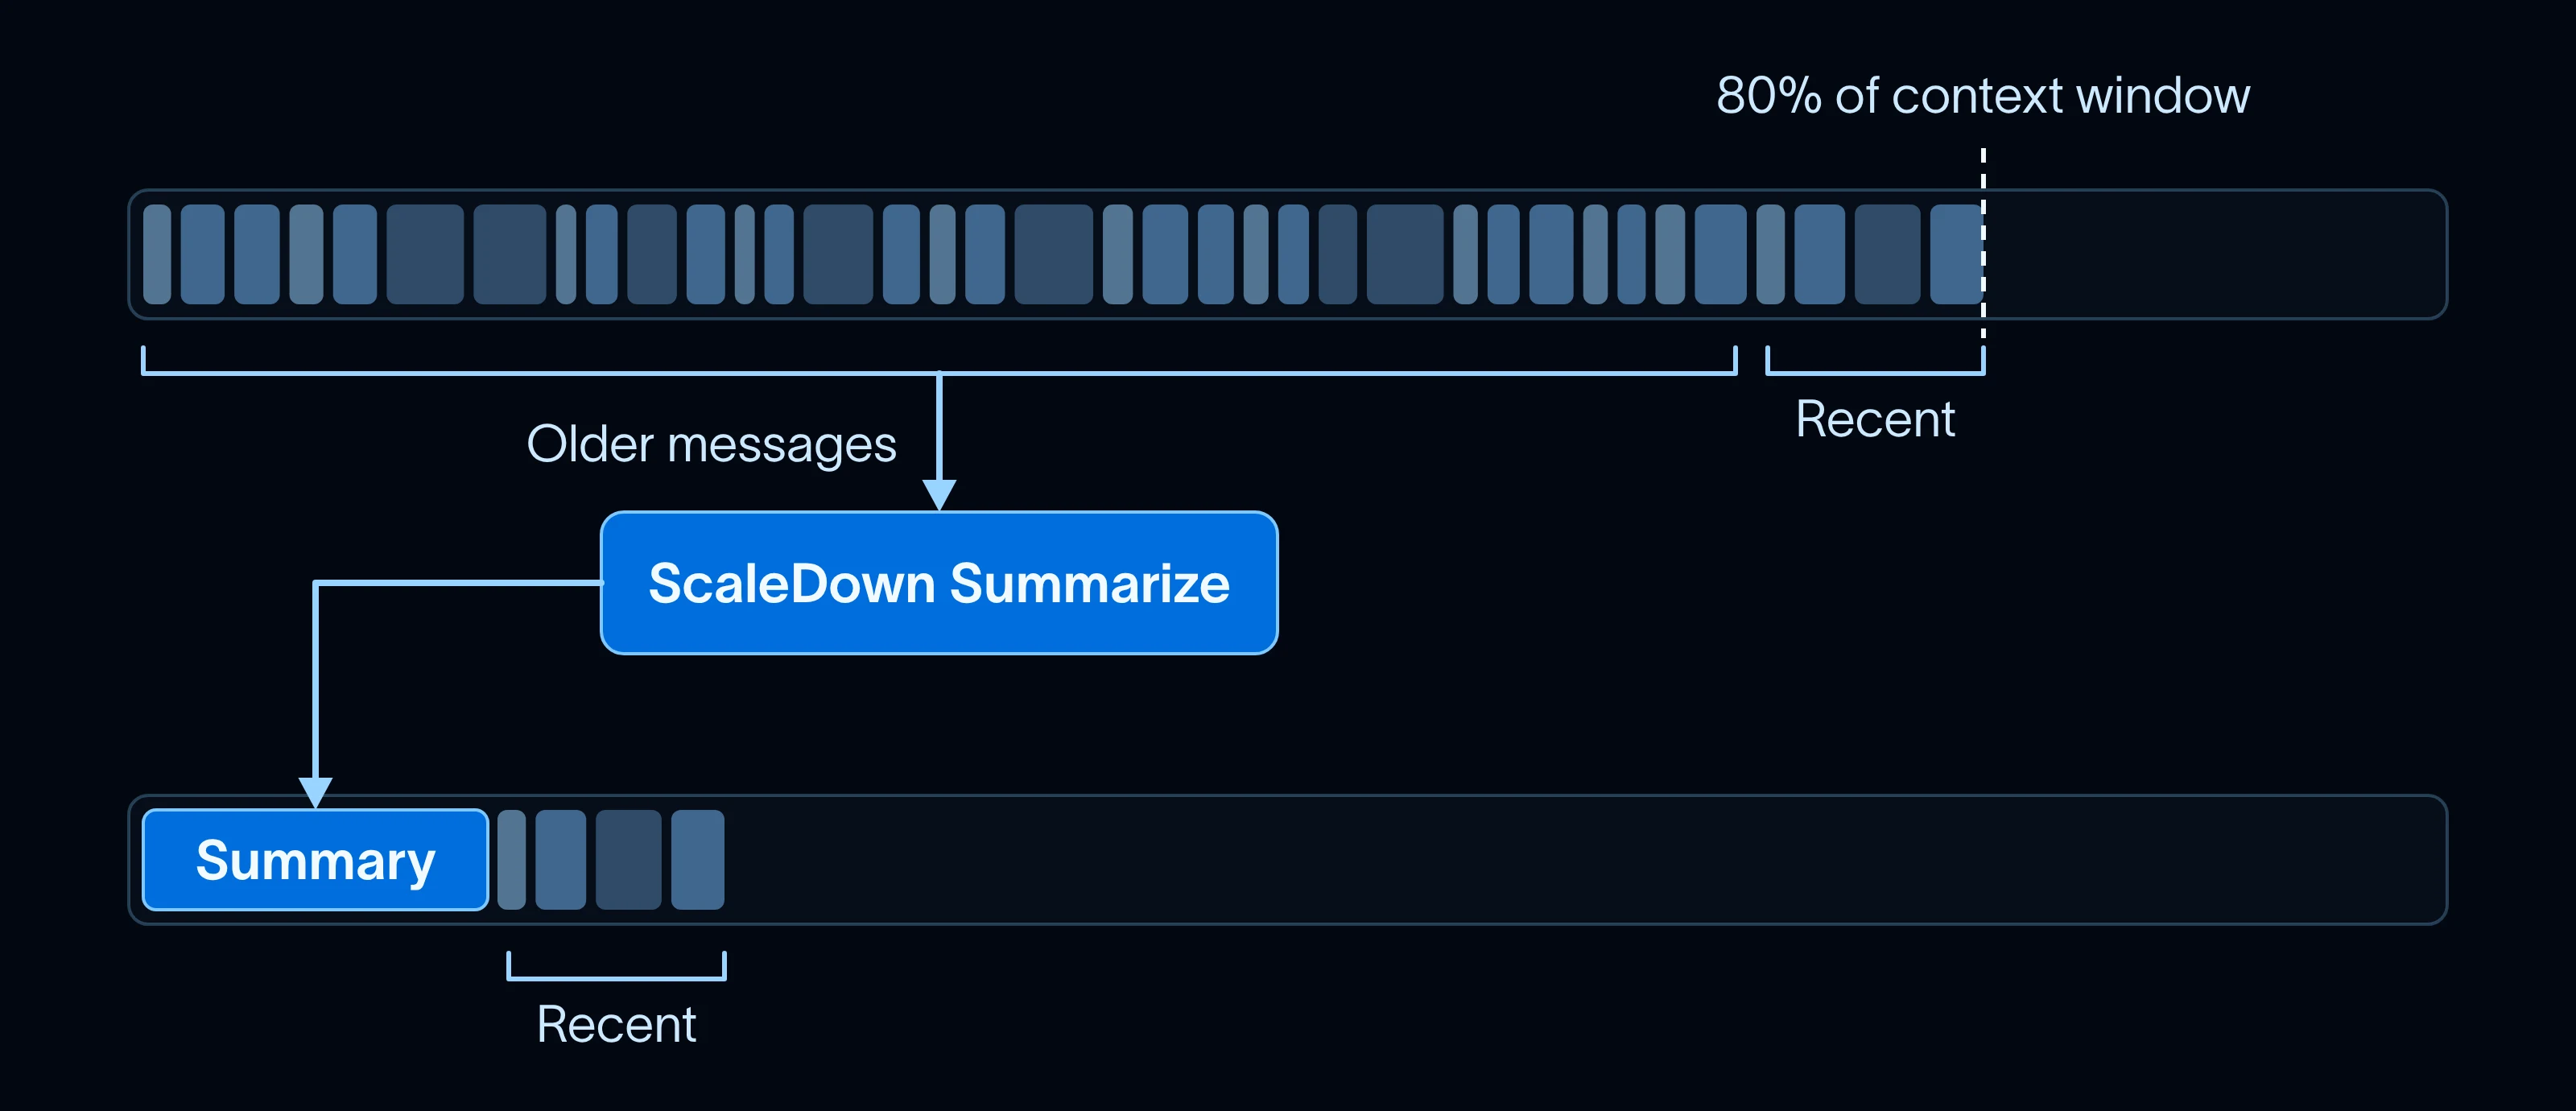
Los agentes de larga duración llaman a muchas herramientas, y cada resultado grande permanece en el contexto durante el resto de la ejecución. Una página web obtenida puede llegar a decenas de miles de caracteres cuando el agente solo necesita un párrafo de ella. Cada paso posterior paga de nuevo por esos tokens, y el agente empeora en mantenerse en la tarea a medida que su contexto se llena.
ScaledownToolCompressionMiddleware añade un parámetro opcional compression_query a tus herramientas. Cuando el modelo solo necesita parte de un resultado, lo indica en compression_query en la llamada a la herramienta, por ejemplo "refund policy for EU orders". El middleware lo elimina antes de que se ejecute la herramienta, y luego ScaleDown comprime la salida a las partes relevantes antes de que el modelo la vea:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
Tus herramientas no cambian, por lo que esto funciona con cualquier herramienta, incluidas las herramientas MCP. En este trazo, ScaleDown redujo una larga página de documentación en casi un 90% antes de que el modelo la viera. El resultado comprimido comienza con una nota como esta, de modo que el modelo pueda volver a llamar a la herramienta sin compression_query si necesita la página completa:
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
Extraer datos estructurados
Los agentes extraen constantemente valores específicos de lo que leen, como un ID, una fecha o un campo que necesita la siguiente llamada a una herramienta. Esa extracción ocurre dentro del bucle del agente, por lo que debe ser lo suficientemente rápida como para no añadir latencia a cada turno, y lo suficientemente exacta como para que una herramienta pueda usar el valor tal cual.
Por ejemplo, antes de que un agente de soporte pueda presentar un ticket, necesita el número de pedido, el mensaje de error y el correo electrónico del cliente. El modelo principal podría completar esos datos como argumentos de la herramienta, pero podría parafrasear un código de error o escribir mal una dirección de correo electrónico en lugar de copiarla exactamente.
ScaledownExtractionMiddleware entrega este paso a ScaleDown. Describes cada campo en lenguaje natural, y Extract copia el valor del texto. Un campo también puede ser un conjunto de etiquetas, al que ScaleDown responde con Classify, de modo que el ticket pueda enrutarse por tipo de problema. Antes de la primera llamada al modelo de una ejecución, el middleware envía los mensajes del usuario a Extract y guarda los campos en el estado del agente bajo scaledown_extraction, donde tus herramientas pueden leerlos:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
Extract solo lee los mensajes del usuario, nunca las respuestas del agente, por lo que cada valor es algo que el cliente dijo realmente. Con un checkpointer, la extracción se vuelve a ejecutar en cada turno, por lo que el registro se completa a medida que el cliente añade detalles. Para "El pedido A-1042 falló con ERR_PAYMENT_DECLINED. Ya probé con otra tarjeta.", los campos regresan como:
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
Clasificación deriva
Un agente decide su siguiente paso en función de su estado actual, como si la tarea está terminada o si la última llamada a la herramienta funcionó. Clasificar ese estado ocurre en cada turno, por lo que debe ser barato y rápido.
Un estado que vale la pena detectar en agentes de larga ejecución es la deriva: repetir en bucle la misma llamada a una herramienta que falla, o quedarse atascado en un ciclo improductivo. No existe un middleware preconstruido para esto, pero puedes llamar a cualquier modelo de ScaleDown desde tu propio middleware personalizado. Aquí hay un cortacircuito que se ejecuta después de cada llamada al modelo, envía el historial a ScaleDown Classify y detiene la ejecución cuando se desvía del rumbo:
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
Classify devuelve una probabilidad para cada etiqueta, así que tú eliges el nivel de confianza necesario antes de que se dispare el cortacircuito. Su razón de una línea aparece en el mensaje final, de modo que puedes ver por qué se detuvo la ejecución. Una versión más suave no termina la ejecución en el primer disparo: añade la razón a la conversación como un empujón para cambiar de rumbo, y solo se detiene si el agente vuelve a derivar.
Estas cuatro secciones muestran algunos de los lugares donde encajan los modelos de ScaleDown, y la lista no es exhaustiva. Puedes combinarlos entre sí, como ejecutar extract / summarize sobre resultados largos de herramientas, o clasificación para el enrutamiento de modelos en tiempo de ejecución. Consulta ScaleDown Cookbooks para ver otras formas de usar los modelos CDM en diferentes tipos de datos.
ScaleDown en el LangSmith LLM Gateway
El LangSmith LLM Gateway le permite llamar a modelos de distintos proveedores con una sola clave de API de LangSmith, rastrea cada llamada y aplica sus límites de gasto y de tasa de solicitudes. ScaleDown ahora es uno de sus proveedores de acceso directo a modelos, en la /scaledown ruta.
Un administrador añade su clave de ScaleDown a los secretos de proveedor del espacio de trabajo como SCALEDOWN_API_KEY una vez. Luego apunte langchain-scaledown al gateway y autentíquese con su clave de LangSmith:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
Cada llamada a ScaleDown aparece entonces como un rastreo de LangSmith y cuenta para los mismos límites que sus otras llamadas a modelos.
Cuándo no usar ScaleDown
Mantenga un LLM de propósito general para la generación abierta, como escribir código, redactar respuestas y planificar. Esto sigue el enfoque de "barato por defecto, frontera por excepción" de nuestros Jev posts: usar un LLM grande de propósito general para las partes difíciles, y modelos especializados para los pasos de alto volumen que lo rodean.
ScaleDown es lo suficientemente rápido y barato para ejecutarse en cada turno, de modo que su agente puede tomar las decisiones estructuradas de las que depende la gestión del contexto sin ralentizar el bucle principal ni pagar precios de frontera por ellas. En un agente de larga ejecución, esas decisiones ocurren en casi cada turno, por lo que el ahorro se acumula rápidamente.
Empiece ahora
Instale la integración y configure su clave de API de ScaleDown:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
Las nuevas cuentas de ScaleDown reciben 50M de tokens gratis. The La documentación de integración de ScaleDown cubre las opciones de configuración de cada middleware. Pruébalo langchain-scaledown y cuéntanos qué te parece en el foro de LangChain, Xo GitHub.