
Puntos clave
- La búsqueda de IA ahora permite a los usuarios encontrar conversaciones basadas en la comprensión semántica de las huellas, como “¿el usuario se frustró?”. o “¿se filtraron datos personales sensibles?”.
- Describa un comportamiento en lenguaje sencillo, y un modelo de decisión rápido lee las huellas y devuelve aquellas en las que ocurrió.
- LangSmith utiliza trajectories para normalizar las trazas, reducir el exceso de contexto y entregar los resultados de la consulta de forma rápida.
Agente traces son grandes, multimodales y ricos en información. Capturan detalles clave como las entradas del usuario, cómo responden los agentes y los fallos lógicos. Esto hace que los traces sean especialmente valiosos para comprender el comportamiento del usuario y mejorar el rendimiento del agente, pero las plataformas de datos tradicionales no están diseñadas para manejar cargas de datos grandes y no estructuradas como estas.
Para que los datos de trazas sean útiles, los equipos necesitan una infraestructura que pueda soportar todo el ciclo de vida: ingerir y almacenar volúmenes elevados de ejecuciones, realizar consultas a las trazas de manera flexible y convertirlas en vistas para la depuración, el análisis de productos y los flujos de trabajo operativos, como anotaciones. Por eso hemos creado SmithDB, la base de datos diseñada específicamente para datos de trazas en LangSmith, y recientemente Custom Apps, que permiten a los equipos crear vistas personalizadas sobre sus trazas.
Hoy estamos añadiendo AI Search, una nueva forma de realizar consultas en trazas utilizando lenguaje natural.
¿Por qué creamos la búsqueda de IA?
Cada rastro contiene las entradas del usuario, el razonamiento del agente, las llamadas a herramientas y las respuestas, toda la información necesaria para entender dónde los agentes son eficaces y dónde fallan. Los equipos que usan LangSmith a menudo analizan sus rastros de agentes para descubrir ejemplos para una base de datos o conversaciones para un revisor en una cola de anotación.
Sin embargo, descubrir los registros correctos puede ser complicado. Preguntas como “¿hubo una fuga de PII?” o “¿el usuario se sintió frustrado?” no se pueden relacionar claramente con un único atributo de registro como etiquetas o metadatos, y tampoco se pueden responder mediante una búsqueda completa del texto. Requieren una comprensión del contenido del registro. Hasta ahora, eso significaba configurar un evaluador con anticipación o revisar manualmente los registros.
Por eso creamos AI Search. Usted describe el comportamiento que busca, y LangSmith devuelve los rastros donde ocurrió. Esto le permite encontrar rastros en un montón de datos y buscar patrones problemáticos específicamente.
Qué puedes buscar
Puede buscar cualquier cosa que aparezca en el contenido de un rastro. Podría buscar un agente que dijo que completó una tarea pero no lo hizo, un usuario que parecía frustrado o que rechazaba una respuesta, una solicitud a un modelo que filtró información personal identificable (PII), o alguien que intenta cancelar su suscripción. Los equipos de producto pueden buscar “solicitudes de integraciones que no soportamos”, “competidores mencionados” o “usuarios confundidos sobre el proceso de onboarding” y ver en qué punto el producto falla, con las propias palabras de los usuarios.
La búsqueda de IA también funciona junto con los filtros que ya utiliza, por lo que la búsqueda solo puede ejecutarse en rastros que hayan producido errores, o únicamente con un etiqueta específica.
Cómo lo construimos
¿Por qué un modelo lee cada rastro?
La búsqueda de vectores es la forma habitual de buscar por significado en lugar de por palabras exactas. Convierte su consulta y cada rastro en un embebiendo, una lista corta de números que captura de qué trata el texto. Luego devuelve los rastros cuyos embebiyentes están más cercanos a la consulta. Esto funciona bien para la búsqueda de temas, como encontrar conversaciones sobre facturación. Pero un embebiendo agrupa todo un rastro en un único vector pequeño, y esa compresión es perjudicial. Los detalles importantes relacionados con su consulta pueden perderse. Un rastro en el que el agente realiza el trabajo con éxito y otro en el que solo dice que lo hizo, puede terminar con una incrustación casi idéntica. Para distinguirlos, se necesita un modelo que lea las palabras reales del rastro junto con su pregunta, de modo que pueda razonar sobre lo que ocurrió.
Hasta hace poco, hacer eso en tiempo de búsqueda era demasiado lento y costoso. Los modelos de decisión rápidos cambiaron eso. Responden a una pregunta específica sobre un input de manera rápida y económica suficiente para operar a gran escala. AI Search combina la inferencia del modelo de decisión con SmithDB, nuestro capa de datos para la observabilidad de los agentes. A medida que llegan las trazas, SmithDB las convierte en trayectorias. Cuando realiza una búsqueda, sus filtros reducen los candidatos, y el modelo de decisión verifica cada trayectoria restante contra su descripción.
Las huellas son grandes y vienen en muchos formatos
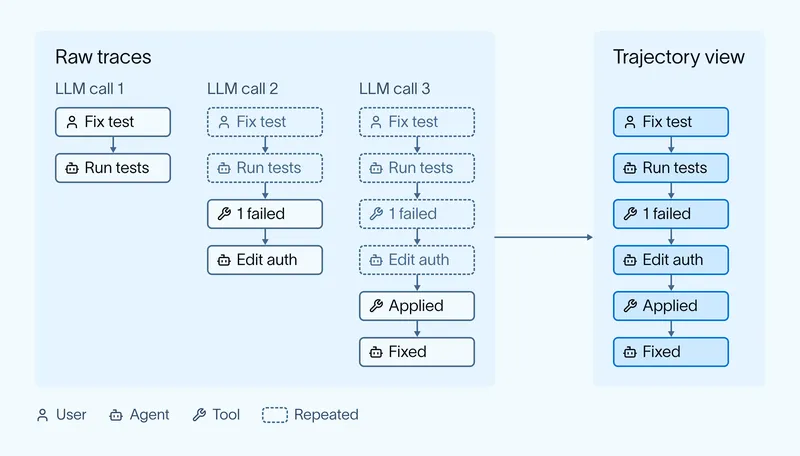
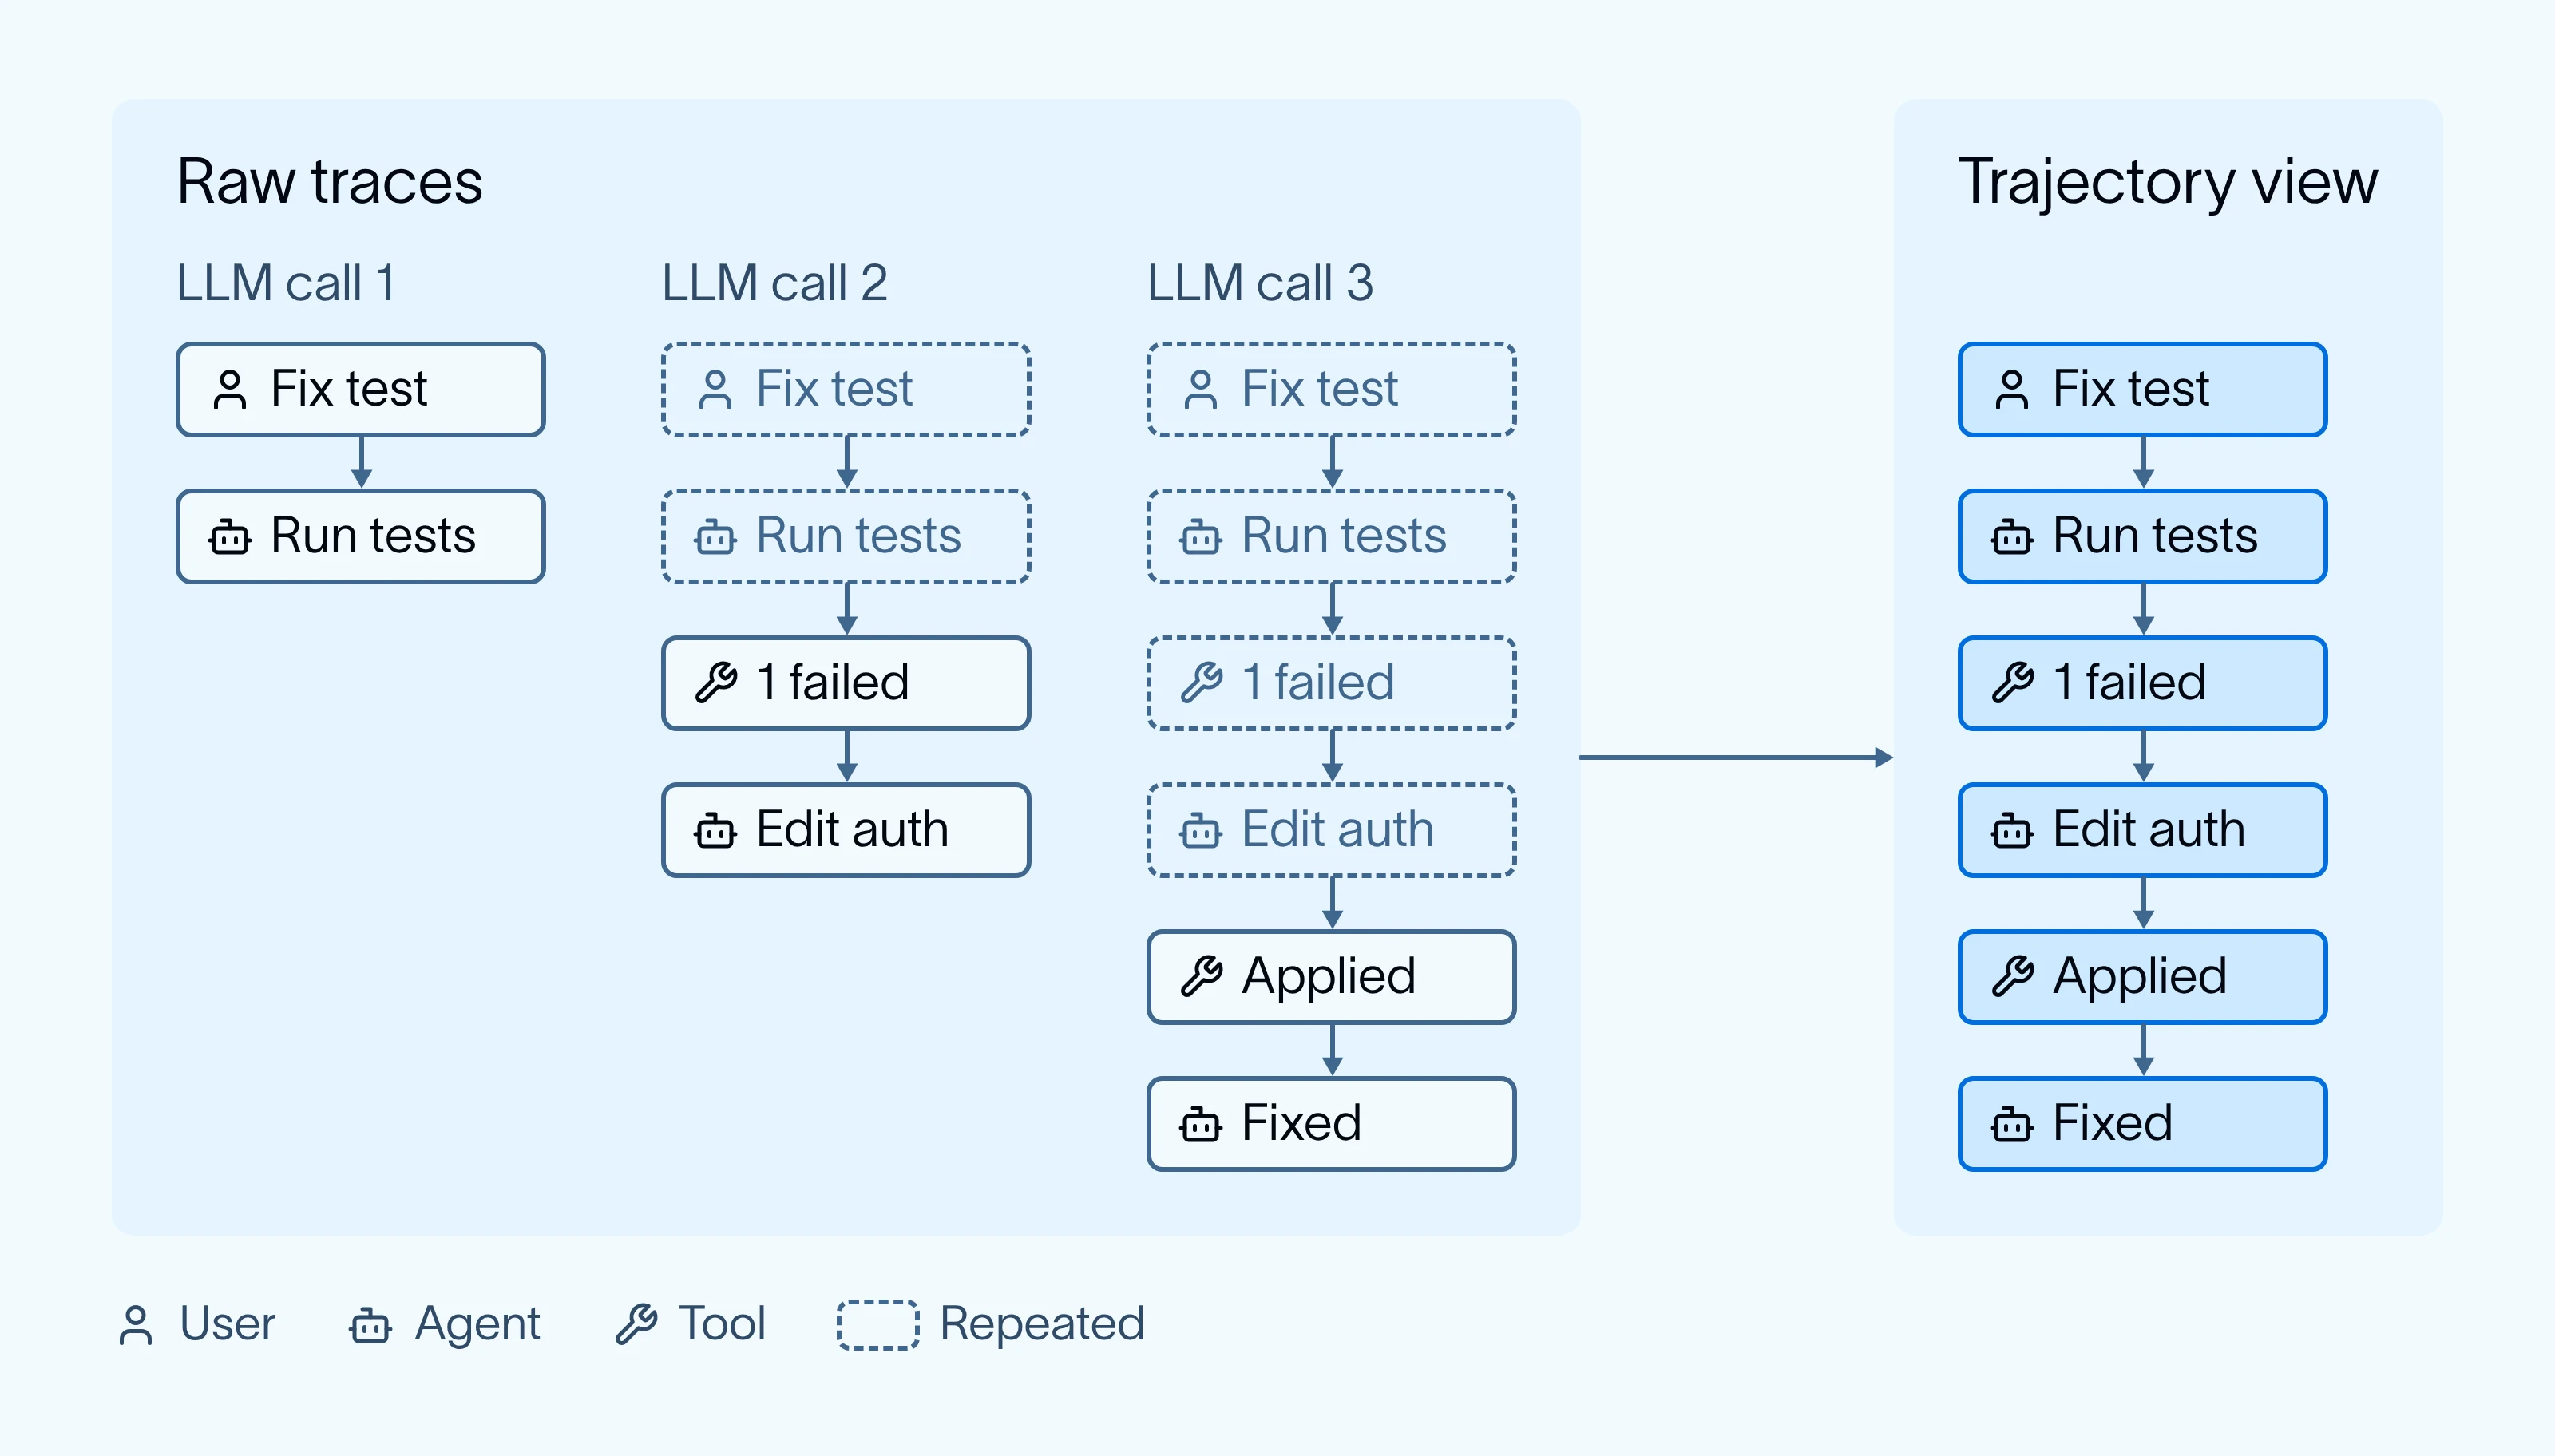
Las trazas provienen de muchas fuentes: los SDKs de OpenAI y Anthropic, LangChain, LangGraph, el SDK de IA de Vercel, OpenTelemetry y otros. Cada uno registra los mensajes de manera ligeramente diferente. Las trazas también se repiten. Los agentes a menudo vuelven a enviar el historial de la conversación con cada llamada del LLM, por lo que el primer mensaje aparece nuevamente en cada llamada después de eso.
SmithDB convierte estos rastros en una trajektoria para cada sesión. Una trajektoria es una visión resumida del trabajo del agente: cada mensaje, llamada a herramienta y resultado de la herramienta se listan una vez. SmithDB la crea a medida que llegan los rastros y convierte todos los formatos soportados en la misma forma.
La búsqueda de IA analiza las trayectorias en lugar de los rastros brutos. Dado que todos los formatos tienen la misma forma de trayectoria, una búsqueda funciona entre agentes construidos con diferentes SDKs. La eliminación de los mensajes repetidos reduce el volumen de contexto, por lo que las búsquedas se ejecutan más rápidamente. Una trayectoria también abarca toda la sesión; por lo tanto, si se realiza una búsqueda por “el usuario intentó cancelar”, el modelo puede ver qué pidió el usuario, qué hizo el agente y cómo terminó la conversación.
Las trayectorias siguen siendo largas
Eliminar duplicados ayuda, pero las trayectorias de los agentes siguen siendo largas. Para tener una idea de cuánto dure, muestramos 150 conversaciones aleatorias de Open SWE, el agente de programación de código de código abierto que el equipo de LangChain utiliza todos los días. Cada tarea se ejecuta en su propio sandbox con acceso a shell y puede delegar el trabajo a subagentes, por lo que las conversaciones se vuelven largas.
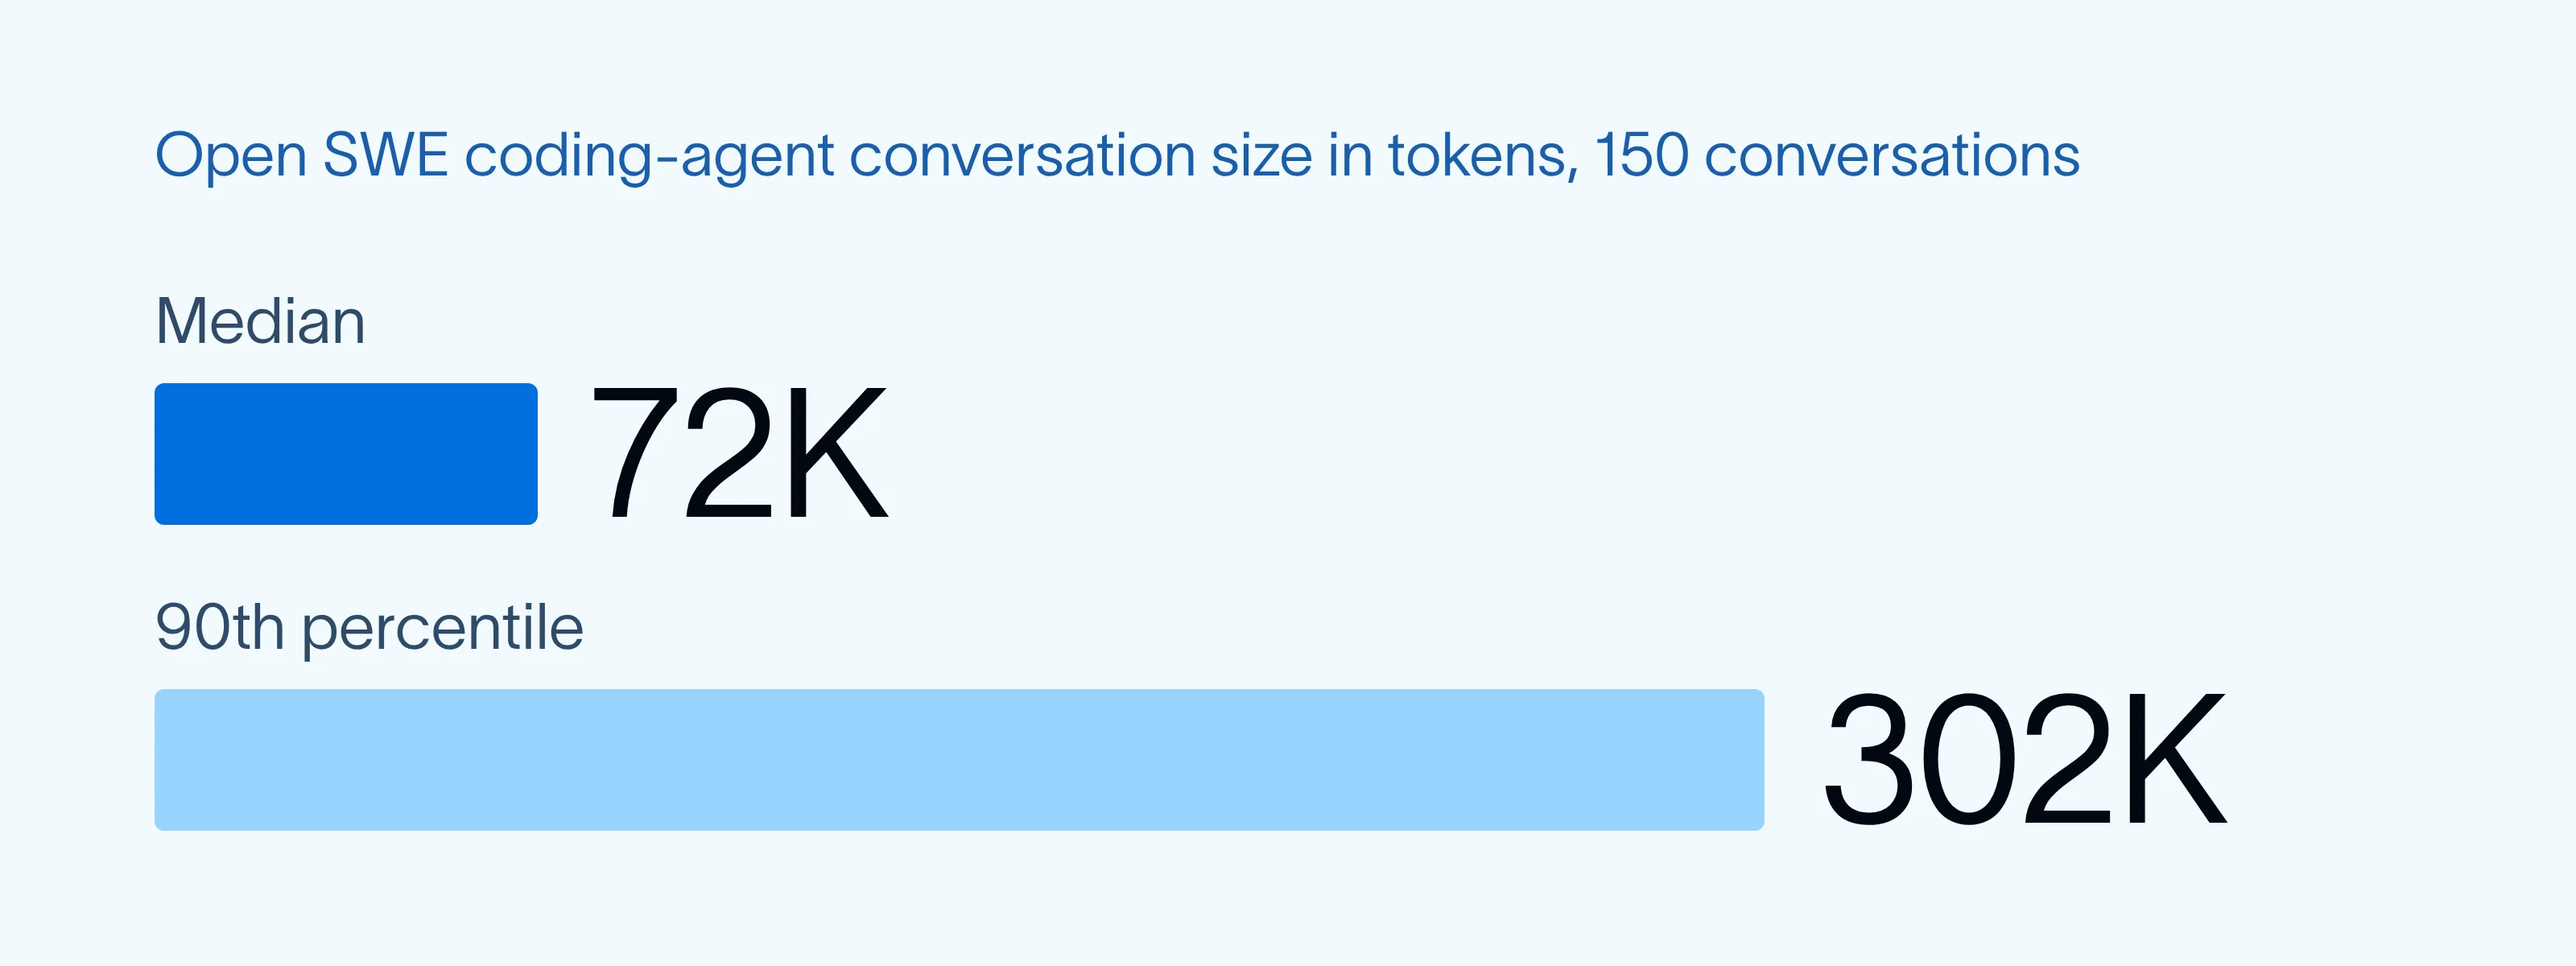
Unos pocos de ellos superaron un millón de tokens, incluso en una muestra tan pequeña. Buscar un comportamiento raro significa leer muchas conversaciones, por lo que la búsqueda de IA se encuentra regularmente con situaciones de ese tipo y no puede leer cada token.
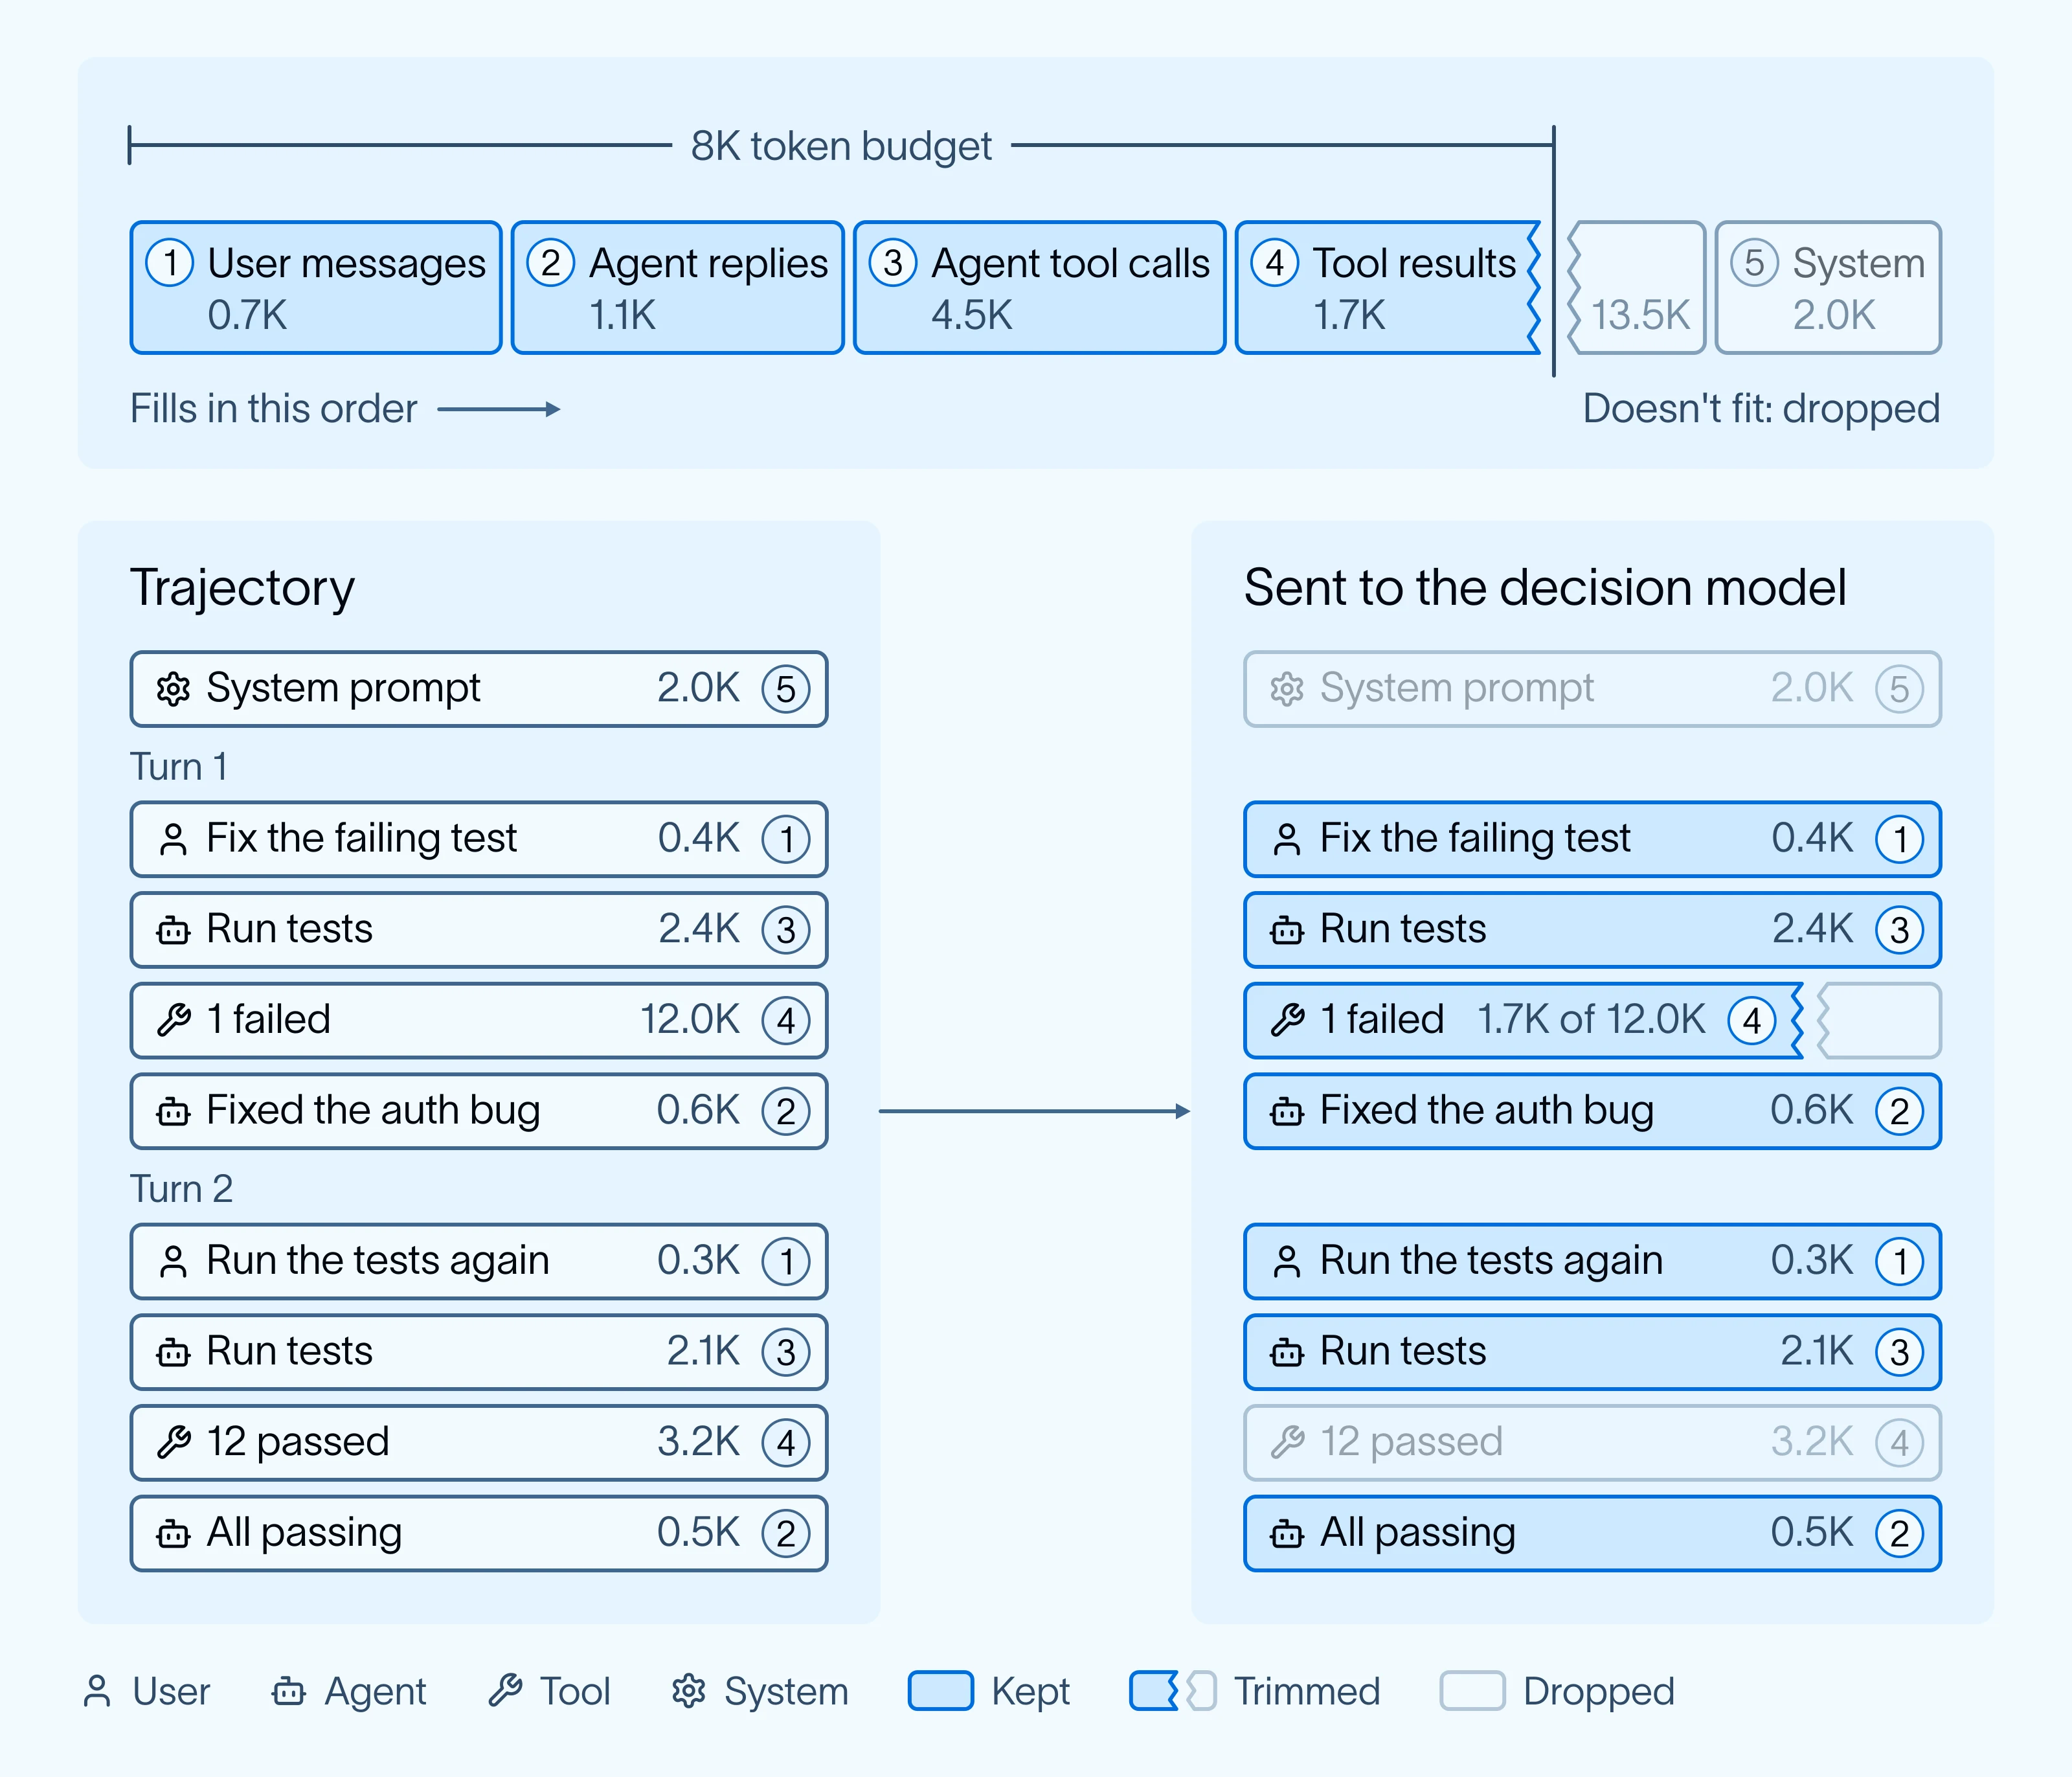
La mayoría de las preguntas no necesitan todos esos tokens. Muchas preguntas se refieren a lo que el usuario preguntó y cómo el agente respondió. En la conversación media, alrededor de 2K de los 72K tokens provienen de los mensajes del usuario y las respuestas del agente. Alrededor del 85% es producto de la salida de herramientas, en su mayoría lecturas de archivos y comandos de shell.
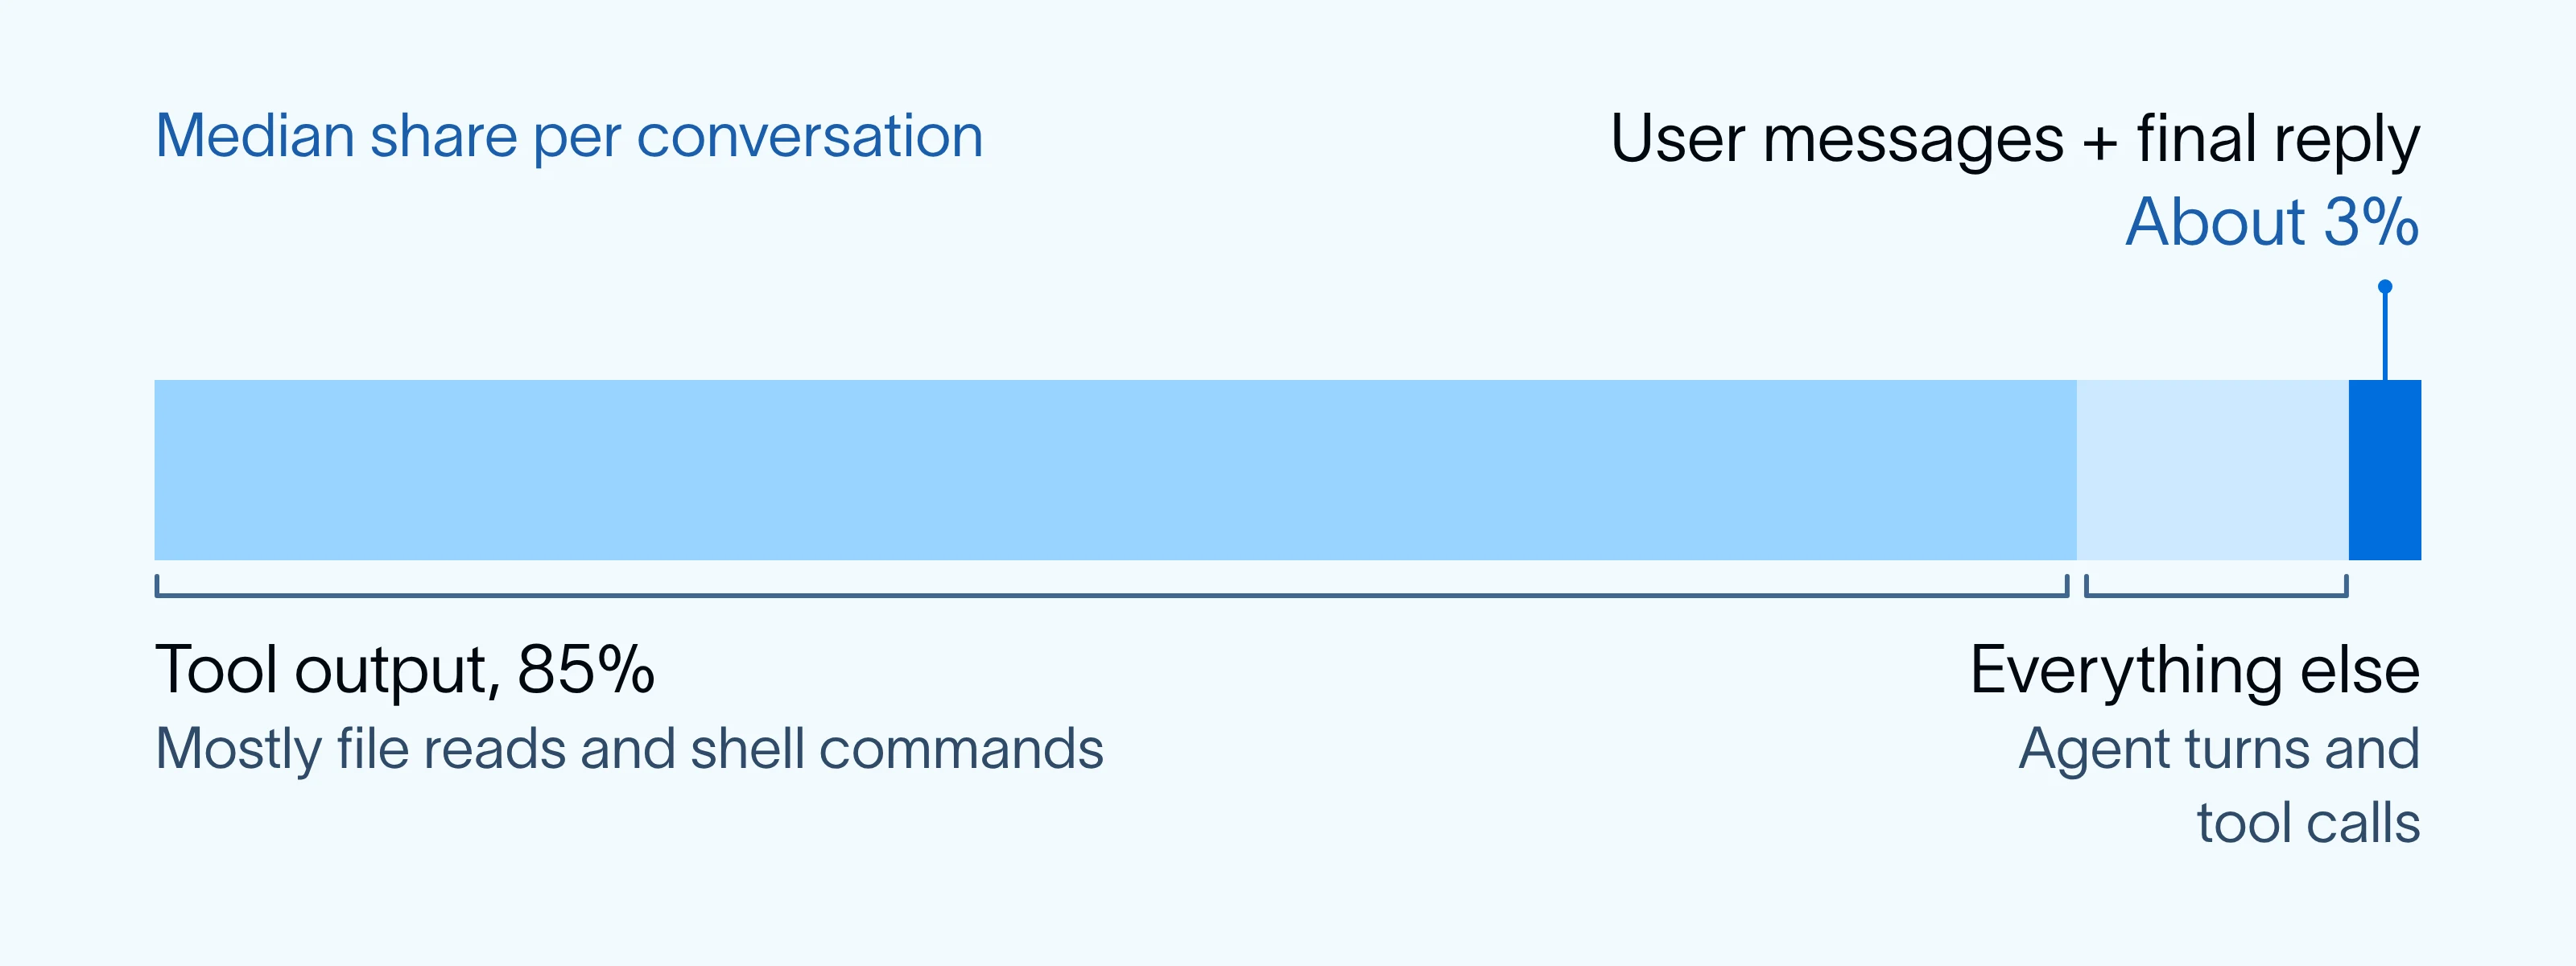
Cada trayectoria recibe un presupuesto fijo de tokens, que se llena en orden de prioridad. Los mensajes del usuario y las respuestas del agente al usuario van primero. El resto del presupuesto se asigna a todo lo demás: los mensajes intermedios de la IA (el razonamiento y las llamadas a herramientas del agente), los resultados de las herramientas y los mensajes del sistema. Si el siguiente mensaje solo se ajusta parcialmente al presupuesto, se corta para llenarlo, y todo lo que sigue se elimina.
Las búsquedas deben ser rápidas a gran escala
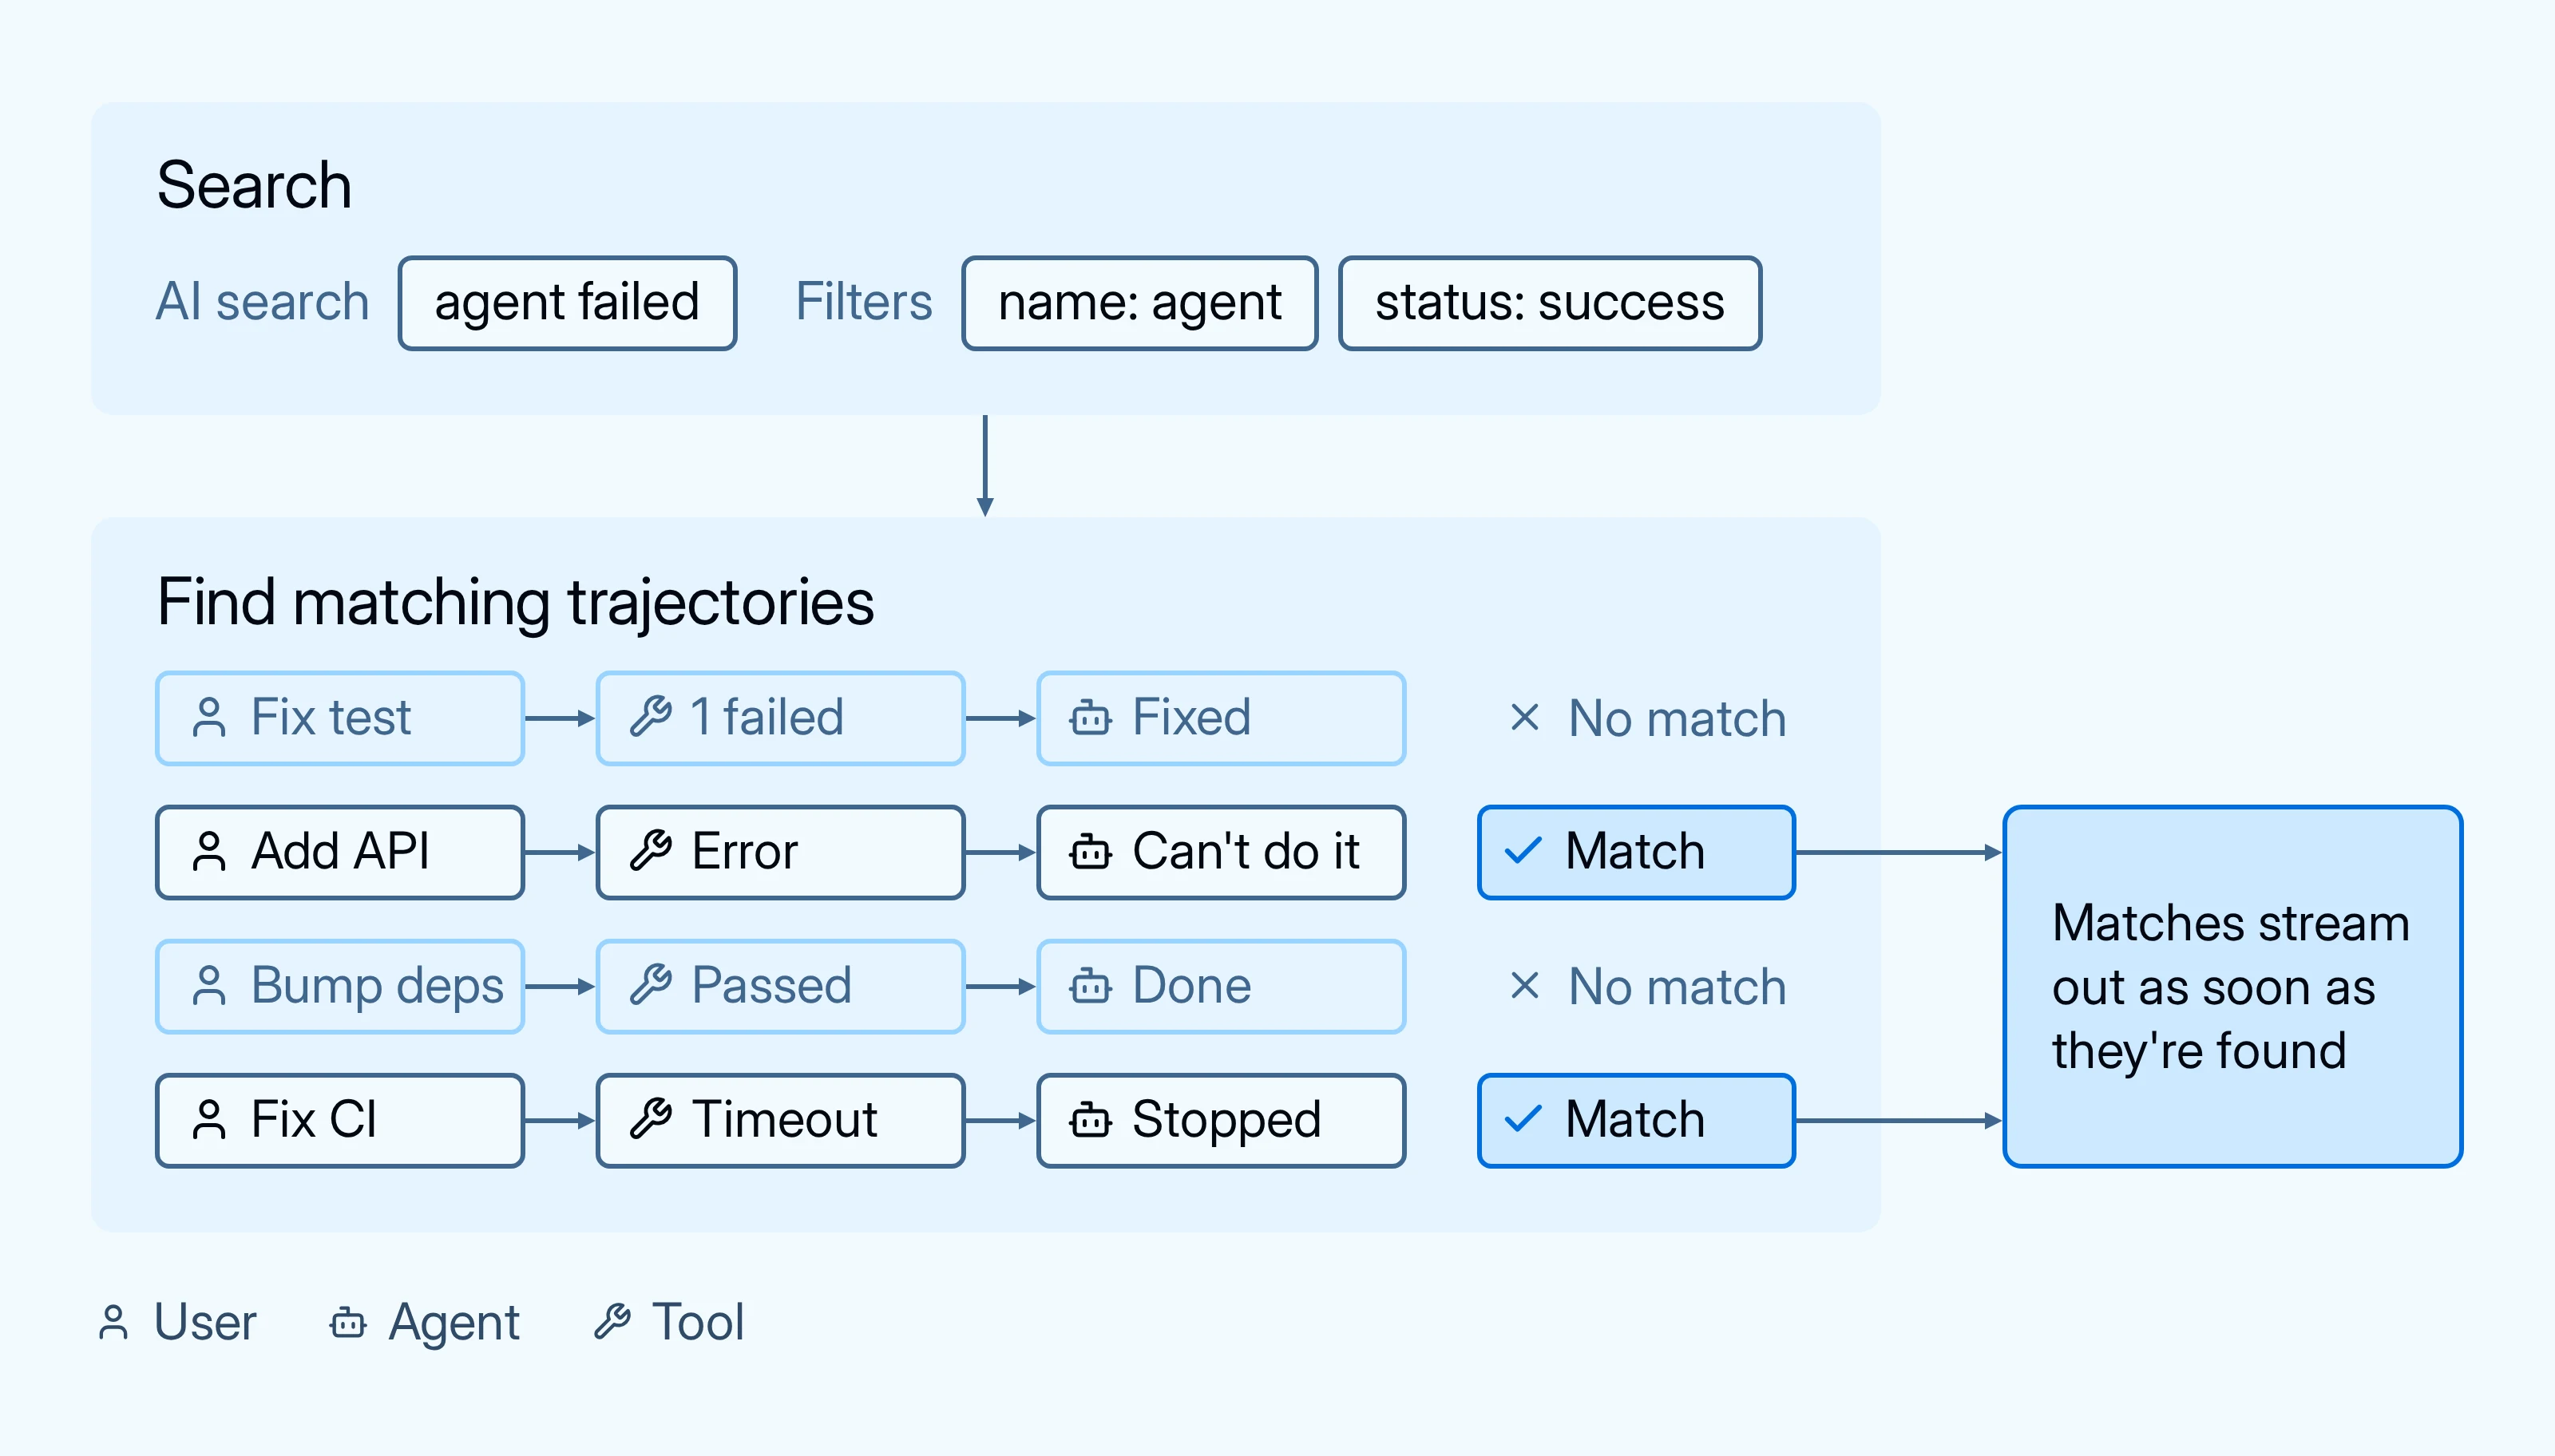
SmithDB está diseñado para ingerir y escanear grandes volúmenes de datos de trazados de agentes. Cuando realiza una búsqueda, los filtros estructurados limitan primero los candidatos. Luego, el modelo de decisión verifica cada trayectoria restante contra la descripción proporcionada, en paralelo. Mientras el modelo verifica un lote de trayectorias, SmithDB ya está recuperando y preparando el siguiente lote. Los resultados se envían de vuelta mientras se encuentran, por lo que no es necesario esperar a la escaneo completa.
¿Qué sigue?
Todavía estamos aprendiendo qué preguntas son las que más hacen la gente. Las conversaciones más difíciles de clasificar son aquellas con diferencias sutiles. Distinguir entre “el usuario se rindió” y “el usuario obtuvo lo que necesitaba y se fue” puede depender de un par de interacciones en una trayectoria larga. Queremos ver si un modelo ajustado con esos registros puede distinguirlos de manera más confiable.
El presupuesto de tokens funciona bien cuando la respuesta se encuentra en lo que el usuario y el agente dijeron. Otras preguntas requieren evidencia diferente. Un agente que ignora un error del herramienta solo aparece en los resultados de la herramienta. Estamos explorando formas de seleccionar el contexto según la pregunta, y señales que indican cuando el modelo no está seguro, para que pueda realizar una segunda pasada con más contexto.
También nos gustaría pasar por una lista simple de partidos, agrupando los resultados similares o resumiendo lo que tienen en común.
Comience
La Búsqueda de IA está en una versión beta pública en LangSmith Cloud en las regiones GCP US, EU y APAC, sin costo adicional. Los administradores de organización pueden activarla en los ajustes, y luego aparece en la página de rastreo. Los documentos sobre la Búsqueda de IA contienen los detalles. Avísenos qué buscas.