
Mixture-of-Experts (MoE) es una arquitectura de activación dispersa que escala la capacidad de los modelos de lenguaje grandes (LLM) manteniendo bajo el cómputo por token. Debido a que sus operaciones representan una gran parte del tiempo total de cómputo, las ineficiencias en ellas elevan directamente la latencia y el costo de las solicitudes. Por lo tanto, optimizar las operaciones MoE mediante ingeniería de kernels ofrece la mayor oportunidad de mejoras de rendimiento.
Fused MoE es una técnica de optimización clave para la arquitectura MoE. Un sistema fused MoE fusiona el enrutamiento de tokens, la reorganización de datos y cálculos de red especializados en una única operación por lotes en la GPU. Esto reemplaza la ejecución de esas operaciones de enrutamiento y cómputo de expertos como bucles separados y secuenciales. Si bien esto ofrece ventajas de latencia, también trae complejidad en las implementaciones de kernels y en la capacidad de depuración. Una alta utilización de GPU para esta arquitectura requiere optimizaciones específicas del hardware.
En esta publicación, describimos las diferentes optimizaciones de kernel que implementamos para modelos fused MoE y le mostramos cómo puede beneficiarse de este trabajo. Utilizamos un modelo MoE representativo como nuestro ejemplo principal.
Swap-AB para la utilización de WGMMA
Para maximizar el throughput del procesamiento de tensores, la arquitectura NVIDIA Hopper se basa en el protocolo de instrucciones Warp Group Matrix Multiply Accumulate (WGMMA), que se ejecuta colectivamente a través de un warpgroup cooperativo de 128 threads. Esta asimetría de operandos es fundamentalmente una propiedad a nivel de la arquitectura del conjunto de instrucciones (ISA). En la definición subyacente en wgmma.mma_async ensamblador, el hardware fija la dimensión de fila de la matriz (M) en una escala constante de 64 para definir su topología paralela de mapeo de threads. La dimensión de columna (N) permanece altamente variable. El Operando A se mapea estrictamente a lo largo de esta dimensión M fija (usando registros o memoria compartida), y el Operando B se mapea a lo largo de la dimensión variable N (mediante un descriptor de memoria compartida). Estos espacios de operandos son, por lo tanto, estructuralmente no intercambiables. En consecuencia, la utilización máxima de tiles del hardware está regida por estas codificaciones rígidas de formas, requiriendo que la dimensión M sea igual o superior a 64 para evitar que los carriles de ejecución de cómputo permanezcan inactivos.
Esta preferencia estructural proviene de cómo los Hopper Tensor Cores particionan los bloques de memoria. El hardware impone una forma mínima fija de diseño para la dimensión principal del primer operando, bloqueando la altura del bloque exactamente en 64 (M=64). Cuando una matriz matemática posee una dimensión principal grande y continua en este espacio primario, los planificadores internos de hardware de Hopper pueden mapear y distribuir limpiamente los datos a través de la cuadrícula física de cómputo.
Esta asimetría estructural se convierte en un grave cuello de botella de rendimiento durante la fase de decodificación de las redes MoE. En una capa MoE estándar, el álgebra lineal que rige el cómputo del experto se formula usando la notación matricial tradicional:
A[M,K] x B[K,N] —> C[M,N]
Donde (M) representa el número de filas de tokens (o tamaño del lote), (K) representa la dimensión de características ocultas, y (N) representa la dimensión extensa de salida del experto.
Durante la fase de decodificación, el sistema procesa solo un token por secuencia de usuario a la vez. En consecuencia, el espacio del lote o el tamaño de las filas de tokens es profundamente delgado, cayendo regularmente a un perfil donde (M < 64), y frecuentemente hasta una sola fila (M = 1). Bajo esta disposición estructural estándar:
La matriz (A) se transforma en un vector horizontal delgado y fragmentado (por ejemplo, 1 x 4096).
La matriz (B) (los pesos centrales del experto) permanece como un bloque vertical grande y denso (por ejemplo, 4096 x 8192).
Debido a que el número de filas (M) es minúsculo, la matriz (A) es físicamente incapaz de llenar el cubo fijo de diseño de (64) filas del hardware para el Operando A. Cuando la instrucción WGMMA se ejecuta sobre este diseño, deja una vasta porción de la capacidad física del Tensor Core completamente desabastecida. El silicio gasta ciclos de reloj procesando espacios espaciales vacíos, lo que conduce a una pobre utilización del hardware.
En una capa LLM densa estándar, las matrices de pesos son estáticas, unificadas y perfectamente contiguas. En una capa MoE, sin embargo, la carga de trabajo está fragmentada a través de una flota de subredes independientes (expertos). Esto crea cuellos de botella únicos de memoria y diseño que la hacen hipersensible a las restricciones de WGMMA de la GPU Hopper. En una capa densa estándar, la multiplicación de matrices multiplica un vector de tokens por una única matriz de pesos de capa. La dimensión de salida (N) es el tamaño oculto del modelo (por ejemplo, 4096).
En un kernel Fused MoE, la GPU no solo multiplica contra un experto. Está agrupando y ejecutando cálculos para todos los expertos activos simultáneamente para evitar lanzar kernels individuales para cada experto. Para una capa densa estándar, N es el tamaño oculto (4,096). Para una capa fused MoE, N es el número de expertos elegidos multiplicado por el tamaño intermedio del experto. Para un modelo que ejecuta una topk=8 rutina, la dimensión N efectiva dentro del kernel fusionado explota hacia decenas o cientos de miles de parámetros. Debido a que la dimensión N es tan desproporcionadamente grande en comparación con el minúsculo tamaño del token de decodificación (M=1), la asimetría del diseño se vuelve extrema. Transponer las matrices mueve esta gran dimensión combinada de MoE al espacio primario, desbloqueando la precarga de hardware a una escala que las capas densas estándar no pueden igualar.
Para resolver este desalineamiento de hardware sin alterar la integridad matemática subyacente del modelo, explotamos la propiedad algebraica de la transposición de matrices:
BT[N,K] x AT[K,M] —> CT[N,M]
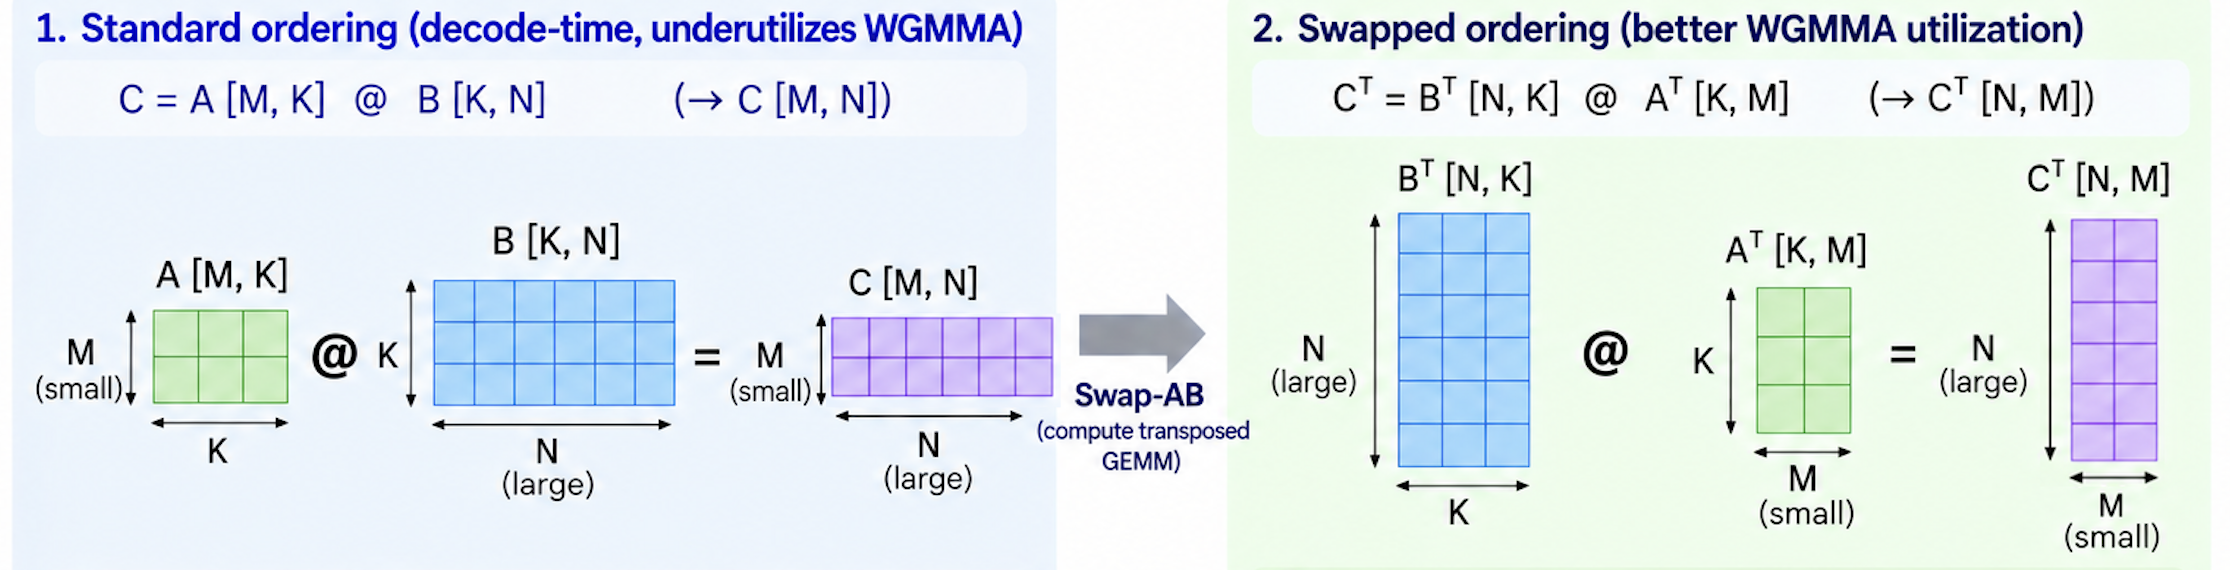
Figura 1: Swap-AB para la utilización de WGMMA
Al invertir programáticamente la multiplicación de matrices antes de que llegue a la capa de ensamblaje PTX, realineamos el software para que coincidiera con la topografía exacta del silicio Hopper. Esta transposición desencadena dos ventajas arquitectónicas inmediatas en la GPU. Primero, satura el diseño físico. La extensa dimensión de expertos (N = 8192) se promueve a la primera posición de operando (BT), y como (N) es grande, inunda fácilmente el umbral obligatorio de (64) filas del hardware. Los Tensor Cores operan entonces con máxima densidad local sin ciclos de ejecución desperdiciados. Segundo, activa la captación previa asíncrona. Los motores de copia de hardware dedicados de Hopper pueden captar previamente direcciones de memoria de forma asíncrona desde la memoria compartida directamente a los registros antes de que se active el bloque de ejecución matemática. Colocar los bloques continuos de pesos grandes (BT) en la posición principal permite que estos motores recorran el diseño de datos sin problemas y mantengan el pipeline de cómputo saturado sin intervención de la CPU. Esto produjo una mejora del 2–4 por ciento en el throughput de salida de extremo a extremo en modelos MoE a gran escala en H200. Subimos esta optimización a vLLM, y está disponible en la versión 0.24.0 o posterior.
Enrutamiento de backend para la cuantización de tensores FP8
Más allá de las interioridades del kernel, la elección de qué backend ejecuta el cómputo MoE tiene un gran efecto en el rendimiento. El oráculo MoE de vLLM enruta diferentes esquemas de cuantización a Triton, FlashInfer+CUTLASS u otros backends. El profiling reveló que, para modelos con cuantización de tensores FP8 en Hopper, el backend Triton supera consistentemente a la ruta FLASHINFER_CUTLASS predeterminada.
El backend Triton supera a CUTLASS en cargas de trabajo MoE de baja concurrencia principalmente porque reemplaza configuraciones rígidas de matemática matricial a nivel de framework con una fusión de registros personalizada a nivel de operador. CUTLASS se basa en estructuras de plantillas estándar de C++ que tratan el escalado de tensores FP8, la multiplicación de matrices y la agregación de expertos como operaciones matemáticas discretas. El backend Triton, en cambio, consolida todo este pipeline en una sola pasada de hardware. Los datos se extraen de la memoria de alto ancho de banda global (HBM) exactamente una vez y se procesan completamente dentro de los registros SRAM ultrarrápidos y los archivos de ejecución de cómputo de la GPU. Luego se transmiten de vuelta al destino final de la matriz. Esto elimina las lentas idas y vueltas de lectura/escritura en la VRAM global que comprometen a CUTLASS cuando se ve obligado a recorrer constantemente pasos intermedios de escalado de tensores.
Además, esta fusión a nivel de registros se combina específicamente con diseños de planificación dinámica diseñados en torno al agrupamiento variable de tokens, resolviendo una falla estructural severa en las plantillas de compilación tradicionales. CUTLASS está optimizado de forma nativa para dimensiones de matriz densas, grandes y predecibles. Cuando encuentra los perfiles de lote fluidos y ultra delgados (M < 64 o M = 1) típicos de la fase de decodificación en vivo, sus estructuras predeterminadas de bloque-tiling y mapeo de hilos se vuelven profundamente ineficientes. El resultado es una fuerte subutilización de warps o un costoso overhead de relleno de memoria. Por el contrario, el backend MoE de Triton destaca en mapear dinámicamente estos arreglos de tokens pequeños y fragmentados a través de los límites físicos de los pesos de expertos activos. Esto mantiene los flujos internos de captación previa y los pipelines de Tensor Core del hardware completamente saturados incluso al procesar cargas de trabajo muy inestables con tamaños de lote muy bajos.
Actualizar la política de enrutamiento es un cambio puramente de configuración sin modificar código de kernel. Aun así, produjo una mejora del 10 por ciento en el throughput de extremo a extremo para modelos MoE fusionados cuantizados en FP8 en H200. Esta mejora está disponible en el contenedor AWS Large Model Inference (LMI) v28.
Eliminación de recompilación JIT en Triton
Una de las patologías de rendimiento más impactantes en la inferencia en GPU es también una de las menos evidentes: la recompilación innecesaria de kernels. Triton, el framework de compilación que subyace a muchos de los kernels personalizados de vLLM, especializa los argumentos enteros de forma predeterminada. Cada vez que se invoca un kernel con un valor previamente no visto para un parámetro especializado, Triton activa una nueva compilación just-in-time (JIT). En cargas de trabajo de servicio donde las longitudes de secuencia y los tamaños de lote varían continuamente, esto crea un flujo constante de overhead de compilación que infla la latencia, particularmente el Time to First Token (TTFT).
En el servicio de modelos MoE, el _fused_inv_rope_fp8_quant_per_head kernel (responsable del embedding posicional rotatorio fusionado y la cuantización FP8) se recompilaba con cada nuevo num_tokens valor. Agregar do_not_specialize anotaciones a los parámetros de longitud variable eliminó por completo estas recompilaciones, mejorando el TTFT en un 9 por ciento en H200 con paralelismo de tensores de 8 vías (PR #42849).
En un clúster multi-GPU, las 8 GPU deben ejecutar sus kernels en sincronización perfecta a nivel de microsegundos. Si incluso una GPU debe detenerse para recompilar su _fused_inv_rope_fp8_quant_per_head kernel local porque cambió su conteo local de tokens en lote, las otras siete GPU quedan inactivas esperándola. Al eliminar las recompilaciones en todo el clúster, suavizamos el overhead de coordinación multi-GPU, logrando una aceleración del 9 por ciento en la latencia de la respuesta inicial del usuario. El principio aquí es tratar al compilador como una superficie de optimización de primera clase. Comprender cómo Triton especializa la semántica y reconocer cuándo los parámetros están muertos o son variables desbloquea mejoras de latencia con cambios mínimos de código.
Subimos esta optimización a vLLM, y está disponible en la versión 0.22.0 o posterior.
Conclusión
A través de nuestra colaboración con la comunidad de vLLM, implementamos y publicamos como código abierto múltiples optimizaciones de kernels para modelos MoE fusionados. Aplicamos estas optimizaciones en el LMI Deep Learning Container en Amazon SageMaker AI. En conjunto, estas optimizaciones han logrado hasta un 10 por ciento más de rendimiento y hasta un 9 por ciento menos de tiempo en TTFT. Para comenzar con el alojamiento de modelos personalizados, consulte la documentación de alojamiento de Amazon SageMaker AI.