
Grok 4.7 de SpaceXAI ya está disponible en Amazon Bedrock, que ofrece una selección de modelos fundacionales (FMs) de múltiples proveedores. Según SpaceXAI, Grok 4.7 está entrenado para trabajar más tiempo en tareas más difíciles y sabe cuándo verificar su propio trabajo. Esto importa especialmente para los agentes, que llevan una tarea a través de muchos pasos y deben verificar lo que encuentran en el camino.
Un agente que funciona de esta manera tiene que hacer más que buscar información. Debe formar una respuesta candidata, verificarla contra lo que ha aprendido y refinarla hasta que encaje. Grok 4.7 expone una configuración de esfuerzo de razonamiento que controla cuánta deliberación ocurre antes de cada respuesta, y para cargas de trabajo de agentes una pregunta práctica es qué nivel ejecutar.
En esta publicación, creamos un agente con llamadas a herramientas sobre Grok 4.7 y lo evaluamos en tres tareas que requieren búsqueda en lugar de consulta. Las tareas son diagnosticar una interrupción de dos servicios a partir de sus alertas, programar mantenimiento bajo restricciones que interactúan y elegir un conjunto óptimo de migraciones bajo un presupuesto. Cada tarea tiene exactamente una respuesta correcta, verificada por fuerza bruta. Ejecutamos las tres en cada nivel de esfuerzo de razonamiento, seis veces cada una, para 72 ejecuciones de agente.
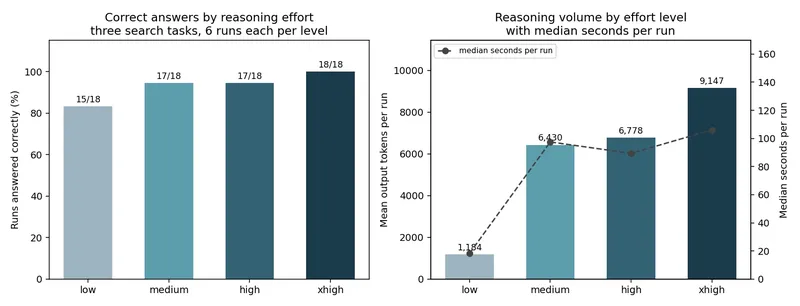
El agente respondió correctamente 67 de las 72 ejecuciones. En xhigh respondió correctamente las 18, y en low respondió 15 de 18 mientras usaba aproximadamente un octavo de los tokens de salida. Esto da una compensación clara que se puede ajustar por solicitud, y mostramos cómo medirla en sus propias tareas y cómo monitorearla en producción.
Informamos los conteos de tokens en lugar de moneda en toda la publicación. Los precios de los tokens cambian, y los conteos son de donde se derivan sus propios costos, por lo que una medición expresada en tokens sigue siendo válida.
Lo que SpaceXAI informa sobre Grok 4.7
Según SpaceXAI, Grok 4.7 usa un modelo base más grande que Grok 4.6 y fue entrenado con una ejecución de aprendizaje por refuerzo más larga sobre una mezcla de tareas más difícil. Esta mezcla está ponderada hacia problemas que toman muchas horas en completarse. SpaceXAI informa que el modelo es mejor verificando su propio trabajo y manejando contextos más largos.
Los resultados de benchmarks publicados por SpaceXAI siguen ese énfasis. Las mayores mejoras reportadas sobre Grok 4.6 aparecen en las categorías que miden trabajo sostenido en lugar de respuestas de un solo turno.
| Benchmark | Categoría | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | Trabajo en terminal de varias horas | 20.3% | 37.6% |
| EEBench | Ingeniería eléctrica | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | Trabajo legal | 15.8% | 19.6% |
| CursorBench 4.0 | Programación de mayor duración | 40.4% | 46.3% |
| HealthBench Professional | Razonamiento clínico | 48.5% | 56.7% |
| AA Briefcase v1.1 | Trabajo de oficina de varias horas | 1,546 | 1,657 |
Fuente: SpaceXAI, Introducing Grok 4.7 (https://x.ai/news/grok-4-7). Las puntuaciones son las publicadas por SpaceXAI en el momento del lanzamiento del modelo.
Los benchmarks muestran cómo se desempeña un modelo en tareas estándar. Para tu propia carga de trabajo, el siguiente paso útil es medir en tareas con forma similar a la tuya, que es lo que el resto de esta publicación recorre.
SpaceXAI enumera una ventana de contexto de 500K tokens para Grok 4.7, con entrada de texto e imagen y salida de texto. En Amazon Bedrock, el modelo admite esfuerzo de razonamiento configurable, llamadas a herramientas y salida estructurada.
Cómo accedes a Grok 4.7 en Amazon Bedrock
Grok 4.7 se ejecuta en el bedrock-runtime endpoint y se accede a través de un perfil de inferencia entre Regiones . Hay dos perfiles disponibles:
| Perfil de inferencia | Enrutamiento | Cuándo usarlo |
| us.xai.grok-4.7 | Dentro de la geografía de EE. UU. | Tiene requisitos de residencia de datos en EE. UU. |
| global.xai.grok-4.7 | Regiones comerciales de AWS | No tiene restricciones de residencia y desea la mayor capacidad disponible |
La inferencia entre regiones enruta las solicitudes a través de varias Regiones de AWS, lo que le proporciona un mayor rendimiento sin tener que gestionar la capacidad Región por Región. Las solicitudes nombran uno de los perfiles de inferencia en lugar de un ID de modelo puro.
El modelo es compatible con las API Chat Completions y Responses compatibles con OpenAI, y con la API Converse de Amazon Bedrock. En Converse, el razonamiento se devuelve como un reasoningContent bloque junto al text bloque. En inferenceConfig, establezca maxTokens únicamente, y coloque los parámetros específicos del modelo, como el esfuerzo de razonamiento, en additionalModelRequestFields.
Para ver la lista actual de Regiones admitidas, niveles de servicio y precios de tokens, consulte la tarjeta del modelo Grok 4.7 en la Guía del usuario de Amazon Bedrock y la página de precios de Amazon Bedrock (https://aws.amazon.com/bedrock/pricing/).
Requisitos previos
- Una cuenta de AWS con acceso a Amazon Bedrock y el acceso al modelo habilitado para Grok 4.7.
- Python 3.9 o posterior, con
openai,boto3, yaws-bedrock-token-generatorinstalados. - Credenciales de AWS configuradas en su entorno.
Su identidad de AWS Identity and Access Management (IAM) necesita bedrock:InvokeModel tanto en el perfil de inferencia como en el proyecto predeterminado de su cuenta:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7o elglobal.equivalente.arn:aws:bedrock:{region}:{account-id}:project/default.
Incluya ambos recursos en la declaración de la política. El permiso del proyecto predeterminado es necesario además del perfil de inferencia.
Conexión al modelo
Para uso en producción, recomendamos generar un token de portador de corta duración a partir de sus credenciales de AWS existentes, de modo que la autenticación permanezca vinculada a su identidad de IAM y no se almacene ningún secreto de larga duración:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
Los tokens de razonamiento cuentan como tokens de salida y consumen max_completion_tokens antes de que se produzca el texto de la respuesta, por lo que dimensione el límite dejando espacio para ambos. Si se alcanza el límite durante el razonamiento, la respuesta se devuelve sin texto de respuesta, así que verifique el contenido vacío en el código del agente y aumente el límite si lo observa. Nuestras ejecuciones usaron un límite de 32,768 tokens, lo que dejó margen en cada nivel de esfuerzo.
Grok 4.7 admite cuatro niveles de esfuerzo: low, medium, high, y xhigh. Los niveles de esfuerzo pueden cambiar entre versiones del modelo, por lo que vale la pena confirmarlos contra el servicio en lugar de codificar una lista de forma fija:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
Tareas de diseño que requieren razonamiento
Muchas evaluaciones de agentes prueban la diligencia: leer un registro, filtrarlo, sumarlo. Esas tareas valen la pena, pero para ver qué aporta el esfuerzo de razonamiento, una tarea debe requerir búsqueda: la respuesta no se puede leer directamente de los datos, hay que proponerla y luego verificarla.
Construimos un entorno sintético de 20 servicios, expuestos a través de siete herramientas, y tres tareas sobre él. Cada tarea tiene exactamente una respuesta correcta, y cada una está construida de modo que una heurística rápida no basta para encontrarla.
| Tarea | Lo que el agente tiene que hacer | Lo que la convierte en una tarea de razonamiento |
| two_fault_diagnosis | Dos servicios fallaron silenciosamente a las 03:00 y otros 12 emitieron alertas. Identificar los dos que fallaron | Los servicios fallidos no generan alertas, por lo que la respuesta no está entre los servicios con alertas. 190 pares posibles, y solo uno explica exactamente las alertas observadas |
| maintenance_schedule | Planificar ocho servicios a lo largo de cuatro noches, dos por noche, bajo diez restricciones y una regla de que dos servicios del mismo equipo nunca comparten noche | 2,520 horarios posibles, uno válido. La regla de equipo depende de datos que el agente tiene que consultar |
| migration_budget | Elegir candidatos a migrar que maximicen la reducción de riesgo dentro de un presupuesto, incluyendo prerrequisitos transitivos | 53 conjuntos factibles, uno óptimo. Elegir primero la mejor relación da un conjunto nueve puntos por debajo del óptimo |
Cuatro prácticas mantienen la confiabilidad de una medición como esta, y se aplican a la mayoría de las evaluaciones de agentes.
Enunciar cada regla de la que depende el evaluador. Si el prompt deja un caso límite abierto, una respuesta razonable puede puntuarse como incorrecta, y la evaluación termina midiendo la especificación en lugar del modelo. El prompt de diagnóstico, por ejemplo, indica explícitamente que un servicio fallido no genera ninguna alerta propia.
Demostrar que cada tarea tiene una única respuesta. Cada entorno es lo suficientemente pequeño para enumerarlo, así que verificamos cada respuesta candidata antes de ejecutar nada. Para el horario, eso son unas pocas líneas:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
Evaluar una línea final obligatoria, no toda la respuesta. Cada prompt pide al agente terminar con una línea como FINAL: auth, checkout. El evaluador lee solo esa línea, de modo que una respuesta que discute otros candidatos mientras explica su razonamiento se evalúa por su conclusión:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
Rastrear el formato por separado de la corrección. Una línea final ausente es una señal distinta de una incorrecta. En nuestras ejecuciones, las 72 respuestas incluyeron una línea final evaluable.
Restringir los parámetros de las herramientas con un enum donde los valores válidos son conocidos, de modo que cada llamada a herramienta apunte a un recurso real:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
El system prompt es deliberadamente breve y pide al agente verificar su respuesta antes de darla:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
El bucle del agente es un bucle estándar de llamada a herramientas: llamar al modelo con reasoning_effort establecido, ejecutar cada llamada a herramienta devuelta, añadir el resultado con la clave tool_call_id, y repetir hasta que el modelo deje de solicitar herramientas. El seguimiento de prompt_tokens y completion_tokens a lo largo del bucle proporciona los recuentos de tokens informados en la siguiente sección.
Resultados
Seis ejecuciones de cada tarea en cada nivel de esfuerzo, 72 ejecuciones en total. El agente respondió correctamente 67.
| Tarea | low | medium | high | xhigh |
| diagnóstico_de_fallas_dos | 5 de 6 | 6 de 6 | 6 de 6 | 6 de 6 |
| cronograma_de_mantenimiento | 5 de 6 | 5 de 6 | 5 de 6 | 6 de 6 |
| migration_budget | 5 de 6 | 6 de 6 | 6 de 6 | 6 de 6 |
| Las tres tareas | 15 de 18 | 17 de 18 | 17 de 18 | 18 de 18 |
| Por ejecución | low | medium | high | xhigh |
| Media de tokens de salida | 1,184 | 6,430 | 6,778 | 9,147 |
| Tokens de salida en relación con low | 1.0x | 5.4x | 5.7x | 7.7x |
| Media de llamadas a herramientas | 17.2 | 18.7 | 17.8 | 18.1 |
| Tiempo transcurrido mediano | 18s | 98s | 89s | 106s |
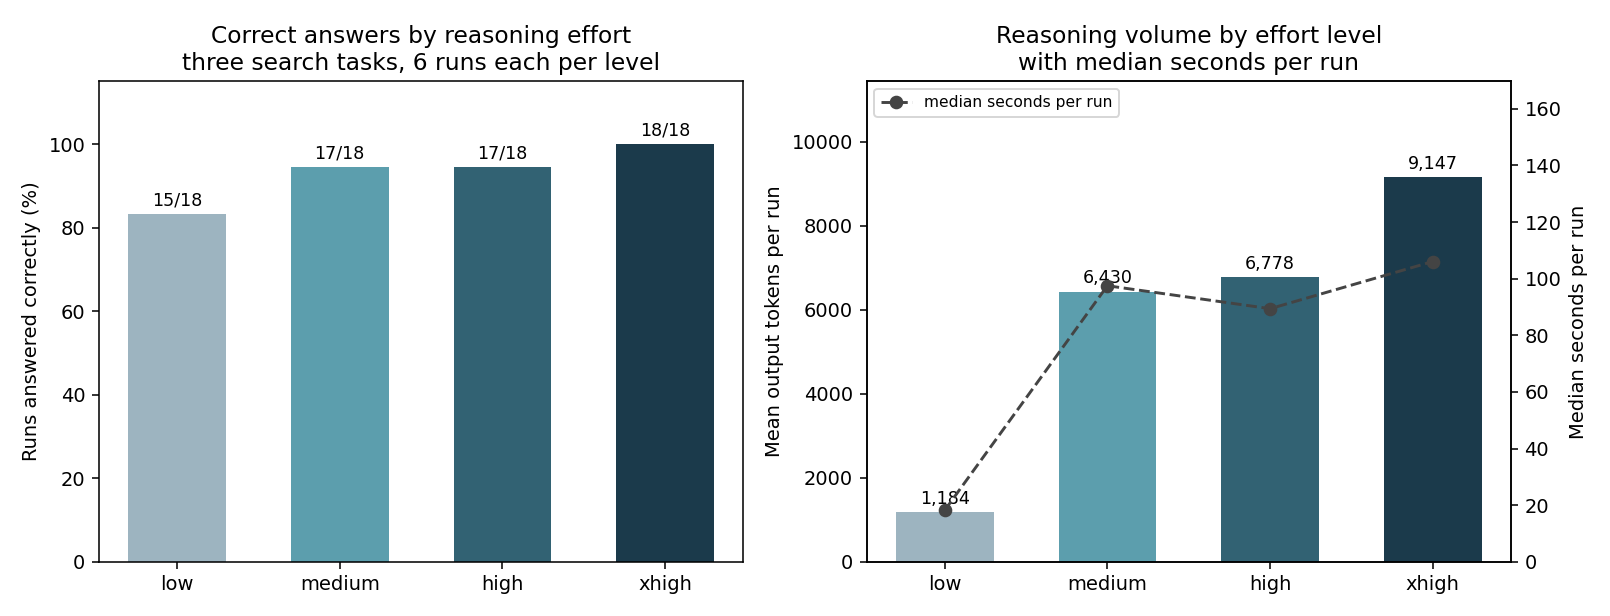
Figura 1: Proporción de ejecuciones respondidas correctamente en cada nivel de esfuerzo de razonamiento (izquierda) y media de tokens de salida por ejecución con los segundos medianos por ejecución superpuestos (derecha)
Tres observaciones.
xhigh respondió correctamente todas las ejecuciones. Las 18 ejecuciones de las tres tareas fueron correctas en xhigh, y medium y high respondió correctamente 17 de 18 en cada caso. Con seis ejecuciones por tarea y nivel, las diferencias entre niveles son indicativas más que estadísticamente concluyentes, y la dirección fue consistente en las tres tareas.
El esfuerzo cambia cuánto razona el agente, no cuánto explora. Las llamadas a herramientas fueron esencialmente planas, entre 17.2 y 18.7 por ejecución en cada nivel. El agente recopiló los mismos hechos independientemente del esfuerzo, y lo que cambió fue cuánto razonamiento aplicó a ellos, con los tokens de salida aumentando de 1,184 en low a 9,147 en xhigh.
low ofrece una sólida relación costo-calidad. A low, el agente respondió correctamente en 15 de 18 ejecuciones usando aproximadamente un octavo de los tokens de salida de xhigh, con una ejecución mediana de 18 segundos. Cuando se acepta una tasa de finalización ligeramente menor, o cuando las respuestas se revisan posteriormente, low es una opción eficiente. Cuando cada respuesta debe ser correcta a la primera, los niveles más altos son la opción predeterminada más segura.
Cómo el nivel de esfuerzo moldea la respuesta
Las tareas se diseñaron en torno a un tipo específico de dificultad, y observar cómo manejó cada nivel de esfuerzo aclara cuándo vale la pena el razonamiento adicional.
Optimización. La tarea de migración recompensa considerar combinaciones en lugar de clasificar las opciones de una en una. Seleccionar los candidatos con las mejores proporciones individuales produce una respuesta razonable que se queda a nueve puntos del óptimo. En medium y superiores, el agente encontró el conjunto óptimo en las 18 ejecuciones.
Prueba de hipótesis. La tarea de diagnóstico requiere verificar un par candidato en ambas direcciones: cada alerta debe ser explicada, y cada servicio que permaneció en silencio debe ser coherente con la respuesta. En medium y superiores, el agente identificó el par correcto en las 18 ejecuciones.
Satisfacción de restricciones. La tarea de programación combina diez restricciones enumeradas con una regla del equipo que depende de datos de propiedad consultados. xhigh produjo el cronograma válido en cada ejecución, y esta fue la tarea donde el nivel más alto marcó la diferencia más clara.
El patrón en las tres tareas es que el esfuerzo de razonamiento adicional es más valioso cuando el agente tiene que sopesar varias respuestas candidatas entre sí, en lugar de seguir un único camino hacia el resultado.
Monitorear el razonamiento en producción
En producción no tienes una respuesta conocida con la que calificar, pero sí sabes cuántos tokens de salida y llamadas a herramientas usó cada ejecución. Eso te da una señal operativa útil.
Las ejecuciones correctas en cada nivel se mantienen por encima de un piso claro de volumen de razonamiento. Cada ejecución correcta en medium y superiores usó al menos 1,739 tokens de salida, y la ejecución típica usó varios miles. Una ejecución que no hace llamadas a herramientas, o que produce mucho menos resultado de lo normal para su nivel, vale la pena marcarla para revisión:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
Calibra la línea base a partir de ejecuciones que hayas calificado, por tarea y por nivel de esfuerzo, y luego aplícala a las ejecuciones que no has calificado. Trata una alerta como un indicativo para inspeccionar o volver a ejecutar. En low, donde cada ejecución es breve, el volumen de salida es una señal más débil, así que combínala con verificaciones puntuales.
Pedir al agente que verifique su respuesta en el prompt del sistema vale la pena mantenerlo, porque hace que el razonamiento del agente sea fácil de seguir al revisar una ejecución. Combínalo con la calificación automática siempre que exista una respuesta conocida, para que la calidad se mida de manera independiente de la transcripción.
Elegir un nivel de esfuerzo de razonamiento
Estos resultados sugieren algunas reglas prácticas.
Ajustar el esfuerzo al tipo de tarea. Las tareas que implican búsqueda, optimización o prueba de una hipótesis se benefician más de medium o superior. Las tareas que siguen un único camino, o cuyas respuestas se revisan aguas abajo, pueden ejecutarse de manera eficiente en low.
Fijar el esfuerzo por solicitud, no por agente. El esfuerzo es un parámetro de la solicitud, por lo que un agente puede ejecutar sus pasos de planificación y verificación a un nivel superior y sus pasos mecánicos, como formatear el resultado de una herramienta, en low. Eso combina gran parte de la fiabilidad de un nivel superior con un menor costo de tokens.
Medir en tus propias tareas, con repeticiones. Una sola ejecución por configuración da una sola observación. Repetir cada configuración varias veces muestra cuán consistente es.
Monitorear el volumen de razonamiento. Los tokens de salida y las llamadas a herramientas por ejecución, rastreados por nivel de esfuerzo, te dan una señal temprana para revisar una ejecución antes de que su resultado se utilice.
Limitaciones de esta medición
Seis ejecuciones por tarea y nivel de esfuerzo. Suficiente para mostrar una dirección consistente en tres tareas, no suficiente para un intervalo de confianza. Trate las diferencias entre niveles como indicativas.
Un entorno sintético. Las herramientas leen datos generados en código, lo que hace posible demostrar que cada tarea tiene exactamente una respuesta y calificar automáticamente. Las herramientas reales añaden latencia, resultados parciales y errores, ninguno de los cuales se prueba aquí.
Minutos, no horas. El tiempo mediano de ejecución osciló entre 18 segundos en low y 106 segundos en xhigh. Esta es una versión a escala reducida de trabajo de horizonte largo. El método se transfiere. Las cifras absolutas, no.
Una versión de modelo, una Región, un prompt por tarea. Distintas formulaciones de la misma tarea pueden cambiar los resultados, y esa es una de las razones por las que importa enunciar explícitamente cada regla.
Recuentos de tokens, no costos. Para convertirlos a moneda, aplique las tarifas actuales de su perfil de inferencia y nivel de servicio desde la página de precios de Amazon Bedrock. Los perfiles Global y US Geo tienen precios diferentes, y los niveles de servicio Flex y Priority aplican multiplicadores.
Controles operativos para cargas de trabajo de agentes
Incorpore reintentos. Los agentes que emiten un alto volumen de llamadas deben tratar los reintentos como parte del diseño. Establezca un tiempo de espera de solicitud, reintente solo los errores que admitan reintento, aplique retroceso exponencial con jitter y respete un encabezado Retry-After cuando se devuelva uno:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
El rendimiento bajo demanda escala con el tiempo, así que incremente gradualmente una nueva carga de trabajo de alto volumen en lugar de comenzar a plena tasa.
Auditoría de una ejecución. El registro de invocaciones de modelos escribe los datos de solicitud y respuesta en Amazon Simple Storage Service (Amazon S3) o Amazon CloudWatch Logs. Esto le brinda la transcripción completa de las ejecuciones que desee revisar a posteriori.
Monitoreo del volumen de razonamiento a escala. Las métricas de Amazon CloudWatch le ofrecen la vista agregada del uso de tokens, que es donde las líneas base por nivel descritas anteriormente se convierten en algo sobre lo que puede generar alarmas.
Atribución del gasto entre agentes. La desglosación de costos en AWS Cost Explorer y el AWS Cost and Usage Report desglosa el uso por modelo, lo que, combinado con los recuentos de tokens por tarea, le proporciona tanto la economía unitaria como la factura agregada.
Ajustar el costo a la urgencia. Los niveles de servicio se establecen por solicitud, por lo que un despliegue puede enviar un análisis nocturno a través del nivel Flex y una solicitud interactiva a través de Priority. Para una carga de trabajo que se ejecuta en un nivel de esfuerzo más alto, la selección del nivel es una palanca adicional sobre el costo.
Elegir un perfil de enrutamiento. La inferencia entre Regiones amplía el conjunto de capacidad del que se abastece una ejecución prolongada. El perfil Global sirve desde la Región de AWS comercial que usted elija y generalmente tiene un precio por token más bajo que el enrutamiento geográfico. El perfil de EE. UU. mantiene el procesamiento dentro de los Estados Unidos. Elija según sus requisitos de residencia de datos, así como el costo.
Limpieza
Los ejemplos de esta publicación no crean recursos de AWS facturables más allá del uso de tokens por solicitud. Si generó una clave de API de Amazon Bedrock a largo plazo, elimínela en la consola de Amazon Bedrock cuando termine, ya que sigue siendo válida hasta que se revoque. Los tokens de corto plazo generados a partir de credenciales de IAM caducan por sí solos.
Si habilitó el registro de invocaciones de modelos en Amazon S3 durante las pruebas, revise el bucket y elimine los objetos que ya no necesite.
Conclusión
SpaceXAI entrenó a Grok 4.7 para trabajar más tiempo en tareas más difíciles y para saber cuándo verificar su propio trabajo. En tres tareas que requerían búsqueda en lugar de consulta directa, el agente respondió correctamente en 67 de 72 ejecuciones, y cada ejecución en xhigh. Dado que el esfuerzo de razonamiento se establece por solicitud, puede elegir dónde se sitúa cada paso de un agente en la disyuntiva entre minuciosidad y costo de tokens.
Tres cosas vale la pena llevar a su propia evaluación. Diseñe tareas con una única respuesta demostrable y enuncie cada regla de la que depende el evaluador. Repita las ejecuciones, para ver qué tan consistente es cada configuración. Y monitoree los tokens de salida y las llamadas a herramientas por nivel de esfuerzo, para tener una señal operativa junto con sus mediciones de calidad.
Lecturas adicionales
- Introducing Grok on Amazon Bedrock
- Grok 4.7 is now available on Amazon Bedrock
- Enrute las solicitudes de inferencia del modelo en varias Regiones de AWS con la inferencia entre Regiones
- Getting started with Amazon Bedrock
- Chat Completions API
- Amazon Bedrock pricing
- Introducing Grok 4.7 (SpaceXAI)