
Los analistas de seguridad necesitan respuestas rápidas sobre su infraestructura en la nube sin un conocimiento profundo de lenguajes de consulta específicos del dominio. La herramienta de Orca Securitycubre más de 900 modelos de nube (los tipos de recursos que Sonar rastrea, como una instancia de Amazon Elastic Compute Cloud (Amazon EC2) o un bucket de Amazon Simple Storage Service (Amazon S3)). Consultar esos datos requería nombres de modelos precisos, navegación de relaciones anidadas y selección entre 18 operadores (funciones de comparación como equals o contains usadas para filtrar resultados).
Para resolver esto, Orca Security se asoció con AWS para construir Discovery AI, un agente de consultas en lenguaje natural sobre Amazon Bedrock. Orca proporciona seguridad contextual para la nube, el código y la IA, y Sonar es su sistema de consultas específico del dominio donde los usuarios buscan, filtran y exploran en todo el grafo de datos.
En esta publicación, compartimos la arquitectura y los resultados de Discovery AI, que convierte una pregunta en lenguaje natural en una consulta de Sonar. Como resultado, Orca redujo los costos de consulta en un 90 por ciento, los tokens de entrada en un 93 por ciento y la latencia en un 75 por ciento en comparación con la línea base inicial.
Unir el lenguaje natural y las consultas estructuradas
El sistema de consultas Sonar de Orca Security admite más de 900 modelos de infraestructura en la nube y aplicaciones con relaciones complejas entre ellos. Para consultar estos datos, los usuarios construyen objetos JSON que especifican nombres exactos de modelos, eligen entre 18 operadores y navegan jerarquías de padre-hijo entre proveedores de nube. Hacerlo bien requiere un conocimiento profundo del esquema de Sonar.
Para construir esta capacidad, el equipo de Orca se propuso crear una interfaz de lenguaje natural que pudiera generar consultas de Sonar válidas a partir de texto sencillo.
Su prueba de concepto inicial cargaba el esquema completo de Sonar en un único prompt en el modelo más grande disponible. Esto incluía más de 900 definiciones de modelos, cada tipo de relación y un amplio conjunto de consultas de ejemplo. La calidad de la salida era sólida (los socios de diseño y los usuarios internos respondieron positivamente), pero surgieron tres inconvenientes significativos a escala de producción.
El consumo de tokens era ineficiente, con aproximadamente 2 millones de tokens de entrada por carga de trabajo, lo que elevaba el costo. La latencia era alta, con tiempos de respuesta de extremo a extremo de alrededor de 60 segundos por carga de trabajo. La precisión en consultas complejas de varios modelos era limitada, porque las relaciones anidadas y las consultas con múltiples condiciones a menudo requerían un refinamiento adicional.
El equipo de Orca validó que el concepto funcionaba. El siguiente desafío era hacerlo lo suficientemente rentable, rápido y preciso para producción. Para abordar esto, el equipo de Orca diseñó e implementó una solución que maneja miles de consultas por día con tiempos de respuesta de 15 segundos usando Amazon Bedrock.
Descripción general de la solución
Orca diseñó Discovery AI como una solución híbrida sobre Amazon Bedrock que combina la Generación Aumentada por Recuperación (RAG) con la construcción de consultas consciente del esquema. El sistema convierte preguntas en lenguaje natural en filtros de Discovery válidos a través de una canalización de múltiples etapas, con cada etapa asignada al modelo de Amazon Bedrock más apropiado.
Orca eligió Amazon Bedrock porque proporciona acceso a múltiples modelos a través de una única API, lo que permite al equipo asignar diferentes modelos fundacionales a cada etapa de la canalización sin gestionar integraciones separadas. Amazon Bedrock también hereda los controles de gobernanza de AWS a través de AWS Identity and Access Management (IAM), puntos de enlace de nube privada virtual (VPC) y AWS CloudTrail, cumpliendo con los requisitos de seguridad de Orca. La arquitectura agnóstica del modelo significó que el equipo podía cambiar a versiones de modelos más nuevas a medida que estuvieran disponibles sin rediseñar la canalización.
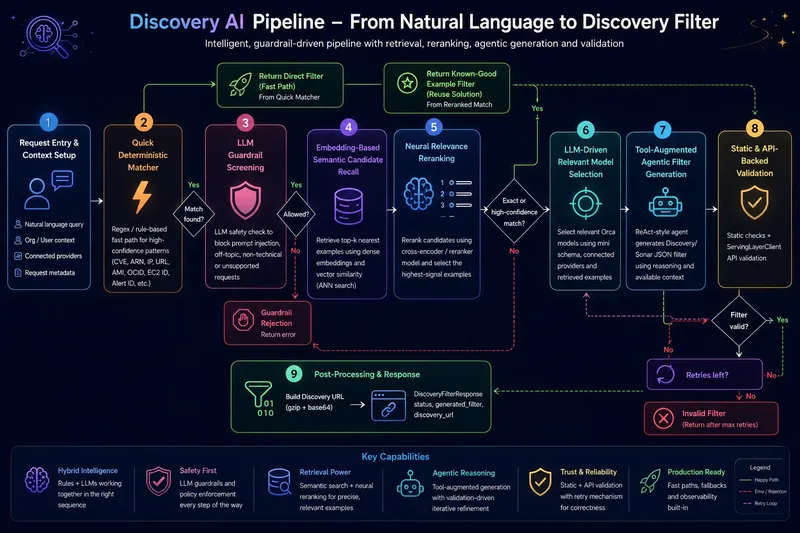
El siguiente diagrama ilustra la arquitectura de la canalización de nueve etapas.
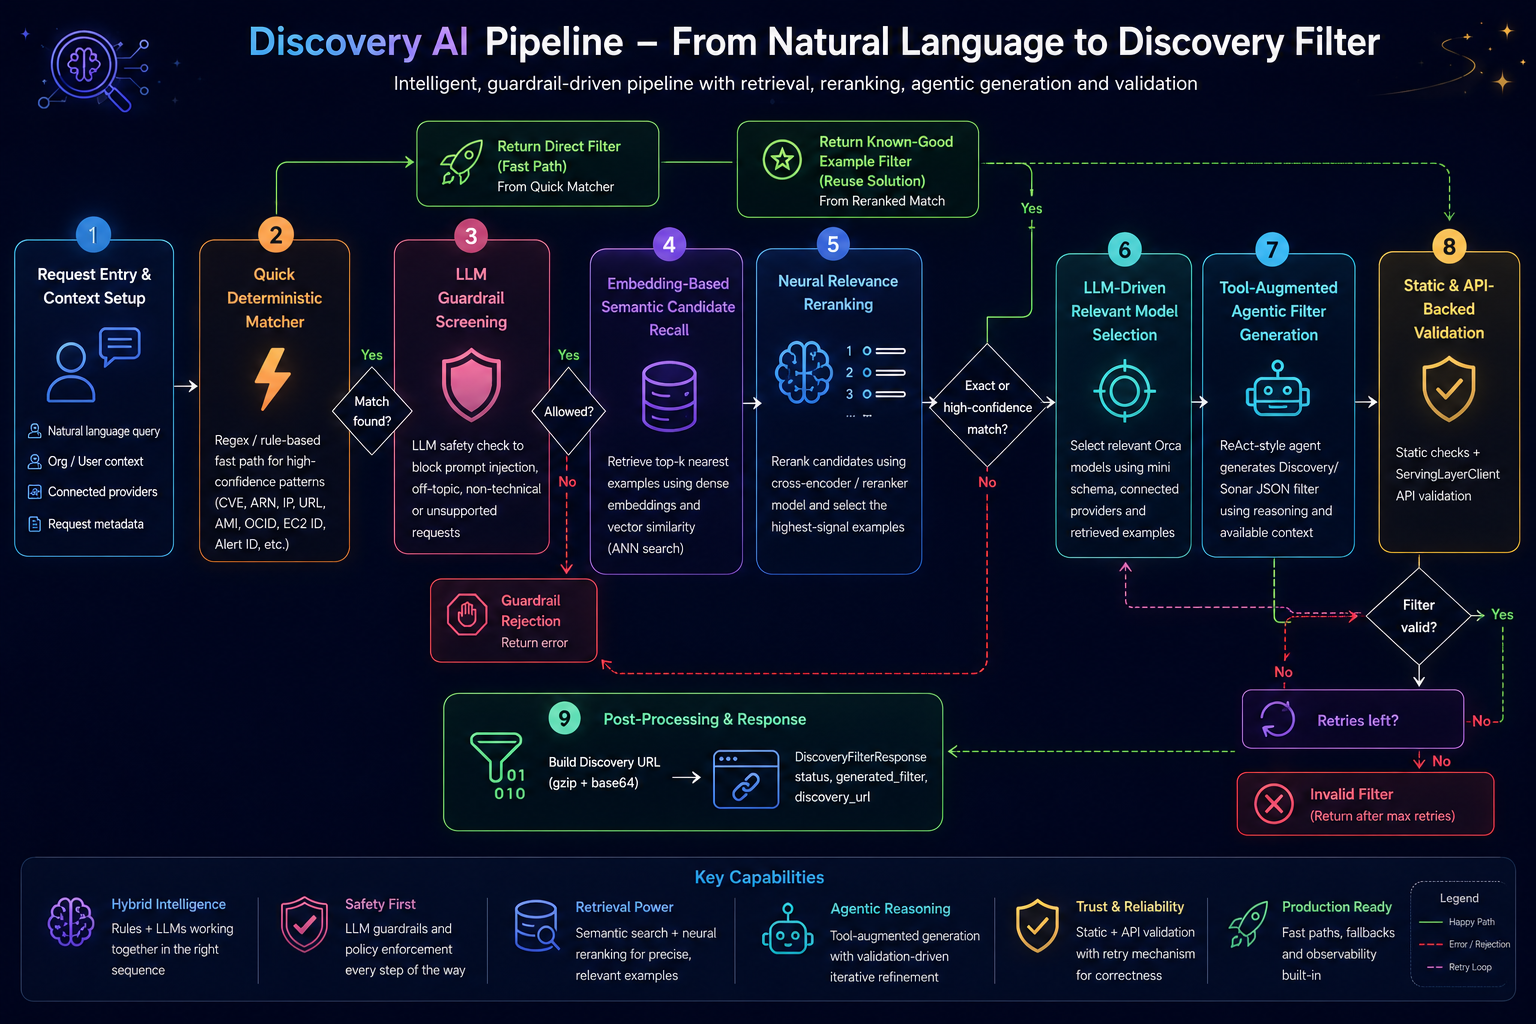
Figura 1: Arquitectura de la canalización multi etapa de Discovery AI que muestra el flujo desde la entrada en lenguaje natural hasta consultas de filtro de Discovery validadas usando modelos fundacionales en Amazon Bedrock
La canalización de Discovery AI convierte una solicitud en lenguaje natural en un filtro de Discovery validado a través de nueve pasos.
- Entrada de solicitud y configuración de contexto: la canalización comienza combinando la solicitud en lenguaje natural del usuario con el contexto relevante, incluida la organización del usuario, los proveedores de nube conectados y los metadatos de la solicitud. Este contexto ayuda a la canalización a interpretar la solicitud con precisión y a generar un filtro de Discovery que coincida con el entorno del cliente.
- Comparador determinista rápido: el Quick Matcher identifica entradas estructuradas como direcciones IP, Common Vulnerabilities and Exposures (CVE), ARN, hashes de archivos, IDs de Amazon Machine Image, Oracle Cloud Identifiers, IDs de EC2, URL e IDs de alertas. Utiliza regex y coincidencia basada en reglas para detectar patrones de alta confianza. Cuando se encuentra una coincidencia, la canalización puede devolver un filtro de Discovery predefinido a través de una vía rápida, sin usar inferencia de modelos de lenguaje de gran escala (LLM). Cuando no se encuentra ninguna coincidencia, la solicitud continúa con el siguiente paso.
- Filtrado de guardarraíles LLM: el componente Guardrail verifica si la solicitud es segura, relevante, técnica y compatible. Bloquea los intentos de inyección de prompts, las solicitudes fuera de tema y las entradas no compatibles antes de que lleguen al resto de la canalización. Las solicitudes que no superan las comprobaciones del guardarrail se rechazan con un error apropiado. Las solicitudes aprobadas continúan con la recuperación de ejemplos.
- Recuperación de candidatos semánticos basada en embeddings: el pipeline busca ejemplos de consultas previamente validados y relevantes utilizando Amazon Titan Text Embeddings. Recupera los 20 ejemplos más cercanos del almacén de vectores según la similitud semántica. Estos candidatos proporcionan al pipeline ejemplos de cómo solicitudes de lenguaje natural similares se tradujeron previamente en filtros de Discovery.
- Reordenamiento de relevancia neuronal: los candidatos recuperados se reordenan utilizando Cohere Rerank 3.5 en Amazon Bedrock. Identifica los ejemplos más relevantes para la solicitud actual y selecciona los cinco ejemplos con mayor señal. Cuando se encuentra una coincidencia exacta o de alta confianza, el pipeline puede reutilizar directamente el filtro conocido como bueno. De lo contrario, los ejemplos reordenados se pasan a las etapas generativas.
- Selección de modelos relevantes impulsada por LLM: la Selección de Modelos reduce más de 900 modelos Sonar al pequeño conjunto relevante para la solicitud. Considera la solicitud del usuario, los proveedores conectados y los ejemplos recuperados al seleccionar los modelos apropiados. Los modelos seleccionados se proporcionan al Generador utilizando el nivel de esquema adecuado, que va desde micro esquemas compactos hasta mini esquemas más detallados. Esto reduce el contexto innecesario y hace que la generación sea más eficiente.
- Generación de filtros agéntica aumentada con herramientas: el Generador utiliza un agente aumentado con herramientas para construir el filtro final de Discovery. Razona sobre los esquemas de modelos seleccionados, los ejemplos recuperados, el contexto del usuario y las herramientas disponibles. El agente puede refinar iterativamente el filtro a medida que avanza hacia una representación válida de la solicitud del usuario.
- Validación estática y respaldada por API: el filtro generado se verifica para comprobar su corrección sintáctica y semántica. El pipeline primero aplica validación estática y luego verifica el filtro contra la API Sonar de Orca. Cuando la validación falla, el error de validación se devuelve al Generador para que el agente pueda corregir el filtro e intentarlo de nuevo. Si se alcanza el número máximo de reintentos sin producir un filtro válido, el pipeline devuelve una respuesta de filtro no válido. El Generador está restringido a los ejemplos reordenados y a los esquemas seleccionados. La validación estática resuelve cada modelo, campo y operador de vuelta a esas definiciones de esquema. Cada error de validación regresa al agente con el elemento problemático identificado, de modo que los reintentos se reancoren en lugar de volver a adivinar.
- Post-procesamiento y respuesta: una vez que se produce un filtro válido, ya sea mediante el Quick Matcher, la reutilización de un ejemplo conocido como bueno o la generación agéntica, el pipeline prepara la respuesta final. El equipo asignó diferentes modelos fundacionales en Amazon Bedrock entre los componentes según los requisitos de cada etapa. Anthropic Claude Haiku 4.5 alimenta el Selector de Modelos y el Generador. Estos componentes requieren un razonamiento sólido para una construcción precisa de consultas. Amazon Nova 2 Lite se encarga del Guardrail y el Validator, donde se prioriza la inferencia rápida a menor costo. Amazon Titan proporciona embeddings para la búsqueda semántica en el componente de Recuperación de Ejemplos. Cohere Rerank 3.5 reordena los candidatos recuperados para maximizar la relevancia. Para conocer la disponibilidad de modelos por región de AWS, consulte Disponibilidad regional por modelos.
Maximización de la relevancia y la diversidad en la recuperación de ejemplos
La recuperación de ejemplos surgió como la palanca de precisión más importante del pipeline. Los ejemplos sólidos enseñan al Generador a traducir preguntas en consultas Sonar de manera más eficiente que los esquemas por sí solos, por lo que el equipo de Orca evaluó comparativamente varias estrategias de recuperación en Amazon Bedrock. Cada estrategia compensaba de manera diferente la relevancia, la diversidad o la velocidad, y compararlas directamente mostró qué combinación funcionaba mejor.
La búsqueda semántica pura de top-K sobre embeddings de Amazon Titan era rápida, pero tendía a devolver ejemplos casi duplicados que privaban al Generador de diversidad. La Relevancia Marginal Máxima (MMR) mejoró la diversidad, pero sacrificaba relevancia cuando el mejor candidato era en realidad la respuesta correcta. Recuperar un conjunto de candidatos más grande y luego reordenarlo incorporaba un grupo más amplio y utilizaba un reordenador para seleccionar el subconjunto más relevante, lo que apuntaba hacia el enfoque ganador.
El ganador fue la recuperación de los 20 vecinos más cercanos utilizando embeddings de Amazon Titan. Orca luego reordenó estos resultados con Cohere Rerank 3.5 hasta los cinco primeros. Este enfoque le da al Generador un conjunto pequeño, diverso y altamente relevante de ejemplos sin forzar una compensación entre cobertura y precisión en el momento de la recuperación.
Carga de más de 900 modelos en el contexto
Una restricción fundamental dio forma a la arquitectura. No era factible incluir los esquemas de más de 900 modelos Sonar en cada prompt. Incluso con modelos de contexto largo, hacerlo degrada tanto el costo como la precisión.
El Selector de Modelos resuelve esto. Ejecutándose en Anthropic Claude Haiku 4.5, trabaja con representaciones compactas y semánticamente ricas de cada modelo (nombre, propósito, campos clave y relaciones clave). Dada la pregunta del usuario, devuelve solo los modelos que el Generador realmente necesita. El Generador recibe entonces el detalle completo del esquema solo para esos modelos seleccionados, además de las relaciones que los conectan.
Metodología de evaluación
Para iterar con confianza, el equipo de Orca construyó desde el principio del proyecto un entorno de evaluación continua. Este entorno combina un conjunto de datos curado, una capa de puntuación automatizada y un enfoque de medición por segmentos, de modo que el equipo pueda confiar en cada cambio antes de implementarlo. Juntos, estos elementos convierten la evaluación en un paso rutinario en lugar de una ocurrencia tardía.
El conjunto de datos de evaluación curado abarca los tipos de preguntas, las familias de modelos y los niveles de complejidad que se observan en producción, por lo que refleja el uso real. Una capa de puntuación con LLM como juez califica las consultas generadas en cuanto a corrección, exhaustividad y equivalencia semántica con una consulta de referencia, lo que brinda al equipo una señal de calidad constante. La metodología de medición luego desglosa las diferencias por segmento, lo que permite al equipo identificar exactamente dónde ocurren las regresiones y qué corregir.
Cada cambio en un prompt, un modelo, un parámetro de recuperación o un ejemplo pasa por el arnés de pruebas antes de llegar a producción.
Sistema de etiquetado con expertos del dominio en el bucle para la mejora continua
Sostener la precisión a medida que los entornos de los clientes evolucionan y surgen nuevos patrones de preguntas requirió más que una implementación inicial sólida. El equipo de Orca creó una herramienta interna de etiquetado para gerentes de producto, ingenieros de soporte e investigadores de seguridad. Con la herramienta, pueden marcar consultas, corregir resultados e incorporar correcciones al banco de ejemplos en una sola acción. Además, el sistema recopila automáticamente consultas de producción con ejemplos de coincidencia de baja confianza y las enruta al experto del dominio correspondiente para su etiquetado diario. La siguiente ejecución del pipeline recupera el nuevo ejemplo mediante Cohere Rerank 3.5, y la precisión en esa clase de preguntas mejora en ese mismo momento, sin necesidad de despliegue.
“La interfaz de usuario de etiquetado es la inversión más importante que hicimos para la calidad a largo plazo. Convierte a Discovery AI de un despliegue estático en un sistema vivo, con nuestros expertos del dominio mejorándolo continuamente dentro de su flujo de trabajo habitual.”
— Or Gabay, Director de IA, Orca Security
Combinado con la observabilidad del pipeline de extremo a extremo y paneles compartidos que abarcan a los equipos de producto, ingeniería y atención al cliente, este ciclo de retroalimentación es lo que mantiene a Discovery AI mejorando después del lanzamiento inicial.
Resultados
Tras desplegar Discovery AI en producción, la nueva solución superó la línea de base inicial en costo, latencia y precisión. El uso de tokens de entrada cayó un 93 por ciento, de aproximadamente 2 millones de tokens a 140,000 por carga de trabajo comparable. El costo general disminuyó un 90 por ciento, impulsado por ese menor consumo de tokens junto con la asignación de modelos por etapa en Amazon Bedrock.
La latencia también mejoró, con tiempos de respuesta de extremo a extremo que cayeron un 75 por ciento, de aproximadamente 60 segundos a 15 segundos. La precisión en consultas complejas de múltiples modelos también mejoró, medida de forma continua a través del arnés de evaluación del equipo.
Discovery AI ahora procesa miles de consultas por día en producción desde marzo de 2026, con validación de calidad por parte de expertos internos y comentarios de los clientes.
Conclusión
En esta publicación, compartimos cómo Orca Security construyó Discovery AI sobre Amazon Bedrock. La solución redujo los costos de consulta en un 90 por ciento, el uso de tokens de entrada en un 93 por ciento y la latencia en un 75 por ciento en comparación con la línea de base inicial. La solución combina varias tecnologías clave. Estas incluyen la recuperación de ejemplos basada en RAG con Cohere Rerank 3.5, la asignación de modelos por etapa entre Anthropic Claude Haiku 4.5 y Amazon Nova 2 Lite, y la búsqueda semántica impulsada por Amazon Titan. Además, un sistema continuo de etiquetado con humanos en el bucle proporciona una mejora constante. Esta combinación permitió a Orca convertir un prototipo funcional en una solución de nivel de producción que es tanto más barata de operar como más precisa.
Para comenzar a construir soluciones similares, explore Amazon Bedrock para acceso a modelos de base (FM), Cohere Rerank en Amazon Bedrock para optimización de recuperación, y Amazon Titan para embeddings. Para obtener más información sobre la herramienta de seguridad en la nube de Orca Security, visite orca.security.
Para obtener más información sobre cómo Orca Security aplica la IA en su marco, consulte cómo Orca impulsa resultados de seguridad con IA y cómo Orca asegura la adopción de IA, incluido Amazon Bedrock.
Para más información sobre las técnicas utilizadas en esta publicación, lea publicaciones relacionadas en el AWS Machine Learning Blog.