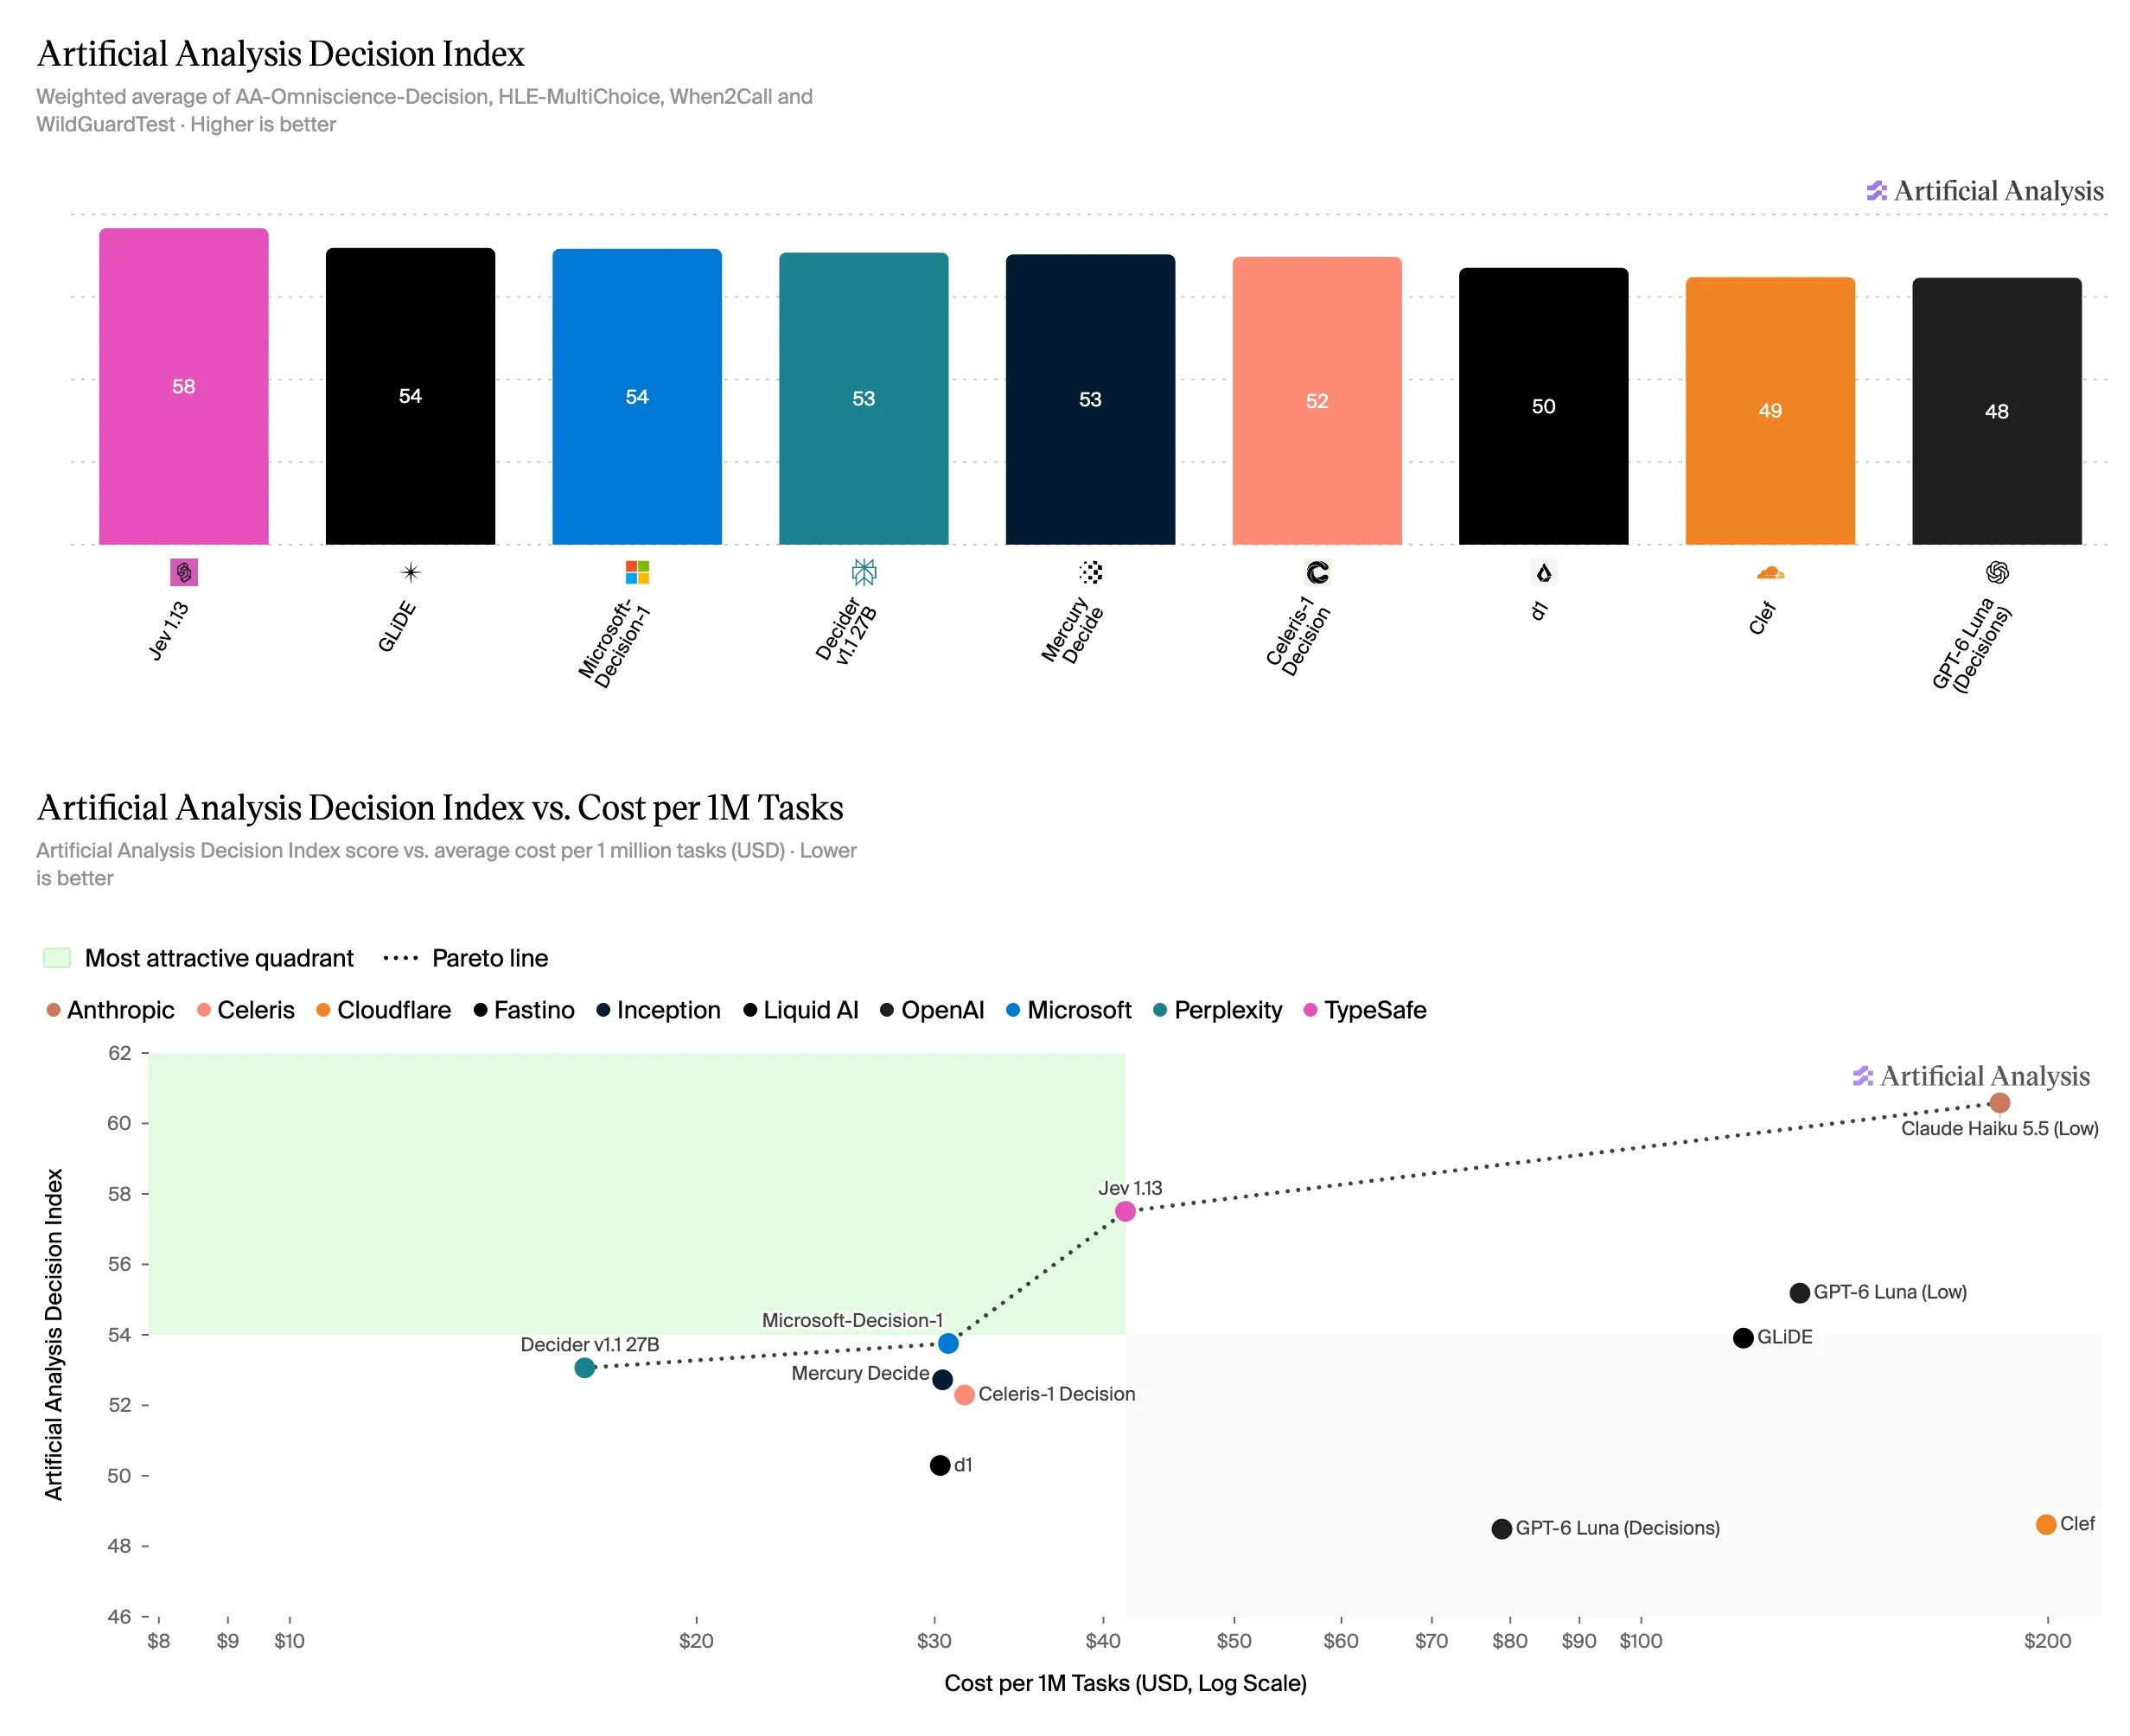
Presentamos el Artificial Analysis Decision Index, que evalúa modelos de decisión en clasificación, llamadas a herramientas, conocimiento y razonamiento. Jev lidera entre los modelos de decisión; los modelos de lenguaje como Claude Haiku 5.5 siguen ofreciendo mayor precisión, pero a un costo y latencia mucho mayores
Los modelos de decisión entregan respuestas estructuradas o clasificaciones con probabilidades asociadas, ofreciendo respuestas más rápidas y costos más bajos que el uso de modelos de lenguaje. El Artificial Analysis Decision Index v1.0 compara la capacidad, el costo y la velocidad de los modelos de decisión y también los compara con los modelos de lenguaje.
Benchmarks en el Artificial Analysis Decision Index v1.0:
➤ AA-Omniscience-Decision: Un conjunto de datos privado de 500 preguntas adaptadas del benchmark propietario AA-Omniscience, que mide el conocimiento de los modelos de decisión y su tendencia a alucinar
➤ HLE-MultiChoice: 513 preguntas de opción múltiple solo de texto de Humanity's Last Exam, que prueban las capacidades de razonamiento de los modelos de decisión
➤ When2Call: Un benchmark de llamadas a herramientas de NVIDIA, que prueba si los modelos pueden decidir correctamente llamar a una herramienta, solicitar aclaración, negarse a responder o responder directamente, evaluando capacidades relevantes para flujos de trabajo agénticos y enrutamiento de herramientas
➤ WildGuardTest: Un benchmark de seguridad que evalúa las capacidades de clasificación de los modelos en solicitudes dañinas de usuarios, negativas del asistente y respuestas dañinas. Usamos un subconjunto de 835 de las 1,725 filas de prueba originales donde los tres anotadores humanos coincidieron en las tres etiquetas, tras excluir las preguntas que consistentemente desencadenan negativas del modelo
Resultados clave:
➤ Jev 1.13 lidera el Decision Index y se sitúa en la frontera de Pareto de Capacidad vs. Costo: Jev 1.13 de @typesafeai obtiene 58 en el Artificial Analysis Decision Index, por delante de GLiDE (54) de @fastinoAI y Microsoft-Decision-1 (54) de @Microsoft. Decider v1.1 27B de @perplexity_ai tiene el Costo por 1M de Tareas más bajo, $17, con Microsoft-Decision-1 ($31) y Jev 1.13 ($42) también en la frontera de Pareto de Capacidad vs. Costo. Celeris-1 Decision tiene el Tiempo por Tarea más rápido, 0.06 segundos, más de 2 veces más rápido que Jev 1.13 (0.13 segundos por tarea)
➤ Los modelos de decisión están mal calibrados en tareas de conocimiento y razonamiento: En casi todos los niveles de probabilidad para las respuestas elegidas, la precisión queda por debajo de esa probabilidad para todos los modelos de decisión. Esta brecha es mayor en AA-Omniscience-Decision y HLE-MultiChoice, mientras que la mayoría de los modelos están relativamente bien calibrados en WildGuardTest (clasificación) y When2Call (llamadas a herramientas)
➤ Los modelos de decisión ofrecen ventajas significativas de velocidad y costo sobre los modelos de lenguaje, pero quedan atrás en conocimiento y razonamiento: En tareas de clasificación y llamadas a herramientas, los modelos de decisión líderes rinden de manera comparable a los modelos de lenguaje siendo significativamente más rápidos y baratos. Sin embargo, los modelos de lenguaje superan sustancialmente en conocimiento y razonamiento. Claude Haiku 5.5 (Low) obtiene 61 en el Decision Index, 3 puntos por delante de Jev 1.13, pero tarda 1.4 segundos por tarea frente a 0.13 segundos (11 veces más lento) y cuesta $184 por 1M de Tareas frente a $42 de Jev 1.13 (4.4 veces más caro)
Continuaremos desarrollando el Artificial Analysis Decision Index para ayudar a los desarrolladores y empresas a comprender mejor cuándo y cómo usar los modelos de decisión.