Texto Batallas de arena muestran:
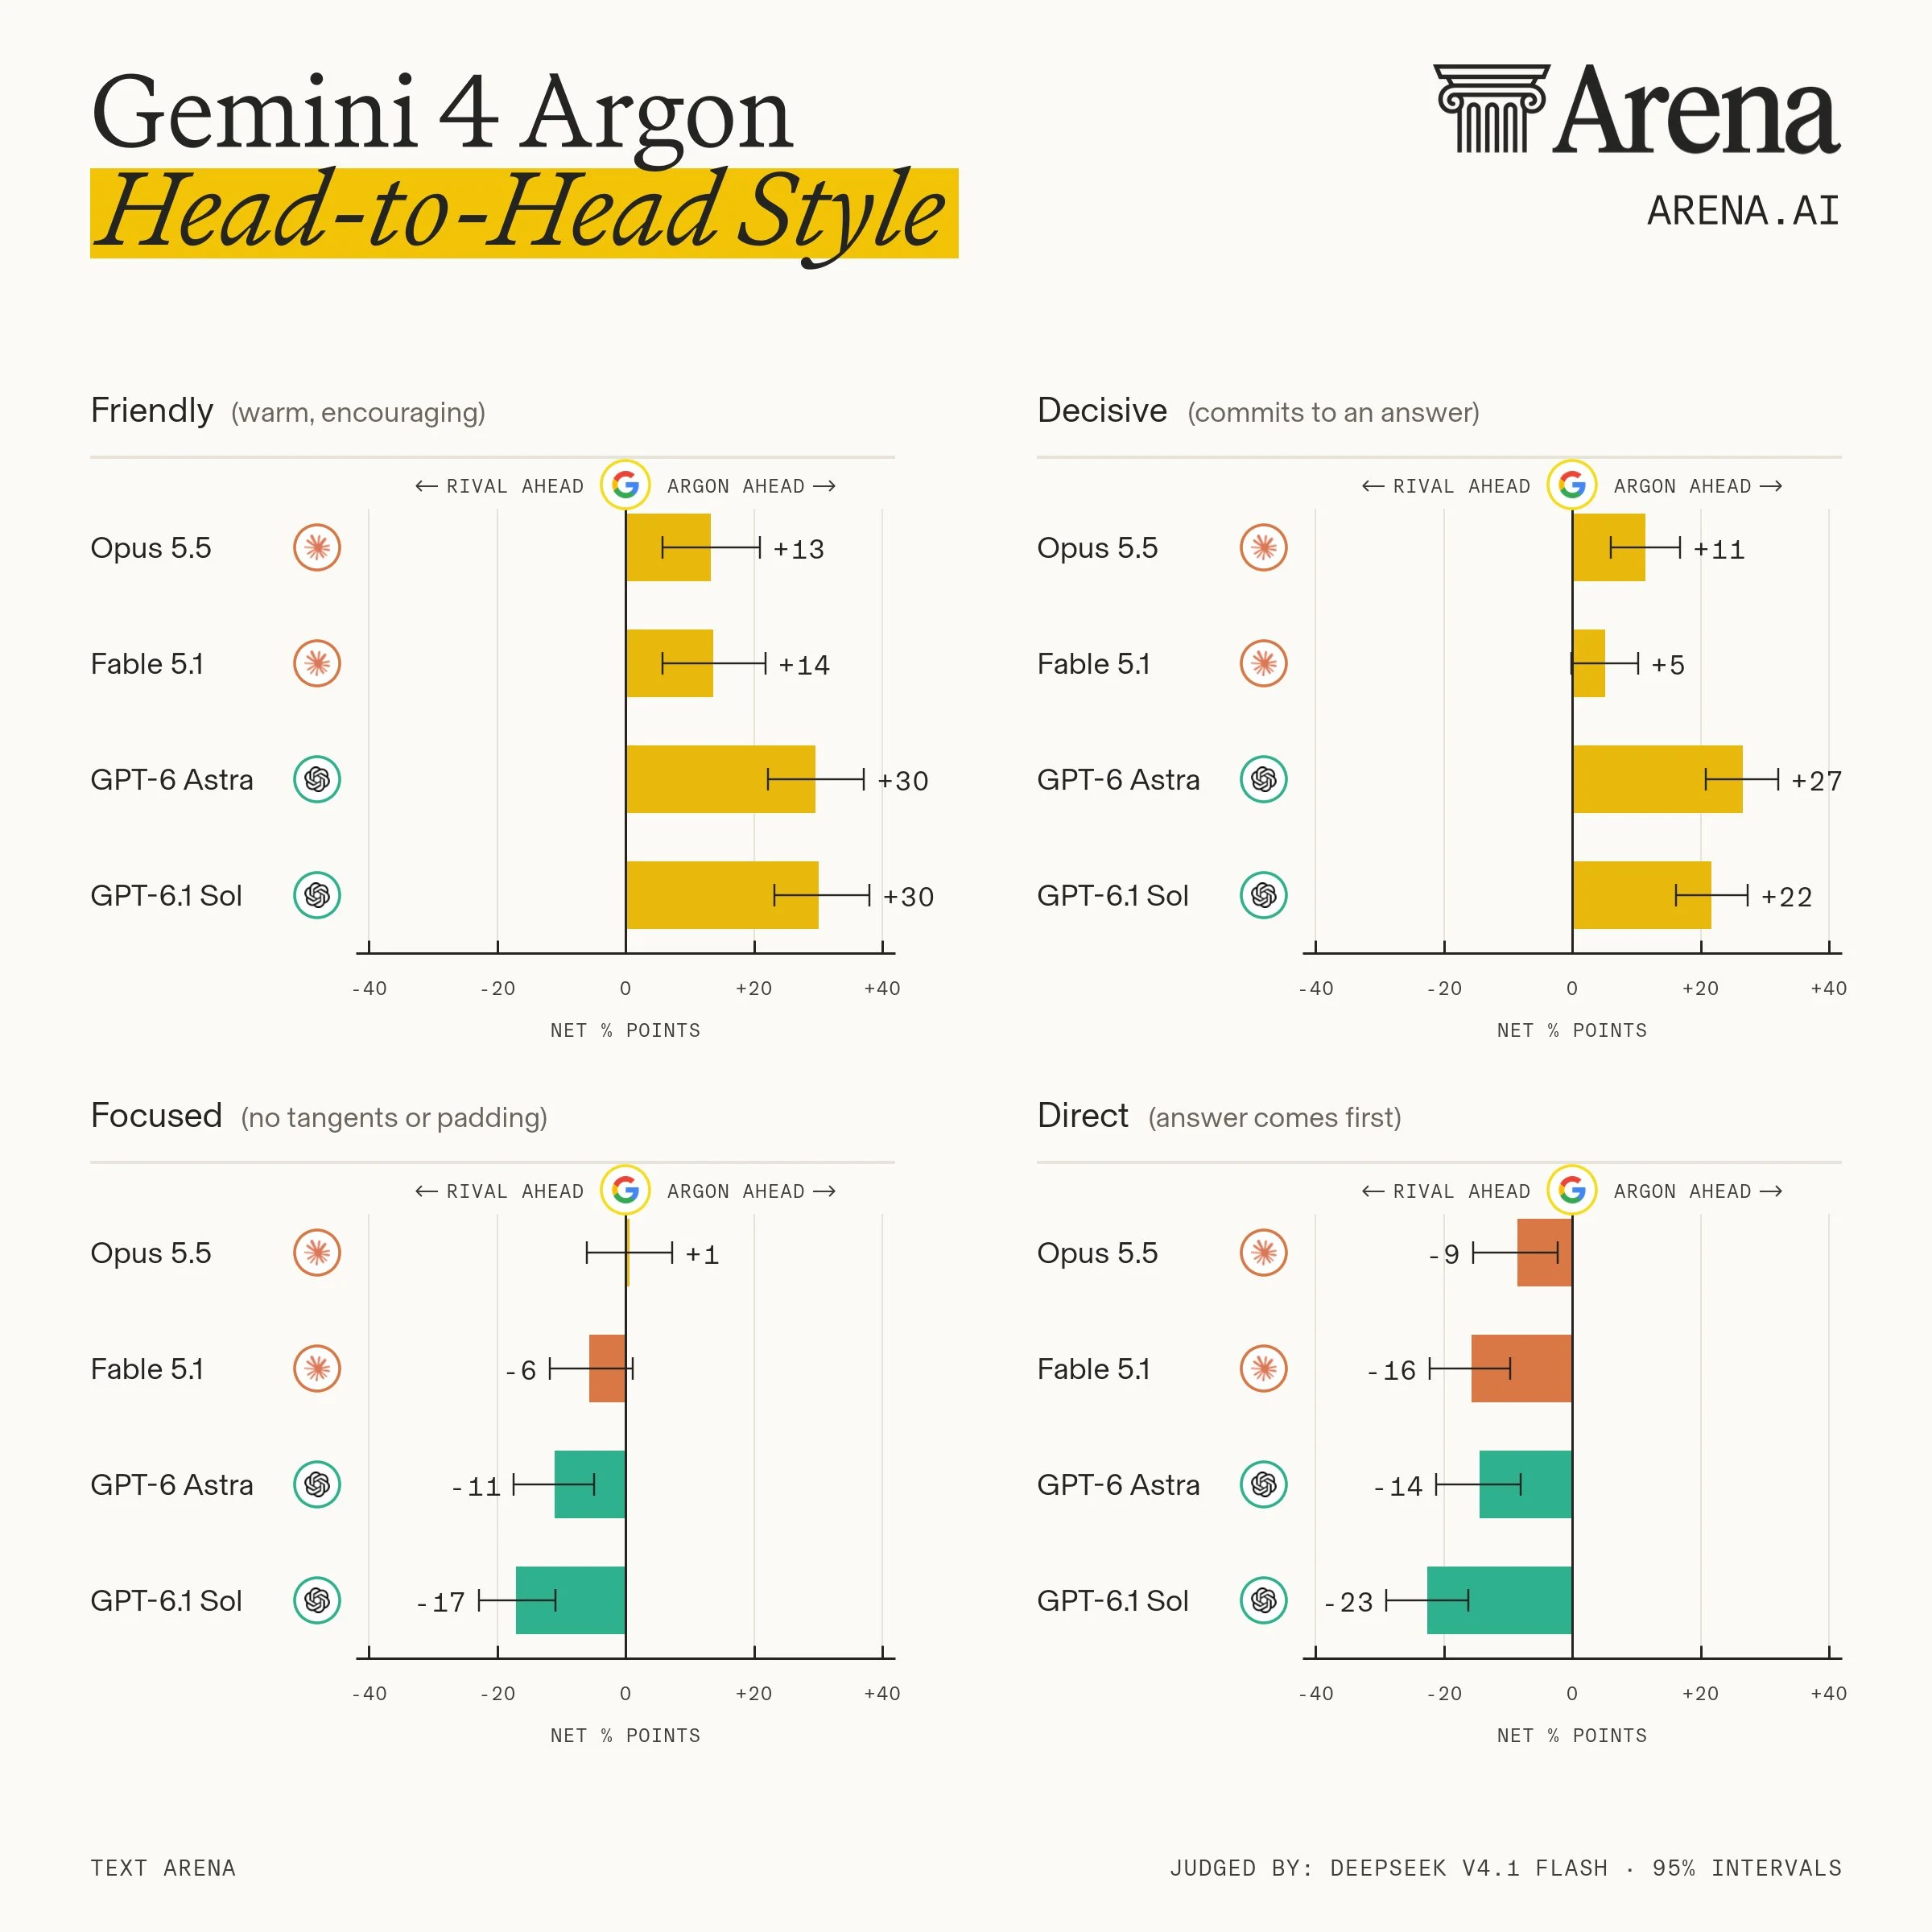
- La nueva versión de @GoogleDeepMind es más amigable y decisiva. Mantiene un tono cálido, alentador y claro. En contra de GPT-6.1 Sol, el juez de IA calificó a Argon como más amigable en el 55% de las comparaciones, mientras que Sol obtuvo solo el 25%. En contra de Opus 5.5, es del 46% frente al 32%.
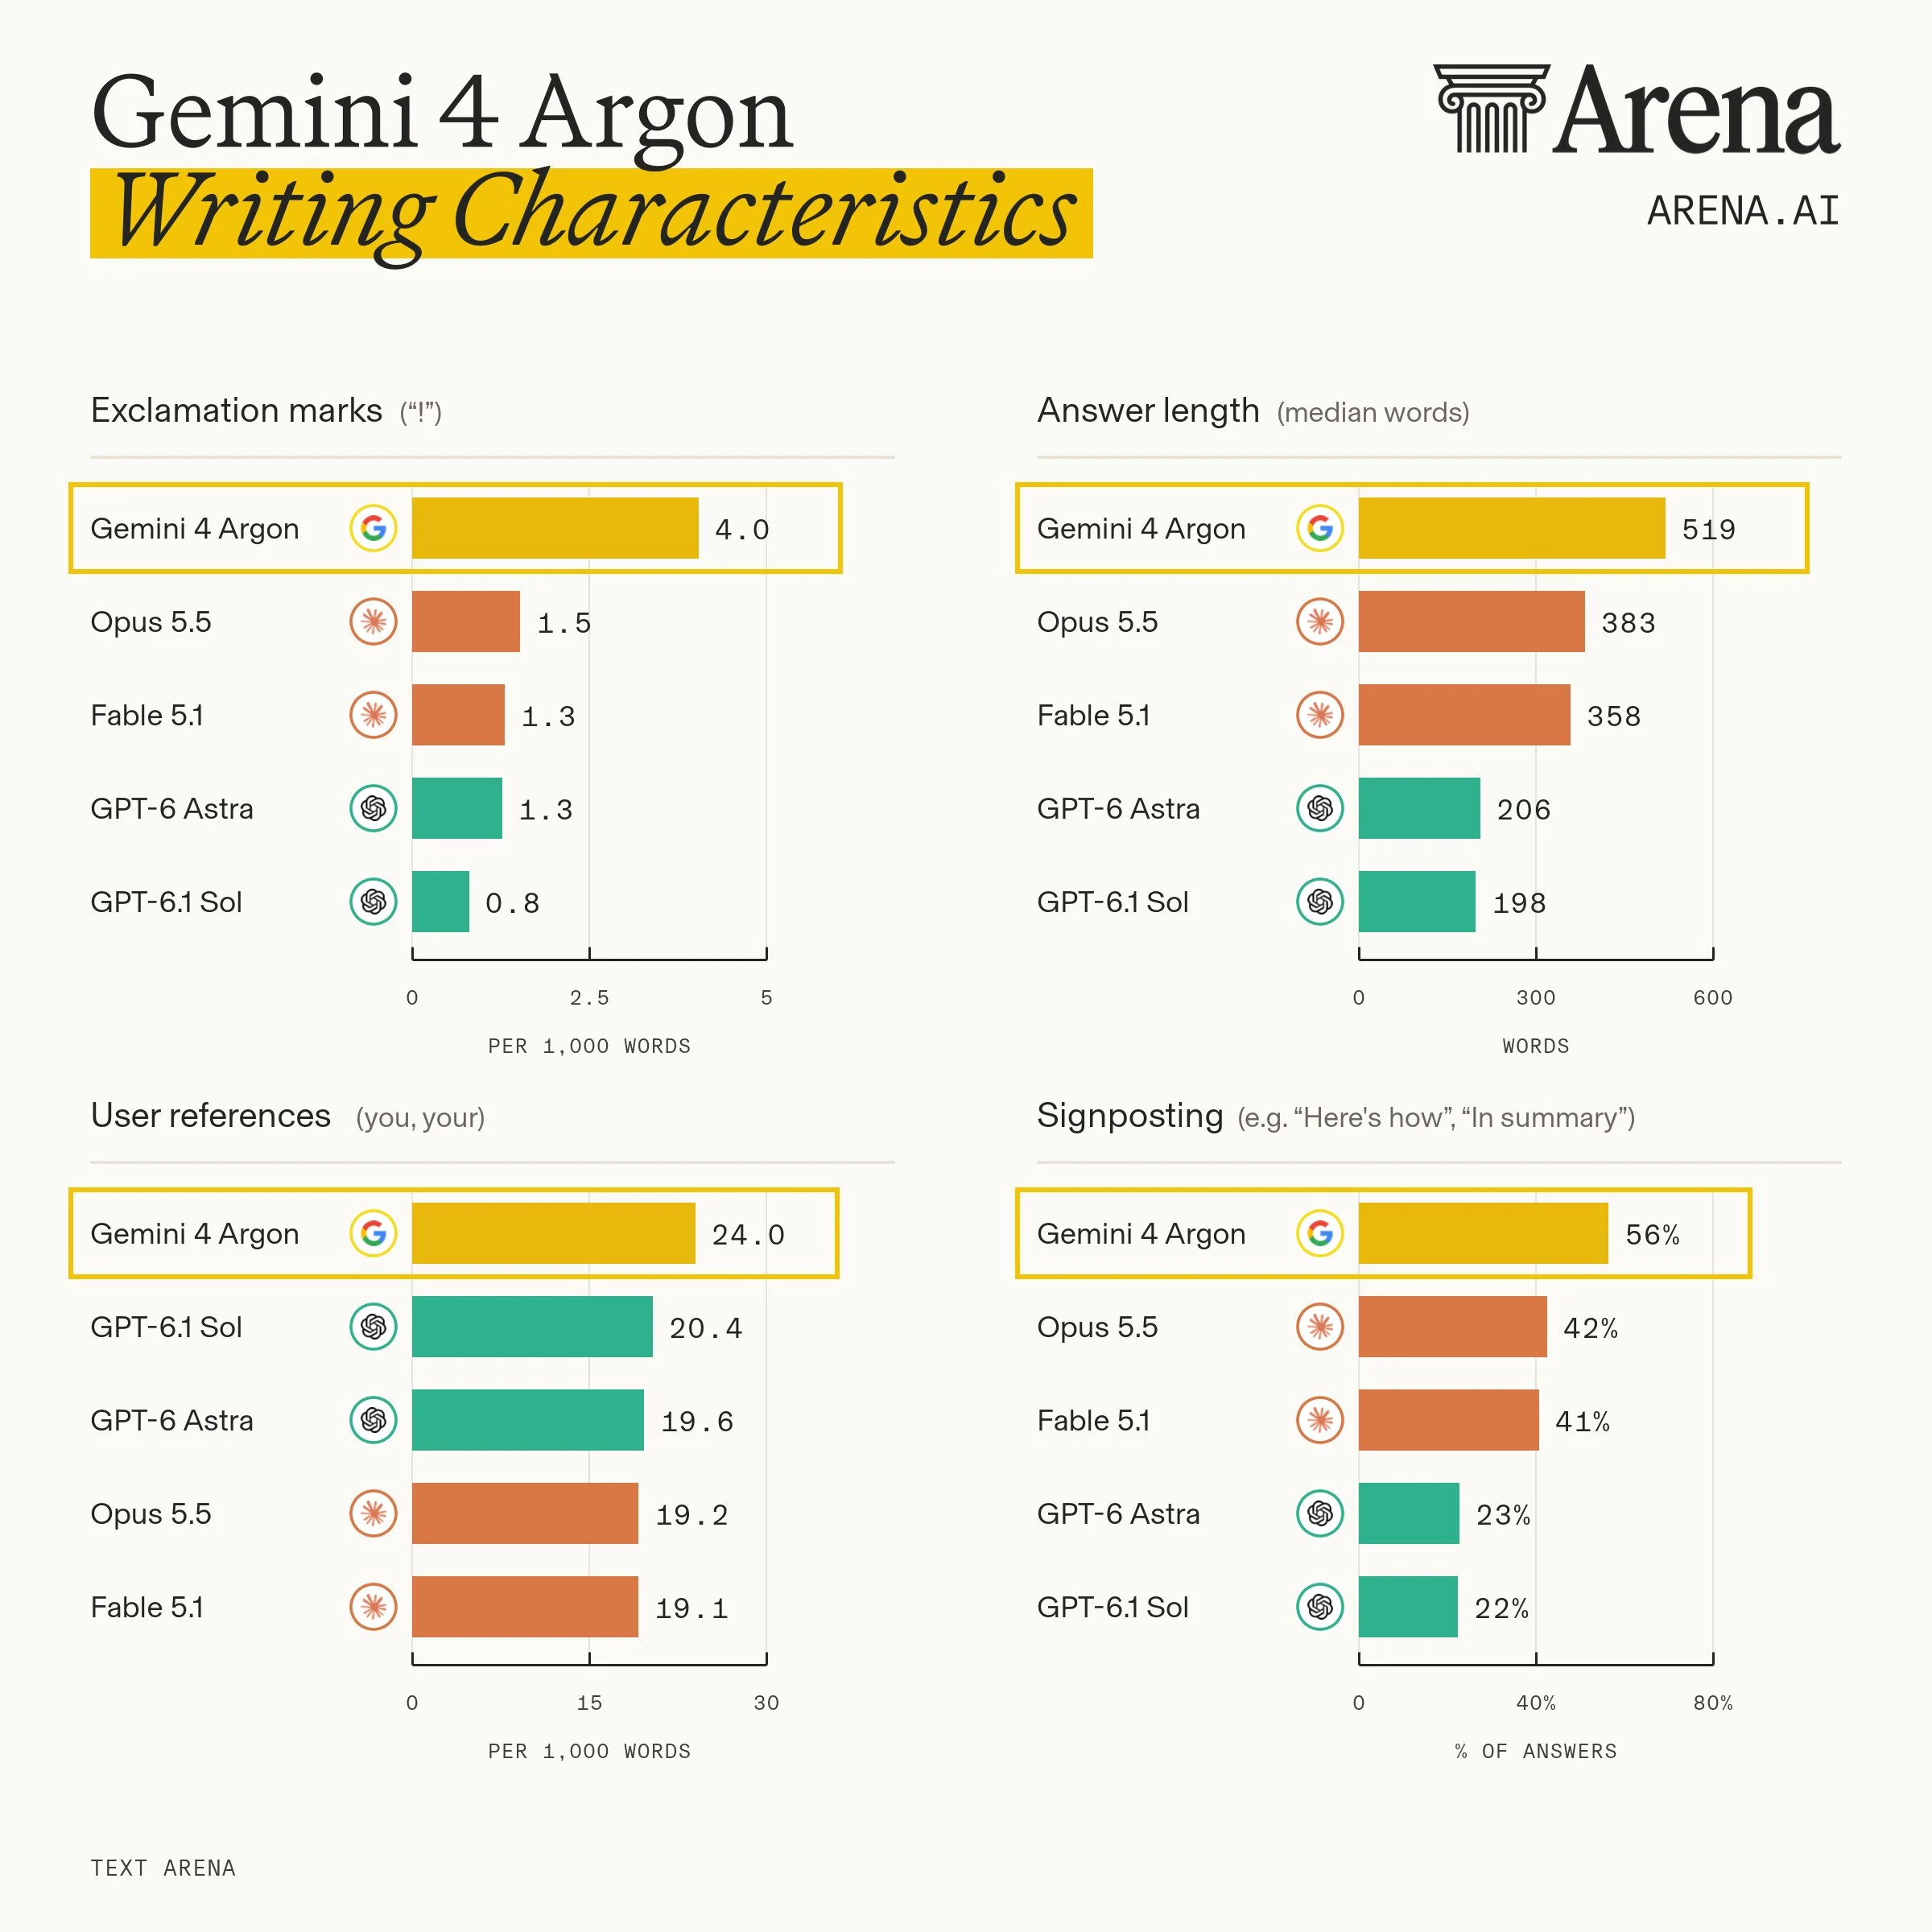
– Es más conversacional: el modelo se desvía más y es menos directo. Las respuestas de los rivales fueron calificadas como más directas en el 32-37% de las comparaciones, mientras que las de Argon fueron solo en el 14-23%. Esto también se refleja en la longitud de sus respuestas: la mediana de las respuestas de Argon es de 519 palabras, en comparación con 358-383 para Claude y aproximadamente 200 para los modelos GPT.
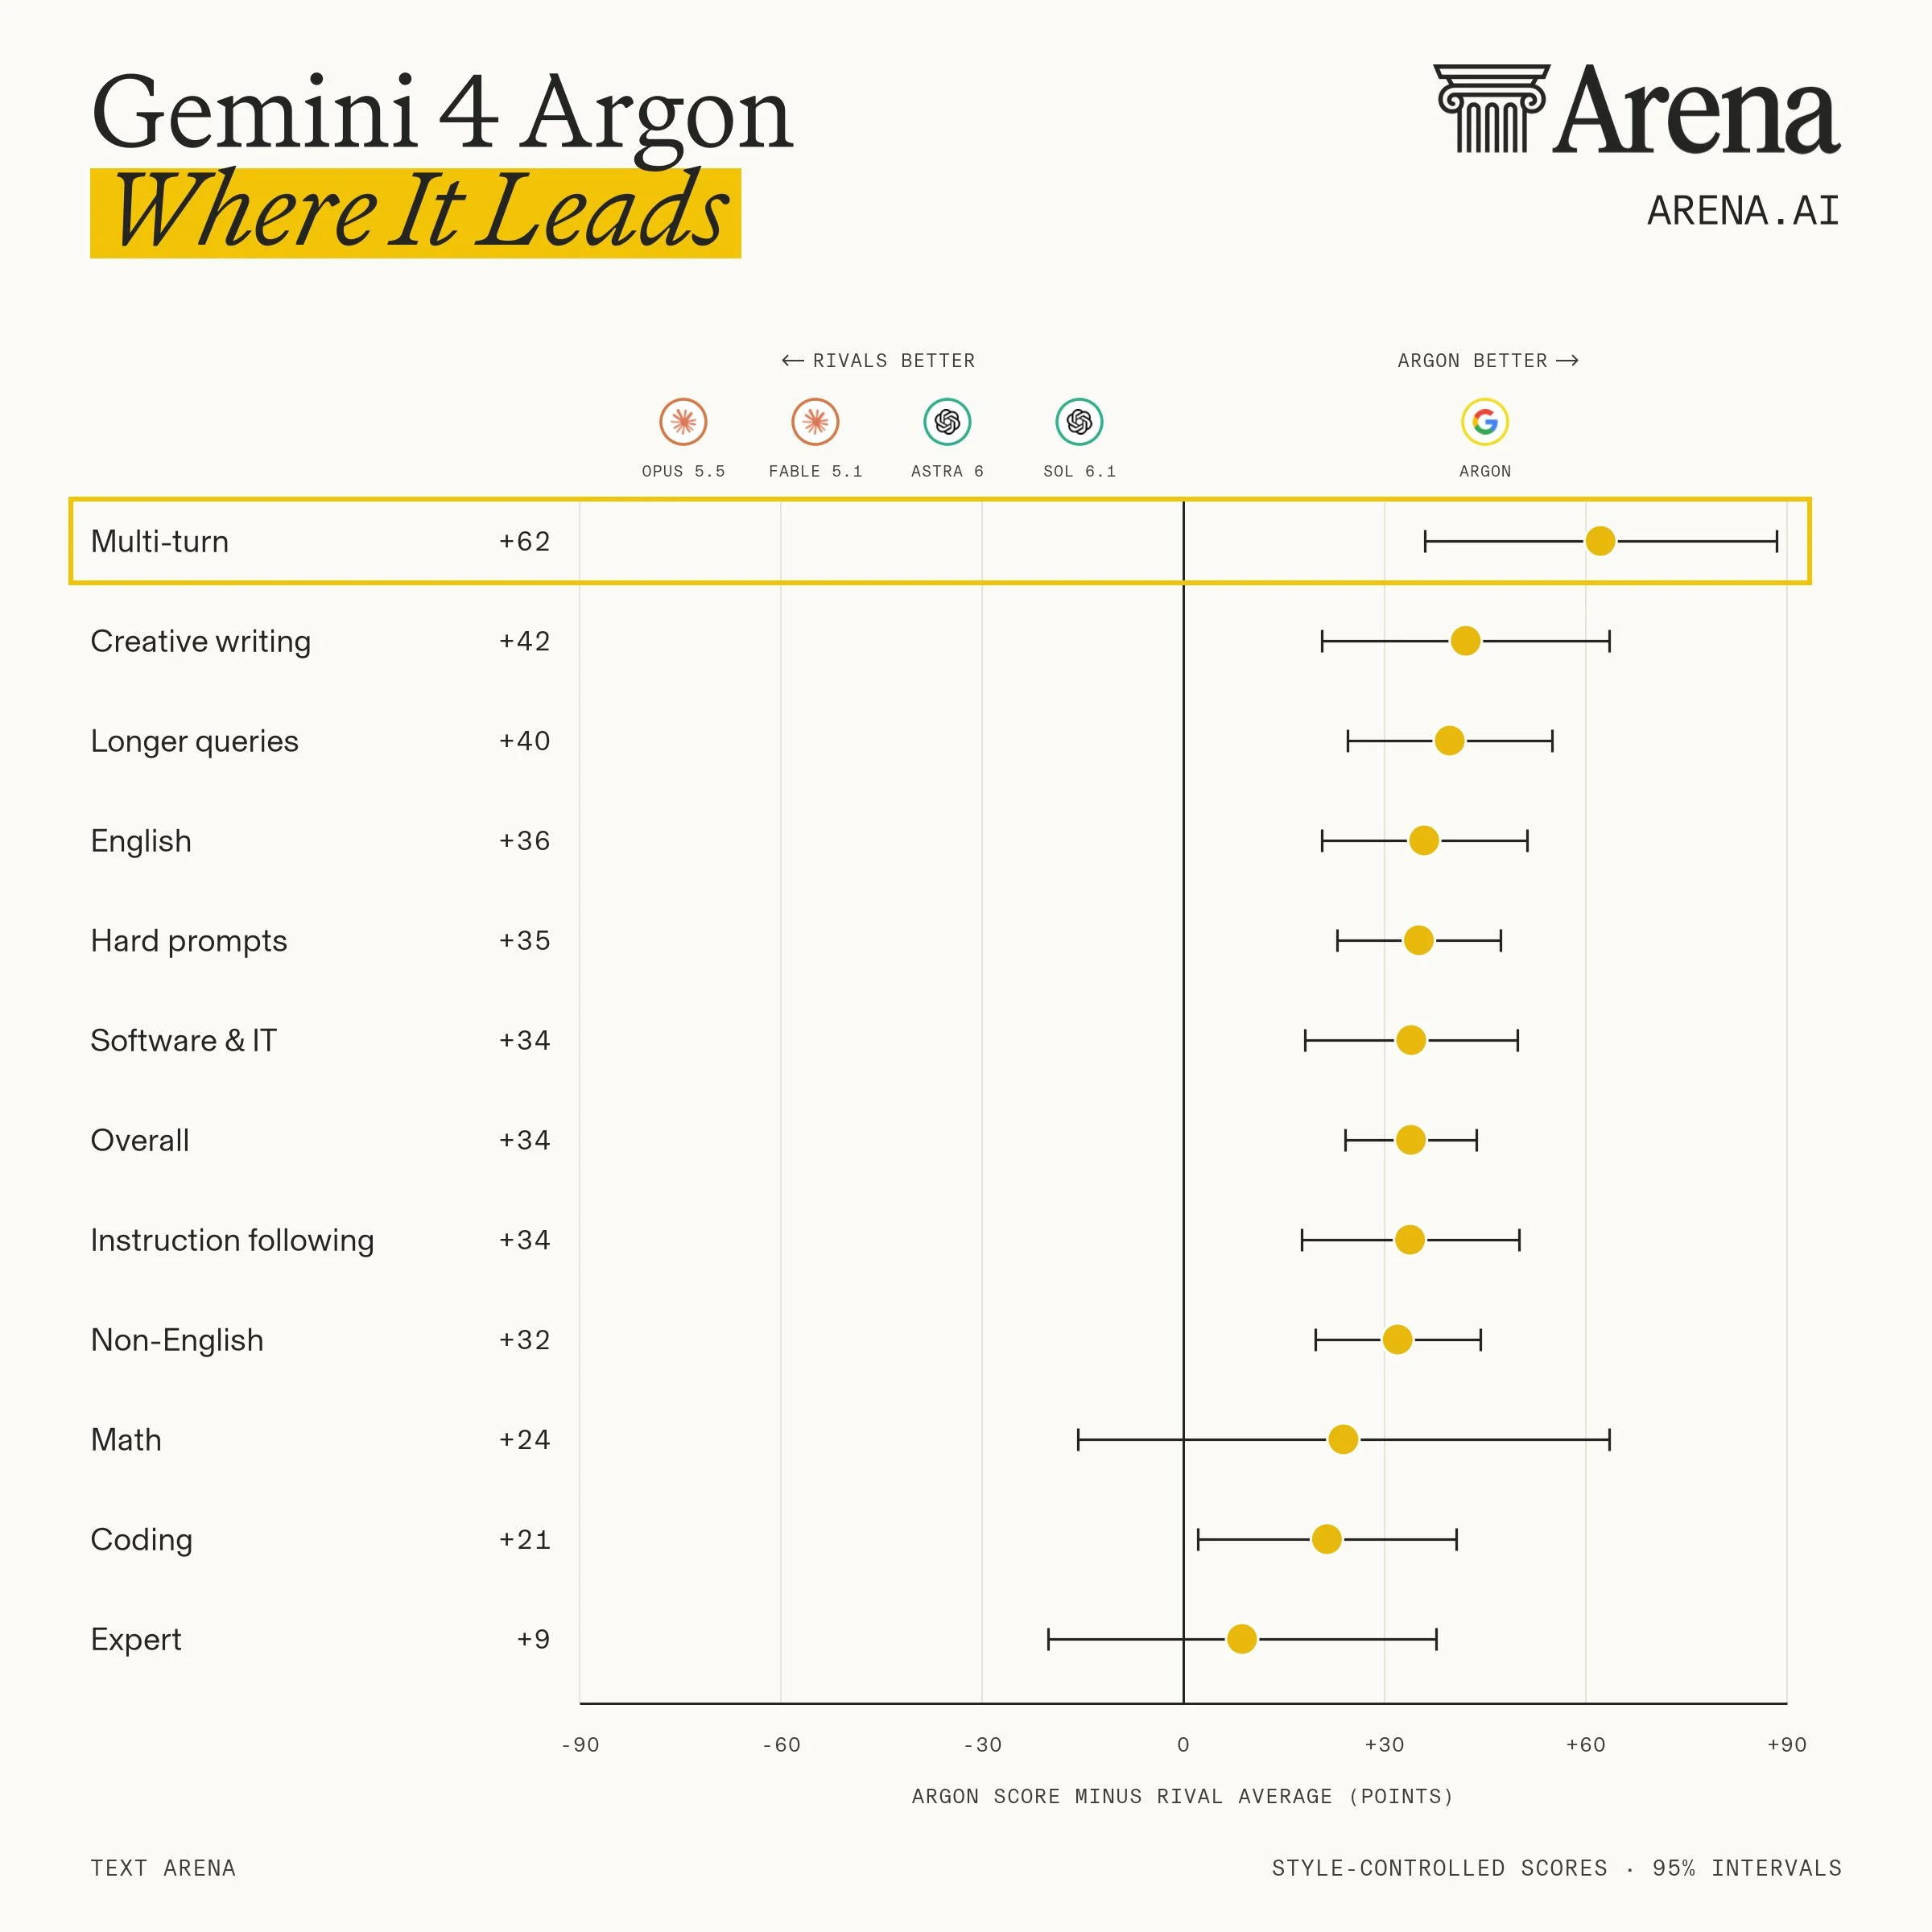
- Estos comportamientos se manifiestan en los votos de los usuarios. Argon tiene la ventaja más grande en los chat multitanuales (+62 puntos), la escritura creativa (+42) y las consultas más largas (+40); son estas categorías donde tal personalidad es de mayor importancia.
- Los indicadores más claros de su estilo accesible son su uso de signos de exclamación (aproximadamente 3 veces Opus 5.5 y 5 veces GPT-6.1 Sol), las referencias al usuario (24 por cada 1,000 palabras, en comparación con 19-20 para cada modelo rival) y las señales de orientación (56% de sus respuestas, frente a 41-42% para Claude y 22-23% para los modelos GPT).