
Elegir el modelo adecuado para una aplicación específica requiere un método práctico para probarlo con entradas representativas. Amazon SageMaker JumpStart proporciona acceso a un amplio catálogo de modelos ya preentrenados. En este artículo, mostramos cómo desplegar un modelo disponible desde SageMaker JumpStart, ejecutar una prueba de rendimiento ligera y repetible utilizando el SDK Python de SageMaker, y eliminar el punto de acceso cuando la prueba esté completa. Para los modelos soportados y la capacidad disponible, este flujo de trabajo proporciona un camino de evaluación repetible, aunque el tiempo de despliegue varía según el modelo, el tipo de instancia, la cuota y la región de AWS.
En 2026, SageMaker JumpStart introdujo dos mejoras que simplifican el descubrimiento y la implementación de modelos. En la sección Model Hub de la consola Amazon SageMaker AI, se puede navegar por el catálogo de SageMaker JumpStart, ver ejemplos de notebooks y abrirlos directamente en SageMaker Studio. Las opciones de despliegue de endpoint preconfiguradas proporcionan configuraciones nombradas optimizadas para prioridades como bajo costo, baja latencia o cargas de trabajo de uso general en una gama de modelos de inteligencia artificial generativa, incluyendo configuraciones optimizadas por Neuron. Además, ahora se puede pasar de la descubrimiento de modelos de Hugging Face al despliegue de AI de SageMaker con un solo clic, mediante la nueva integración de deep link.
Descripción general de la solución
Nuestro enfoque utiliza un script de Python reutilizable que realiza tres pasos:
- Descubre y despliega un modelo desde SageMaker JumpStart.
- Ejecute los prompts de muestra específicos del modelo y mida la latencia, la longitud aproximada de la salida y la tasa de generación de una solicitud única.
- Limpiar el punto final.
Este patrón funciona para muchos modelos SageMaker JumpStart compatibles, aunque los formatos de carga, los tipos de instancias requeridos, los requisitos del acuerdo de licencia para el usuario final (EULA) y los esquemas de respuesta pueden requerir ajustes específicos para cada modelo.
Requisitos previos
- Un cuenta de AWS con permisos para SageMaker AI.
- Python 3+ con SageMaker Python SDK v3 instalado (
pip install "sagemaker>=3,<4"). - Cantidad suficiente de instancias GPU para el modelo que desea probar o solicitar un aumento de cuota.
Paso 1.a: Descubrir los modelos disponibles
Ruta de la interfaz de usuario para encontrar modelos en SageMaker JumpStart:
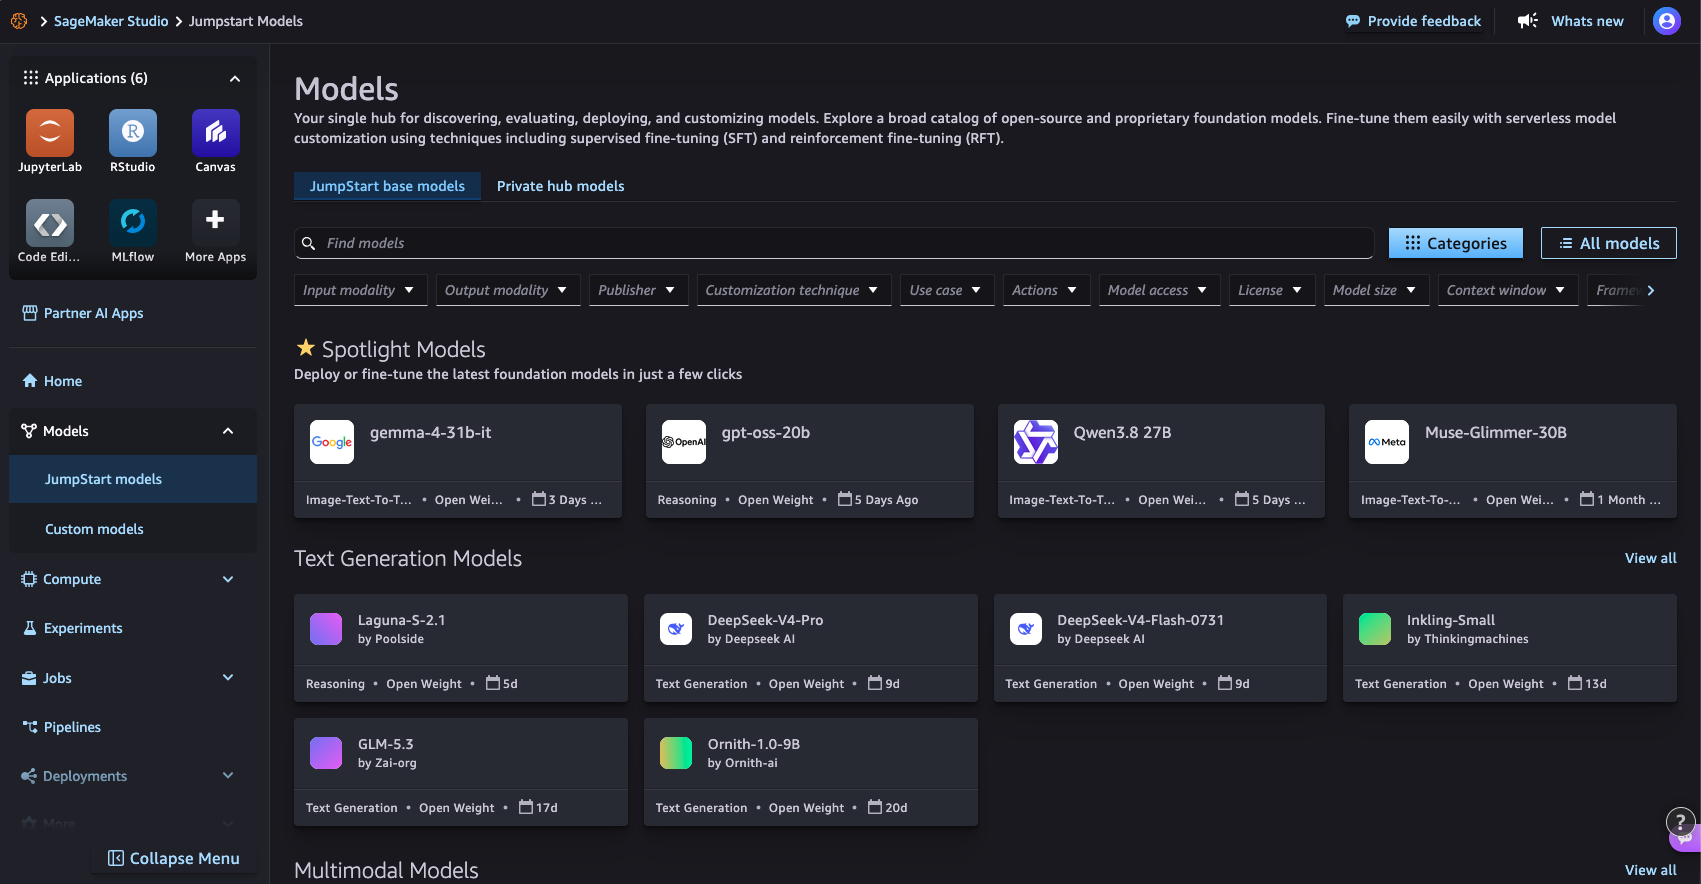
Figura 1: Navegación por el catálogo de modelos en la página SageMaker JumpStart Models en SageMaker Studio
Ruta de código que utiliza el SDK de Python de SageMaker:
from sagemaker.core.jumpstart.notebook_utils import (
    list_jumpstart_models,
)

REGION = "us-east-1"

models = list_jumpstart_models(
    filter="task == textgeneration",
    region=REGION,
    list_versions=True,
)

print(f"Found {len(models)} text generation models")

for model_id, model_version in models[:10]:
    print(
        f" - {model_id} "
        f"(version {model_version})"
    )
O busque por nombre del modelo:
from sagemaker.core.jumpstart.notebook_utils import list_jumpstart_models

ids = list_jumpstart_models(
    filter="model_id contains qwen",
    region=REGION,
    list_versions=True,
)

print(f"{len(ids)} models matched in {REGION}\n")

for model_id, version in ids:
    print(f"{model_id:<55} v{version}")
Paso 1.b: Implementar el modelo
Ruta de UI para desplegar modelos desde SageMaker JumpStart:
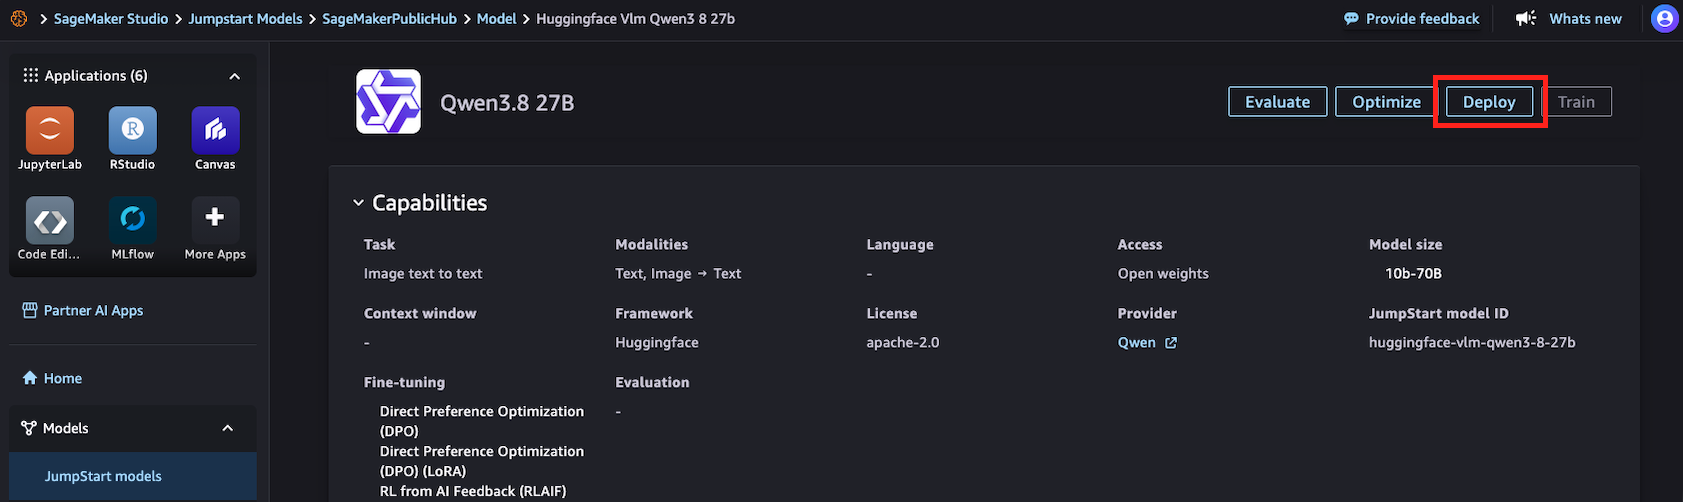
Figura 2: Desplegar un modelo desde la página de detalles de SageMaker JumpStart en SageMaker Studio
Ruta de código que utiliza el SDK de Python de SageMaker:
import time

from sagemaker.core.jumpstart.accessors import JumpStartModelsAccessor
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.core.training.configs import Compute
from sagemaker.serve import ModelBuilder

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"
ACCEPT_EULA = False  # Set True only after reviewing the model terms

def get_field(value, name, default=None):
    if isinstance(value, dict):
        return value.get(name, default)
    return getattr(value, name, default)

# Resolve the JumpStart-recommended deployment configuration.
specs = JumpStartModelsAccessor().get_model_specs(
    region=REGION,
    model_id=MODEL_ID,
    version=MODEL_VERSION,
)

if isinstance(specs, list):
    if not specs:
        raise ValueError(
            f"No JumpStart specification found for {MODEL_ID}"
        )
    specs = specs[0]

recommended_instance_type = get_field(
    specs,
    "default_inference_instance_type",
)

if not recommended_instance_type:
    raise ValueError(
        f"No recommended instance type found for {MODEL_ID}"
    )

print(f"Model: {MODEL_ID}")
print(f"Region: {REGION}")
print(f"Recommended instance: {recommended_instance_type}")

start = time.time()

jumpstart_config = JumpStartConfig(
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    accept_eula=ACCEPT_EULA,
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(
        instance_type=recommended_instance_type,
        instance_count=1,
    ),
)

model = model_builder.build()
endpoint = model_builder.deploy()
deploy_time = time.time() - start

print(f"Deployed in {deploy_time:.1f} seconds")
print(f"Endpoint: {endpoint.endpoint_name}")
Paso 2: Ejecuta los prompts de muestra y mide el rendimiento
from sagemaker.core.payloads import retrieve_all_examples
import json
import time

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"

example_payloads = retrieve_all_examples(
    region=REGION,
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    serialize=True,
)

#you can re-create the endpoint pointer using the endpoint name:
#from sagemaker.core.resources import Endpoint
#endpoint = Endpoint.get(endpoint_name="<your_endpoint_name>",region=REGION)

def read_response_body(result):
    body = result.body
    if hasattr(body, "read"):
        body = body.read()
    if isinstance(body, bytes):
        body = body.decode("utf-8")
    if isinstance(body, str):
        try:
            return json.loads(body)
        except json.JSONDecodeError:
            return body
    return body

def extract_output(response):
    """Handle common JumpStart text-generation response formats."""
    if isinstance(response, list):
        response = response[0] if response else ""
    if isinstance(response, dict):
        choices = response.get("choices")
        if choices:
            choice = choices[0]
            message = choice.get("message")
            if isinstance(message, dict):
                return message.get("content", "")
            return choice.get("text", "")
        for field in (
            "generated_text",
            "output_text",
            "text",
        ):
            if field in response:
                return response[field]
    return response

results = []

for payload in example_payloads or []:
    start = time.perf_counter()
    result = endpoint.invoke(
        body=payload.body,
        content_type=payload.content_type,
        accept=payload.accept,
    )
    latency = time.perf_counter() - start
    response = read_response_body(result)
    output = extract_output(response)
    if not isinstance(output, str):
        output = json.dumps(output, indent=2)
    # This is an estimate based on whitespace-separated words.
    output_words = len(output.split())
    results.append(
        {
            "request_preview": payload.body[:50],
            "latency_s": round(latency, 2),
            "estimated_output_words": output_words,
            "words_per_second": round(
                output_words / latency,
                1,
            ) if latency > 0 else 0,
        }
    )
    print("Input:\n", payload.body, end="\n\n")
    print("Output:\n", output, end="\n\n")
    print(
        f"Latency: {latency:.2f} seconds\n"
        f"Estimated output words: {output_words}\n"
        f"Estimated single-request output generation rate: "
        f"{output_words / latency:.1f} words/second\n"
    )
    print("-" * 80)

print("\nSummary:")
for result in results:
    print(result)
Resultado:
Input:
{"max_tokens": 256, "messages": [{"content": "What is deep learning?", "role": "user"}], "model": "/opt/ml/model"}
Output:
Here's a thinking process that leads to the explanation of deep learning:
1. **Deconstruct the Request:**
* **Question:** "What is deep learning?"
* **Intent:** The user wants a clear, comprehensive, yet accessible definition and overview of deep learning.
* **Target Audience:** Likely someone looking for a general understanding, possibly a student, tech
enthusiast, or professional exploring the field. The tone should be informative, structured, and
not overly jargon-heavy (though key terms need explanation).
2. **Initial Brainstorming & Key Concepts:**
* What is it? A subset of machine learning, which is a subset of AI.
* Core mechanism: Artificial Neural Networks (ANNs).
* "Deep" means many layers (hidden layers).
* How does it work? Learning representations from data (feature learning).
* Key applications: Image recognition, NLP, speech, self-driving cars.
* Why is it popular now? Big data, GPU power, better algorithms.
* Pros/Cons: High accuracy vs. black box, data hunger.
3. **Structuring the Answer:**
Latency: 9.07 seconds
Estimated output words: 153
Estimated single-request output generation rate: 16.9 words/second
--------------------------------------------------------------------------------
Summary:
{'request_preview': '{"max_tokens": 256, "messages": {"content": "What', 'latency_s': 9.07, 'estimated_output_words': 153, 'words_per_second': 16.9}
Paso 3: Limpieza
print(f"Deleting endpoint: {endpoint.endpoint_name}")
endpoint.delete()
endpoint.wait_for_delete()
print("Endpoint deleted")
Conclusión
Este patrón funciona para muchos modelos disponibles de SageMaker JumpStart, pero el formato de carga útil, el tipo de instancia requerido, el EULA y el análisis de la respuesta pueden requerir ajustes específicos para cada modelo. Al utilizar prompts de prueba consistentes y medir la latencia, el rendimiento y la calidad del resultado entre los modelos, puede comparar las opciones y seleccionar el que se adapte mejor a su carga de trabajo.
Pruebe este enfoque con diferentes modelos de Amazon SageMaker JumpStart para encontrar el equilibrio adecuado entre calidad, velocidad y costo para sus aplicaciones.
Referencias
- Documentación del SDK de Python de SageMaker
- Evaluación y optimización del despliegue JumpStart de SageMaker (artículo de blog)
- De Hugging Face a SageMaker Studio en un clic (entrada de blog)
- Amazon SageMaker JumpStart