
Un equipo de servicios financieros dedica una cantidad significativa de tiempo cada semana a crear manualmente presentaciones de PowerPoint para clientes a partir de informes trimestrales, documentos de cumplimiento y análisis de mercado. Cada presentación requiere leer cientos de páginas, extraer puntos de datos clave, estructurar diapositivas y generar visualizaciones de apoyo. Esta publicación le guía en la creación de un sistema de agentes de IA utilizando Amazon Bedrock AgentCore que automatiza este flujo de trabajo, completándolo en menos de 90 segundos en nuestras pruebas internas. Este enfoque reduce el tiempo de creación de presentaciones mientras fundamenta el contenido en los documentos de origen. La solución despliega un agente supervisor en AgentCore runtime, una capacidad de Amazon Bedrock AgentCore, utilizando el marco de trabajo Strands Agents para orquestar las herramientas de generación y resumen de documentos. Anthropic Claude Sonnet 4.6 (disponible en Amazon Bedrock) gestiona la creación de contenido, Amazon Titan Text Embeddings v2 potencia la búsqueda vectorial, y Stability AI Stable Image Inpaint (disponible en Amazon Bedrock) genera las imágenes de las diapositivas. Esta publicación incluye un repositorio público con los recursos de código.
Descripción general de la solución
La solución despliega un único agente supervisor en Amazon Bedrock AgentCore runtime que selecciona entre las herramientas de generación de documentos y resumen según las solicitudes del usuario. Un pipeline de Generación Aumentada por Recuperación (RAG) utiliza Amazon OpenSearch Serverless para el almacenamiento vectorial y la búsqueda semántica en contenido multimodal.
La solución incluye una API REST construida con .NET 8 minimal APIs, de modo que puede integrarse con aplicaciones empresariales existentes mediante llamadas HTTP estándar. AWS Lambda ofrece computación sin servidor, incluidas funciones en contenedores para la generación de PowerPoint. La solución protege la implementación con aislamiento de Amazon Virtual Private Cloud (Amazon VPC) , cifrado de AWS Key Management Service (AWS KMS) y control de acceso con privilegios mínimos de AWS Identity and Access Management (IAM) .
Conceptos clave
Esta sección cubre AgentCore runtime, RAG y las barreras de seguridad de contenido tal como se aplican a esta solución.
Orquestación de agentes con Amazon Bedrock AgentCore
Un único agente de IA que genera documentos a partir de grandes bases de conocimiento debe recuperar contenido, estructurar esquemas, generar texto, crear imágenes y ensamblar archivos. En lugar de implementar estas responsabilidades en competencia dentro de una función monolítica, la solución utiliza una arquitectura basada en herramientas en la que un agente supervisor dirige las solicitudes a herramientas especializadas.
Amazon Bedrock AgentCore runtime proporciona una plataforma para construir, conectar y optimizar agentes a escala, con cualquier marco de trabajo o modelo. El código del agente se ejecuta en un contenedor aislado con gestión de sesiones, identidad integrada y observabilidad. La solución utiliza el marco Strands Agents (un SDK de código abierto para construir agentes de IA) para implementar la lógica del supervisor.
El agente supervisor expone dos herramientas:
- generate_pptx: Crea presentaciones de PowerPoint invocando la función Lambda PPTX Generator, que recupera contenido de la base de conocimiento, genera esquemas de diapositivas, crea imágenes con IA y ensambla el documento final.
- generate_summary: Extrae y sintetiza información de la base de conocimiento utilizando RAG para entregar respuestas precisas y fundamentadas.
El agente determina si una solicitud requiere generación de documentos, resumen de contenido o ambos, y luego invoca la herramienta apropiada. Puede añadir nuevas capacidades definiendo nuevas herramientas en el código del agente sin modificar las existentes.
Generación Aumentada por Recuperación (RAG) para el conocimiento empresarial
RAG aborda un desafío fundamental en los sistemas de IA: entregar información precisa y actualizada fundamentada en datos empresariales en lugar de depender únicamente de los datos de entrenamiento del modelo. La implementación utiliza Amazon Bedrock Knowledge Bases, que combinan la búsqueda vectorial con modelos de lenguaje de gran escala (LLM) para recuperar contexto relevante antes de generar las respuestas.
El pipeline de RAG funciona de la siguiente manera:
- Usted carga documentos empresariales en Amazon Simple Storage Service (Amazon S3).
- El sistema divide y analiza los documentos, aplicando un manejo especial para contenido multimodal que incluye tablas, gráficos e imágenes.
- Amazon Titan Text Embeddings v2 convierte cada fragmento en vectores de alta dimensión que capturan el significado semántico.
- Amazon OpenSearch Serverless almacena los vectores, creando una base de datos vectorial con capacidad de búsqueda.
- En el momento de la consulta, el sistema convierte la solicitud del usuario en un embedding y realiza una búsqueda de similitud para recuperar los fragmentos de documentos relevantes.
- Los fragmentos recuperados proporcionan contexto al modelo de lenguaje, el cual genera respuestas fundamentadas en el material de origen.
Este enfoque está diseñado para ayudar a reducir el contenido alucinado al fundamentar los documentos generados en información de origen proveniente de la base de conocimiento empresarial.
Nota: El plano de datos de la colección de Amazon OpenSearch Serverless debe permanecer accesible públicamente porque Amazon Bedrock Knowledge Bases accede a Amazon OpenSearch Serverless desde infraestructura administrada por AWS, no a través de VPC endpoints del cliente. Las políticas de acceso de datos de IAM protegen la colección, y el acceso solo por VPC restringe el panel de Amazon OpenSearch Serverless.
Amazon Bedrock Guardrails para la seguridad del contenido
Las aplicaciones de IA empresariales requieren moderación de contenido para cumplir con los estándares organizacionales y los requisitos de cumplimiento. Amazon Bedrock Guardrails ofrece filtrado de contenido integrado y mecanismos de seguridad incorporados en toda la tubería de generación de documentos.
Los guardrails operan en múltiples etapas:
- Procesamiento de entrada: Filtra las solicitudes de los usuarios para ayudar a prevenir problemas de inyección y contenido inapropiado.
- Generación de salida: Monitorea las salidas del modelo para verificar el cumplimiento de las políticas de contenido.
- Manejo de información de identificación personal (PII): Detecta y anonimiza o bloquea la PII.
La implementación crea guardrails personalizados mediante AWS Cloud Development Kit (AWS CDK), configurados con políticas específicas adaptadas a la creación de documentos empresariales. El agente aplica los guardrails a nivel de invocación del modelo, proporcionando una seguridad de contenido consistente sin requerir configuración manual para cada implementación.
Arquitectura de la solución
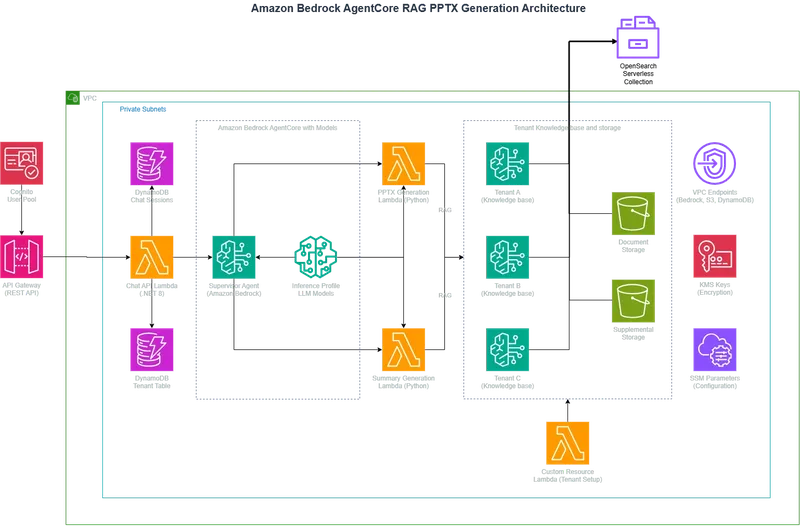
El siguiente diagrama ilustra el sistema de generación de documentos basado en agentes.
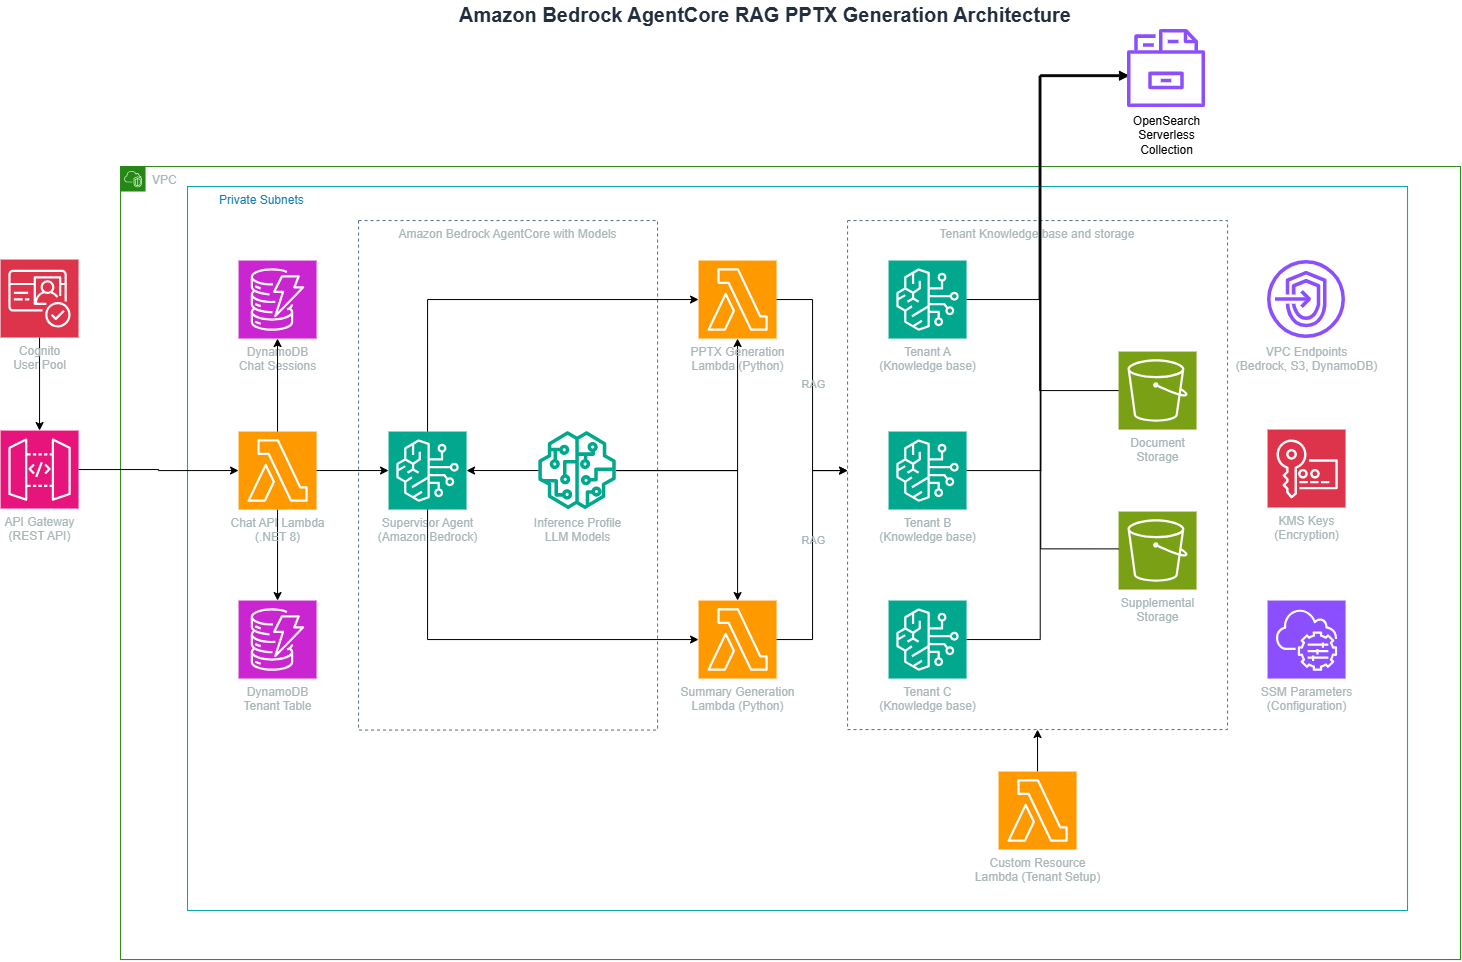
Figura 1: Arquitectura del sistema de generación de presentaciones RAG de Amazon Bedrock AgentCore
El flujo de datos comienza con las solicitudes de los usuarios que llegan a través de Amazon API Gateway, que las enruta a una Chat API basada en .NET que se ejecuta en AWS Lambda. La API mantiene el estado de la conversación en Amazon DynamoDB. Luego invoca al agente supervisor alojado en el runtime de Amazon Bedrock AgentCore.
El agente supervisor analiza la solicitud y selecciona la herramienta adecuada. Para la generación de documentos, invoca al PPTX Generator Lambda (una función de Python en contenedor). Para la resumisión, el supervisor invoca al Summary Generator Lambda, que consulta la base de conocimiento a través de la retrieve_and_generate API.
El sistema procesa, divide en fragmentos (chunks) y genera embeddings de los documentos almacenados en Amazon S3 usando Amazon Titan Text Embeddings v2. Amazon OpenSearch Serverless indexa los embeddings para una búsqueda semántica rápida. Cuando las herramientas consultan la base de conocimiento, Amazon OpenSearch Serverless recupera los fragmentos relevantes, que luego se suministran como contexto a Anthropic Claude Sonnet 4.6 (en Amazon Bedrock) para generar respuestas fundamentadas.
El sistema almacena los documentos generados en Amazon S3 y devuelve URL prefirmadas para una descarga segura. Las medidas de seguridad incluyen:
- AWS WAF con conjuntos de reglas administradas y limitación de tasa basada en IP en Amazon API Gateway.
- Amazon Cognito con el plan de funciones Plus y el modo de seguridad avanzada para la protección contra amenazas.
- Amazon Bedrock Guardrails aprovisionado mediante AWS CDK para un filtrado de contenido consistente.
- Amazon DynamoDB con recuperación en un punto en el tiempo, protección contra eliminación y cifrado administrado por el cliente con AWS KMS.
- Buckets de Amazon S3 con versionado, registro de acceso al servidor y bloqueo de acceso público.
- AWS X-Ray tracing en las funciones de Lambda para la depuración distribuida.
- Validación de entradas con verificación de ID de inquilino e ID de sesión basada en expresiones regulares.
- Aislamiento de inquilinos mediante la AWS Security Token Service (AWS STS) asunción de rol por inquilino.
Requisitos previos
Antes de realizar la implementación, necesita las siguientes herramientas y accesos configurados en su entorno:
- Entorno de AWS:
- Una cuenta de AWS activa con permisos para implementar infraestructura.
- AWS Command Line Interface (AWS CLI) configurado con credenciales.
- Rol de IAM con las políticas de acceso a servicios adecuadas.
- Herramientas de desarrollo:
- .NET SDK 8 con Amazon.Lambda.Tools instalado globalmente.
- Python 3.12 o posterior para AWS CDK y las funciones de Lambda.
- Node.js y AWS CDK CLI para el despliegue de infraestructura.
- Docker o Finch para compilar imágenes de contenedor (se requiere compatibilidad con ARM64).
- Acceso a servicios de AWS:
- Amazon Bedrock con acceso a modelos para Anthropic Claude Sonnet 4.6, Amazon Titan Text Embeddings v2 y Stability AI Stable Image Inpaint (disponible a través de Amazon Bedrock). Para conocer la disponibilidad de modelos por Región, consulte Modelos compatibles por Región de AWS en Amazon Bedrock.
- Amazon Bedrock AgentCore access enabled in your account.
- Tiempo de espera de integración de la API REST regional de Amazon API Gateway configurado en al menos 300 segundos. El valor predeterminado es de 29 segundos. Para obtener más información, consulte Cuotas de API Gateway.
- Una Amazon VPC existente con subredes privadas.
- Un bucket de Amazon S3 para los artefactos de despliegue.
Configurar la solución
El proceso de configuración incluye configurar los parámetros de despliegue e inicializar el entorno de AWS CDK.
- Clonar el repositorio y navegue hasta el directorio del proyecto:
git clone https://github.com/aws-samples/sample-generating-powerpoint-presentations-with-amazon-bedrock.git - Crear el archivo de configuración
pipeline-params.inien la raíz del repositorio:environment=dev awscliprofile= ContainerRegistry=lambda-pptx-gen AgentContainerRegistry=agentcore-supervisor BucketDev=<amzn-s3-demo-bucket> VpcId=<your-vpc-id> ParsingInferenceProfileId=us.anthropic.claude-haiku-4-5-20251001-v1:0 AgentInferenceProfileId=us.anthropic.claude-sonnet-4-6 EmbeddingModelId=amazon.titan-embed-text-v2:0 ImageGenerationModelId=stability.stable-image-inpaint-v1:0 PPTXGenImageTag=latest AgentImageTag=latestEstablezca
awscliprofilecon el nombre de su perfil de AWS CLI, o déjelo vacío para usar credenciales de variables de entorno. - Bootstrap AWS CDK (una vez por cuenta y Región):
cdk bootstrapEsto crea la pila CDKToolkit de AWS CloudFormation necesaria para los despliegues de AWS CDK.
- Hacer ejecutables los scripts de compilación:
chmod +x ./pipeline-build.sh
chmod +x ./pipeline-deploy.sh
chmod +x ./deploy-agentcore.sh
Compilar y desplegar
El despliegue consta de tres fases: compilación de artefactos, despliegue de infraestructura y despliegue del agente de ejecución de AgentCore.
Fase de compilación
La fase de compilación compila el código de la aplicación y empaqueta los artefactos de despliegue. Ejecute el script de compilación:
./pipeline-build.shEsto compila los proyectos .NET (Chat API) y los empaqueta como paquetes de despliegue de Lambda. Compila la imagen de contenedor del PPTX Generator usando Docker o Finch y se autentica en Amazon Elastic Container Registry (Amazon ECR). A continuación, envía la imagen del contenedor y almacena los artefactos de compilación en el directorio asset-output .
Fase de despliegue de la infraestructura
El despliegue de la infraestructura crea los recursos de AWS y configura las integraciones de servicios. Ejecute el script de despliegue:
./pipeline-deploy.shEl despliegue crea cuatro stacks de AWS CloudFormation en orden de dependencia:
- VPCEndpointsStack: Configura endpoints de Amazon VPC para los servicios de AWS, incluido Amazon Bedrock AgentCore.
- OpensearchStack: Aprovisiona una colección de Amazon OpenSearch Serverless para el almacenamiento de vectores.
- AgentCoreStack: Crea guardrails, funciones de Lambda, roles de IAM y almacena la configuración en AWS Systems Manager Parameter Store.
- ChatApiStack: Despliega Amazon API Gateway y la Lambda de Chat API.
Despliegue del runtime de AgentCore
Después de desplegar los stacks de infraestructura, despliegue el agente supervisor al runtime de AgentCore:
./deploy-agentcore.shEste script compila el contenedor del agente supervisor (ARM64), lo envía a Amazon ECR, crea el runtime y el endpoint de AgentCore, y actualiza el parámetro de Systems Manager con el ARN (Amazon Resource Name) del endpoint. La Chat API hace referencia a este ARN del endpoint para enrutar las solicitudes al agente.
Después del despliegue, las salidas de AWS CloudFormation incluyen la URL del endpoint de Amazon API Gateway y los identificadores de recursos.
Configuración
La solución ofrece varios puntos de configuración:
Instrucciones del agente
Edite agent/app.py para modificar el system prompt y el comportamiento del agente supervisor. El agente usa Strands Agents con dos herramientas definidas en agent/tools.py:
- generate_pptx: Invoca la Lambda PPTX Generator para la creación de documentos.
- generate_summary: Invoca la Lambda Summary Generator para consultas a la base de conocimiento.
Selección del modelo
En pipeline-params.ini, ajuste los identificadores de modelo:
ParsingInferenceProfileId: Modelo para el análisis de documentos de la base de conocimiento (se recomienda Anthropic Claude Haiku 4.5 por su eficiencia de costos).AgentInferenceProfileId: Modelo para el razonamiento del agente (se recomienda Anthropic Claude Sonnet 4.6).EmbeddingModelId: Modelo de embeddings para búsqueda vectorial (Amazon Titan Text Embeddings v2).ImageGenerationModelId: Modelo para la generación de imágenes de diapositivas (Stability AI Stable Image Inpaint).
Con perfiles de inferencia en lugar de IDs de modelo directos, las solicitudes utilizan un grupo de capacidad multi-Región más amplio, lo que aumenta el rendimiento y ayuda a mantener un desempeño consistente bajo carga.
Configuración de Lambda
Ajuste los recursos de cómputo en los archivos del stack:
- Chat API: 128 MB de memoria, tiempo de espera de 29 segundos, 100 de concurrencia reservada (en
api.py). - PPTX Generator: 900 MB de memoria, tiempo de espera de 300 segundos, 50 de concurrencia reservada (en
pptx_gen.py). - Summary Generator: 512 MB de memoria, tiempo de espera de 300 segundos, 50 de concurrencia reservada (en
sum_gen.py).
Resultados
En pruebas internas con un PDF de 90 páginas del Amazon 2024 Annual Report , la solución produjo las siguientes métricas de rendimiento:
- Tiempo de generación de la presentación: 70–90 segundos de extremo a extremo (incluyendo la recuperación de la base de conocimiento, la generación de contenido, la creación de imágenes y el ensamblado del archivo).
- Número de diapositivas: Seis diapositivas con formatos de título, viñetas, imagen+texto, solo imagen y conclusión.
- Generación de imágenes: Dos imágenes generadas por IA por presentación usando Stability AI Stable Image Inpaint.
- Costo por generación: Aproximadamente $0.04 en costos de invocación del modelo al momento de escribir esto en us-east-1 (generación de texto e imágenes, siendo la generación de imágenes la mayor parte del costo).
- Ingesta de la base de conocimiento: Menos de 2 minutos para un único documento PDF de 1.3 MB.
Presentaciones de PowerPoint
Las siguientes figuras muestran diapositivas de ejemplo de una presentación generada.
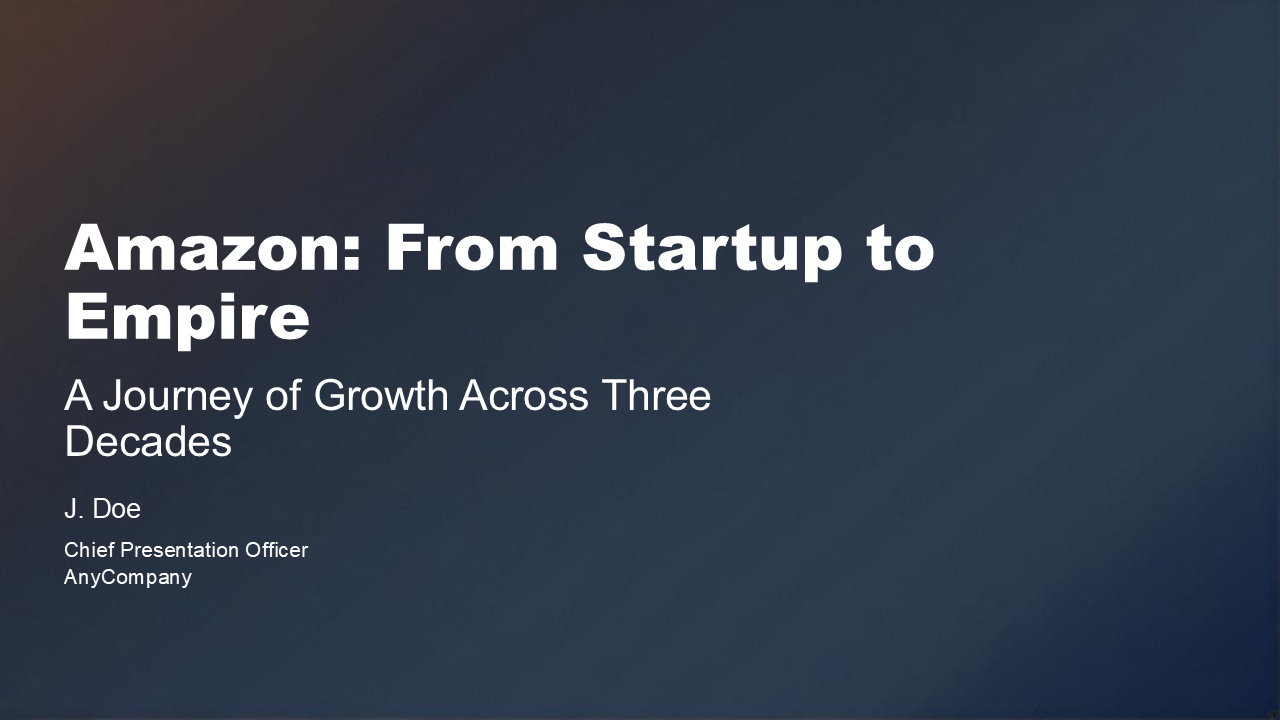
Figura 2: Diapositiva de título generada con marca personalizable
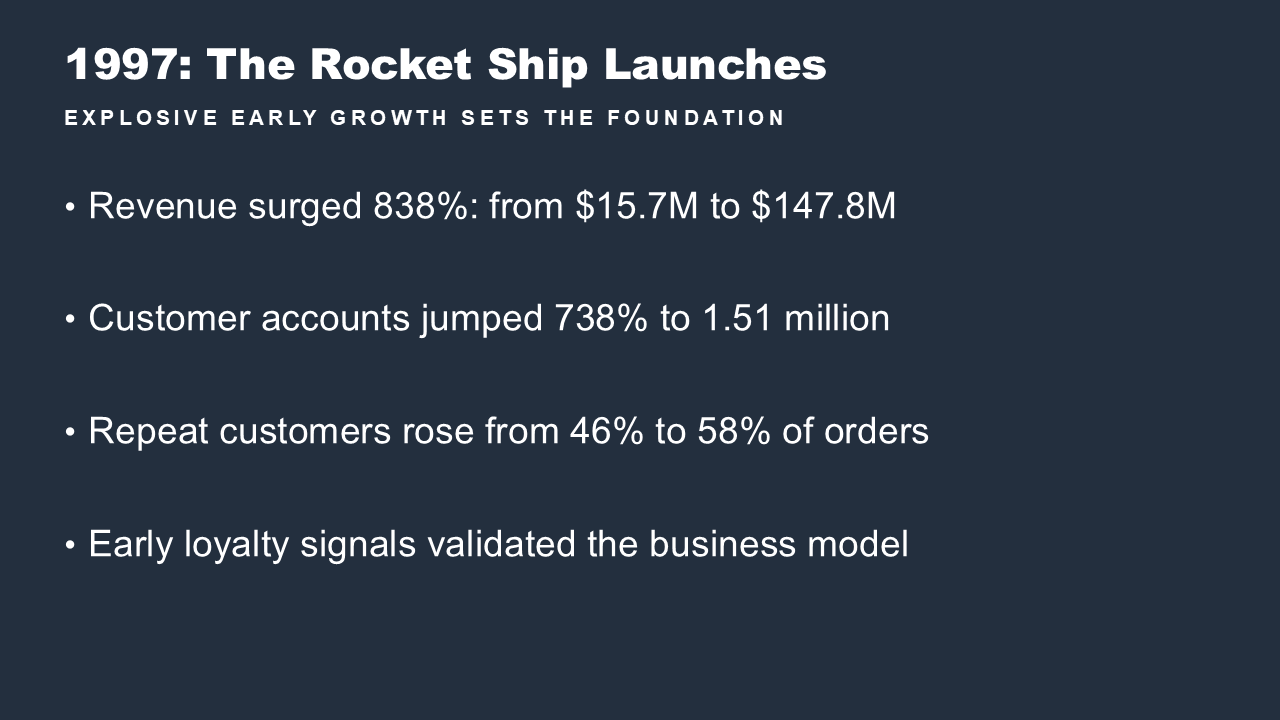
Figura 3: Diapositiva de contenido generada con viñetas
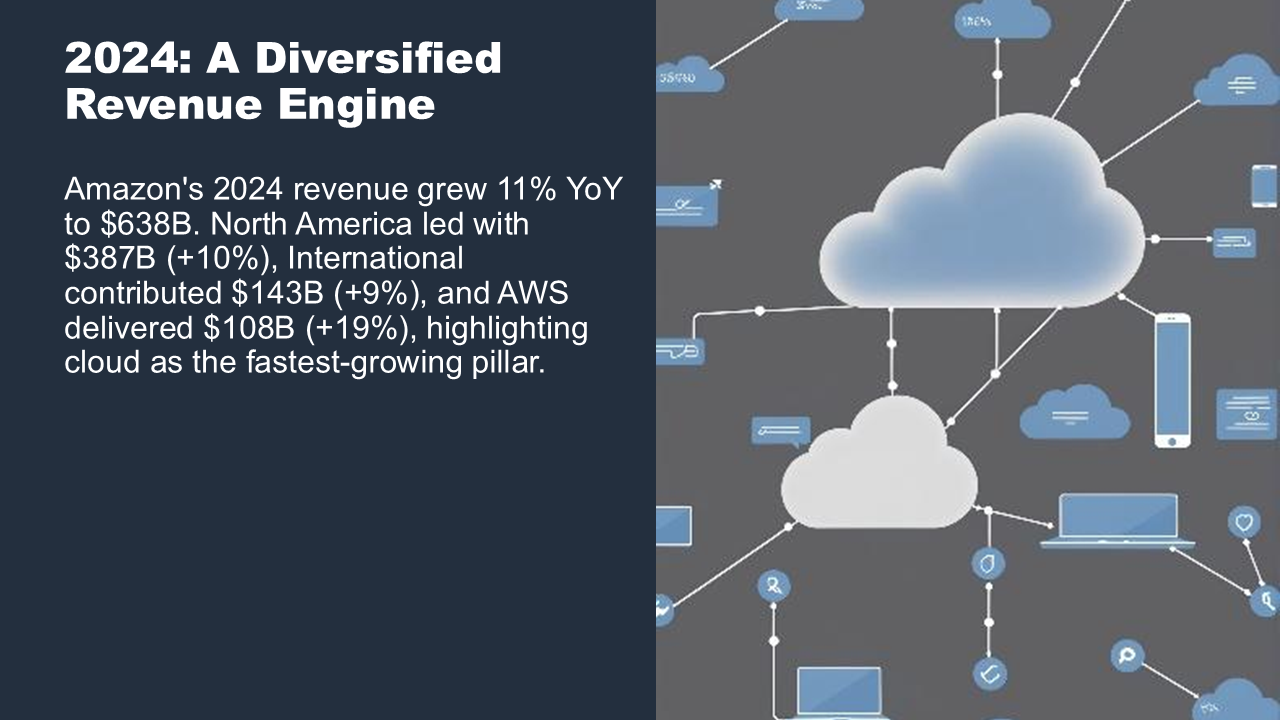
Figura 4: Diapositiva generada que combina texto con una imagen generada por IA
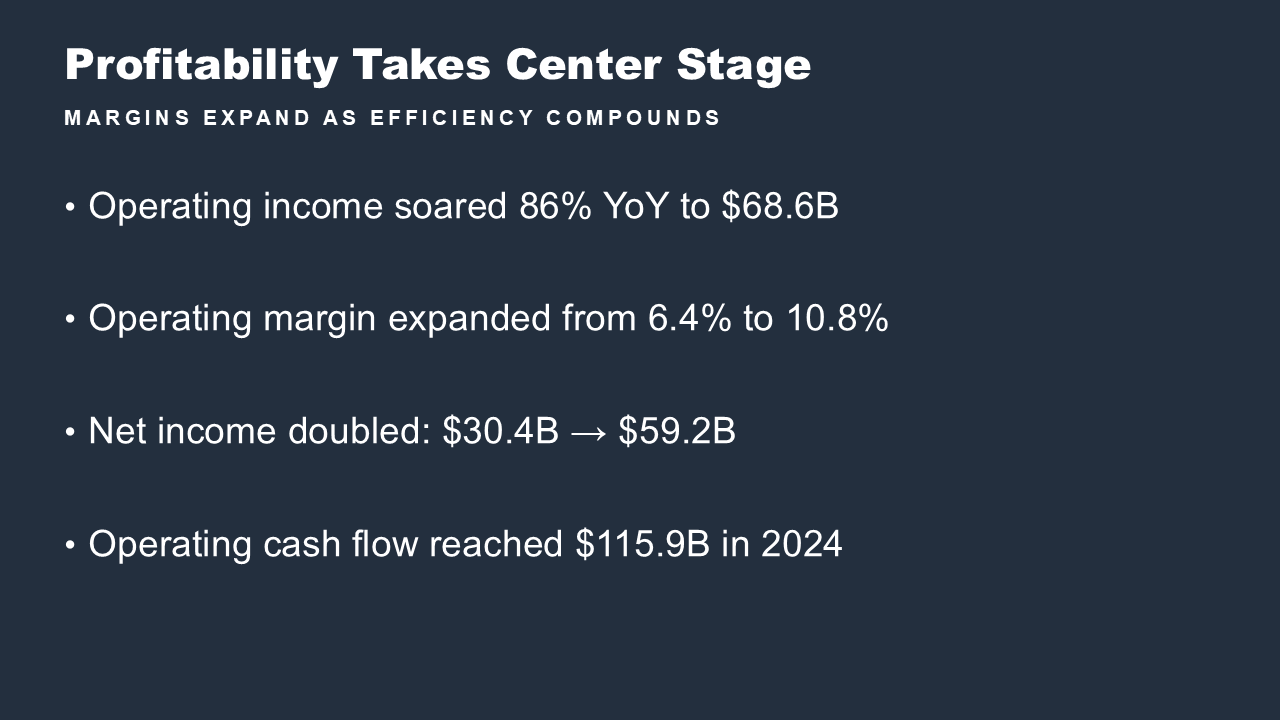
Figura 5: Diapositiva de contenido generada que resume métricas de rentabilidad
Figura 6: Diapositiva generada de solo imagen con un elemento visual generado por IA
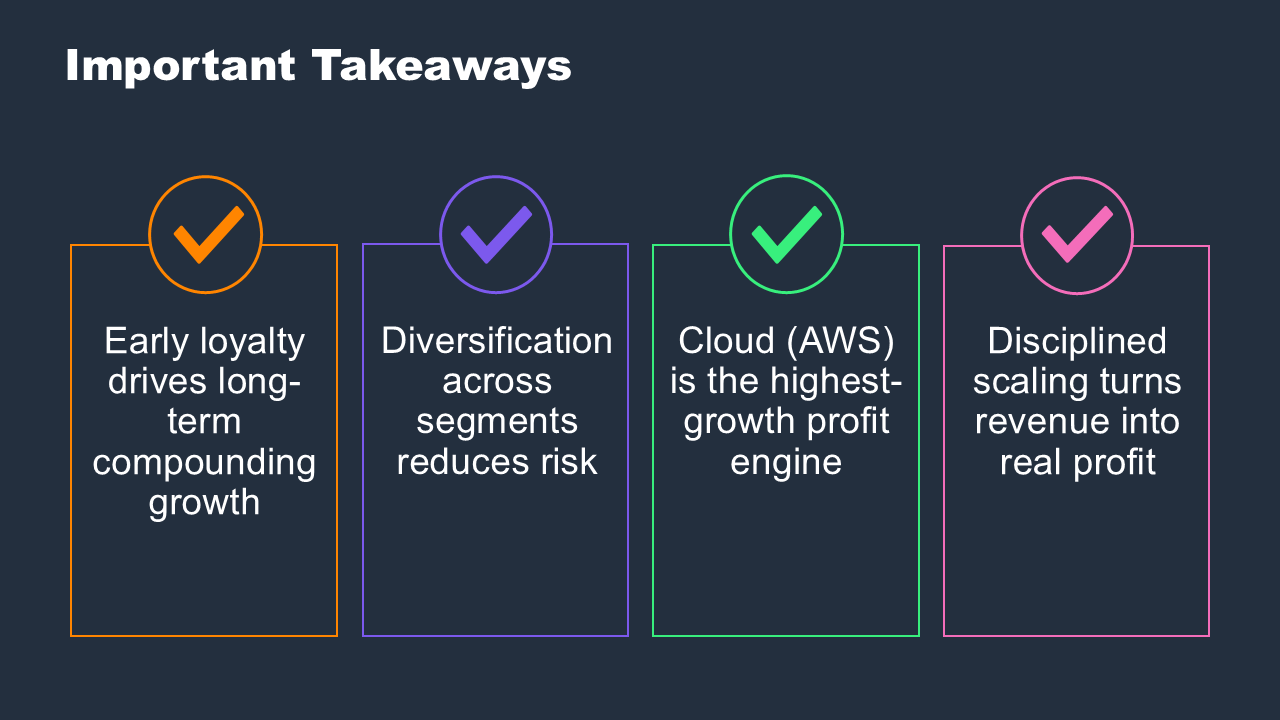
Figura 7: Diapositiva de conclusiones generada
Las presentaciones generadas incluyen:
- Diapositivas de título con personalización de marca.
- Diapositivas de contenido con viñetas y texto estructurado.
- Diapositivas de imágenes con visuales generados por IA de Stability AI Stable Image Inpaint (en Amazon Bedrock).
- Notas del orador con orientación para la presentación.
- Formato consistente basado en plantillas corporativas.
Resúmenes
Los resultados de resumen proporcionados a la base de conocimientos incluyen:
- Síntesis concisa del contenido de la base de conocimientos.
- Seguimiento de citas a los documentos de origen.
- Formato estructurado con puntos clave resaltados.
Respuestas de API
La Chat API devuelve:
- Respuestas en streaming para comentarios de usuarios en tiempo real. Debido a que las pruebas internas mostraron que la generación de presentaciones toma 70–90 segundos (superando el tiempo de espera de integración predeterminado de 29 segundos de Amazon API Gateway), la Chat API utiliza un patrón de invocación asíncrono. Use streaming o sondeo para recibir el resultado final en lugar de esperar una llamada REST síncrona.
- Mantenimiento del contexto de conversación a lo largo de múltiples turnos.
- URLs prefirmadas de Amazon S3 para descargas de documentos (expiración de 5 minutos).
El contenido generado se somete a la validación de Amazon Bedrock Guardrails para verificar el cumplimiento de las políticas de contenido antes de la entrega.
Limpieza
Para evitar cargos continuos, elimine los recursos desplegados:
- Elimine el runtime de AgentCore y el endpoint:
aws bedrock-agentcore-control delete-agent-runtime-endpoint \ --agent-runtime-id <runtime-id> \ --agent-runtime-endpoint-id <endpoint-id> aws bedrock-agentcore-control delete-agent-runtime \ --agent-runtime-id <runtime-id> - Desactive la protección contra eliminación de Amazon DynamoDB (requerido antes de eliminar la pila):
aws dynamodb update-table --table-name chat-sessions-dev --no-deletion-protection-enabled aws dynamodb update-table --table-name tenant-table-dev --no-deletion-protection-enabled - Elimine las pilas de AWS CloudFormation en orden inverso de dependencias:
aws cloudformation delete-stack --stack-name ChatApiStack aws cloudformation delete-stack --stack-name AgentCoreStack aws cloudformation delete-stack --stack-name OpensearchStack aws cloudformation delete-stack --stack-name VPCEndpointsStack - Vacíe los buckets de Amazon S3 antes de eliminarlos (AWS CloudFormation no puede eliminar buckets que no están vacíos):
aws s3 rm s3://amzn-s3-demo-bucket --recursive - Elimine los repositorios de Amazon ECR que contienen imágenes de contenedor:
aws ecr delete-repository --repository-name lambda-pptx-gen --force aws ecr delete-repository --repository-name agentcore-supervisor --force - Elimine las sub-pilas de la base de conocimientos del tenant (creadas por el provisionador del tenant):
aws cloudformation delete-stack --stack-name bedrock-kb-<tenant-id>
Consideraciones de seguridad
Esta solución utiliza variables de entorno de Lambda para valores de configuración como IDs de modelos, nombres de buckets de Amazon S3 e IDs de guardrails. Estos son identificadores de recursos, no secretos. Para implementaciones de producción, utilice AWS Secrets Manager para valores de configuración sensibles, como claves de API y credenciales de bases de datos.
El agente de runtime de AgentCore se ejecuta en un contenedor aislado con aislamiento a nivel de sesión. Cada sesión de usuario opera en un entorno dedicado, lo que ayuda a prevenir la contaminación de datos entre sesiones.
Conclusión
En esta publicación, construyó un sistema de agentes de IA con Amazon Bedrock AgentCore que automatiza la generación de documentos empresariales. El agente supervisor desplegado en el runtime de AgentCore enruta las solicitudes a herramientas especializadas para la creación y el resumen de documentos, reduciendo la creación de presentaciones a unos 90 segundos en una prueba interna.
El pipeline RAG fundamenta el contenido generado en documentos fuente, y Amazon Bedrock Guardrails verifica el cumplimiento del contenido. Puede adaptar esta arquitectura para la generación automatizada de informes en servicios financieros, documentación técnica para equipos de ingeniería o creación de propuestas para organizaciones de ventas.
Para empezar, clone el repositorio de GitHub y siga las instrucciones de configuración. Para obtener más información sobre los servicios utilizados, consulte la documentación de Amazon Bedrock AgentCore, Strands Agents SDK, y la AWS CDK Developer Guide.