
Presentamos OpenCompute
Por Walker Hildebrand, Sherry Bai - 14 de octubre de 2026 - 7 minutos de lectura
Producto
Compartir
En un mundo en el que los agentes pueden trabajar mientras usted duerme, ¿cómo les permitimos operar en su infraestructura?
Cuando el agente está en una ventana de chat, la respuesta es sencilla: funciona en la máquina que has configurado para la sesión. Pero cuando los agentes investigan alertas, responden a solicitudes asincrónicas, ejecutan automatizaciones programadas y gestionan problemas durante todo el día, surge la necesidad de un cálculo on-demand. Ya no se necesita simplemente un lugar donde ejecutar un agente; se necesita una flota de cálculos que pueda mantenerse al ritmo del trabajo.
Hoy, presentamos OpenCompute, el orquestador autohostado de Factory para sandboxes de agentes en la plataforma de ejecución que elijas, ahora en previsualización privada.
OpenCompute ofrece el aprovisionamiento a demanda y la gestión del ciclo de vida para la infraestructura controlada por el cliente, integrada con la experiencia Factory a través de Entornos, Automatizaciones y Control remoto. Sus agentes reciben computadoras cuando las necesitan. Usted elige dónde se ejecutan esas computadoras.
Está basado en una convicción: adoptar el desarrollo de software autónomo no debería requerir entregarle las llaves de su infraestructura a otra persona.
¿Cómo logramos construir algo en seis semanas que nos permita desplegarlo en un entorno on-premises personalizado en dos días?
Construyendo sobre el control remoto
En abril de 2026, introdujimos los Droid Computers: máquinas persistentes para orquestar los Droids. Los clientes podían crear una computadora en la nube de Factory o registrar su propia máquina a través del Control Remoto.
La experiencia de control remoto permite la integración con Factory sin depender de la capa de computación. Ejecuta Droid en cualquier máquina, conéctalo a Factory y trabaja con él de forma remota. Esa máquina puede ser una estación de trabajo, una VM en la nube o un servidor dentro de una red privada. Como el bucle de ejecución del agente se ejecuta en esa máquina, Droid puede trabajar con repositorios privados, registros de paquetes y servicios en un entorno interno. Los clientes no necesitan exponer esos sistemas públicamente para que estén disponibles para un agente. Nuestro soporte para BYOK y inferencia autohostada ofrece un control adicional sobre la soberanía de los datos.
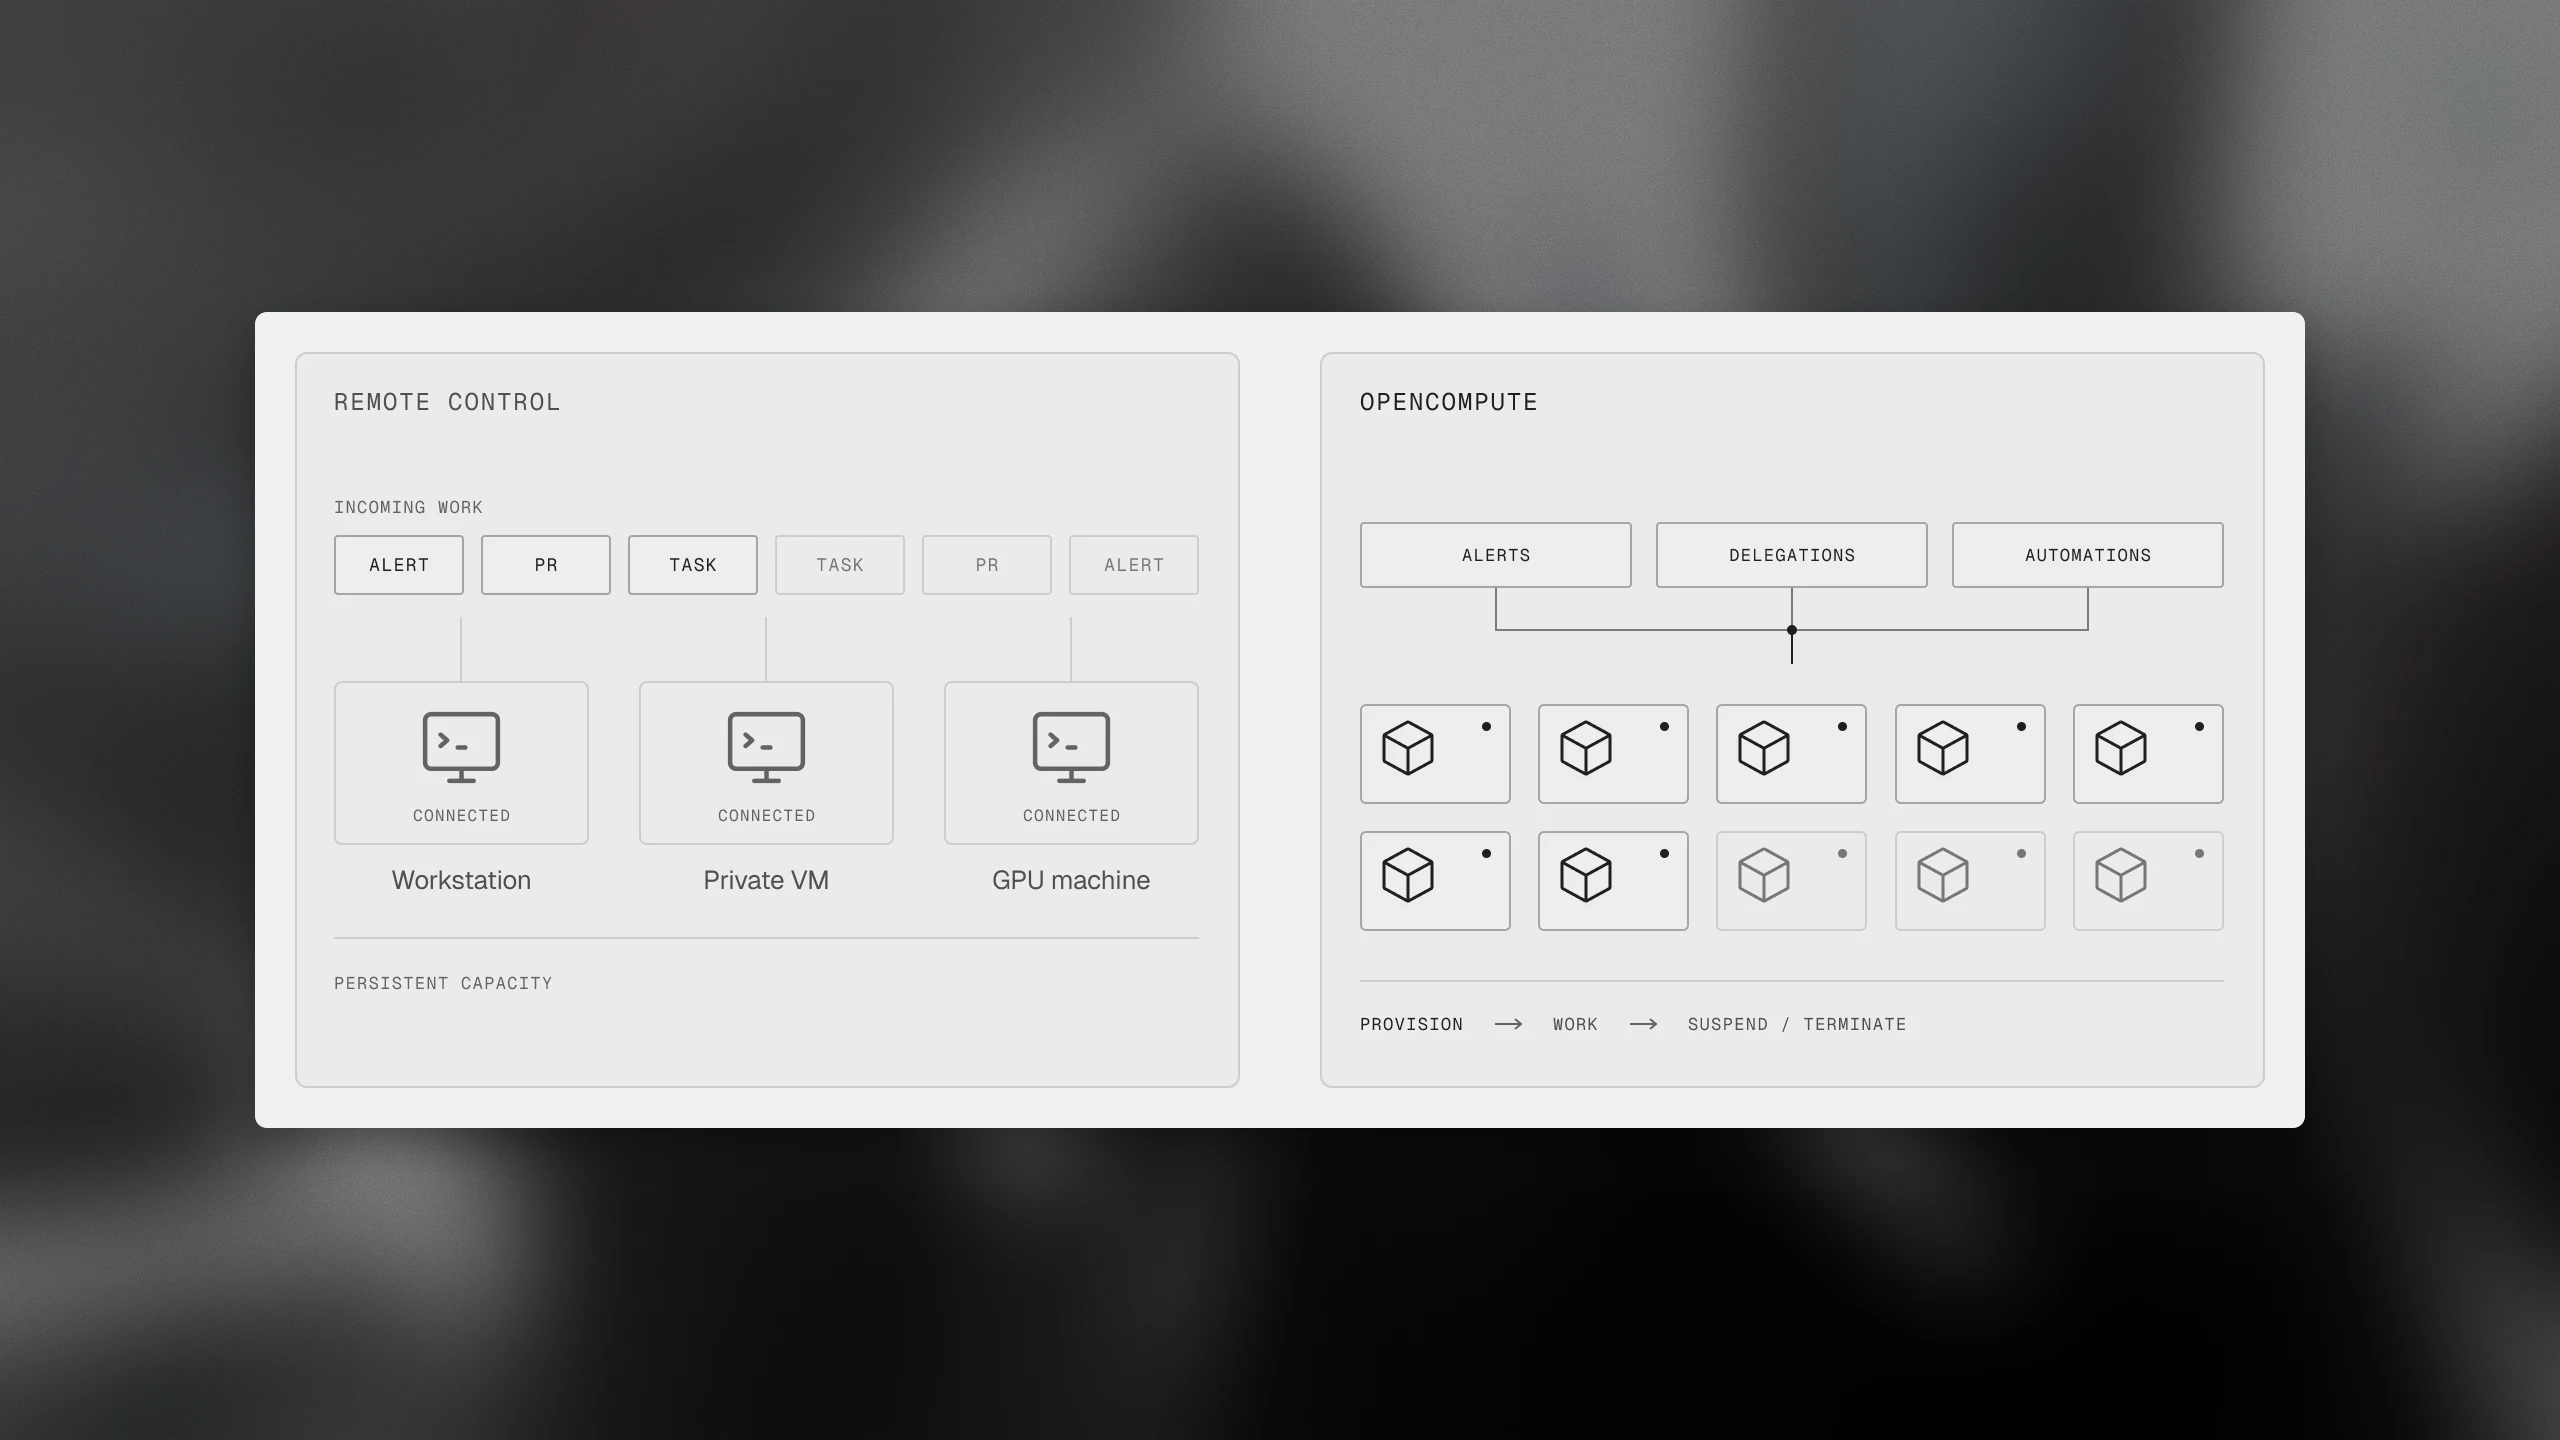
El control remoto demostró el valor de ese modelo, y la industria en general ha seguido en la misma dirección. Pero comenzamos a ver otra brecha clara: nuestros clientes empresariales necesitaban una solución para gestionar flotas de computadoras, no un solo computadora por vez.
Una máquina no es una flota
El control remoto es una opción adecuada para una máquina persistente destinada a un usuario o servicio individual: una estación de trabajo configurada, una máquina virtual de desarrollo o una unidad con hardware especializado. Responde a la pregunta: ¿cómo llevo los agentes al lugar donde los necesito más?
Pero necesitábamos computación para satisfacer las demandas de organizaciones completas, apoyando sesiones interactivas mientras también permite que los agentes operan de manera independiente a medida que surgen tareas.
Un alerta debe poder iniciar una investigación sin que alguien proporcione primero una máquina virtual. Una serie de delegaciones en Slack no debe dejar a un equipo contando las máquinas disponibles. Una tarea completada no debe dejar recursos inactivos funcionando indefinidamente.
Nuestra oferta gestionada ya ha manejado algunas partes de ese ciclo de vida. Las máquinas autohostadas no tenían la misma integración nativa para el aprovisionamiento, la suspensión y la reanudación. Los clientes podían ejecutar Droid donde quisieran, pero tenían que manejar ellos mismos la flota.
Cajas de prueba en todas partes
Vimos una gran variación en la infraestructura en la nube de nuestros clientes. Algunos querían que los agentes se ejecutaran en clústeres existentes de Kubernetes, otros en hardware especializado, y otros en una plataforma interna de la cual sus desarrolladores ya dependían. Otros estaban implementando nueva infraestructura de microVM o buscando una solución.
Nuestro mandato no era simplemente proporcionar a los clientes flotas de celdas de prueba. Teníamos que hacer que la gestión de flotas funcionara en cualquier infraestructura. Necesitábamos llevar la orquestación al entorno del cliente, no traer a cada cliente a nuestro lugar.
No hay escasez de trabajos que se realizan en entornos de sandbox para agentes. Las plataformas de sandbox en la nube de terceros incluyen E2B, Daytona y Modal. Proyectos como Kubernetes Agent Sandbox, el Agent Substrate de Google y AWS Lambda MicroVMs también muestran una creciente demanda por soluciones de “trae tu propia nube” y “trae tu propia infraestructura”.
Cada plataforma realiza diferentes compromisos en cuanto a aislamiento, persistencia, velocidad de inicio, simplicidad operativa y flexibilidad de despliegue. Un backend adecuado para tareas de corta duración puede no ser adecuado para un entorno de desarrollo persistente. Un servicio que funciona bien para una startup puede quedar fuera de servicio dentro de la red de una empresa regulada. Y la mejor opción en seis meses podría diferir de la mejor opción hoy.
Decidimos construir una capa sobre la infraestructura de computación. OpenCompute es responsable del ciclo de vida común: solicitar un ordenador, llevarlo al estado deseado, rastrear su actividad y suspender o terminarlo según la política y las capacidades del proveedor. El proveedor es el responsable de los mecanismos de infraestructura que permiten llevar a cabo dichas operaciones. Esto nos permite beneficiarse de las mejoras en todo el ecosistema sin obligar a los clientes a esperar que reemplazemos los fundamentos de nuestro producto.
Hacer que las interfaces realicen el trabajo
El desarrollo de OpenCompute ha sido nativo para los agentes desde el principio, comenzando con una misión para probar el concepto. Nuestro trabajo fue definir los límites, especificar el comportamiento y hacer que la corrección fuera testable. Los Droids se encargaron del resto bajo dirección humana.
Eso hizo que el diseño de interfaz fuera especialmente importante. “Construir soporte para este proveedor” es una tarea de alcance abierto. “Implementar este contrato y cumplir con estos tests de conformidad” proporciona a un agente un problema limitado y una definición verificable del éxito.
La misma separación que hizo que OpenCompute fuera flexible para los clientes también lo hizo accesible para su construcción. Un nuevo driver, la integración con cada proveedor, podría centrarse en ese proveedor sin tener que reescribir la gestión del flota. El plano de control compartido podría mejorarse sin necesidad de aprender otra API de nube.
Ese enfoque nos permitió desarrollar y evaluar integraciones entre AWS Lambda MicroVMs, Kubernetes, EC2, Agent Sandbox, Agent Substrate y otros proveedores experimentales. No se trataba de implementaciones idénticas ni de backend igualmente maduros. Eso era el objetivo: la arquitectura podía manejar las diferencias sin convertir cada uno en un producto independiente.
Seis semanas para la primera implementación
La prueba más clara ocurrió con la implementación del primer cliente. El cliente necesitaba OpenCompute en un entorno local personalizado, con una interfaz de proveedor interno. Justo antes de embarcarnos en el vuelo para conocer al cliente, iniciamos una misión para desarrollar el driver inicial de su entorno con la información que teníamos.
Para cuando aterrizamos, el conductor ya estaba listo. Después de dos días en el sitio, el cliente configuró su primer sandbox a través de OpenCompute. Desde la perspectiva del usuario, parecía como si estuviera creando un Droid Computer gestionado, pero el sandbox se ejecutaba en el centro de datos del cliente. No necesitábamos inventar una nueva arquitectura para ese cliente. Necesitábamos conectar su infraestructura a una interfaz que ya habíamos definido.
Desde el prototipo inicial hasta la implementación para el primer cliente: seis semanas.
Esa primera integración no fue el final del trabajo de ingeniería. La persistencia, la recuperación, las herramientas de despliegue y el fortalecimiento operativo continuaron después. Pero validó la apuesta central: integrar un nuevo proveedor podría ser un problema de motor, no una reescritura de la plataforma.
Visión general de la arquitectura
OpenCompute es un servicio autohosteado que conecta el backend de Factory con el plano de computación subyacente del cliente.
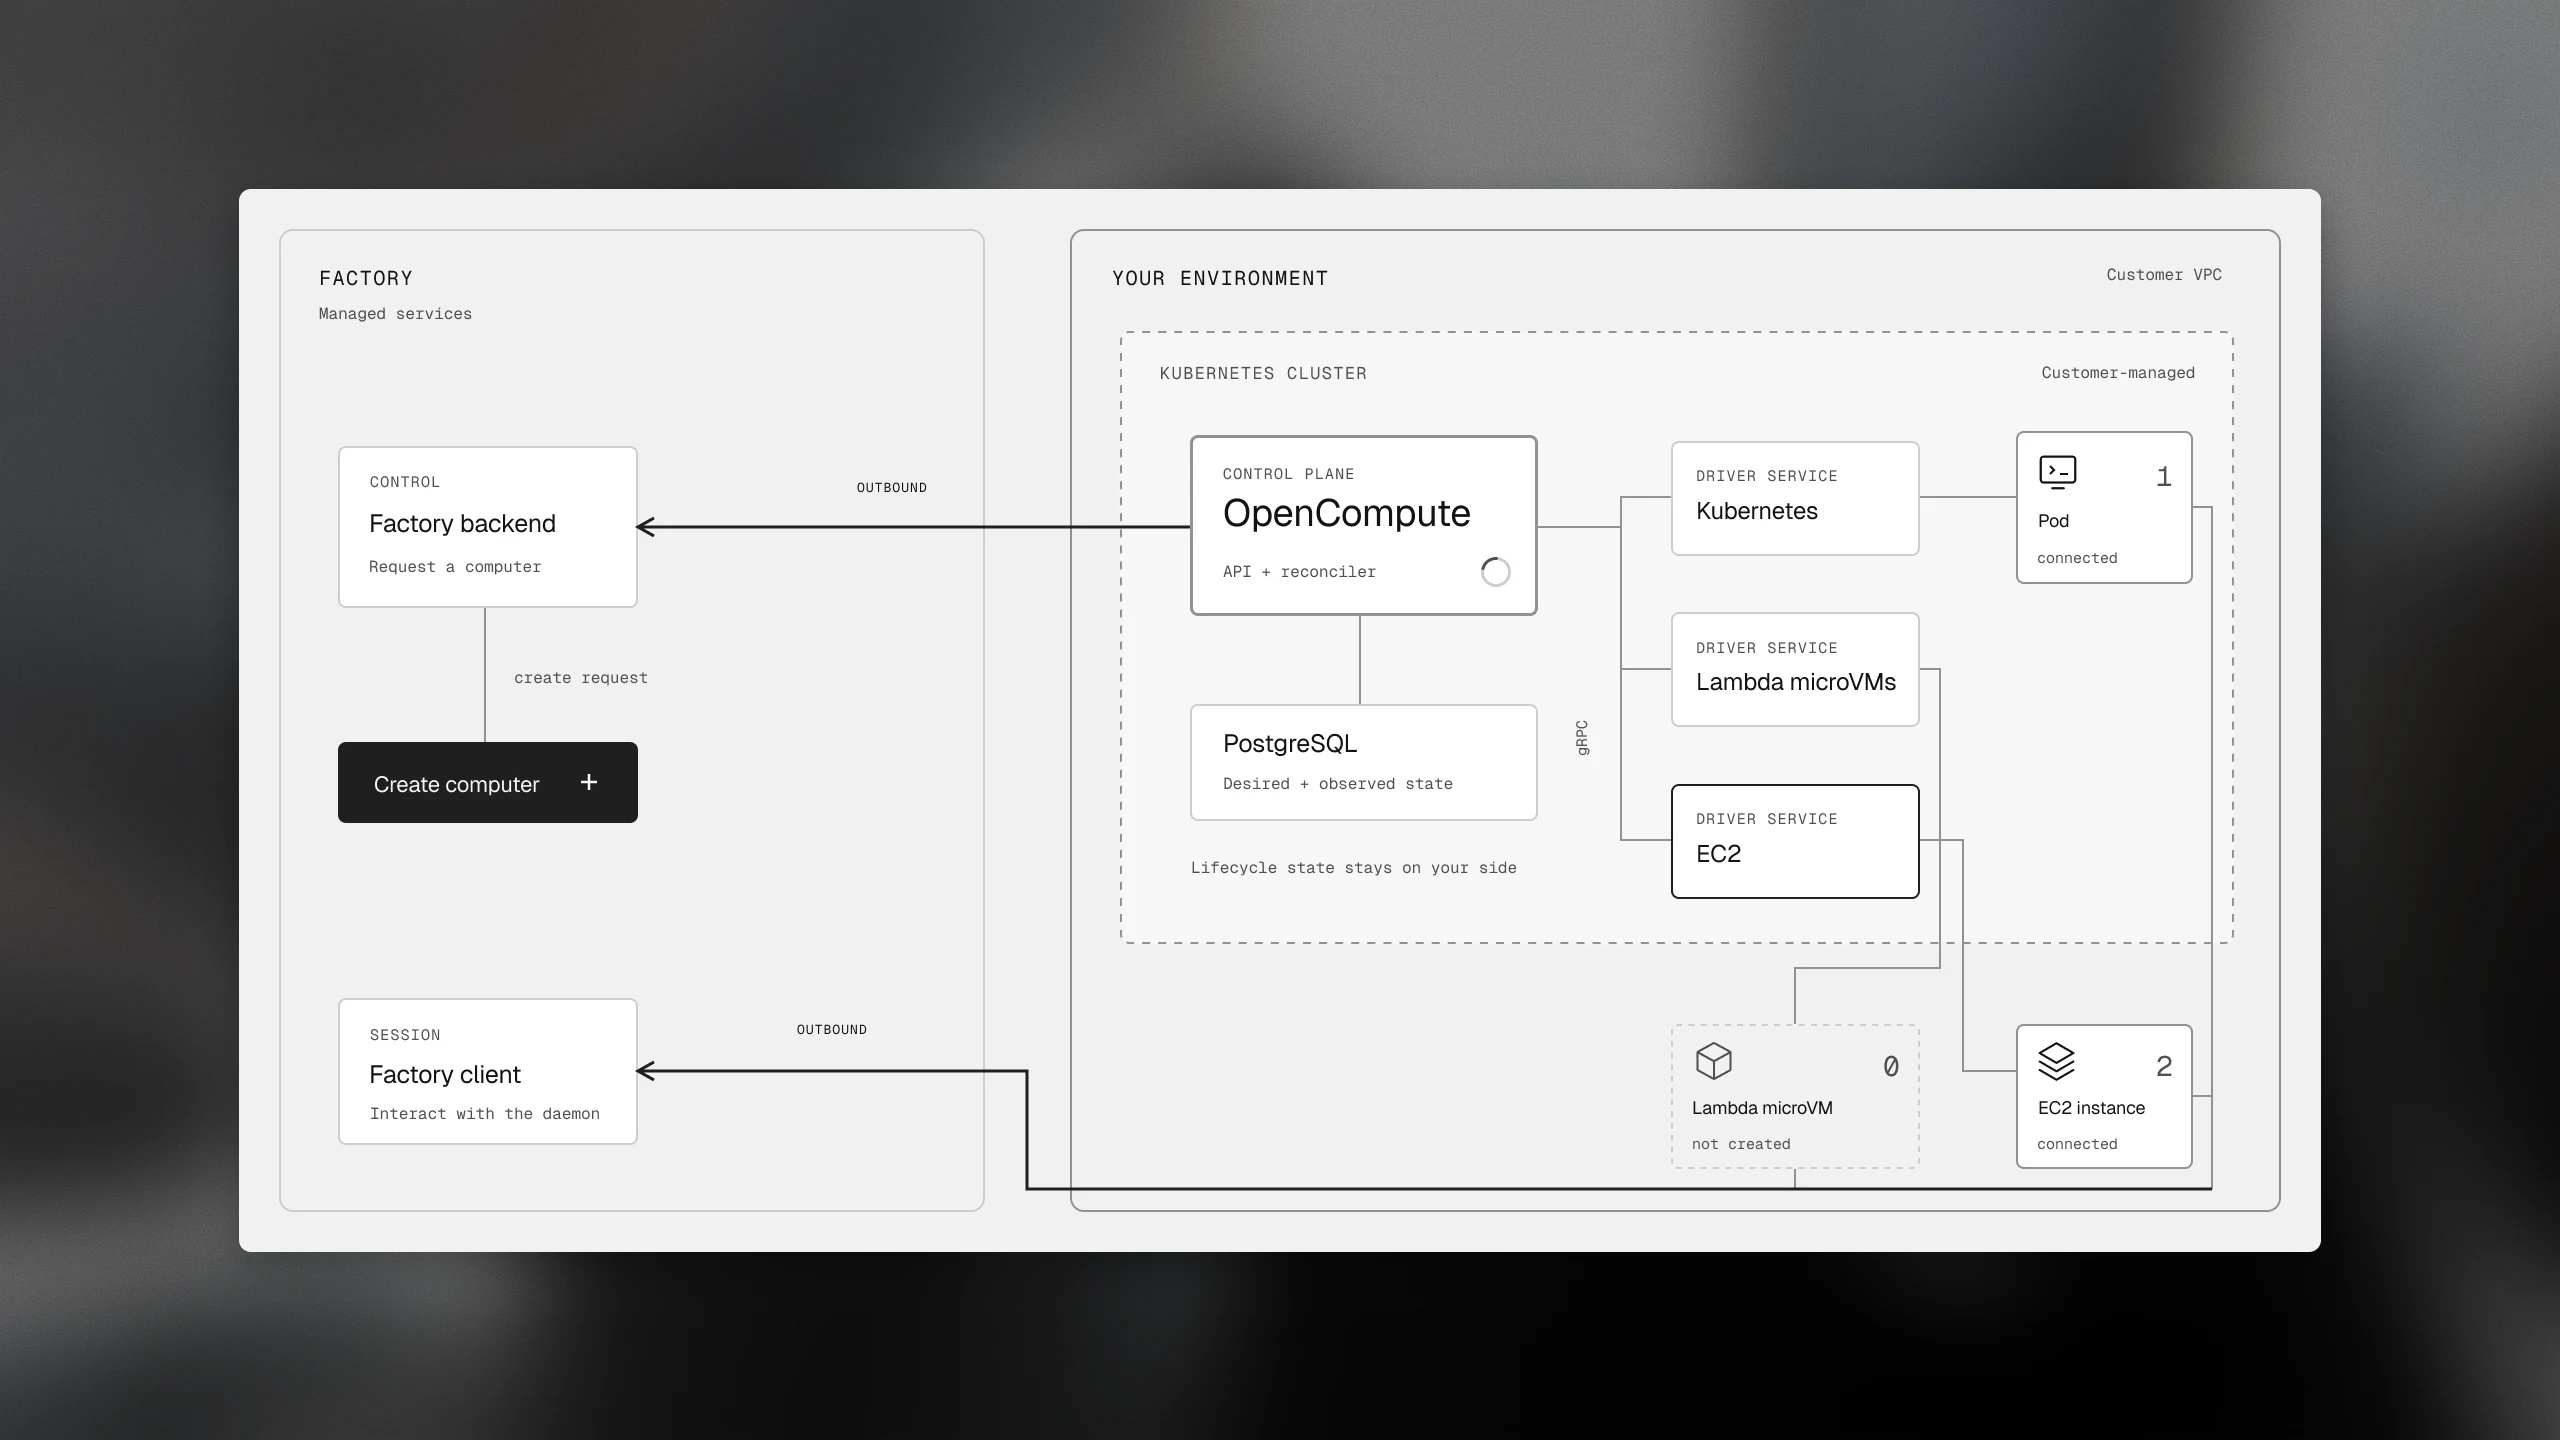
Conectar hacia afuera, ejecutar dentro
OpenCompute se ejecuta en su entorno y establece una conexión WebSocket segura con TLS hacia Factory. Factory envía solicitudes de computación autorizadas a través de esa conexión. No es necesario exponer un punto final OpenCompute público ni abrir un puerto de firewall de entrada para Factory.
Al inscribirse, su implementación OpenCompute registra una clave pública con Factory. Al conectarse, demuestra posesión de la clave privada correspondiente firmando un desafío nuevo. La clave privada permanece bajo su control y puede existir en un KMS en la nube soportado.
Cada sandbox aprovisionado por OpenCompute establece su propia conexión de salida con Factory, exactamente como los ordenadores controlados remotamente en la actualidad. Los repositorios y servicios internos pueden permanecer privados. Droid se conecta con ellos desde dentro de tu red.
Una nota sobre la colocación de datos: El cálculo de la colocación está separado del enrutamiento de inferencia y el almacenamiento de sesiones. Mantener los datos de sesión completamente locales depende de su configuración de inferencia y sincronización.
Registra la intención, luego reconcilia
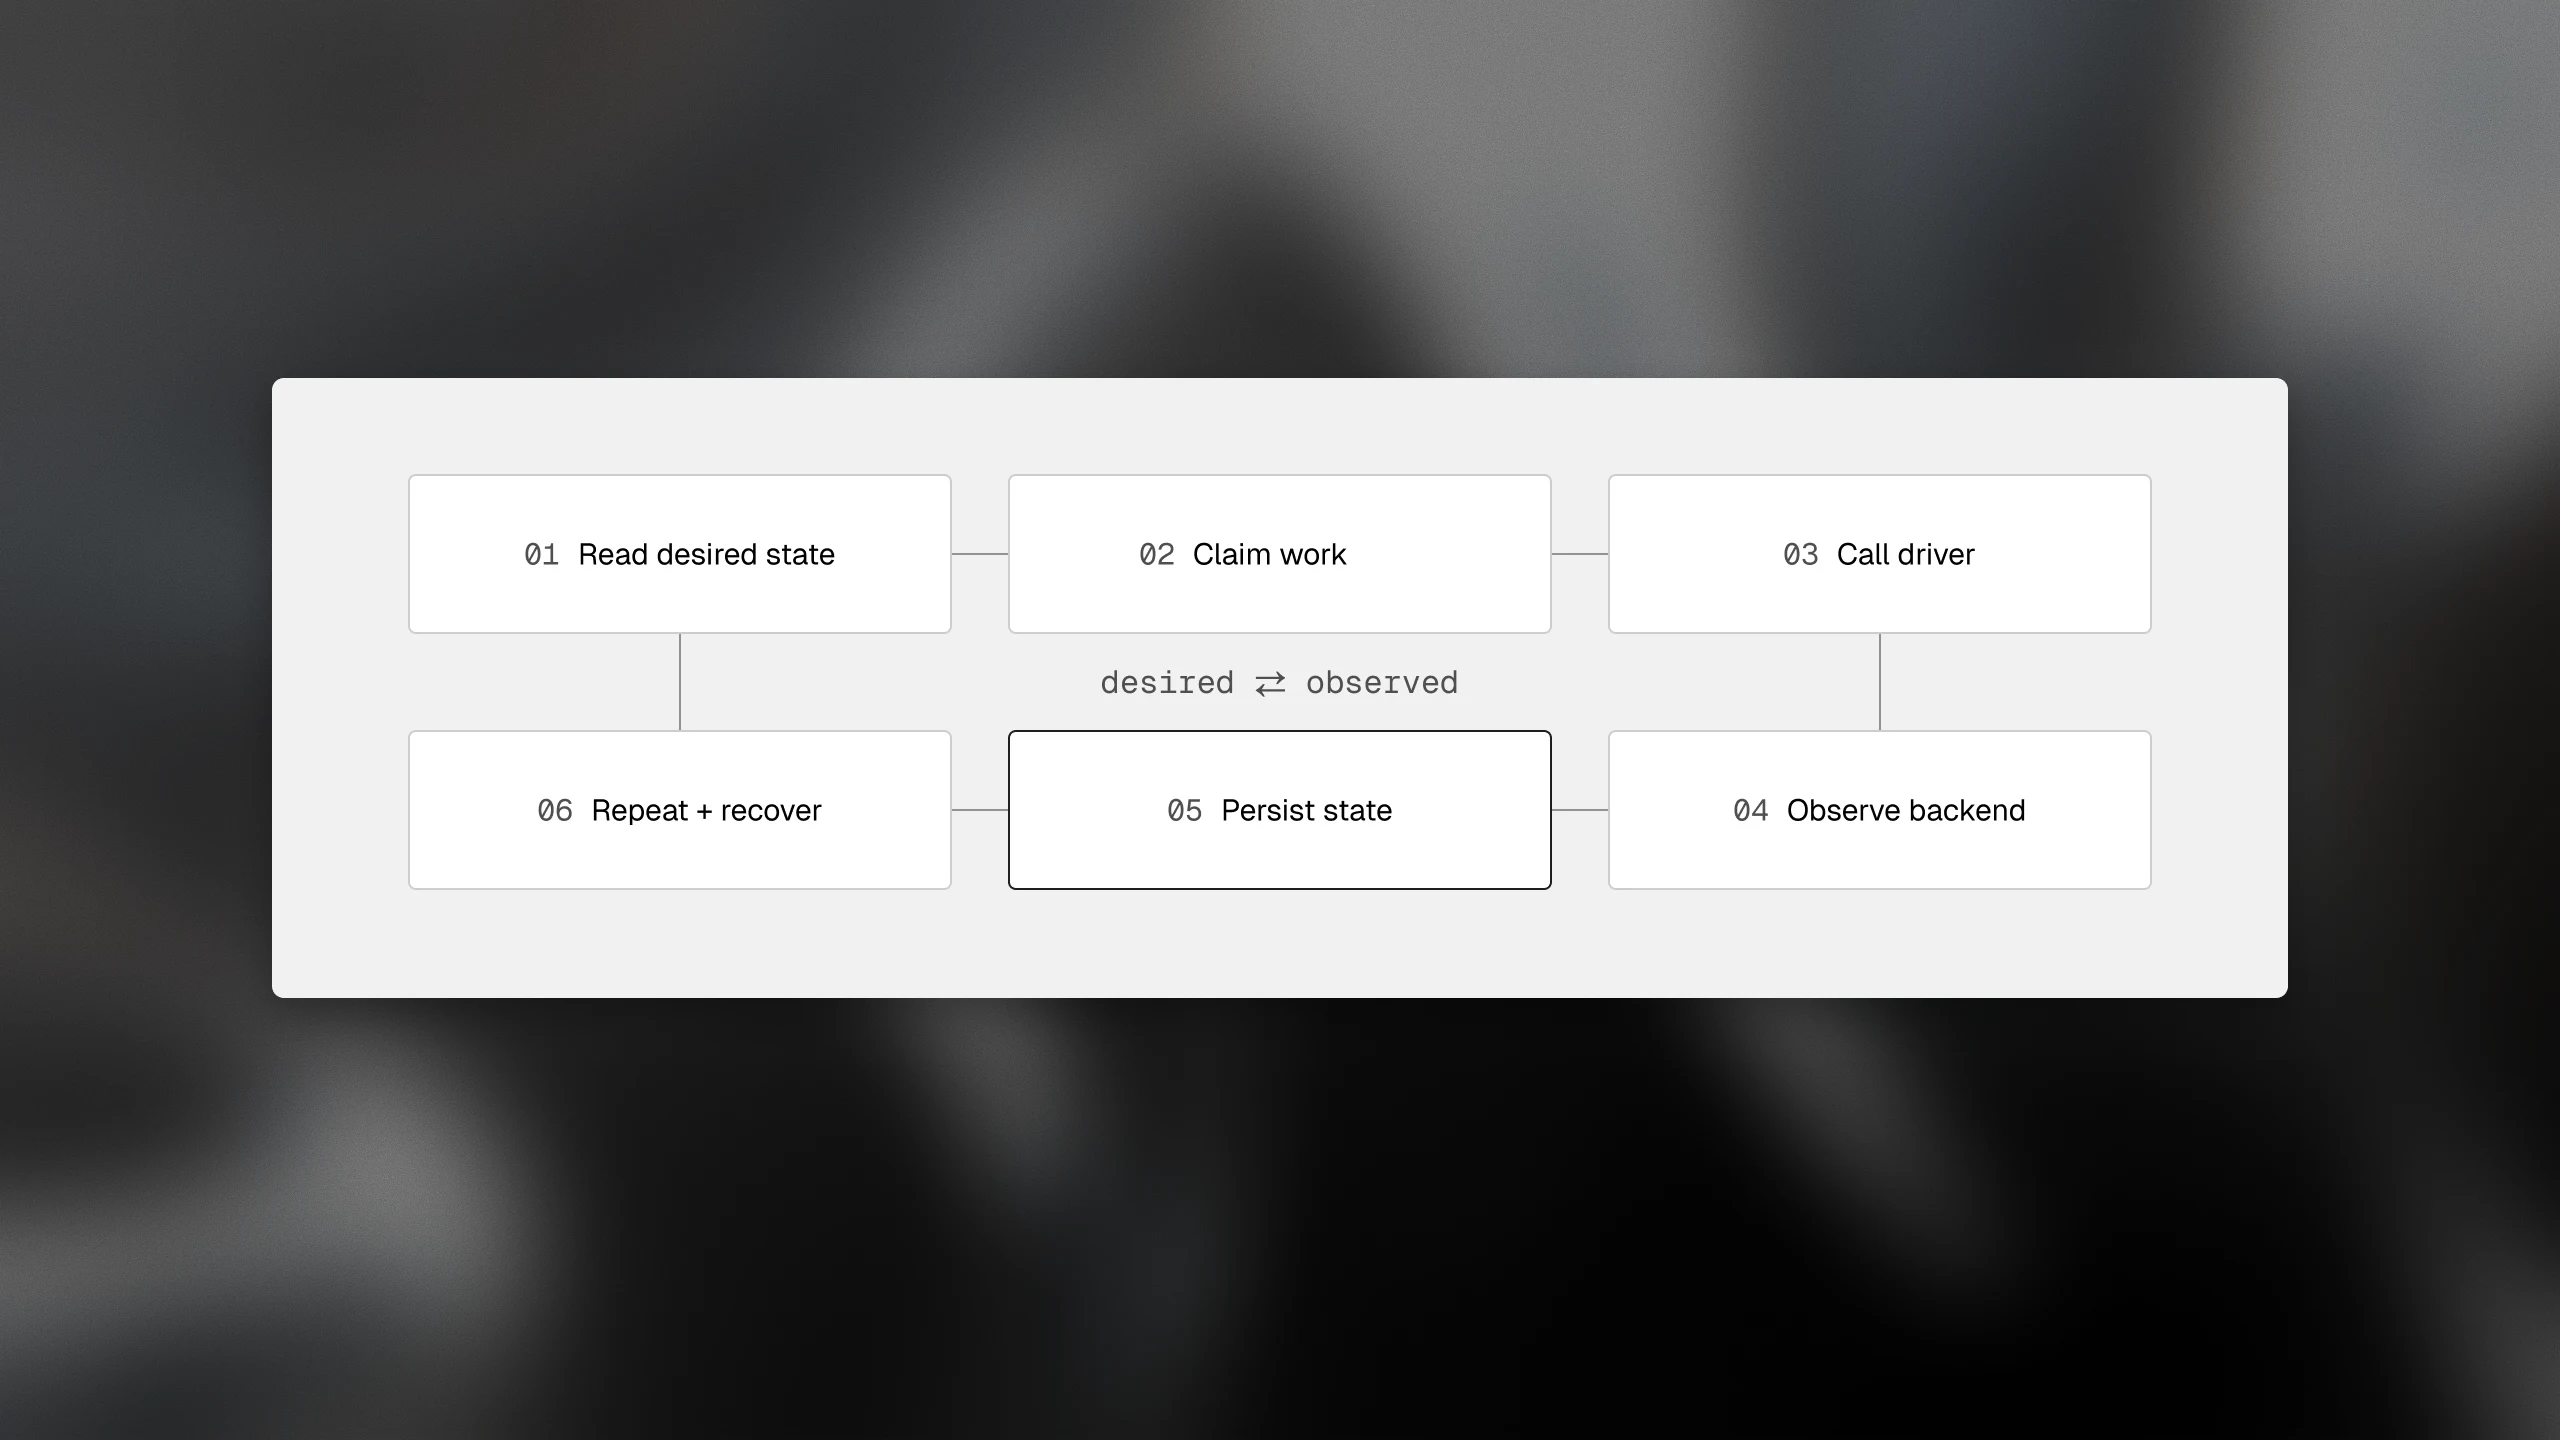
La provisioning no es una llamada API confiable, especialmente al tratar con proveedores desconocidos. Las conexiones se pierden. Los proveedores limitan el tráfico. Los procesos se reinician después de que la solicitud tenga éxito, pero antes de que llegue la respuesta. OpenCompute aborda esto con un modelo de ciclo de vida declarativo. Su plano de control en Go registra el estado del ordenador deseado y observado en una base de datos Postgres que se ejecuta en su entorno. Un reconciliador trabaja continuamente para llevar el ordenador al estado solicitado.
Crear un registro informático conserva la intención de forma duradera, en lugar de mantener una solicitud abierta hasta que el proveedor termine. El reconciliador gestiona el aprovisionamiento y la observación, realiza intentos para fallos recuperables y impulsa las transiciones del ciclo de vida soportadas. Dado que la intención es duradera, un reinicio del plano de control no borra el trabajo inacabado.
Las computadoras se lanzan a partir de construcciones inmutables, separando la preparación del entorno de la creación de máquinas. El almacenamiento compatible con S3 guarda los artefactos de construcción y los datos de snapshot. Los señales de actividad y las configuraciones de ciclo de vida por computadora indican al plan de control cuándo mantener la computadora en funcionamiento y cuándo ejecutar acciones de ciclo de vida.
Estandarizar el comportamiento, no la infraestructura
Cada integración con el proveedor se ejecuta como un driver gRPC independiente. El driver traduce las operaciones comunes en los mecanismos nativos del backend para crear, observar, ejecutar comandos y destruir computadoras.
El comportamiento específico del proveedor queda fuera de la base de datos y la lógica de reconciliación del plano de control. Los drivers pueden utilizar el transporte y el tiempo de ejecución adecuados para su backend, en lugar de adoptar un agente invitado obligatorio.
Pero una interfaz común es útil solo si es honesta sobre las diferencias. No todo backend puede suspender un ordenador, tomar instantáneas de su disco o hacer fork. Por lo tanto, OpenCompute define un perfil de conformidad Core requerido y perfiles opcionales de Suspend, Snapshot y Fork. Los tests de caja negra verifican el comportamiento que un driver afirma soportar. Las solicitudes no soportadas son rechazadas antes de cambiar el estado duradero, en lugar de aparecer como errores a mitad del proceso de provisión.
El contrato también es neutral en cuanto a proveedores. La fábrica es uno de los clientes posibles de OpenCompute, y los controladores son independientes de las características específicas de la fábrica. OpenCompute expone su propia API, CLI y panel de administración, ya que la capa que gestiona su computación debe ser útil de forma independiente del producto que la solicitó primero.
¿Qué sigue?
Planificamos abrir OpenCompute como código abierto. El objetivo no es simplemente publicar la implementación, sino hacer que los contratos, los pruebas de conformidad y el modelo de controlador sean útiles para las personas que desarrollan sistemas de agentes.
También lo consideramos como la base para el futuro de Factory. Las sesiones interactivas, las automatizaciones programadas, las investigaciones de incidentes y el trabajo delegado no deberían necesitar sus propias historias de infraestructura. Deben poder solicitar el entorno que necesitan a través del mismo nivel de ciclo de vida, ya sea que Factory o el cliente lo operen.
Estamos emocionados de transferir esa base a más manos y ver qué proveedores conectarán a las personas siguientemente.
El futuro de las cargas de trabajo agenticas no se ejecutará en un solo tipo de máquina en la nube de una empresa. OpenCompute es la forma en que pretendemos construir para ese futuro.
OpenCompute está ahora en una previsualización privada. Si está interesado en explorar OpenCompute, póngase en contacto con el propietario de su cuenta en Factory.