
Cada empresa tiene sus propios flujos de trabajo, herramientas, casos límite y definiciones de éxito. (se abre en una nueva ventana)Third Moment Research(se abre en una nueva ventana) cree que los mejores agentes deberían ser realmente buenos en ese trabajo específico y deberían mejorar sus capacidades cuanto más se usen.
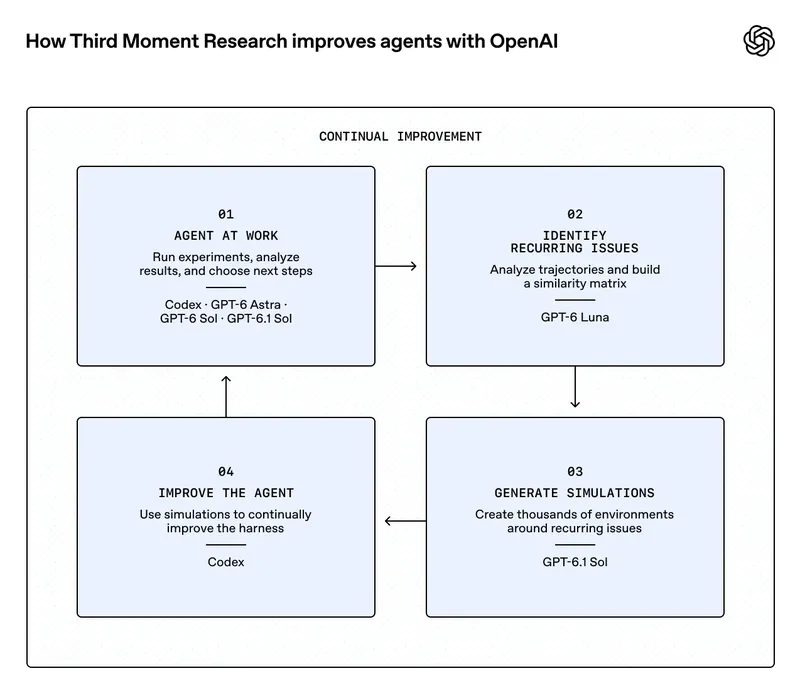
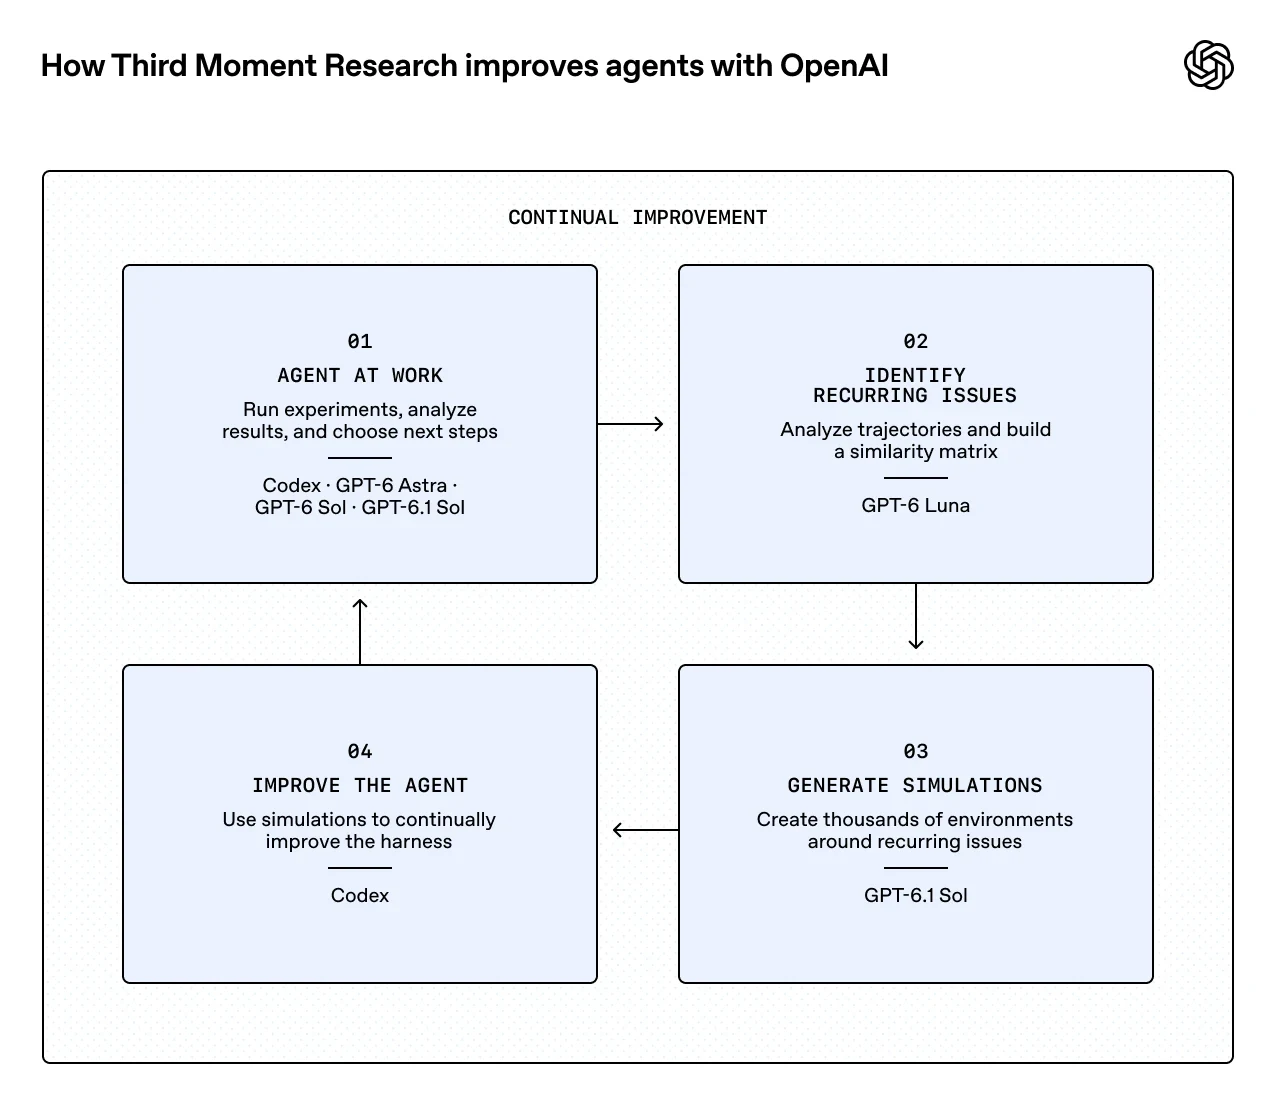
La empresa está construyendo un sistema de IA autosuperable en torno a esa idea, usando los modelos más recientes de OpenAI para comprender el comportamiento de los agentes, identificar debilidades recurrentes y crear automáticamente miles de escenarios sintéticos alrededor de esos problemas. El equipo usa esos escenarios para mejorar a los agentes, repitiendo el proceso a medida que surgen nuevos problemas.
Codex, GPT‑6 Astra, GPT‑6 Sol y GPT‑6.1 Sol respaldan el trabajo de investigación y computacional del sistema, lo que permite a Third Moment ejecutar 10,000 agentes a la vez en investigaciones que duran de 36 a 48 horas. La empresa también usa Daybreak para probar la seguridad de los entornos donde trabajan los agentes.
“En una sola sesión, GPT-6.1 Sol es capaz de mantener un hilo coherente de investigación computacional a lo largo de días de cómputo sin perder el rumbo.”—Adam Khakhar, Cofundador, Third Moment Research
Reducción del tiempo de ejecución y el desperdicio de tokens con Codex
Una de las primeras aplicaciones de Third Moment es en el campo de las finanzas cuantitativas, dada la clara medida de éxito. Este dominio proporciona un entorno concreto para estudiar cómo trabajan los agentes y dónde tienen dificultades. El equipo usa Codex para encontrar y abordar problemas en el entorno de investigación.
En una instancia, usó Codex con GPT‑5.6, el modelo GPT más reciente en ese momento, para analizar miles de trayectorias de simulación grabadas (las acciones de los agentes y las respuestas del entorno) junto con marcas de tiempo y la base de código.
Codex descubrió un cuello de botella: realizar pruebas retrospectivas de una estrategia de negociación sobre un año de datos bursátiles de EE. UU. a nivel de órdenes tomaba varias horas. Mientras esperaban, los agentes sondeaban repetidamente para ver si se había completado, desperdiciando tokens y llenando su contexto con comprobaciones de estado.
Tras perfilar la prueba retrospectiva y analizar sus entradas y uso, Codex identificó una optimización de caché y una técnica de empaquetado de memoria. Experimentó con soluciones e implementó la corrección en producción, reduciendo la prueba retrospectiva de aproximadamente 3 horas a aproximadamente 3 a 5 minutos. Esto redujo el uso de tokens y la contaminación del contexto, liberando más del presupuesto de tokens de los agentes para nuevos experimentos.
Mantener a los agentes enfocados en la tarea con Codex y GPT‑6
Third Moment proporciona a cada agente las herramientas, la información y el entorno que necesita para un trabajo específico. Para la investigación cuantitativa, el equipo ejecuta el harness predeterminado de Codex dentro de un entorno en Docker. Los agentes reciben un terabyte de datos, documentación y un repositorio de investigación con módulos para ingeniería de características, entrenamiento de modelos con soporte de GPU, estrategias de negociación y simulación.
GPT‑6 Astra, GPT‑6 Sol y GPT‑6.1 Sol proporcionan el razonamiento, mientras que el harness de Codex da a los agentes herramientas para actuar, crear planes, establecer objetivos, generar subagentes y compactar el contexto a medida que continúa el trabajo.
Para abordar a los agentes que se detienen antes de completar una tarea, Third Moment trata a Codex como un subagente dentro de un harness externo impulsado por GPT‑6 Sol o GPT‑6.1 Sol. El harness externo examina la trayectoria cuando una tarea queda sin terminar y determina si reintentarla, terminar el trabajo o escalarlo a revisión humana.
“El harness de Codex es extremadamente versátil, y permite su uso en muchos dominios diferentes.”—Adam Khakhar, Cofundador, Third Moment Research
En ese entorno de investigación, los agentes trabajan para mejorar un sistema de negociación de referencia construido por los ingenieros de Third Moment. Prueban estrategias de negociación con datos históricos, evalúan si una mejora es significativa o ruido, y usan cada resultado para elegir el siguiente experimento. Según Adam, su trabajo ha mejorado el sistema de negociación de referencia.
Sostener investigaciones más largas con mayor eficiencia de tokens
Antes de GPT‑5.5, dice Adam, los modelos solo podían ejecutar experimentos prescritos por un usuario. Con GPT‑5.5 y GPT‑5.6, los modelos que trabajaban con el harness de Codex podían usar los resultados para diseñar experimentos de seguimiento. Ahora, con GPT‑6 Astra, GPT‑6 Sol y GPT‑6.1 Sol, los agentes pueden investigar las causas raíz mediante cientos de experimentos ejecutándose en paralelo con subagentes.
Esa progresión ha ayudado a los agentes a explorar direcciones de investigación que el equipo no había anticipado. En una sesión, GPT‑6.1 Sol identificó el impacto de las operaciones no mostradas en una bolsa donde esas operaciones representaban una participación inesperadamente grande del volumen. “Este fue un resultado nada obvio que nuestro equipo de investigación no había considerado inicialmente”, dice Adam.
Third Moment evalúa los modelos en optimización, sistemas de aprendizaje automático e investigación cuantitativa. Prueba los lanzamientos fronterizos en sus configuraciones de razonamiento más altas, evaluando su capacidad para navegar repositorios, escribir código eficiente y sostener una investigación. Las pruebas actuales también incluyen GPT‑6 Luna.
“GPT-6.1 Sol es actualmente nuestro modelo más usado gracias a su eficiencia de tokens. Completa las tareas con la menor cantidad de tokens mientras ofrece un rendimiento similar al de GPT-6 Astra.”—Jeffrey Yan, Cofundador, Third Moment Research
Un benchmark pide a los agentes reducir la latencia de actualización de un servicio de marcador en vivo preservando sus salidas. El equipo mide la aceleración dividiendo el tiempo de ejecución promedio de una solución creada por un experto entre el de la solución del modelo en el mismo hardware, sujeto a corrección. GPT‑6 Astra logró la mayor aceleración, según Adam.
Para trabajos específicos, incluidas comprobaciones de debilidades de seguridad concretas en el sistema de simulación, el equipo usa modelos más eficientes como GPT‑5.6 Terra. Para la investigación profunda, Adam cree que un razonamiento más potente puede justificar un costo mayor: “En el ámbito de las finanzas cuantitativas, el valor de encontrar alguna señal interesante es extremadamente alto”.
Automatización de las pruebas de seguridad con Daybreak
Con 10,000 agentes funcionando de manera autónoma, Third Moment necesita una forma de probar la seguridad de sus entornos de investigación a gran escala. El equipo utiliza la plataforma de ciberseguridad Daybreak para automatizar esas pruebas antes de lanzar las simulaciones.
Las pruebas verifican si un agente podría salir de su entorno de investigación y acceder a la red más amplia. “Al usar Daybreak, podemos lograr que los propios agentes hagan pruebas de penetración en la simulación y prueben su infraestructura y seguridad”, dice Adam.
“Sin Daybreak, no podríamos probar esto de forma autónoma a gran escala.”—Adam Khakhar, cofundador de Third Moment Research
Avanzando hacia cientos de miles de agentes que colaboran
La ambición de Third Moment se extiende al trabajo especializado que las empresas realizan a diario. Para un minorista, eso podría significar tomar mejores decisiones de cadena de suministro cuando el inventario es escaso o un proveedor se retrasa. Para un equipo de ingeniería, podría significar encontrar cuellos de botella de rendimiento en una base de código grande. Para un negocio con muchos documentos, podría significar identificar dónde los compromisos de un documento no coinciden con los resultados registrados en otro.
Basándose en las capacidades de razonamiento de GPT‑6 Astra, GPT‑6 Sol y GPT‑6.1 Sol, Third Moment planea pasar de investigaciones individuales a cientos de miles de subagentes que colaboren. Su hoja de ruta contempla billones de tokens que respalden cadenas de decenas de experimentos dependientes, con el objetivo de usar esa investigación para mejorar autónomamente los agentes a medida que surjan nuevos desafíos.
Para Adam, esto daría a las personas más capacidad para moldear cómo aprenden y trabajan los agentes: “Los humanos pueden estar en una posición de mucho mayor apalancamiento, en la que pueden pensar en cómo hacer investigación y optimizar la investigación en sí misma en lugar de hacer realmente la investigación”.